Curso
Introdução a Deep Learning em Python
4 h
264.6K
Em deep learning, é comum ver muitas discussões sobre tensores como a estrutura de dados fundamental. O termo tensor até aparece no nome da principal biblioteca de machine learning do Google: “TensorFlow”. Tensores são um tipo de estrutura de dados usada em álgebra linear e, assim como vetores e matrizes, você pode realizar operações aritméticas com eles.
Já o PyTorch é um pacote Python criado pelo Facebook que oferece dois recursos de alto nível: 1) computação com tensores (como o NumPy) com forte aceleração por GPU e 2) redes neurais profundas construídas sobre um sistema de diferenciação automática baseado em “fitas” (tape-based).
Neste tutorial, você vai descobrir o que são tensores e como manipulá-los em Python com PyTorch.
Então, sem mais demora, vamos começar com a introdução aos tensores.
Um tensor é uma generalização de vetores e matrizes e pode ser entendido como um array multidimensional. Segundo o livro de referência em deep learning “Deep Learning” (Goodfellow et al.) -
"De modo geral, um arranjo de números organizado em uma grade regular com um número variável de eixos é conhecido como tensor."
Um escalar é um tensor de ordem zero (ou posto zero). Um vetor é um tensor unidimensional (primeira ordem) e uma matriz é um tensor bidimensional (segunda ordem).
O infográfico a seguir descreve tensores de um jeito bem didático:
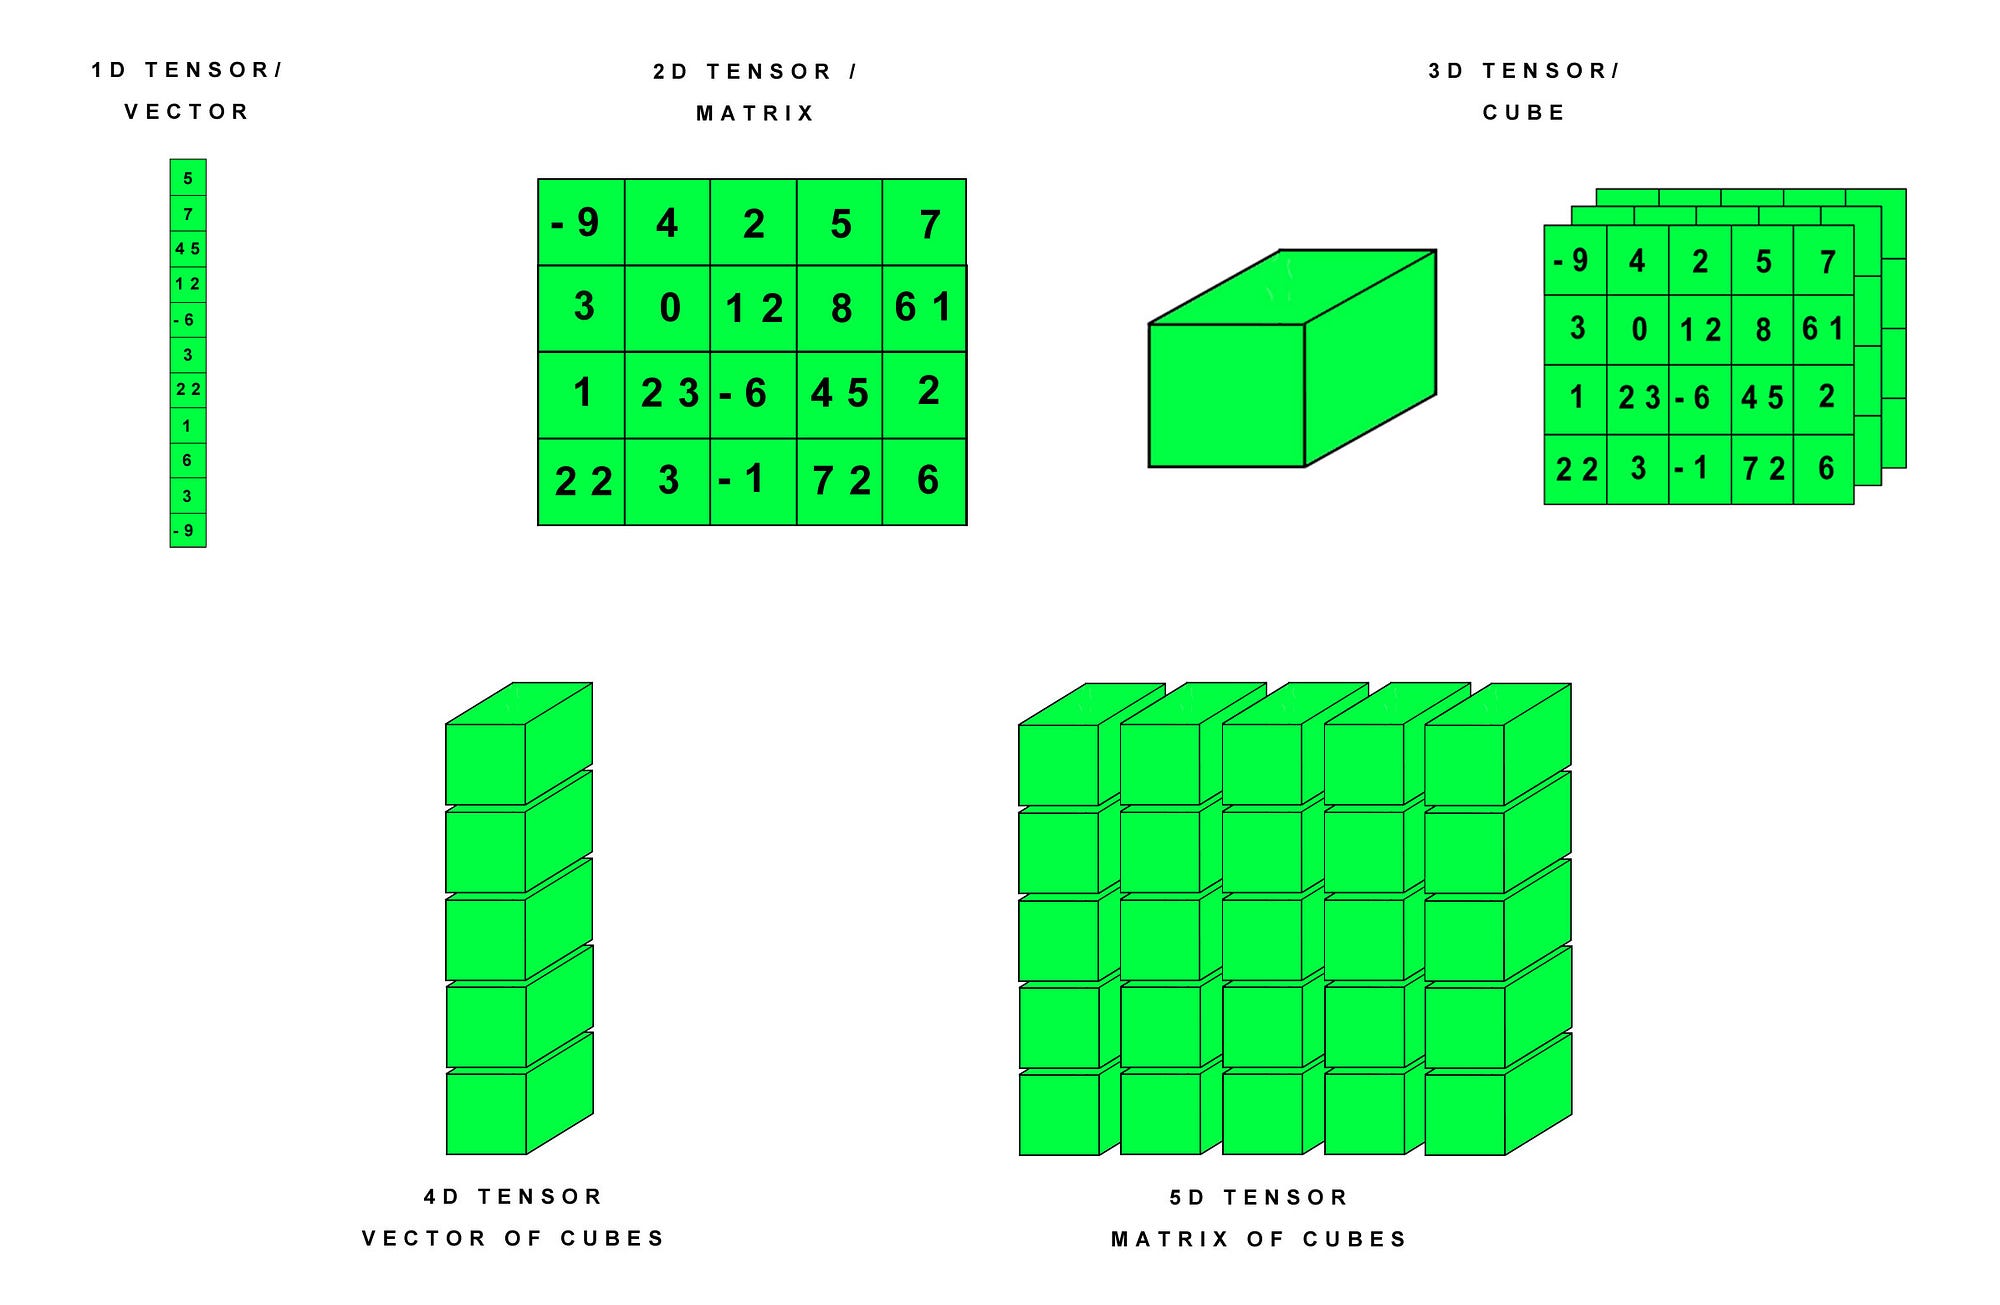
Vamos construir a intuição por trás dos tensores de forma mais clara agora.
Um tensor é o bloco básico do machine learning moderno. No fundo, é um contêiner de dados. Em geral, contém números. Às vezes até inclui strings, mas é raro. Pense nele como um “balde” de números.
Muitas vezes, porém, as pessoas confundem tensores com arrays multidimensionais. De acordo com o StackExchange:
Tensores e arrays multidimensionais são tipos de objetos diferentes. O primeiro é um tipo de função. O segundo é uma estrutura de dados adequada para representar um tensor em um sistema de coordenadas.
Matematicamente, tensores são definidos como funções multilineares. Uma função multilinear é composta por várias variáveis vetoriais. Um campo tensorial é uma função cujo valor é um tensor. Para uma explicação matemática rigorosa, você pode ler aqui.
Portanto, tensores são funções ou contêineres que você precisa definir. O cálculo de fato acontece quando há dados sendo alimentados. O que você vê como arrays ou multidimensionais (1D, 2D, …, ND) pode ser considerado tensores genéricos.
Agora vamos falar um pouco sobre a notação de tensores.
A notação de tensores é muito parecida com a notação de matrizes: uma letra maiúscula representa um tensor e letras minúsculas com índices inteiros representam valores escalares dentro do tensor.

Muitas operações que podem ser feitas com escalares, vetores e matrizes podem ser reformuladas para serem realizadas com tensores.
Como ferramenta, tensores e álgebra tensorial são amplamente usados em física e engenharia. Em machine learning, o treinamento e a operação de modelos de deep learning também podem ser descritos em termos de tensores.
PyTorch é um pacote de computação científica em Python direcionado para:
Vamos resumir rapidamente os diferenciais do PyTorch:
O PyTorch oferece uma grande variedade de rotinas com tensores para acelerar e atender às suas necessidades de computação científica, como slicing, indexação, operações matemáticas, álgebra linear, reduções. E tudo isso é rápido.
O PyTorch tem uma forma única de construir redes neurais: usando e “reproduzindo” uma gravação em fita.
A maioria dos frameworks, como TensorFlow, Theano, Caffe e CNTK, têm uma visão estática do mundo. Você precisa construir uma rede neural e reutilizar a mesma estrutura repetidas vezes. Mudar o comportamento da rede significa recomeçar do zero.
O PyTorch usa uma técnica chamada diferenciação automática em modo reverso (Reverse-mode), que permite alterar o comportamento da sua rede de forma arbitrária sem atraso ou overhead. Nossa inspiração vem de diversos artigos de pesquisa sobre o tema, assim como trabalhos atuais e passados, como autograd, Chainer etc.
(Embora essa técnica não seja exclusiva do PyTorch, ele tem uma das implementações mais rápidas até hoje. Você ganha o melhor de velocidade e flexibilidade para suas pesquisas.)
(Por isso, o PyTorch é bem rápido — seja executando redes pequenas ou grandes.)
Este post faz uma ótima comparação entre PyTorch e TensorFlow.
P.S.: este post da DataCamp é um excelente ponto de partida para começar com TensorFlow.
Instalar o PyTorch é bem direto. Como o PyTorch oferece computação eficiente em GPU, ele se comunica com seus drivers CUDA e executa tudo mais rápido.
Você vai precisar de torch e torchvision para usar PyTorch. Vamos instalá-los em um ambiente Windows. Mais adiante você verá os passos para Linux e Mac também.
Estou com Python 3.5 com Anaconda instalado. Também não tenho CUDA. Execute os comandos abaixo para instalar torch e torchvision:
(Atenção: o PyTorch não oferece suporte ao Python 2.7. Portanto, é obrigatório ter Python => 3.5.)
Se você tiver CUDA habilitado na sua máquina, rode o seguinte (para CUDA 9.0):
Agora, veja os passos de instalação em um ambiente Linux com Python 3.5 e sem suporte a CUDA:
Sim, você acertou! É igual ao do Windows.
Se você tiver suporte a CUDA (9.0), então o passo seria:
Para Mac, com Python 3.5 e sem suporte a CUDA, os passos seriam:
E, com suporte a CUDA (9.0):
(Os binários do MacOS não suportam CUDA; instale a partir do código-fonte se precisar de CUDA)
Esperamos que, até aqui, você já tenha concluído a instalação do PyTorch!
Agora, vamos direto para um pouco de aritmética com tensores no PyTorch.
Primeiro, vamos importar as bibliotecas necessárias.
from __future__ import print_function
import torch
Se a instalação do PyTorch deu certo, executar as linhas acima não deve gerar erros.
Agora, vamos construir uma matriz 5x3, não inicializada:
x = torch.rand(5, 3)
print(x)
tensor([[ 0.5991,  0.9365,  0.6120],
        [ 0.3622,  0.1408,  0.8811],
        [ 0.6248,  0.4808,  0.0322],
        [ 0.2267,  0.3715,  0.8430],
        [ 0.0145,  0.0900,  0.3418]])
Construa uma matriz preenchida com zeros e do tipo de dado long:
x = torch.zeros(5, 3, dtype=torch.long)
print(x)
tensor([[ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0]])
Construa um tensor diretamente a partir de dados:
x = torch.tensor([5.5, 3])
print(x)
tensor([ 5.5000, 3.0000])
Se você entendeu bem os tensores, diga nos comentários que tipo de tensor é o x!
Você pode criar um tensor com base em um tensor existente. Esses métodos reaproveitam propriedades do tensor de entrada, por exemplo o dtype (tipo de dado), a menos que você forneça novos valores:
x = x.new_ones(5, 3, dtype=torch.double)
print(x)

x = torch.randn_like(x, dtype=torch.float)
print(x)
tensor([[ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.]], dtype=torch.float64)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
Obtenha o tamanho:
print(x.size())
torch.Size([5, 3])
Note que torch.Size é, na prática, uma tupla, então aceita todas as operações de tupla.
Agora, vamos fazer uma operação de adição em tensores.
A adição elemento a elemento de dois tensores com as mesmas dimensões resulta em um novo tensor com as mesmas dimensões, em que cada valor escalar é a soma elemento a elemento dos escalares nos tensores originais.

# Sintaxe 1 para adição de tensores no PyTorch
y = torch.rand(5, 3)
print(x)
print(y)
print(x + y)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
tensor([[ 0.8285,  0.7619,  0.1147],
        [ 0.1624,  0.8994,  0.6119],
        [ 0.2802,  0.2950,  0.7098],
        [ 0.8132,  0.3382,  0.4383],
        [ 0.6738,  0.2022,  0.3264]])
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
# Sintaxe 2 para adição de tensores no PyTorch
print(torch.add(x, y))
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
Vamos fazer agora a subtração de tensores.
A subtração elemento a elemento de um tensor de outro, ambos com as mesmas dimensões, resulta em um novo tensor nas mesmas dimensões, em que cada valor escalar é a subtração elemento a elemento dos escalares nos tensores de origem.

Agora vamos olhar para o produto tensorial:
Realiza a multiplicação de matrizes entre mat1 e mat2.
Se mat1 é um tensor (n×m) e mat2 é um tensor (m×p), o resultado será um tensor (n×p).
Você faz produtos tensoriais no PyTorch assim:
mat1 = torch.randn(2, 3)
mat2 = torch.randn(3, 3)
print(mat1)
print(mat2)
print(torch.mm(mat1, mat2))
tensor([[ 1.9490, -0.6503, -1.9448],
        [-0.7126,  1.0519, -0.4250]])
tensor([[ 0.0846,  0.4410, -0.0625],
        [-1.3264, -0.5265,  0.2575],
        [-1.3324,  0.6644,  0.3528]])
tensor([[ 3.6185, -0.0901, -0.9753],
        [-0.8892, -1.1504,  0.1654]])
Note que torch.mm() não faz broadcasting. Vamos falar um pouco sobre broadcasting.
Broadcasting descreve como arrays com formatos diferentes são tratados em operações aritméticas. Sujeito a certas regras, o array menor é “espalhado” sobre o maior para que fiquem com formas compatíveis. Broadcasting permite vetorizar operações de arrays para que os loops ocorram em C em vez de Python. Isso é feito sem cópias desnecessárias de dados e normalmente leva a implementações eficientes. Há, no entanto, casos em que broadcasting não é indicado, pois pode levar a uso ineficiente de memória e tornar o cálculo mais lento.
Dois tensores são “broadcastable” se as seguintes regras forem atendidas:
Vamos entender isso no PyTorch com o trecho a seguir:
x=torch.empty(5,7,3)
y=torch.empty(5,7,3)
# formas iguais são sempre broadcastable (ou seja, as regras acima sempre valem)
x=torch.empty((0,))
y=torch.empty(2,2)
# x e y não são broadcastable, porque x não tem ao menos 1 dimensão
# é possível alinhar dimensões finais
x=torch.empty(5,3,4,1)
y=torch.empty(  3,1,1)
# x e y são broadcastable.
# 1ª dimensão final: ambos têm tamanho 1
# 2ª dimensão final: y tem tamanho 1
# 3ª dimensão final: tamanho de x == tamanho de y
# 4ª dimensão final: a dimensão de y não existe
# mas:
>>> x=torch.empty(5,2,4,1)
>>> y=torch.empty(  3,1,1)
# x e y não são broadcastable, porque na 3ª dimensão final 2 != 3
Agora que você já tem uma boa noção de broadcasting, vamos ver qual será o tamanho do tensor resultante quando dois tensores forem "broadcastable".
Se dois tensores x e y são “broadcastable”, o tamanho do tensor resultante é calculado assim:
Se o número de dimensões de x e y não for igual, prefixe 1 às dimensões do tensor com menos dimensões para igualar o comprimento. Depois, para cada dimensão, o tamanho resultante é o máximo entre os tamanhos de x e y naquela dimensão. Por exemplo:
# alinhar dimensões finais pode facilitar a leitura
x=torch.empty(5,1,4,1)
y=torch.empty(  3,1,1)
(x+y).size()
torch.Size([5, 3, 4, 1])
torch.Size([5, 3, 4, 1])
# mas não é obrigatório:
x=torch.empty(1)
y=torch.empty(3,1,7)
(x+y).size()
torch.Size([3, 1, 7])
torch.Size([3, 1, 7])
x=torch.empty(5,2,4,1)
y=torch.empty(3,1,1)
(x+y).size()
---------------------------------------------------------------------------

RuntimeError                              Traceback (most recent call last)

<ipython-input-17-72fb34250db7> in <module>()
      1 x=torch.empty(5,2,4,1)
      2 y=torch.empty(3,1,1)
----> 3 (x+y).size()


RuntimeError: The size of tensor a (2) must match the size of tensor b (3) at non-singleton dimension 1
Agora a ideia ficou clara!
O produto tensorial é a forma mais comum de multiplicação de tensores que você vai encontrar, mas há outras, como o produto interno (dot) de tensores e a contração tensorial.
Converter um Tensor do Torch em um array NumPy e vice-versa é muito simples. Esse recurso é chamado de Numpy Bridge. Vamos ver.
O Tensor do Torch e o array NumPy compartilham os mesmos endereços de memória base; alterar um altera o outro.
Convertendo um Tensor do Torch em um array NumPy.
# Um tensor 1D com 5 uns
a = torch.ones(5)
print(a)
tensor([ 1., 1., 1., 1., 1.])
# Converter o tensor do Torch em um array NumPy
b = a.numpy()
print(b)
[1. 1. 1. 1. 1.]
Veja como o array NumPy refletiu o valor.
Nas seções acima, você fez aritmética básica com tensores, como adição, subtração e produtos. Agora, na próxima seção, você vai implementar uma rede neural básica no PyTorch.
Se você precisa relembrar redes neurais, este artigo da DataCamp é um ótimo começo. Vale conferir também:
Antes da implementação, vamos falar um pouco sobre um conceito chamado diferenciação automática, central para todas as redes neurais no PyTorch. Isso é particularmente útil para calcular gradientes durante o backpropagation.
O pacote autograd fornece diferenciação automática para todas as operações com tensores. É um framework define-by-run, o que significa que seu backpropagation é definido pela forma como seu código roda e que cada iteração pode ser diferente.
Vamos ver a diferenciação automática em ação com um exemplo simples.
# Crie um tensor de posto 2 com todos os elementos iguais a 1
x = torch.ones(2, 2, requires_grad=True)
print(x)
tensor([[ 1.,  1.],
        [ 1.,  1.]])
Faça uma operação de adição.
y = x + 2
print(y)
tensor([[ 3.,  3.],
        [ 3.,  3.]])
Faça mais algumas operações em y.
z = y * y * 3
out = z.mean()

print(z, out)
tensor([[ 27.,  27.],
        [ 27.,  27.]]) tensor(27.)
Vamos fazer o backprop agora. Como out contém um escalar, out.backward() é equivalente a out.backward(torch.tensor(1)).
out.backward()

# imprimir gradientes d(out)/dx
print(x.grad)
tensor([[ 4.5000,  4.5000],
        [ 4.5000,  4.5000]])

Agora você já sabe sobre diferenciação automática e como o PyTorch lida com isso. Vamos codar uma rede neural simples usando PyTorch.
Você vai criar uma rede neural com uma camada oculta e uma unidade de saída. Vai usar a ReLU na camada oculta e a sigmoid na camada de saída.
Primeiro, importe a biblioteca PyTorch. Redes neurais podem ser construídas com o pacote torch.nn.
import torch
import torch.nn as nn
Em seguida, defina os tamanhos de todas as camadas e o batch size:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
Agora, crie alguns dados de entrada fictícios x e alguns dados-alvo fictícios y. Você usará tensores do PyTorch para armazenar esses dados. Tensores do PyTorch podem ser usados e manipulados como arrays do NumPy, com o benefício extra de poderem rodar em GPUs. Mas, neste tutorial, vamos rodar na CPU. E é simples transferi-los para GPU, caso queira.
x = torch.randn(batch_size, n_in)
y = torch.tensor([[1.0], [0.0], [0.0], [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])
Agora, vamos definir o modelo em uma linha de código.
model = nn.Sequential(nn.Linear(n_in, n_h),
                     nn.ReLU(),
                     nn.Linear(n_h, n_out),
                     nn.Sigmoid())
Isso cria um modelo no formato input -> linear -> relu -> linear -> sigmoid. Há outra forma de definir modelos, usada para arquiteturas mais complexas e personalizadas: definindo o modelo em uma classe. Você pode ler sobre isso aqui.
Agora é hora de construir sua função de perda. Vamos usar o erro quadrático médio (Mean Squared Error Loss).
criterion = torch.nn.MSELoss()
Também não se esqueça de definir o otimizador. Vamos usar o poderoso Stochastic Gradient Descent e uma taxa de aprendizado de 0.01. model.parameters() retorna um iterador sobre os parâmetros do modelo (pesos e vieses).
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
Agora vamos rodar o gradiente descendente por 50 épocas. Isso faz, nessa ordem: forward, cálculo da perda, backward e atualização dos parâmetros.
for epoch in range(50):
    # Forward Propagation
    y_pred = model(x)
    # Compute and print loss
    loss = criterion(y_pred, y)
    print('epoch: ', epoch,' loss: ', loss.item())
    # Zero the gradients
    optimizer.zero_grad()

    # perform a backward pass (backpropagation)
    loss.backward()

    # Update the parameters
    optimizer.step()
epoch:  0  loss:  0.2399429827928543
epoch:  1  loss:  0.23988191783428192
epoch:  2  loss:  0.23982088267803192
epoch:  3  loss:  0.2397598922252655
epoch:  4  loss:  0.23969893157482147
epoch:  5  loss:  0.23963800072669983
epoch:  6  loss:  0.23957709968090057
epoch:  7  loss:  0.23951618373394012
epoch:  8  loss:  0.23945537209510803
epoch:  9  loss:  0.23939454555511475
epoch:  10  loss:  0.23933371901512146
epoch:  11  loss:  0.23927298188209534
epoch:  12  loss:  0.23921218514442444
epoch:  13  loss:  0.23915143311023712
epoch:  14  loss:  0.2390907108783722
epoch:  15  loss:  0.23903003334999084
epoch:  16  loss:  0.23896940052509308
epoch:  17  loss:  0.23890872299671173
epoch:  18  loss:  0.23884813487529755
epoch:  19  loss:  0.23878750205039978
epoch:  20  loss:  0.23872694373130798
epoch:  21  loss:  0.2386663407087326
epoch:  22  loss:  0.2386058121919632
epoch:  23  loss:  0.23854532837867737
epoch:  24  loss:  0.23848481476306915
epoch:  25  loss:  0.23842433094978333
epoch:  26  loss:  0.2383638620376587
epoch:  27  loss:  0.23830339312553406
epoch:  28  loss:  0.2382429838180542
epoch:  29  loss:  0.23818258941173553
epoch:  30  loss:  0.2381247729063034
epoch:  31  loss:  0.2380656749010086
epoch:  32  loss:  0.23800739645957947
epoch:  33  loss:  0.2379491776227951
epoch:  34  loss:  0.2378900945186615
epoch:  35  loss:  0.23783239722251892
epoch:  36  loss:  0.23777374625205994
epoch:  37  loss:  0.23771481215953827
epoch:  38  loss:  0.23765745759010315
epoch:  39  loss:  0.23759838938713074
epoch:  40  loss:  0.23753997683525085
epoch:  41  loss:  0.2374821901321411
epoch:  42  loss:  0.23742322623729706
epoch:  43  loss:  0.23736533522605896
epoch:  44  loss:  0.23730707168579102
epoch:  45  loss:  0.23724813759326935
epoch:  46  loss:  0.23719079792499542
epoch:  47  loss:  0.23713204264640808
epoch:  48  loss:  0.23707345128059387
epoch:  49  loss:  0.2370160073041916
y_pred recebe os valores previstos a partir de um forward do modelo. Você passa isso, junto com os alvos y, para a função de perda, que calcula o erro.
Depois, optimizer.zero_grad() zera todos os gradientes. É preciso fazer isso para que gradientes anteriores não se acumulem.
Em seguida, loss.backward() é a “mágica” do PyTorch usando o Autograd. O Autograd calcula automaticamente todos os gradientes em relação a todos os parâmetros com base no grafo computacional criado dinamicamente. Basicamente, isso realiza o backward (backpropagation) do gradiente descendente.
Por fim, você chama optimizer.step(), que faz uma atualização dos parâmetros usando os novos gradientes.
Pronto, você chegou ao fim. Neste post, passamos por muita coisa: começamos com tensores, falamos de diferenciação automática e muito mais! Você também implementou uma rede neural simples usando PyTorch e seu sistema de tensores.
Se quiser aprender mais sobre PyTorch e se aprofundar, consulte a documentação e os tutoriais oficiais — são muito bem escritos. Você encontra tudo aqui.
A seguir estão algumas referências que me ajudaram a escrever este tutorial:
Se quiser perguntar ou comentar algo, deixe sua mensagem nos comentários!
Se você se interessa em aprender mais sobre Python, faça o curso Statistical Thinking in Python (Part 1) da DataCamp.
Aprenda mais sobre Python e PyTorch
Curso
Curso
Tutorial
Arjun Sarkar
15 min
Tutorial
Tutorial
Abid Ali Awan
10 min
Tutorial
Tutorial
Abid Ali Awan
14 min
Tutorial
Zoumana Keita
8 min




