कोर्स
Python में Deep Learning परिचय
4 घंटा
264.7K
डीप लर्निंग में, टेन्सर को आधारभूत डेटा संरचना के रूप में लेकर अक्सर चर्चा होती है। Google की प्रमुख मशीन लर्निंग लाइब्रेरी के नाम में भी Tensor आता है: “TensorFlow”。 टेन्सर रेखीय बीजगणित में प्रयुक्त एक डेटा संरचना है, और वेक्टर व मैट्रिक्स की तरह, आप टेन्सर पर भी अंकगणितीय क्रियाएँ कर सकते हैं।
दूसरी ओर, PyTorch Facebook द्वारा विकसित एक पायथन पैकेज है जो दो उच्च-स्तरीय विशेषताएँ प्रदान करता है: 1) GPU त्वरण के साथ शक्तिशाली टेन्सर गणना (Numpy जैसी) और 2) टेप-आधारित स्वचालित अवकलन प्रणाली पर निर्मित डीप न्यूरल नेटवर्क।
इस ट्यूटोरियल में, आप जानेंगे कि टेन्सर क्या होते हैं और Python में PyTorch के साथ उन्हें कैसे संचालित किया जाता है।
तो, बिना देरी किए टेन्सर के परिचय से शुरू करते हैं।
एक टेन्सर वेक्टर और मैट्रिक्स का सामान्यीकृत रूप है और इसे बहुआयामी ऐरे के रूप में आसानी से समझा जा सकता है। लोकप्रिय डीप लर्निंग किताब "Deep Learning" (Goodfellow आदि) के अनुसार -
"सामान्य स्थिति में, संख्याओं की वह श्रेणी जो एक नियमित ग्रिड पर अक्षों की परिवर्तनीय संख्या के साथ व्यवस्थित होती है, उसे टेन्सर कहा जाता है।"
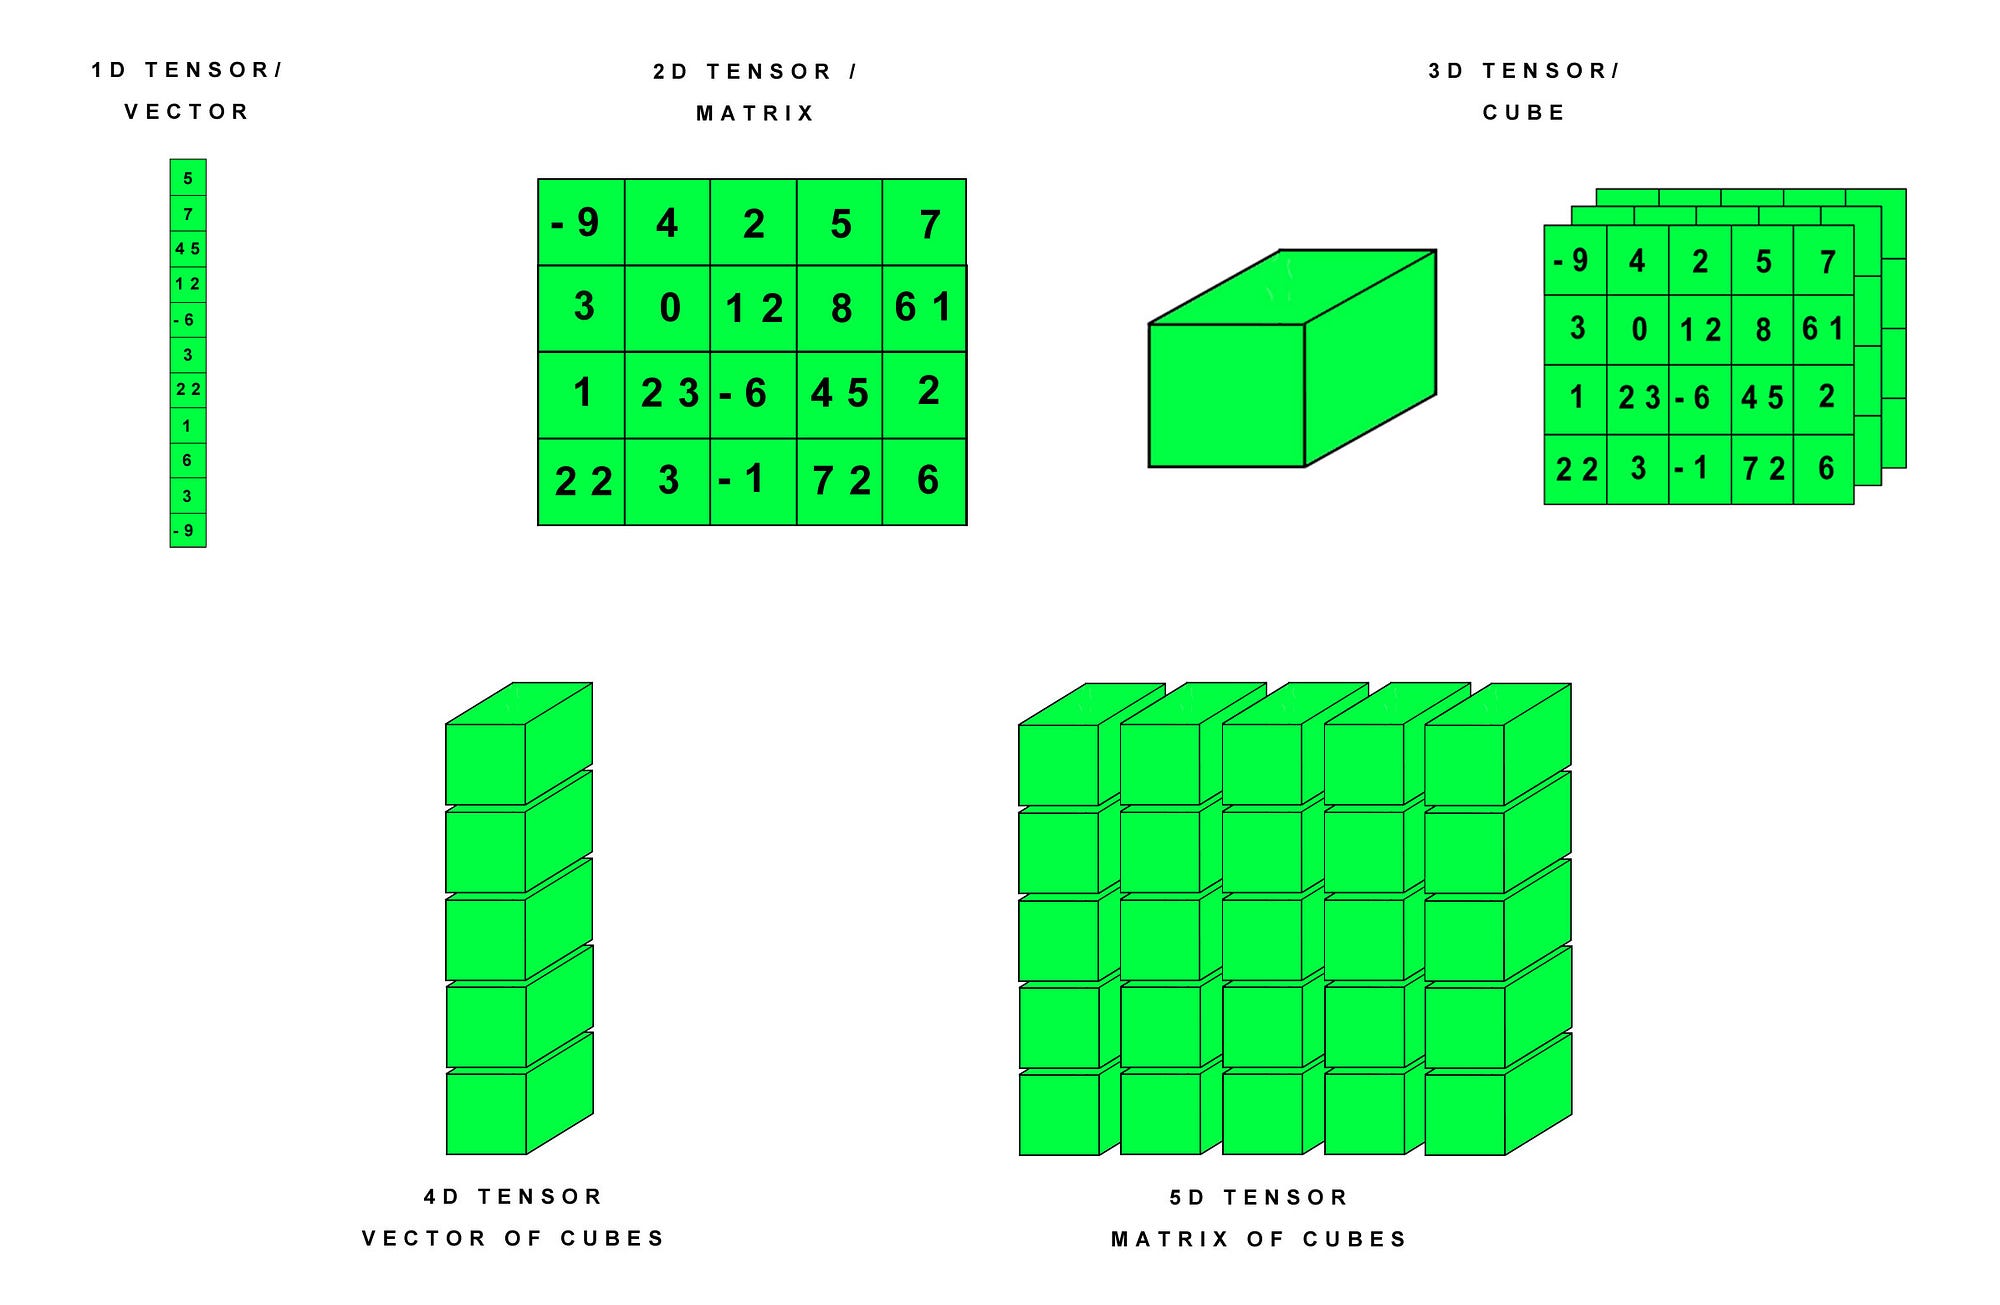
स्केलर शून्य-क्रम या रैंक-शून्य टेन्सर है। वेक्टर एक-आयामी या प्रथम-क्रम टेन्सर है, और मैट्रिक्स द्वि-आयामी या द्वितीय-क्रम टेन्सर है।
निम्नलिखित इन्फोग्राफिक टेन्सर को बहुत सुविधाजनक तरीके से दर्शाता है:
अब इसे और सरल ढंग से समझने के लिए सहजता विकसित करते हैं।
टेन्सर आधुनिक मशीन लर्निंग के बुनियादी निर्माण खंड हैं। मूल रूप से, यह डेटा रखने वाला कंटेनर है। अधिकांशतः इसमें संख्याएँ होती हैं। कभी-कभी इसमें स्ट्रिंग्स भी हो सकती हैं, पर वह दुर्लभ है। तो इसे संख्याओं की बाल्टी की तरह सोचें।
लेकिन अक्सर लोग टेन्सर को बहुआयामी ऐरे के साथ भ्रमित करते हैं। StackExchange के अनुसार:
टेन्सर और बहुआयामी ऐरे भिन्न प्रकार की वस्तुएँ हैं। पहला एक प्रकार का फलन है। दूसरा किसी निर्देशांक प्रणाली में टेन्सर का प्रतिनिधित्व करने के लिए उपयुक्त डेटा संरचना है।
गणितीय रूप से, टेन्सर बहुरेखीय फलन के रूप में परिभाषित होते हैं। बहुरेखीय फलन में विभिन्न वेक्टर चर होते हैं। टेन्सर क्षेत्र (tensor field) एक टेन्सर-मूल्यित फलन है। एक कठोर गणितीय व्याख्या के लिए, आप यहाँ पढ़ सकते हैं।
अतः, टेन्सर फलन या कंटेनर हैं जिन्हें आपको परिभाषित करना होता है। वास्तविक गणना तब होती है जब डेटा प्रविष्ट किया जाता है। जो आप ऐरे या बहुआयामी (1D, 2D, …, ND) के रूप में देखते हैं, उन्हें सामान्य टेन्सर माना जा सकता है।
अब, टेन्सर संकेतन पर थोड़ी बात करते हैं।
टेन्सर संकेतन मैट्रिक्स संकेतन जैसा ही है, जहाँ एक बड़े अक्षर से टेन्सर को दर्शाया जाता है और टेन्सर के भीतर के स्केलर मानों को उपसक्रिप्ट पूर्णांकों के साथ छोटे अक्षरों से दर्शाया जाता है।

वे सभी क्रियाएँ जो स्केलर, वेक्टर और मैट्रिक्स पर की जा सकती हैं, उन्हें पुनर्परिभाषित करके टेन्सर पर भी किया जा सकता है।
एक औज़ार के रूप में, टेन्सर और टेन्सर बीजगणित भौतिकी और अभियांत्रिकी के क्षेत्रों में व्यापक रूप से प्रयुक्त होते हैं। यह एक पद और तकनीकों का समूह है जिसके माध्यम से मशीन लर्निंग में डीप लर्निंग मॉडलों के प्रशिक्षण और संचालन को टेन्सर के परिप्रेक्ष्य में वर्णित किया जा सकता है।
PyTorch एक Python-आधारित वैज्ञानिक संगणना पैकेज है, जिसका लक्ष्य है:
PyTorch की विशिष्ट विशेषताओं का त्वरित सारांश:
PyTorch वैज्ञानिक संगणना जरूरतों के लिए ढेरों टेन्सर रूटीन प्रदान करता है, जैसे slicing, indexing, गणितीय क्रियाएँ, रैखिक बीजगणित, reductions। और ये तेज़ हैं।
PyTorch में न्यूरल नेटवर्क बनाने का अनोखा तरीका है: टेप रिकॉर्डर का उपयोग और उसे फिर से चलाना।
ज़्यादातर फ्रेमवर्क जैसे TensorFlow, Theano, Caffe और CNTK दुनिया को स्थिर रूप में देखते हैं। आपको एक न्यूरल नेटवर्क बनाना होता है और उसी संरचना का बार-बार पुन: उपयोग करना होता है। नेटवर्क के व्यवहार में बदलाव का मतलब है कि आपको शून्य से शुरू करना होगा।
PyTorch Reverse-mode auto-differentiation नामक तकनीक का उपयोग करता है, जो आपको शून्य विलंब या ओवरहेड के साथ अपने नेटवर्क के व्यवहार को मनचाहा बदलने देती है। हमारी प्रेरणा इस विषय पर कई शोध-पत्रों और वर्तमान/पूर्व कार्यों जैसे autograd, Chainer आदि से आती है।
(हालाँकि यह तकनीक PyTorch के लिए अनन्य नहीं है, फिर भी इसकी अब तक की सबसे तेज़ कार्यान्वयन में से एक है। आपको अपने अनुसंधान के लिए गति और लचीलापन दोनों का सर्वश्रेष्ठ मिलता है।)
(इसलिए, PyTorch काफी तेज़ है – चाहे आप छोटे या बड़े न्यूरल नेटवर्क चलाएँ।)
यह ब्लॉग PyTorch और TensorFlow की तुलना बहुत अच्छी तरह करता है।
टिप्पणी: यह DataCamp ब्लॉग TensorFlow शुरू करने के लिए एक उत्कृष्ट प्रारंभिक संसाधन है।
PyTorch की स्थापना काफ़ी सरल है। PyTorch कुशल GPU गणना का समर्थन करता है, यह आपके Cuda ड्राइवरों से कुशलतापूर्वक संवाद करता है और कार्यों को तेज़ी से करता है।
PyTorch के उपयोग के लिए आपको torch और torchvision की आवश्यकता होगी। आइए इन्हें Windows वातावरण के लिए इंस्टॉल करते हैं। आगे आप Linux और Mac के लिए भी चरण देखेंगे।
मेरे पास Python 3.5 और Anaconda सेटअप है। साथ ही, मेरे पास CUDA नहीं है। torch और torchvision इंस्टॉल करने के लिए निम्न कमांड चलाएँ:
(कृपया ध्यान रखें कि PyTorch Python 2.7 का समर्थन नहीं करता। अतः Python का संस्करण => 3.5 होना आवश्यक है।)
यदि आपके मशीन पर CUDA सक्षम है, तो निम्न चलाएँ (यह CUDA 9.0 के लिए है):
अब, Linux वातावरण में Python 3.5 और बिना CUDA सपोर्ट के इंस्टॉलेशन स्टेप्स देखें:
हाँ, आपने सही समझा! यह Windows वाले के समान ही है।
अब, यदि आपके पास CUDA सपोर्ट (9.0) है तो कदम होगा:
Mac वातावरण में Python 3.5 और बिना CUDA सपोर्ट के चरण होंगे:
और, CUDA सपोर्ट (9.0) के साथ:
(MacOS बाइनरी CUDA का समर्थन नहीं करते, यदि CUDA चाहिए तो स्रोत से इंस्टॉल करें)
आशा है, अब तक आपने PyTorch इंस्टॉलेशन पूरा कर लिया होगा!
अब, सीधे PyTorch के साथ कुछ टेन्सर अंकगणित में उतरते हैं।
पहले, आवश्यक लाइब्रेरी आयात करते हैं।
from __future__ import print_function
import torch
यदि PyTorch सफलतापूर्वक इंस्टॉल हुआ है, तो ऊपर की पंक्तियाँ चलाने पर कोई त्रुटि नहीं आएगी।
अब, 5x3 का एक मैट्रिक्स बनाते हैं, अनइनिशियलाइज़्ड:
x = torch.rand(5, 3)
print(x)
tensor([[ 0.5991,  0.9365,  0.6120],
        [ 0.3622,  0.1408,  0.8811],
        [ 0.6248,  0.4808,  0.0322],
        [ 0.2267,  0.3715,  0.8430],
        [ 0.0145,  0.0900,  0.3418]])
शून्यों से भरा और डेटा टाइप long वाला मैट्रिक्स बनाएँ:
x = torch.zeros(5, 3, dtype=torch.long)
print(x)
tensor([[ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0]])
डेटा से सीधे एक टेन्सर बनाएँ:
x = torch.tensor([5.5, 3])
print(x)
tensor([ 5.5000, 3.0000])
यदि आपने टेन्सर सही समझे हैं, तो कमेंट सेक्शन में बताइए कि x किस प्रकार का टेन्सर है!
आप किसी मौजूदा टेन्सर के आधार पर भी नया टेन्सर बना सकते हैं। ये विधियाँ इनपुट टेन्सर की विशेषताओं, जैसे dtype (डेटा टाइप), को तब तक पुन: उपयोग करेंगी जब तक उपयोगकर्ता नए मान न दे:
x = x.new_ones(5, 3, dtype=torch.double)
print(x)

x = torch.randn_like(x, dtype=torch.float)
print(x)
tensor([[ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.]], dtype=torch.float64)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
इसका आकार प्राप्त करें:
print(x.size())
torch.Size([5, 3])
ध्यान दें कि torch.Size वास्तव में एक ट्यूपल है, इसलिए यह सभी ट्यूपल ऑपरेशन का समर्थन करता है।
अब, टेन्सर पर जोड़ (addition) ऑपरेशन करते हैं।
समान आयाम वाले दो टेन्सरों का एलिमेंट-वाइज योग उन्हीं आयामों वाले एक नए टेन्सर में होता है, जिसमें प्रत्येक स्केलर मान पैरेंट टेन्सरों के स्केलरों के एलिमेंट-वाइज योग के बराबर होता है।

# PyTorch में टेन्सर जोड़ के लिए सिंटैक्स 1
y = torch.rand(5, 3)
print(x)
print(y)
print(x + y)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
tensor([[ 0.8285,  0.7619,  0.1147],
        [ 0.1624,  0.8994,  0.6119],
        [ 0.2802,  0.2950,  0.7098],
        [ 0.8132,  0.3382,  0.4383],
        [ 0.6738,  0.2022,  0.3264]])
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
# PyTorch में टेन्सर जोड़ के लिए सिंटैक्स 2
print(torch.add(x, y))
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
अब टेन्सर घटाव करते हैं।
समान आयाम वाले दो टेन्सरों में से एक को दूसरे से एलिमेंट-वाइज घटाने पर उन्हीं आयामों वाला नया टेन्सर मिलता है, जिसमें प्रत्येक स्केलर मान पैरेंट टेन्सरों के स्केलरों के एलिमेंट-वाइज घटाव के बराबर होता है।

अब Tensor Product पर नज़र डालते हैं:
यह mat1 और mat2 मैट्रिक्स का मैट्रिक्स गुणन करता है।
यदि mat1 एक (n×m) टेन्सर है, mat2 एक (m×p) टेन्सर है, तो आउटपुट (n×p) टेन्सर होगा।
PyTorch में टेन्सर प्रोडक्ट इस प्रकार करते हैं:
mat1 = torch.randn(2, 3)
mat2 = torch.randn(3, 3)
print(mat1)
print(mat2)
print(torch.mm(mat1, mat2))
tensor([[ 1.9490, -0.6503, -1.9448],
        [-0.7126,  1.0519, -0.4250]])
tensor([[ 0.0846,  0.4410, -0.0625],
        [-1.3264, -0.5265,  0.2575],
        [-1.3324,  0.6644,  0.3528]])
tensor([[ 3.6185, -0.0901, -0.9753],
        [-0.8892, -1.1504,  0.1654]])
ध्यान दें कि torch.mm() ब्रॉडकास्ट नहीं करता। आइए ब्रॉडकास्टिंग पर थोड़ा चर्चा करते हैं।
ब्रॉडकास्टिंग उस प्रक्रिया का वर्णन करता है जिसके तहत अलग-अलग आकार वाले ऐरे अंकगणितीय क्रियाओं के दौरान संभाले जाते हैं। कुछ बाध्यताओं के अधीन, छोटा ऐरे बड़े ऐरे पर “ब्रॉडकास्ट” किया जाता है ताकि उनके आकार अनुकूल हो जाएँ। ब्रॉडकास्टिंग ऐरे ऑपरेशनों का वेक्टराइज़ेशन सक्षम करती है ताकि लूपिंग Python के बजाय C में हो। यह अनावश्यक डेटा प्रतियों के बिना ऐसा करती है और प्रायः कुशल एल्गोरिथ्म निष्पादन देती है। हालाँकि, कुछ स्थितियों में ब्रॉडकास्टिंग खराब विचार भी हो सकता है क्योंकि यह मेमोरी का अक्षम उपयोग कर गणना धीमी कर देता है।
दो टेन्सर “ब्रॉडकास्टेबल” होते हैं यदि निम्न नियम लागू हों:
PyTorch के साथ इसे निम्न कोड स्निपेट से समझते हैं:
x=torch.empty(5,7,3)
y=torch.empty(5,7,3)
# समान आकार हमेशा ब्रॉडकास्टेबल होते हैं (अर्थात ऊपर के नियम हमेशा लागू होते हैं)
x=torch.empty((0,))
y=torch.empty(2,2)
# x और y ब्रॉडकास्टेबल नहीं हैं, क्योंकि x में कम से कम 1 आयाम नहीं है
# ट्रेलिंग आयामों को पंक्तिबद्ध किया जा सकता है
x=torch.empty(5,3,4,1)
y=torch.empty(  3,1,1)
# x और y ब्रॉडकास्टेबल हैं।
# 1वाँ ट्रेलिंग आयाम: दोनों का आकार 1
# 2रा ट्रेलिंग आयाम: y का आकार 1
# 3रा ट्रेलिंग आयाम: x का आकार == y का आकार
# 4था ट्रेलिंग आयाम: y का आयाम अस्तित्व में नहीं
# लेकिन:
>>> x=torch.empty(5,2,4,1)
>>> y=torch.empty(  3,1,1)
# x और y ब्रॉडकास्टेबल नहीं हैं, क्योंकि 3रे ट्रेलिंग आयाम में 2 != 3
अब जब आपको ब्रॉडकास्टिंग का अच्छा अंदाज़ा हो गया है, तो देखें कि यदि दो टेन्सर "ब्रॉडकास्टेबल" हों तो उनका परिणामी टेन्सर क्या होगा।
यदि दो टेन्सर x, y “ब्रॉडकास्टेबल” हैं, तो परिणामी टेन्सर का आकार इस प्रकार निकलेगा:
यदि x और y के आयामों की संख्या समान नहीं है, तो छोटे आयामों वाले टेन्सर के आगे 1 जोड़ें ताकि लंबाई समान हो जाए। फिर, प्रत्येक आयामी आकार के लिए, परिणामी आयाम आकार उस आयाम पर x और y के आकारों का अधिकतम होगा। उदाहरण:
# पढ़ने में आसानी के लिए ट्रेलिंग आयाम पंक्तिबद्ध कर सकते हैं
x=torch.empty(5,1,4,1)
y=torch.empty(  3,1,1)
(x+y).size()
torch.Size([5, 3, 4, 1])
torch.Size([5, 3, 4, 1])
# लेकिन आवश्यक नहीं:
x=torch.empty(1)
y=torch.empty(3,1,7)
(x+y).size()
torch.Size([3, 1, 7])
torch.Size([3, 1, 7])
x=torch.empty(5,2,4,1)
y=torch.empty(3,1,1)
(x+y).size()
---------------------------------------------------------------------------

RuntimeError                              Traceback (most recent call last)

<ipython-input-17-72fb34250db7> in <module>()
      1 x=torch.empty(5,2,4,1)
      2 y=torch.empty(3,1,1)
----> 3 (x+y).size()


RuntimeError: The size of tensor a (2) must match the size of tensor b (3) at non-singleton dimension 1
अब आप अवधारणा समझ गए होंगे!
टेन्सर प्रोडक्ट टेन्सर गुणन का सबसे सामान्य रूप है जो आप देख सकते हैं, लेकिन टेन्सर डॉट प्रोडक्ट और टेन्सर कंट्रैक्शन जैसे कई अन्य प्रकार भी मौजूद हैं।
Torch Tensor को NumPy array में और उल्टा बदलना बहुत आसान है। इस अवधारणा को Numpy Bridge कहते हैं। इसे देखते हैं।
Torch Tensor और NumPy array अपनी आधारभूत मेमोरी लोकेशन साझा करते हैं, और एक में बदलाव करने पर दूसरा भी बदल जाता है।
Torch Tensor को NumPy Array में बदलना।
# 5 एकों का 1D टेन्सर
a = torch.ones(5)
print(a)
tensor([ 1., 1., 1., 1., 1.])
# Torch टेन्सर को NumPy array में बदलें
b = a.numpy()
print(b)
[1. 1. 1. 1. 1.]
देखें कि NumPy array का मान कैसे बदला।
तो, ऊपर के अनुभागों में, आपने जोड़, घटाव और टेन्सर प्रोडक्ट जैसी कुछ बुनियादी टेन्सर अंकगणित की। अब अगले भाग में, आप PyTorch में एक सरल न्यूरल नेटवर्क लागू करेंगे।
यदि आपको न्यूरल नेटवर्क का पुनरावलोकन चाहिए, तो यह DataCamp लेख देखने के लिए सबसे अच्छा है। आप निम्न लिंक्स भी देखना चाहेंगे:
इम्प्लीमेंटेशन से पहले, Automatic Differentiation नामक अवधारणा पर थोड़ा चर्चा करते हैं जो PyTorch में सभी न्यूरल नेटवर्क का केंद्र है। यह विशेष रूप से बैकप्रोपेगेशन के दौरान ग्रेडिएंट्स निकालने में उपयोगी है।
autograd पैकेज Tensors पर सभी ऑपरेशनों के लिए स्वचालित अवकलन प्रदान करता है। यह define-by-run फ़्रेमवर्क है, जिसका अर्थ है कि आपकी बैकप्रोपेगेशन आपके कोड के चलने के तरीके से परिभाषित होती है और हर एक इटरेशन अलग हो सकता है।
एक सरल कोड उदाहरण के साथ Automatic Differentiation को क्रिया में देखते हैं।
# सभी एकों का रैंक-2 टेन्सर बनाएँ
x = torch.ones(2, 2, requires_grad=True)
print(x)
tensor([[ 1.,  1.],
        [ 1.,  1.]])
एक जोड़ ऑपरेशन करें।
y = x + 2
print(y)
tensor([[ 3.,  3.],
        [ 3.,  3.]])
y पर कुछ और ऑपरेशन करें।
z = y * y * 3
out = z.mean()

print(z, out)
tensor([[ 27.,  27.],
        [ 27.,  27.]]) tensor(27.)
अब बैकप्रोप करें क्योंकि out में एकल स्केलर है, out.backward() का अर्थ out.backward(torch.tensor(1)) के बराबर है।
out.backward()

# ग्रेडिएंट d(out)/dx प्रिंट करें
print(x.grad)
tensor([[ 4.5000,  4.5000],
        [ 4.5000,  4.5000]])

अब आप Automatic Differentiation और PyTorch के इसे संभालने के तरीके को जानते हैं। अब आप PyTorch का उपयोग करके एक सरल न्यूरल नेटवर्क कोड करेंगे।
आप एक सरल न्यूरल नेटवर्क बनाएँगे जिसमें एक hidden layer और एक single output unit होगा। आप hidden layer में ReLU activation और output layer में sigmoid activation का उपयोग करेंगे।
पहले, आपको PyTorch लाइब्रेरी आयात करनी होगी। न्यूरल नेटवर्क torch.nn पैकेज का उपयोग करके बनाए जा सकते हैं।
import torch
import torch.nn as nn
फिर आप सभी लेयर्स के आकार और batch size परिभाषित करते हैं:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
और अब, आप कुछ dummy input डेटा x और कुछ dummy target डेटा y बनाएँगे। आप इस डेटा को स्टोर करने के लिए PyTorch Tensors का उपयोग करेंगे। PyTorch Tensors का उपयोग और हेरफेर NumPy arrays की तरह ही किया जा सकता है, लेकिन अतिरिक्त लाभ यह है कि PyTorch टेन्सर GPUs पर चल सकते हैं। पर इस ट्यूटोरियल के लिए आप इन्हें CPU पर ही चलाएँगे। यद्यपि, इन्हें GPU पर भेजना काफ़ी सरल है।
x = torch.randn(batch_size, n_in)
y = torch.tensor([[1.0], [0.0], [0.0], [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])
और अब, आप एक पंक्ति के कोड में अपना मॉडल परिभाषित करेंगे।
model = nn.Sequential(nn.Linear(n_in, n_h),
                     nn.ReLU(),
                     nn.Linear(n_h, n_out),
                     nn.Sigmoid())
यह ऐसा मॉडल बनाता है: input -> linear -> relu -> linear -> sigmoid। मॉडल्स को परिभाषित करने का एक और तरीका भी है जो अधिक जटिल और कस्टम मॉडल के लिए उपयोग होता है। यह एक क्लास में मॉडल परिभाषित करके किया जाता है। आप इसके बारे में यहाँ पढ़ सकते हैं।
अब, loss function बनाते हैं। आप Mean Squared Error Loss का उपयोग करेंगे।
criterion = torch.nn.MSELoss()
और अपना optimizer परिभाषित करना न भूलें। यहाँ आप Stochastic Gradient Descent का उपयोग करेंगे और learning rate 0.01 रखेंगे। model.parameters() आपके मॉडल के parameters (weights और biases) पर एक iterator लौटाता है।
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
अब, आप 50 epochs के लिए Gradient Descent चलाएँगे। यह क्रमशः forward propagation, loss computation, backward propagation और parameter updates करता है।
for epoch in range(50):
    # Forward Propagation
    y_pred = model(x)
    # Compute and print loss
    loss = criterion(y_pred, y)
    print('epoch: ', epoch,' loss: ', loss.item())
    # Zero the gradients
    optimizer.zero_grad()

    # perform a backward pass (backpropagation)
    loss.backward()

    # Update the parameters
    optimizer.step()
epoch:  0  loss:  0.2399429827928543
epoch:  1  loss:  0.23988191783428192
epoch:  2  loss:  0.23982088267803192
epoch:  3  loss:  0.2397598922252655
epoch:  4  loss:  0.23969893157482147
epoch:  5  loss:  0.23963800072669983
epoch:  6  loss:  0.23957709968090057
epoch:  7  loss:  0.23951618373394012
epoch:  8  loss:  0.23945537209510803
epoch:  9  loss:  0.23939454555511475
epoch:  10  loss:  0.23933371901512146
epoch:  11  loss:  0.23927298188209534
epoch:  12  loss:  0.23921218514442444
epoch:  13  loss:  0.23915143311023712
epoch:  14  loss:  0.2390907108783722
epoch:  15  loss:  0.23903003334999084
epoch:  16  loss:  0.23896940052509308
epoch:  17  loss:  0.23890872299671173
epoch:  18  loss:  0.23884813487529755
epoch:  19  loss:  0.23878750205039978
epoch:  20  loss:  0.23872694373130798
epoch:  21  loss:  0.2386663407087326
epoch:  22  loss:  0.2386058121919632
epoch:  23  loss:  0.23854532837867737
epoch:  24  loss:  0.23848481476306915
epoch:  25  loss:  0.23842433094978333
epoch:  26  loss:  0.2383638620376587
epoch:  27  loss:  0.23830339312553406
epoch:  28  loss:  0.2382429838180542
epoch:  29  loss:  0.23818258941173553
epoch:  30  loss:  0.2381247729063034
epoch:  31  loss:  0.2380656749010086
epoch:  32  loss:  0.23800739645957947
epoch:  33  loss:  0.2379491776227951
epoch:  34  loss:  0.2378900945186615
epoch:  35  loss:  0.23783239722251892
epoch:  36  loss:  0.23777374625205994
epoch:  37  loss:  0.23771481215953827
epoch:  38  loss:  0.23765745759010315
epoch:  39  loss:  0.23759838938713074
epoch:  40  loss:  0.23753997683525085
epoch:  41  loss:  0.2374821901321411
epoch:  42  loss:  0.23742322623729706
epoch:  43  loss:  0.23736533522605896
epoch:  44  loss:  0.23730707168579102
epoch:  45  loss:  0.23724813759326935
epoch:  46  loss:  0.23719079792499542
epoch:  47  loss:  0.23713204264640808
epoch:  48  loss:  0.23707345128059387
epoch:  49  loss:  0.2370160073041916
y_pred हमारे मॉडल के फॉरवर्ड पास से प्राप्त प्रेडिक्टेड मान हैं। आप इसे target मान y के साथ criterion को पास करते हैं जो loss की गणना करता है।
फिर, optimizer.zero_grad() सभी ग्रेडिएंट्स को शून्य करता है। आपको यह इसलिए करना होता है ताकि पिछले ग्रेडिएंट्स जमा न होते रहें।
फिर, loss.backward() PyTorch का मुख्य जादू है जो Autograd फीचर का उपयोग करता है। Autograd कम्प्यूटेशन ग्राफ के आधार पर सभी parameters के सापेक्ष स्वतः सभी ग्रेडिएंट्स निकाल देता है। मूलतः, यह gradient descent का बैकवर्ड पास (backpropagation) करता है।
अंत में, आप optimizer.step() कॉल करते हैं जो नए ग्रेडिएंट्स का उपयोग करके सभी parameters का एक बार अपडेट करता है।
तो, आप अंत तक पहुँच गए हैं। इस पोस्ट में आपने टेन्सर से लेकर Automatic Differentiation तक बहुत सी बातें कवर कीं! आपने PyTorch और उसके टेन्सर सिस्टम का उपयोग करके एक सरल न्यूरल नेट भी लागू किया।
यदि आप PyTorch के बारे में और सीखना चाहते हैं और इसमें गहराई तक जाना चाहते हैं, तो PyTorch का आधिकारिक प्रलेखन और ट्यूटोरियल देखें। वे वाकई बहुत अच्छे से लिखे गए हैं। आप उन्हें यहाँ पा सकते हैं।
निम्न संदर्भों ने यह ट्यूटोरियल लिखने में मेरी मदद की:
यदि आपके पास कुछ पूछना या चर्चा करना हो तो कमेंट सेक्शन में बताएँ!
यदि आप Python के बारे में और सीखने में रुचि रखते हैं, तो DataCamp का Statistical Thinking in Python (Part 1) लें।
Python और PyTorch के बारे में और जानें
कोर्स
कोर्स