Cursus
Introductie tot Deep Learning in Python
4 uur
264.7K
In deep learning wordt vaak veel gesproken over tensors als de hoeksteen onder de datastructuren. Tensor komt zelfs voor in de naam van Google’s toonaangevende machine learning-bibliotheek: “TensorFlow”. Tensors zijn een type datastructuur uit de lineaire algebra en, net als vectoren en matrices, kun je rekenkundige bewerkingen uitvoeren met tensors.
PyTorch is daarentegen een Python-pakket ontwikkeld door Facebook dat twee high-level features biedt: 1) Tensorberekeningen (zoals Numpy) met krachtige GPU-versnelling en 2) Deep Neural Networks gebouwd op een tape-based systeem voor automatische differentiatie.
In deze tutorial ontdek je wat tensors zijn en hoe je ze met PyTorch in Python manipuleert.
Dus, zonder verder oponthoud: aan de slag met de introductie tot Tensors.
Een tensor is een generalisatie van vectoren en matrices en kun je het best begrijpen als een multidimensionale array. Volgens het populaire deep learning-boek “Deep Learning” (Goodfellow e.a.) -
"In het algemene geval staat een reeks getallen, gerangschikt op een regelmatig rooster met een variabel aantal assen, bekend als een tensor."
Een scalair is een tensor van orde nul of rang nul. Een vector is eendimensionaal of een tensor van de eerste orde, en een matrix is tweedimensionaal of een tensor van de tweede orde.
De volgende infographic beschrijft tensors op een heel overzichtelijke manier:
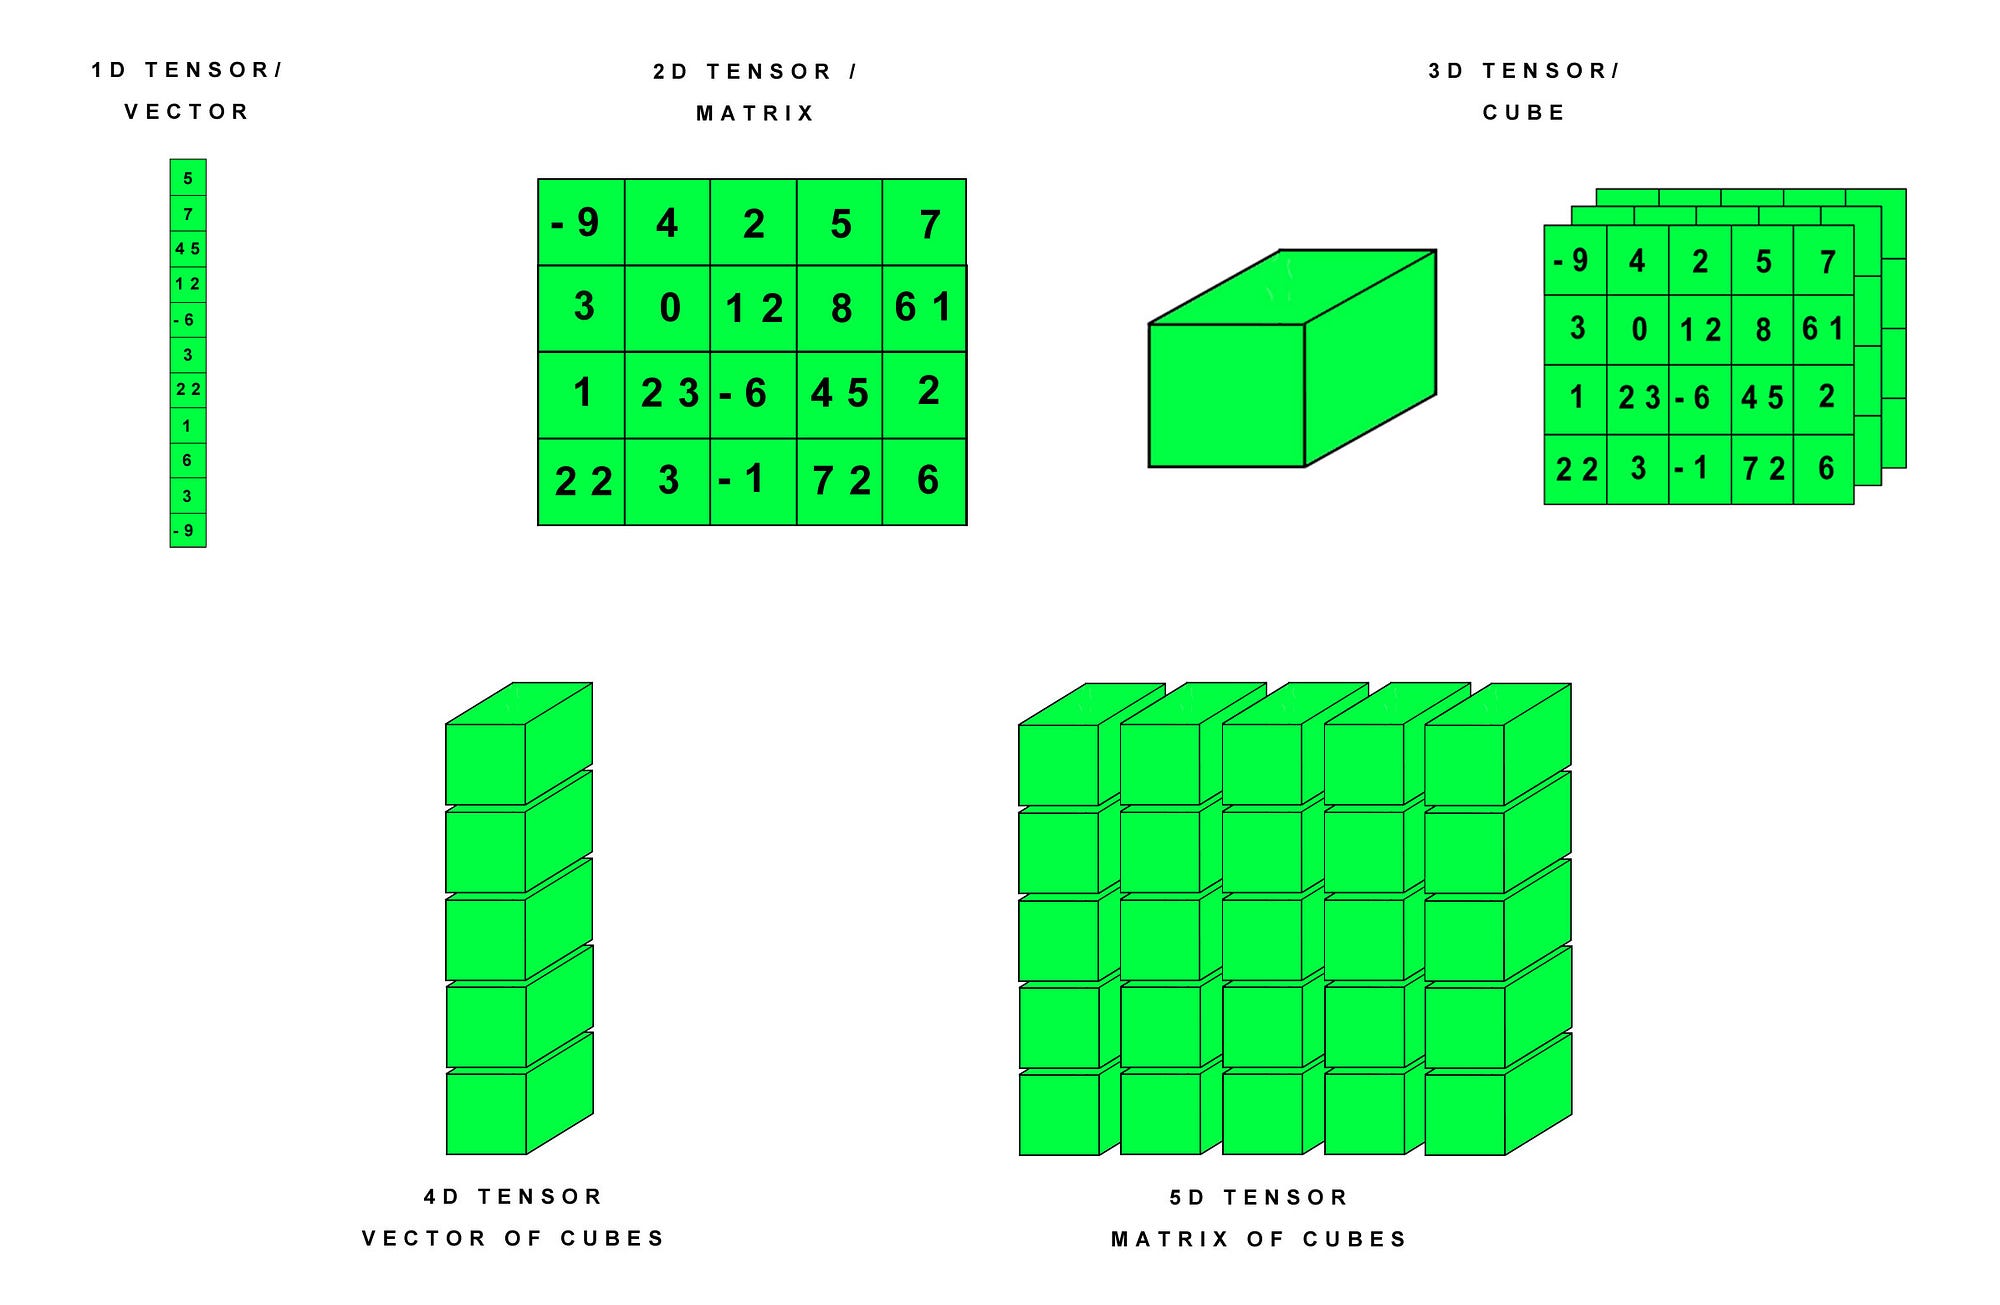
Laten we nu de intuïtie achter tensors op een helderdere manier opbouwen.
Een tensor is de basisbouwsteen van moderne machine learning. In de kern is het een gegevenscontainer. Meestal bevat het getallen. Soms zelfs strings, maar dat is zeldzaam. Zie het dus als een emmer met getallen.
Maar vaak verwarren mensen tensors met multidimensionale arrays. Volgens StackExchange:
Tensors en multidimensionale arrays zijn verschillende soorten objecten. Het eerste is een type functie. Het tweede is een datastructuur die geschikt is om een tensor in een coördinatenstelsel te representeren.
Wiskundig worden tensors gedefinieerd als een multilineaire functie. Een multilineaire functie bestaat uit verschillende vectorvariabelen. Een tensorveld is een tensorwaardige functie. Voor een rigoureuze wiskundige uitleg kun je hier lezen.
Tensors zijn dus functies of containers die je moet definiëren. De feitelijke berekening gebeurt wanneer er data wordt ingevoerd. Wat je ziet als arrays of multidimensionale (1D, 2D, …, ND) structuren kun je beschouwen als generieke tensors.
Nu, laten we het even hebben over de tensornotatie.
Tensornotatie lijkt sterk op matrixnotatie, met een hoofdletter die een tensor voorstelt en kleine letters met subscripten die scalairwaarden binnen de tensor voorstellen.

Veel van de bewerkingen die je met scalairen, vectoren en matrices kunt uitvoeren, kun je herformuleren om met tensors te worden uitgevoerd.
Als hulpmiddel worden tensors en tensoralgebra veel gebruikt in de fysica en de techniek. Het is een term en een verzameling technieken die in machine learning, bij het trainen en gebruiken van deep learning-modellen, in termen van tensors kunnen worden beschreven.
PyTorch is een op Python gebaseerd wetenschappelijk rekenpakket gericht op:
Laten we de unieke eigenschappen van PyTorch kort samenvatten -
PyTorch biedt een brede variëteit aan tensor-routines om je wetenschappelijke berekeningen te versnellen en te ondersteunen, zoals slicing, indexering, wiskundige operaties, lineaire algebra, reducties. En ze zijn snel.
PyTorch heeft een unieke manier om neurale netwerken te bouwen: met het gebruik en het afspelen van een bandrecorder.
De meeste frameworks zoals TensorFlow, Theano, Caffe en CNTK hebben een statische kijk op de wereld. Je moet een neuraal netwerk bouwen en steeds dezelfde structuur hergebruiken. Als je het gedrag van het netwerk wilt veranderen, moet je opnieuw beginnen.
PyTorch gebruikt een techniek genaamd reverse-mode automatische differentiatie, waarmee je het gedrag van je netwerk willekeurig kunt aanpassen zonder vertraging of overhead. Onze inspiratie komt uit verschillende onderzoekspapers over dit onderwerp, evenals uit huidig en verleden werk zoals autograd, autograd, Chainer, enz.
(Hoewel deze techniek niet uniek is voor PyTorch, is het een van de snelste implementaties tot nu toe. Je krijgt het beste van snelheid en flexibiliteit voor je wilde research.)
(Daarom is PyTorch behoorlijk snel – of je nu kleine of grote neurale netwerken draait.)
Deze blog vergelijkt PyTorch en TensorFlow uitstekend.
P.S.: Deze DataCamp-blog is een uitstekende start om met TensorFlow te beginnen.
De installatie van PyTorch is vrij eenvoudig. Omdat PyTorch efficiënte GPU-berekeningen ondersteunt, communiceert het effectief met je Cuda-stuurprogramma’s en voert het dingen sneller uit.
Je hebt torch en torchvision nodig om PyTorch te gebruiken. Laten we ze installeren voor een Windows-omgeving. Later zie je ook de stappen voor Linux en Mac.
Ik heb Python 3.5 met Anaconda geïnstalleerd. Ook heb ik geen CUDA. Voer de volgende commando’s uit om torch en torchvision te installeren:
(Houd er rekening mee dat PyTorch Python 2.7 niet ondersteunt. Je hebt dus een Python-versie => 3.5 nodig.)
Als je CUDA op je machine hebt ingeschakeld, voel je vrij om het volgende uit te voeren (dit is voor CUDA 9.0):
Nu, laten we de installatie-stappen bekijken voor een Linux-omgeving met Python 3.5 en zonder CUDA-ondersteuning:
Ja, je raadt het al! Het is hetzelfde als op Windows.
Als je nu CUDA-ondersteuning (9.0) hebt dan is de stap:
Voor een Mac-omgeving met Python 3.5 en zonder CUDA-ondersteuning zijn de stappen:
En, met CUDA-ondersteuning (9.0):
(MacOS-binaries ondersteunen geen CUDA, installeer vanuit bron als CUDA nodig is)
Hopelijk ben je inmiddels klaar met de installatie van PyTorch!
Laten we nu meteen duiken in wat tensorrekenkunde met PyTorch.
Eerst importeren we alle vereiste bibliotheken.
from __future__ import print_function
import torch
Als de installatie van PyTorch is gelukt, geven de bovenstaande code-regels geen errors.
Laten we nu een 5x3-matrix construeren, niet-geïnitialiseerd:
x = torch.rand(5, 3)
print(x)
tensor([[ 0.5991,  0.9365,  0.6120],
        [ 0.3622,  0.1408,  0.8811],
        [ 0.6248,  0.4808,  0.0322],
        [ 0.2267,  0.3715,  0.8430],
        [ 0.0145,  0.0900,  0.3418]])
Construeer een matrix gevuld met nullen en van het gegevenstype long:
x = torch.zeros(5, 3, dtype=torch.long)
print(x)
tensor([[ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0]])
Construeer een tensor direct uit data:
x = torch.tensor([5.5, 3])
print(x)
tensor([ 5.5000, 3.0000])
Als je Tensors goed hebt begrepen, vertel me dan in de reacties wat voor soort Tensor x is!
Je kunt een tensor maken op basis van een bestaande tensor. Deze methoden hergebruiken eigenschappen van de invoertensor, bijv. dtype (gegevenstype), tenzij de gebruiker nieuwe waarden opgeeft:
x = x.new_ones(5, 3, dtype=torch.double)
print(x)

x = torch.randn_like(x, dtype=torch.float)
print(x)
tensor([[ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.]], dtype=torch.float64)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
Haal de grootte op:
print(x.size())
torch.Size([5, 3])
Merk op dat torch.Size in feite een tuple is, dus alle tuple-bewerkingen ondersteunt.
Nu doen we een optelling op Tensors.
De elementgewijze optelling van twee tensors met dezelfde afmetingen resulteert in een nieuwe tensor met dezelfde afmetingen waarbij elke scalairwaarde de elementgewijze som is van de scalairen in de oorspronkelijke tensors.

# Syntax 1 for Tensor addition in PyTorch
y = torch.rand(5, 3)
print(x)
print(y)
print(x + y)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
tensor([[ 0.8285,  0.7619,  0.1147],
        [ 0.1624,  0.8994,  0.6119],
        [ 0.2802,  0.2950,  0.7098],
        [ 0.8132,  0.3382,  0.4383],
        [ 0.6738,  0.2022,  0.3264]])
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
# Syntax 2 for Tensor addition in PyTorch
print(torch.add(x, y))
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
Laten we nu Tensoraftrekking doen.
De elementgewijze aftrekking van de ene tensor van een andere tensor met dezelfde afmetingen resulteert in een nieuwe tensor met dezelfde afmetingen waarbij elke scalairwaarde de elementgewijze aftrekking is van de scalairen in de oorspronkelijke tensors.

Kijk nu naar het tensorproduct:
Voert een matrixvermenigvuldiging uit van de matrices mat1 en mat2.
Als mat1 een (n×m)-tensor is en mat2 een (m×p)-tensor, dan is de uitkomst een (n×p)-tensor.
Je doet tensorproducten in PyTorch als volgt:
mat1 = torch.randn(2, 3)
mat2 = torch.randn(3, 3)
print(mat1)
print(mat2)
print(torch.mm(mat1, mat2))
tensor([[ 1.9490, -0.6503, -1.9448],
        [-0.7126,  1.0519, -0.4250]])
tensor([[ 0.0846,  0.4410, -0.0625],
        [-1.3264, -0.5265,  0.2575],
        [-1.3324,  0.6644,  0.3528]])
tensor([[ 3.6185, -0.0901, -0.9753],
        [-0.8892, -1.1504,  0.1654]])
Merk op dat torch.mm() niet broadcast. Laten we het hebben over broadcasting.
De term broadcasting beschrijft hoe arrays met verschillende vormen worden behandeld tijdens rekenkundige operaties. Onder bepaalde voorwaarden wordt de kleinere array “uitgezonden” over de grotere array zodat ze compatibele vormen hebben. Broadcasting biedt een manier om array-operaties te vectoriseren zodat lussen in C plaatsvinden in plaats van in Python. Dit gebeurt zonder onnodige kopieën van data te maken en leidt meestal tot efficiënte algoritmen. Er zijn echter gevallen waarin broadcasting geen goed idee is omdat het leidt tot inefficiënt geheugengebruik dat de berekening vertraagt.
Twee tensors zijn “broadcastable” als de volgende regels gelden:
Begrijp dit met PyTorch met het volgende codefragment:
x=torch.empty(5,7,3)
y=torch.empty(5,7,3)
# same shapes are always broadcastable (i.e. the above rules always hold)
x=torch.empty((0,))
y=torch.empty(2,2)
# x and y are not broadcastable, because x does not have at least 1 dimension
# can line up trailing dimensions
x=torch.empty(5,3,4,1)
y=torch.empty(  3,1,1)
# x and y are broadcastable.
# 1st trailing dimension: both have size 1
# 2nd trailing dimension: y has size 1
# 3rd trailing dimension: x size == y size
# 4th trailing dimension: y dimension doesn't exist
# but:
>>> x=torch.empty(5,2,4,1)
>>> y=torch.empty(  3,1,1)
# x and y are not broadcastable, because in the 3rd trailing dimension 2 != 3
Nu je een goed idee hebt van broadcasting, laten we bekijken wat de resulterende tensor is als twee tensors "broadcastable" zijn.
Als twee tensors x, y “broadcastable” zijn, wordt de resulterende tensor-grootte als volgt berekend:
Als het aantal dimensies van x en y niet gelijk is, voeg dan vooraan 1 toe aan de dimensies van de tensor met minder dimensies om ze even lang te maken. Vervolgens is voor elke dimensie de resulterende dimensiegrootte de max van de groottes van x en y langs die dimensie. Bijvoorbeeld:
# can line up trailing dimensions to make reading easier
x=torch.empty(5,1,4,1)
y=torch.empty(  3,1,1)
(x+y).size()
torch.Size([5, 3, 4, 1])
torch.Size([5, 3, 4, 1])
# but not necessary:
x=torch.empty(1)
y=torch.empty(3,1,7)
(x+y).size()
torch.Size([3, 1, 7])
torch.Size([3, 1, 7])
x=torch.empty(5,2,4,1)
y=torch.empty(3,1,1)
(x+y).size()
---------------------------------------------------------------------------

RuntimeError                              Traceback (most recent call last)

<ipython-input-17-72fb34250db7> in <module>()
      1 x=torch.empty(5,2,4,1)
      2 y=torch.empty(3,1,1)
----> 3 (x+y).size()


RuntimeError: The size of tensor a (2) must match the size of tensor b (3) at non-singleton dimension 1
Je snapt het nu!
Het tensorproduct is de meest voorkomende vorm van tensormultiplicatie die je tegenkomt, maar er bestaan veel andere soorten tensormultiplicaties, zoals het tensor dot-product en de tensorcontractie.
Het converteren van een Torch Tensor naar een NumPy-array en omgekeerd is kinderspel. Dit concept heet de NumPy-brug. Laten we daar naar kijken.
De Torch Tensor en NumPy-array delen hun onderliggende geheugenlocaties, en het wijzigen van de ene verandert de andere.
Converteer een Torch Tensor naar een NumPy-array.
# A 1D tensor of 5 ones
a = torch.ones(5)
print(a)
tensor([ 1., 1., 1., 1., 1.])
# Convert the Torch tensor to a NumPy array
b = a.numpy()
print(b)
[1. 1. 1. 1. 1.]
Zie hoe de NumPy-array in waarde veranderde.
In de bovenstaande secties heb je wat basis tensorrekenkunde gedaan zoals optellen, aftrekken en tensorproducten. In de volgende sectie implementeer je een eenvoudig neuraal netwerk in PyTorch.
Als je een opfrisser nodig hebt over neurale netwerken, dan is dit DataCamp-artikel de beste om te raadplegen. Mogelijk wil je ook de volgende links bekijken:
Voordat we implementeren, bespreken we kort een concept genaamd automatische differentiatie dat centraal staat in alle neurale netwerken in PyTorch. Dit is vooral handig voor het berekenen van gradiënten tijdens backpropagation.
Het autograd-pakket biedt automatische differentiatie voor alle operaties op Tensors. Het is een define-by-run framework, wat betekent dat je backpropagation wordt gedefinieerd door hoe je code wordt uitgevoerd en dat elke iteratie anders kan zijn.
Laten we automatische differentiatie in actie zien met een eenvoudig codevoorbeeld.
# Create a Rank-2 tensor of all ones
x = torch.ones(2, 2, requires_grad=True)
print(x)
tensor([[ 1.,  1.],
        [ 1.,  1.]])
Voer een optelling uit.
y = x + 2
print(y)
tensor([[ 3.,  3.],
        [ 3.,  3.]])
Voer nog wat bewerkingen uit op y.
z = y * y * 3
out = z.mean()

print(z, out)
tensor([[ 27.,  27.],
        [ 27.,  27.]]) tensor(27.)
Nu doen we backprop, omdat out één enkele scalair bevat, is out.backward() gelijk aan out.backward(torch.tensor(1)).
out.backward()

# print gradients d(out)/dx
print(x.grad)
tensor([[ 4.5000,  4.5000],
        [ 4.5000,  4.5000]])

Nu weet je over automatische differentiatie en hoe PyTorch dit afhandelt. Je gaat nu een eenvoudig neuraal netwerk coderen met PyTorch.
Je maakt een simpel neuraal netwerk met één verborgen laag en één output-unit. Je gebruikt de ReLU-activatie in de verborgen laag en de sigmoid-activatie in de outputlaag.
Eerst moet je de PyTorch-bibliotheek importeren. Neurale netwerken kunnen worden geconstrueerd met het torch.nn-pakket.
import torch
import torch.nn as nn
Daarna definieer je de groottes van alle lagen en de batchgrootte:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
En nu maak je wat dummy inputdata x en wat dummy targetdata y. Je gebruikt PyTorch Tensors om deze data op te slaan. PyTorch Tensors kun je gebruiken en manipuleren net als NumPy-arrays, met het extra voordeel dat PyTorch-tensors op GPU’s kunnen draaien. Voor deze tutorial laat je ze echter gewoon op de CPU draaien. Overigens is het vrij eenvoudig om ze naar een GPU over te zetten.
x = torch.randn(batch_size, n_in)
y = torch.tensor([[1.0], [0.0], [0.0], [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])
En nu definieer je ons model in één regel code.
model = nn.Sequential(nn.Linear(n_in, n_h),
                     nn.ReLU(),
                     nn.Linear(n_h, n_out),
                     nn.Sigmoid())
Dit creëert een model dat eruitziet als input -> linear -> relu -> linear -> sigmoid. Er is nog een manier om je modellen te definiëren die wordt gebruikt voor meer ingewikkelde en aangepaste modellen. Dat doe je door je model in een klasse te definiëren. Je kunt daarover hier lezen.
Nu is het tijd om je verliesfunctie te construeren. Je gebruikt de Mean Squared Error Loss.
criterion = torch.nn.MSELoss()
Vergeet ook niet je optimizer te definiëren. In dit voorbeeld gebruik je de krachtige Stochastic Gradient Descent en een learning rate van 0,01. model.parameters() retourneert een iterator over de parameters (gewichten en biases) van je model.
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
Nu voer je Gradient Descent 50 epochs uit. Dit doet achtereenvolgens de forward-propagation, verliesberekening, backpropagation en parameterupdates.
for epoch in range(50):
    # Forward Propagation
    y_pred = model(x)
    # Compute and print loss
    loss = criterion(y_pred, y)
    print('epoch: ', epoch,' loss: ', loss.item())
    # Zero the gradients
    optimizer.zero_grad()

    # perform a backward pass (backpropagation)
    loss.backward()

    # Update the parameters
    optimizer.step()
epoch:  0  loss:  0.2399429827928543
epoch:  1  loss:  0.23988191783428192
epoch:  2  loss:  0.23982088267803192
epoch:  3  loss:  0.2397598922252655
epoch:  4  loss:  0.23969893157482147
epoch:  5  loss:  0.23963800072669983
epoch:  6  loss:  0.23957709968090057
epoch:  7  loss:  0.23951618373394012
epoch:  8  loss:  0.23945537209510803
epoch:  9  loss:  0.23939454555511475
epoch:  10  loss:  0.23933371901512146
epoch:  11  loss:  0.23927298188209534
epoch:  12  loss:  0.23921218514442444
epoch:  13  loss:  0.23915143311023712
epoch:  14  loss:  0.2390907108783722
epoch:  15  loss:  0.23903003334999084
epoch:  16  loss:  0.23896940052509308
epoch:  17  loss:  0.23890872299671173
epoch:  18  loss:  0.23884813487529755
epoch:  19  loss:  0.23878750205039978
epoch:  20  loss:  0.23872694373130798
epoch:  21  loss:  0.2386663407087326
epoch:  22  loss:  0.2386058121919632
epoch:  23  loss:  0.23854532837867737
epoch:  24  loss:  0.23848481476306915
epoch:  25  loss:  0.23842433094978333
epoch:  26  loss:  0.2383638620376587
epoch:  27  loss:  0.23830339312553406
epoch:  28  loss:  0.2382429838180542
epoch:  29  loss:  0.23818258941173553
epoch:  30  loss:  0.2381247729063034
epoch:  31  loss:  0.2380656749010086
epoch:  32  loss:  0.23800739645957947
epoch:  33  loss:  0.2379491776227951
epoch:  34  loss:  0.2378900945186615
epoch:  35  loss:  0.23783239722251892
epoch:  36  loss:  0.23777374625205994
epoch:  37  loss:  0.23771481215953827
epoch:  38  loss:  0.23765745759010315
epoch:  39  loss:  0.23759838938713074
epoch:  40  loss:  0.23753997683525085
epoch:  41  loss:  0.2374821901321411
epoch:  42  loss:  0.23742322623729706
epoch:  43  loss:  0.23736533522605896
epoch:  44  loss:  0.23730707168579102
epoch:  45  loss:  0.23724813759326935
epoch:  46  loss:  0.23719079792499542
epoch:  47  loss:  0.23713204264640808
epoch:  48  loss:  0.23707345128059387
epoch:  49  loss:  0.2370160073041916
y_pred krijgt de voorspelde waarden uit een forward pass van ons model. Je geeft dit, samen met targetwaarden y, door aan de criterion die het verlies berekent.
Vervolgens zet optimizer.zero_grad() alle gradiënten op nul. Dit moet je doen zodat eerdere gradiënten niet blijven ophopen.
Daarna is loss.backward() de belangrijkste PyTorch-magic die gebruikmaakt van PyTorch’ Autograd. Autograd berekent automatisch alle gradiënten t.o.v. alle parameters op basis van de computation graph die het dynamisch creëert. Kortom, dit doet de backward pass (backpropagation) van gradient descent.
Tot slot roep je optimizer.step() aan, wat een enkele update van alle parameters uitvoert met de nieuwe gradiënten.
Zo, je bent tot het einde gekomen. In deze post heb je van alles behandeld, van Tensors tot automatische differentiatie en meer! Je hebt ook een eenvoudig neuraal netwerk geïmplementeerd met PyTorch en het tensorsysteem.
Als je meer wilt leren over PyTorch en dieper wilt duiken, bekijk dan de officiële documentatie en tutorials van PyTorch. Die zijn echt goed geschreven. Je vindt ze hier.
De volgende referenties hielpen me bij het schrijven van deze tutorial:
Laat het me weten als je iets wilt vragen of bespreken in de reacties!
Als je meer over Python wilt leren, volg dan DataCamp’s Statistical Thinking in Python (Part 1).
Leer meer over Python en PyTorch
Cursus
Cursus
blog
Adel Nehme
15 min

