Khóa học
Nhập môn Deep Learning với Python
4 giờ
264.8K
Trong học sâu, các cuộc thảo luận về tensor thường xuất hiện rất nhiều như một cấu trúc dữ liệu nền tảng. Tensor thậm chí còn xuất hiện trong tên thư viện máy học chủ lực của Google: “TensorFlow”. Tensor là một loại cấu trúc dữ liệu dùng trong đại số tuyến tính, và tương tự vector, ma trận, bạn có thể thực hiện các phép toán số học với tensor.
Mặt khác, PyTorch là một gói Python do Facebook xây dựng, cung cấp hai tính năng cấp cao: 1) Tính toán Tensor (giống Numpy) với khả năng tăng tốc GPU mạnh mẽ và 2) Mạng nơ-ron sâu được xây dựng trên hệ thống vi phân tự động dựa trên băng ghi (tape-based).
Trong hướng dẫn này, bạn sẽ khám phá tensor là gì và cách thao tác với chúng trong Python bằng PyTorch.
Vậy thì, không dài dòng nữa, hãy bắt đầu với phần giới thiệu về Tensor.
Một tensor là sự khái quát hóa của vector và ma trận, có thể hiểu đơn giản là một mảng đa chiều. Theo cuốn sách học sâu phổ biến “Deep Learning” (Goodfellow và cộng sự) -
“Trong trường hợp tổng quát, một mảng các số được sắp xếp trên một lưới đều với số trục thay đổi được gọi là tensor.”
Một vô hướng (scalar) là tensor bậc không. Một vector là tensor một chiều hay bậc một, và một ma trận là tensor hai chiều hay bậc hai.
Đồ họa thông tin sau mô tả về tensor theo cách rất trực quan:
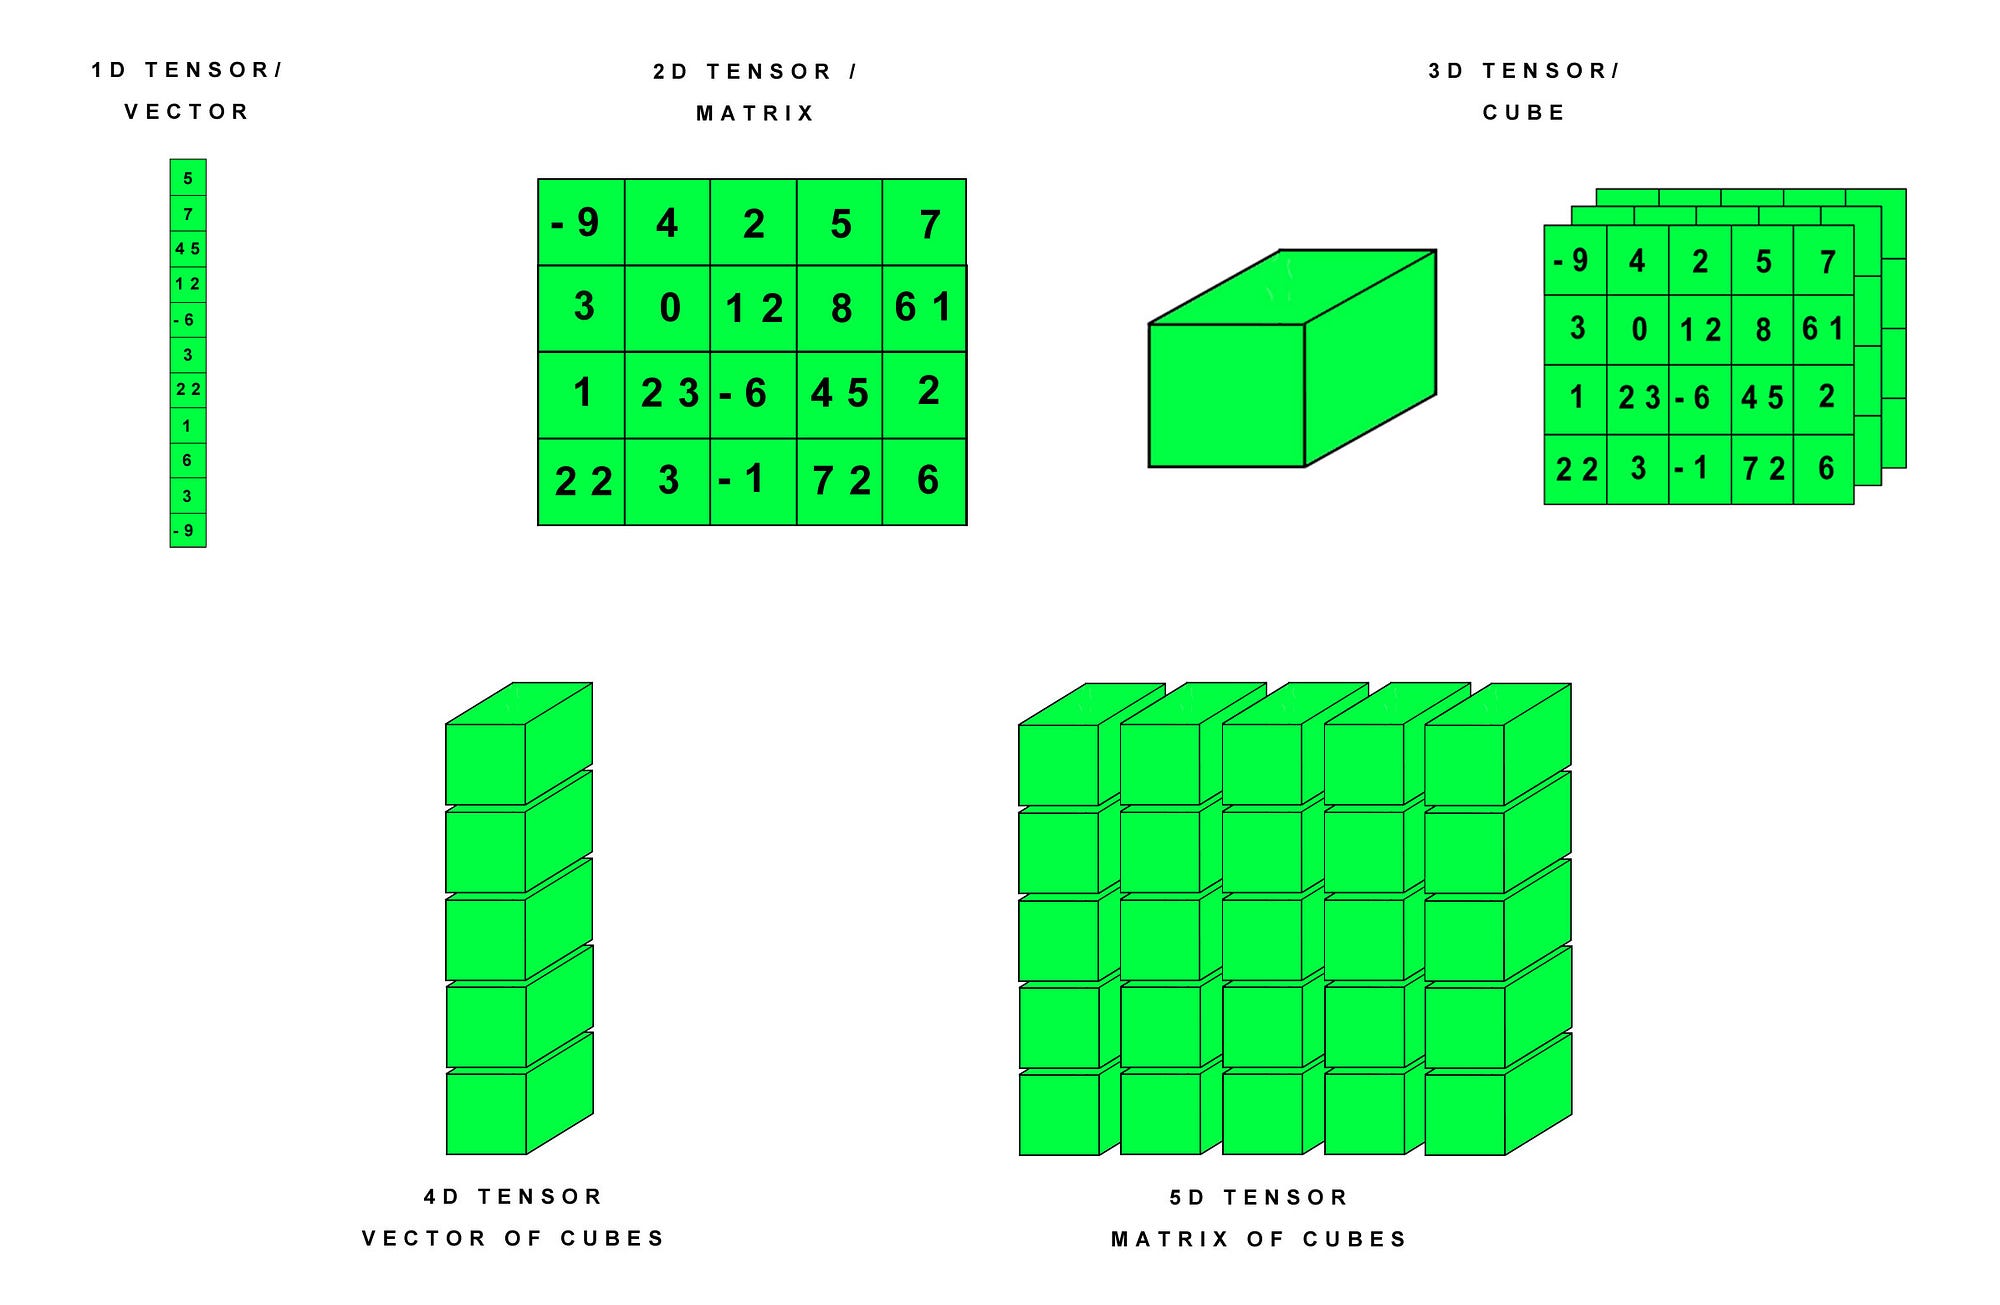
Giờ hãy xây dựng trực giác phía sau tensor theo cách dễ hiểu hơn.
Tensor là khối xây dựng cơ bản của học máy hiện đại. Về cốt lõi, đó là một “vật chứa” dữ liệu. Chủ yếu chứa các con số. Đôi khi còn có chuỗi, nhưng hiếm. Hãy hình dung nó như một “xô” số liệu.
Tuy nhiên, mọi người thường nhầm lẫn tensor với mảng đa chiều. Theo StackExchange:
Tensor và mảng đa chiều là các loại đối tượng khác nhau. Cái đầu tiên là một loại hàm. Cái thứ hai là một cấu trúc dữ liệu phù hợp để biểu diễn một tensor trong một hệ tọa độ.
Về mặt toán học, tensor được định nghĩa là một hàm đa tuyến tính. Một hàm đa tuyến tính gồm nhiều biến vector. Một trường tensor là một hàm nhận giá trị là tensor. Để có lời giải thích toán học chặt chẽ, bạn có thể đọc tại đây.
Vì vậy, tensor là các hàm hoặc “vật chứa” mà bạn cần định nghĩa. Việc tính toán thực sự diễn ra khi có dữ liệu được nạp vào. Những gì bạn thấy như mảng hay đa chiều (1D, 2D, …, ND) có thể coi là các tensor tổng quát.
Bây giờ, hãy nói một chút về ký hiệu Tensor.
Ký hiệu tensor khá giống ký hiệu ma trận, với chữ cái viết hoa biểu diễn tensor và chữ thường với chỉ số dưới là các giá trị vô hướng bên trong tensor.

Nhiều phép toán có thể thực hiện với vô hướng, vector, ma trận cũng có thể được viết lại để thực hiện với tensor.
Như một công cụ, tensor và đại số tensor được sử dụng rộng rãi trong vật lý và kỹ thuật. Trong học máy, các thuật ngữ và kỹ thuật dùng trong huấn luyện, vận hành mô hình học sâu cũng có thể được mô tả thông qua tensor.
PyTorch là một gói tính toán khoa học dựa trên Python, hướng tới:
Hãy tóm tắt nhanh các tính năng độc đáo của PyTorch -
PyTorch cung cấp nhiều hàm thao tác tensor để tăng tốc và đáp ứng nhu cầu tính toán khoa học của bạn như cắt lát, đánh chỉ số, phép toán số học, đại số tuyến tính, phép rút gọn. Và chúng rất nhanh.
PyTorch có cách xây dựng mạng nơ-ron độc đáo: sử dụng và phát lại như một máy ghi băng.
Hầu hết các framework như TensorFlow, Theano, Caffe và CNTK có cái nhìn tĩnh về thế giới. Bạn phải xây dựng một mạng nơ-ron và tái sử dụng cùng cấu trúc đó lặp đi lặp lại. Thay đổi cách mạng hoạt động có nghĩa là phải bắt đầu lại từ đầu.
PyTorch sử dụng kỹ thuật gọi là vi phân tự động chế độ ngược (Reverse-mode auto-differentiation), cho phép bạn thay đổi hành vi mạng một cách tùy ý mà không có độ trễ hoặc chi phí phụ. Cảm hứng của chúng tôi đến từ nhiều bài báo nghiên cứu về chủ đề này, cũng như những công trình hiện tại và trước đây như autograd, autograd, Chainer, v.v.
(Dù kỹ thuật này không phải là độc quyền của PyTorch, đây là một trong những triển khai nhanh nhất cho đến nay. Bạn có được cả tốc độ lẫn sự linh hoạt cho những nghiên cứu táo bạo của mình.)
(Vì vậy, PyTorch khá nhanh – dù bạn chạy mạng nơ-ron nhỏ hay lớn.)
Bài viết này so sánh PyTorch và TensorFlow rất rõ ràng.
P.S.: Bài blog DataCamp này là điểm khởi đầu tuyệt vời để bắt đầu với TensorFlow.
Cài đặt PyTorch khá đơn giản. Vì PyTorch hỗ trợ tính toán GPU hiệu quả, nó giao tiếp tốt với các trình điều khiển Cuda của bạn và thực thi nhanh hơn.
Bạn sẽ cần torch và torchvision để dùng PyTorch. Hãy cài chúng trong môi trường Windows. Sau đó, bạn sẽ thấy các bước cho Linux và Mac.
Tôi có Python 3.5 với thiết lập Anaconda. Ngoài ra, tôi không có CUDA. Chạy các lệnh sau để cài torch và torchvision:
(Lưu ý PyTorch không hỗ trợ Python 2.7. Vì vậy bắt buộc phải có Python phiên bản => 3.5.)
Nếu máy bạn có CUDA, hãy chạy các lệnh sau (dành cho CUDA 9.0):
Bây giờ, đến các bước cài đặt trong môi trường Linux với Python 3.5 và không có CUDA:
Đúng rồi! Nó giống hệt như trên Windows.
Nếu bạn có hỗ trợ CUDA (9.0) thì bước sẽ là:
Với môi trường Mac dùng Python 3.5 và không có CUDA, các bước sẽ là:
Và nếu có CUDA (9.0):
(Các gói nhị phân MacOS không hỗ trợ CUDA, hãy biên dịch từ mã nguồn nếu cần CUDA)
Hy vọng đến đây bạn đã cài đặt xong PyTorch!
Giờ hãy đi thẳng vào một số phép toán Tensor với PyTorch.
Trước tiên, hãy import tất cả thư viện cần thiết.
from __future__ import print_function
import torch
Nếu cài đặt PyTorch thành công, chạy các dòng mã trên sẽ không báo lỗi.
Bây giờ, hãy tạo một ma trận 5x3, chưa khởi tạo:
x = torch.rand(5, 3)
print(x)
tensor([[ 0.5991,  0.9365,  0.6120],
        [ 0.3622,  0.1408,  0.8811],
        [ 0.6248,  0.4808,  0.0322],
        [ 0.2267,  0.3715,  0.8430],
        [ 0.0145,  0.0900,  0.3418]])
Tạo một ma trận toàn số 0 với kiểu dữ liệu long:
x = torch.zeros(5, 3, dtype=torch.long)
print(x)
tensor([[ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0]])
Tạo một tensor trực tiếp từ dữ liệu:
x = torch.tensor([5.5, 3])
print(x)
tensor([ 5.5000, 3.0000])
Nếu bạn đã hiểu đúng về Tensor, hãy cho tôi biết x là tensor loại nào trong phần bình luận!
Bạn có thể tạo một tensor dựa trên một tensor có sẵn. Các phương thức này sẽ tái sử dụng thuộc tính của tensor đầu vào, ví dụ dtype (kiểu dữ liệu), trừ khi người dùng cung cấp giá trị mới:
x = x.new_ones(5, 3, dtype=torch.double)
print(x)

x = torch.randn_like(x, dtype=torch.float)
print(x)
tensor([[ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.]], dtype=torch.float64)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
Lấy kích thước của nó:
print(x.size())
torch.Size([5, 3])
Lưu ý rằng torch.Size thực chất là một tuple, nên nó hỗ trợ mọi thao tác của tuple.
Bây giờ, hãy thực hiện phép cộng trên Tensor.
Phép cộng theo phần tử của hai tensor có cùng kích thước tạo ra một tensor mới có cùng kích thước, trong đó mỗi giá trị vô hướng là phép cộng theo phần tử của các vô hướng trong các tensor gốc.

# Cú pháp 1 để cộng Tensor trong PyTorch
y = torch.rand(5, 3)
print(x)
print(y)
print(x + y)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
tensor([[ 0.8285,  0.7619,  0.1147],
        [ 0.1624,  0.8994,  0.6119],
        [ 0.2802,  0.2950,  0.7098],
        [ 0.8132,  0.3382,  0.4383],
        [ 0.6738,  0.2022,  0.3264]])
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
# Cú pháp 2 để cộng Tensor trong PyTorch
print(torch.add(x, y))
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
Giờ hãy thực hiện phép trừ Tensor.
Phép trừ theo phần tử của một tensor khỏi một tensor khác cùng kích thước tạo ra một tensor mới cùng kích thước, trong đó mỗi giá trị vô hướng là phép trừ theo phần tử của các vô hướng trong các tensor gốc.

Bây giờ hãy xem Tích Tensor:
Thực hiện phép nhân ma trận giữa hai ma trận mat1 và mat2.
Nếu mat1 là tensor (n×m), mat2 là tensor (m×p), thì kết quả sẽ là tensor (n×p).
Bạn thực hiện tích Tensor trong PyTorch như sau:
mat1 = torch.randn(2, 3)
mat2 = torch.randn(3, 3)
print(mat1)
print(mat2)
print(torch.mm(mat1, mat2))
tensor([[ 1.9490, -0.6503, -1.9448],
        [-0.7126,  1.0519, -0.4250]])
tensor([[ 0.0846,  0.4410, -0.0625],
        [-1.3264, -0.5265,  0.2575],
        [-1.3324,  0.6644,  0.3528]])
tensor([[ 3.6185, -0.0901, -0.9753],
        [-0.8892, -1.1504,  0.1654]])
Lưu ý torch.mm() không broadcast. Hãy bàn một chút về broadcasting.
Thuật ngữ broadcasting mô tả cách xử lý các mảng có hình dạng khác nhau trong các phép toán số học. Với một số ràng buộc nhất định, mảng nhỏ hơn sẽ được “phát sóng” trên mảng lớn hơn để chúng có hình dạng tương thích. Broadcasting cho phép vector hóa các phép toán mảng để vòng lặp diễn ra trong C thay vì Python. Nó làm điều này mà không tạo các bản sao dữ liệu không cần thiết và thường dẫn đến các triển khai thuật toán hiệu quả. Tuy vậy, có những trường hợp broadcasting không phù hợp vì gây sử dụng bộ nhớ kém hiệu quả, làm chậm tính toán.
Hai tensor “có thể broadcast” nếu thỏa mãn các quy tắc sau:
Hãy hiểu điều này trong PyTorch với đoạn mã sau:
x=torch.empty(5,7,3)
y=torch.empty(5,7,3)
# các hình dạng giống hệt nhau luôn có thể broadcast (tức luôn thỏa các quy tắc trên)
x=torch.empty((0,))
y=torch.empty(2,2)
# x và y không thể broadcast, vì x không có ít nhất 1 chiều
# có thể căn thẳng các chiều cuối
x=torch.empty(5,3,4,1)
y=torch.empty(  3,1,1)
# x và y có thể broadcast.
# Chiều cuối cùng: cả hai có kích thước 1
# Chiều cuối thứ 2: y có kích thước 1
# Chiều cuối thứ 3: kích thước x == kích thước y
# Chiều cuối thứ 4: chiều của y không tồn tại
# nhưng:
>>> x=torch.empty(5,2,4,1)
>>> y=torch.empty(  3,1,1)
# x và y không thể broadcast, vì ở chiều cuối thứ 3 thì 2 != 3
Giờ khi bạn đã nắm tương đối về broadcasting, hãy xem nếu hai tensor “có thể broadcast” thì tensor kết quả sẽ như thế nào.
Nếu hai tensor x, y “có thể broadcast”, kích thước tensor kết quả được tính như sau:
Nếu số chiều của x và y không bằng nhau, hãy thêm 1 vào phía trước các chiều của tensor có ít chiều hơn để chúng có cùng độ dài. Sau đó, với mỗi kích thước chiều, kích thước kết quả là giá trị lớn nhất giữa kích thước của x và y trên chiều đó. Ví dụ:
# có thể căn thẳng các chiều cuối để dễ đọc
x=torch.empty(5,1,4,1)
y=torch.empty(  3,1,1)
(x+y).size()
torch.Size([5, 3, 4, 1])
torch.Size([5, 3, 4, 1])
# nhưng không bắt buộc:
x=torch.empty(1)
y=torch.empty(3,1,7)
(x+y).size()
torch.Size([3, 1, 7])
torch.Size([3, 1, 7])
x=torch.empty(5,2,4,1)
y=torch.empty(3,1,1)
(x+y).size()
---------------------------------------------------------------------------

RuntimeError                              Traceback (most recent call last)

<ipython-input-17-72fb34250db7> in <module>()
      1 x=torch.empty(5,2,4,1)
      2 y=torch.empty(3,1,1)
----> 3 (x+y).size()


RuntimeError: The size of tensor a (2) must match the size of tensor b (3) at non-singleton dimension 1
Bạn đã hiểu khái niệm rồi!
Tích tensor là dạng nhân tensor phổ biến nhất mà bạn sẽ gặp, nhưng còn nhiều dạng nhân tensor khác, như tích vô hướng tensor và co tensor (tensor contraction).
Chuyển đổi giữa Torch Tensor và mảng NumPy rất đơn giản. Khái niệm này gọi là Numpy Bridge. Hãy xem qua.
Torch Tensor và mảng NumPy sẽ chia sẻ cùng vùng nhớ bên dưới, nên thay đổi một bên sẽ làm bên kia thay đổi theo.
Chuyển một Torch Tensor sang mảng NumPy.
# Một tensor 1D gồm 5 số một
a = torch.ones(5)
print(a)
tensor([ 1., 1., 1., 1., 1.])
# Chuyển tensor Torch sang mảng NumPy
b = a.numpy()
print(b)
[1. 1. 1. 1. 1.]
Hãy xem cách mảng NumPy thay đổi giá trị.
Vậy là ở các phần trên, bạn đã thực hiện một số phép toán Tensor cơ bản như cộng, trừ và tích tensor. Giờ trong phần tiếp theo, bạn sẽ triển khai một mạng nơ-ron cơ bản trong PyTorch.
Nếu bạn cần ôn lại về mạng nơ-ron, thì bài viết này của DataCamp là tài liệu tốt nhất để xem. Bạn cũng có thể tham khảo các liên kết sau:
Trước khi triển khai, hãy thảo luận một chút về khái niệm Vi phân tự động (Automatic Differentiation), trọng tâm của mọi mạng nơ-ron trong PyTorch. Điều này đặc biệt hữu ích để tính gradient trong quá trình lan truyền ngược.
Gói autograd cung cấp vi phân tự động cho tất cả các phép toán trên Tensor. Đây là một framework “định nghĩa theo lần chạy”, nghĩa là lan truyền ngược của bạn được xác định bởi cách mã của bạn chạy, và mỗi vòng lặp có thể khác nhau.
Hãy xem Vi phân Tự động hoạt động như thế nào qua ví dụ mã rất đơn giản.
# Tạo một tensor bậc-2 gồm toàn số một
x = torch.ones(2, 2, requires_grad=True)
print(x)
tensor([[ 1.,  1.],
        [ 1.,  1.]])
Thực hiện phép cộng.
y = x + 2
print(y)
tensor([[ 3.,  3.],
        [ 3.,  3.]])
Thực hiện thêm một vài phép toán trên y.
z = y * y * 3
out = z.mean()

print(z, out)
tensor([[ 27.,  27.],
        [ 27.,  27.]]) tensor(27.)
Bây giờ hãy lan truyền ngược, vì out là một vô hướng đơn, out.backward() tương đương với out.backward(torch.tensor(1)).
out.backward()

# in ra gradient d(out)/dx
print(x.grad)
tensor([[ 4.5000,  4.5000],
        [ 4.5000,  4.5000]])

Bây giờ bạn đã biết về Vi phân Tự động và cách PyTorch xử lý nó. Tiếp theo, bạn sẽ viết mã một mạng nơ-ron đơn giản bằng PyTorch.
Bạn sẽ tạo một mạng nơ-ron đơn giản với một tầng ẩn và một đơn vị đầu ra. Bạn sẽ sử dụng hàm kích hoạt ReLU ở tầng ẩn và sigmoid ở tầng đầu ra.
Trước tiên, bạn cần import thư viện PyTorch. Mạng nơ-ron có thể được xây dựng bằng gói torch.nn.
import torch
import torch.nn as nn
Tiếp theo, bạn định nghĩa kích thước của tất cả các tầng và kích thước batch:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
Và bây giờ, bạn sẽ tạo một số dữ liệu đầu vào giả x và dữ liệu mục tiêu giả y. Bạn sẽ dùng PyTorch Tensor để lưu trữ dữ liệu này. PyTorch Tensor có thể được dùng và thao tác giống như mảng NumPy nhưng có thêm lợi thế là có thể chạy trên GPU. Tuy nhiên, trong hướng dẫn này bạn sẽ chạy trên CPU. Dù vậy, việc chuyển sang GPU khá đơn giản.
x = torch.randn(batch_size, n_in)
y = torch.tensor([[1.0], [0.0], [0.0], [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])
Và giờ, bạn sẽ định nghĩa mô hình chỉ trong một dòng mã.
model = nn.Sequential(nn.Linear(n_in, n_h),
                     nn.ReLU(),
                     nn.Linear(n_h, n_out),
                     nn.Sigmoid())
Điều này tạo ra một mô hình như sau: input -> linear -> relu -> linear -> sigmoid. Có một cách khác để định nghĩa mô hình, dùng để xây dựng các mô hình tùy chỉnh và phức tạp hơn: định nghĩa mô hình trong một lớp. Bạn có thể đọc về nó tại đây.
Bây giờ, đến lúc xây dựng hàm mất mát. Bạn sẽ dùng Mean Squared Error Loss.
criterion = torch.nn.MSELoss()
Và đừng quên định nghĩa bộ tối ưu. Bạn sẽ dùng Stochastic Gradient Descent với tốc độ học 0.01. model.parameters() trả về một iterator trên các tham số (trọng số và độ lệch) của mô hình.
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
Giờ bạn sẽ chạy Gradient Descent trong 50 epoch. Trình tự gồm lan truyền thuận, tính mất mát, lan truyền ngược và cập nhật tham số.
for epoch in range(50):
    # Forward Propagation
    y_pred = model(x)
    # Compute and print loss
    loss = criterion(y_pred, y)
    print('epoch: ', epoch,' loss: ', loss.item())
    # Zero the gradients
    optimizer.zero_grad()

    # perform a backward pass (backpropagation)
    loss.backward()

    # Update the parameters
    optimizer.step()
epoch:  0  loss:  0.2399429827928543
epoch:  1  loss:  0.23988191783428192
epoch:  2  loss:  0.23982088267803192
epoch:  3  loss:  0.2397598922252655
epoch:  4  loss:  0.23969893157482147
epoch:  5  loss:  0.23963800072669983
epoch:  6  loss:  0.23957709968090057
epoch:  7  loss:  0.23951618373394012
epoch:  8  loss:  0.23945537209510803
epoch:  9  loss:  0.23939454555511475
epoch:  10  loss:  0.23933371901512146
epoch:  11  loss:  0.23927298188209534
epoch:  12  loss:  0.23921218514442444
epoch:  13  loss:  0.23915143311023712
epoch:  14  loss:  0.2390907108783722
epoch:  15  loss:  0.23903003334999084
epoch:  16  loss:  0.23896940052509308
epoch:  17  loss:  0.23890872299671173
epoch:  18  loss:  0.23884813487529755
epoch:  19  loss:  0.23878750205039978
epoch:  20  loss:  0.23872694373130798
epoch:  21  loss:  0.2386663407087326
epoch:  22  loss:  0.2386058121919632
epoch:  23  loss:  0.23854532837867737
epoch:  24  loss:  0.23848481476306915
epoch:  25  loss:  0.23842433094978333
epoch:  26  loss:  0.2383638620376587
epoch:  27  loss:  0.23830339312553406
epoch:  28  loss:  0.2382429838180542
epoch:  29  loss:  0.23818258941173553
epoch:  30  loss:  0.2381247729063034
epoch:  31  loss:  0.2380656749010086
epoch:  32  loss:  0.23800739645957947
epoch:  33  loss:  0.2379491776227951
epoch:  34  loss:  0.2378900945186615
epoch:  35  loss:  0.23783239722251892
epoch:  36  loss:  0.23777374625205994
epoch:  37  loss:  0.23771481215953827
epoch:  38  loss:  0.23765745759010315
epoch:  39  loss:  0.23759838938713074
epoch:  40  loss:  0.23753997683525085
epoch:  41  loss:  0.2374821901321411
epoch:  42  loss:  0.23742322623729706
epoch:  43  loss:  0.23736533522605896
epoch:  44  loss:  0.23730707168579102
epoch:  45  loss:  0.23724813759326935
epoch:  46  loss:  0.23719079792499542
epoch:  47  loss:  0.23713204264640808
epoch:  48  loss:  0.23707345128059387
epoch:  49  loss:  0.2370160073041916
y_pred nhận các giá trị dự đoán từ một lần lan truyền thuận của mô hình. Bạn truyền giá trị này cùng với giá trị mục tiêu y vào criterion để tính mất mát.
Sau đó, optimizer.zero_grad() đặt tất cả gradient về 0. Bạn cần làm điều này để các gradient trước đó không tiếp tục cộng dồn.
Tiếp theo, loss.backward() là “phép thuật” chính của PyTorch dùng tính năng Autograd. Autograd tự động tính tất cả gradient theo mọi tham số dựa trên đồ thị tính toán tạo động. Về cơ bản, nó thực hiện lan truyền ngược của gradient descent.
Cuối cùng, bạn gọi optimizer.step() để cập nhật một lượt tất cả tham số bằng các gradient mới.
Vậy là bạn đã đến cuối. Trong bài này, bạn đã đi qua rất nhiều nội dung từ Tensor đến Vi phân Tự động và nhiều thứ khác! Bạn cũng đã triển khai một mạng nơ-ron đơn giản bằng PyTorch và hệ thống tensor của nó.
Nếu bạn muốn học thêm về PyTorch và đào sâu hơn, hãy xem tài liệu và hướng dẫn chính thức của PyTorch. Chúng được viết rất tốt. Bạn có thể tìm thấy chúng tại đây.
Sau đây là một số tài liệu tham khảo đã giúp tôi viết hướng dẫn này:
Hãy cho tôi biết nếu bạn có điều gì muốn hỏi hoặc thảo luận trong phần bình luận!
Nếu bạn quan tâm học thêm về Python, hãy học khóa Tư duy thống kê trong Python (Phần 1) của DataCamp.
Tìm hiểu thêm về Python và PyTorch
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
