
Kursus
Model Linear Tergeneralisasi di R
4 jam
22K
Linear discriminant analysis (LDA) sering tersisih oleh algoritme yang lebih populer, principal component analysis (PCA), ketika berbicara tentang reduksi dimensi. Namun, LDA menawarkan sesuatu yang unik yang tidak dimiliki PCA: ia secara simultan mereduksi dimensi sambil mengoptimalkan keterpisahan kelas.
Tutorial ini akan memperkenalkan Anda pada LDA, intuisi matematis di baliknya, dan aplikasi teknik ini di dunia nyata. Selanjutnya, kita akan mengimplementasikan LDA pada sebuah dataset, membandingkannya dengan PCA, serta menganalisis kelebihan dan kekurangannya, dengan tujuan memberikan semua yang Anda perlukan untuk mulai menerapkan LDA di proyek berikutnya.
LDA adalah teknik reduksi dimensi dan klasifikasi dengan asumsi bahwa kelas-kelas berbeda menghasilkan data berdasarkan distribusi Gaussian yang berbeda.
Tujuan LDA adalah menemukan kombinasi linear dari fitur-fitur yang paling baik memisahkan kelas-kelas tersebut. Ia memaksimalkan rasio sebar antar-kelas terhadap sebar dalam-kelas. Sederhananya, LDA berusaha menemukan arah di ruang fitur di mana kelas-kelas berbeda saling berjauhan (sebar antar-kelas tinggi) sementara titik-titik dalam kelas yang sama saling berdekatan (sebar dalam-kelas rendah).
Objektif ganda ini membuat LDA sangat efektif baik untuk tugas reduksi dimensi maupun klasifikasi.
Memahami matematika di balik LDA memerlukan pemecahan algoritme menjadi tiga komponen kunci:
Matriks sebar dalam-kelas mengukur seberapa tersebar titik data di dalam setiap kelas.
Untuk setiap kelas i, kita menghitung matriks sebar Si sebagai:
Si = Σ(x - μi)(x - μi)TDi mana x merepresentasikan setiap titik data dalam kelas i, dan μi adalah mean kelas i. Total matriks sebar dalam-kelas adalah:
Sw = Σ Si (sum over all classes)Matriks sebar antar-kelas mengukur seberapa jauh mean tiap kelas dari mean keseluruhan. Dihitung sebagai:
Sb = Σ Ni(μi - μ)(μi - μ)T Di mana Ni adalah jumlah sampel dalam kelas i, μi adalah mean kelas i, dan μ adalah mean keseluruhan dari semua data.
LDA berupaya menemukan matriks proyeksi W yang memaksimalkan kriteria Fisher:
J(W) = |WT Sb W| / |WT Sw W|Intinya, ini memaksimalkan rasio sebar antar-kelas terhadap sebar dalam-kelas di ruang terproyeksi. Solusinya melibatkan pencarian eigenvector dari matriks Sw-1Sb, yang memberikan arah (disriminan linear) yang paling baik memisahkan kelas-kelas.
Dengan demikian, LDA mereduksi masalah optimisasi yang kompleks ini menjadi sebuah dekomposisi nilai eigen, sehingga efisien secara komputasi bahkan untuk dataset berdimensi cukup tinggi.
Sekarang setelah kita memahami konsep dan intuisi matematis di balik LDA, mari pelajari aplikasinya di dunia nyata.
LDA memiliki aplikasi di berbagai domain yang memerlukan klasifikasi dan reduksi dimensi:
Mari kita telusuri contoh end-to-end penerapan LDA menggunakan Python.
Kita akan menggunakan dataset Seeds, yang dapat diunduh dari perpustakaan UCI maupun dari Kaggle. Dataset ini berisi pengukuran butir gandum yang berasal dari tiga varietas gandum yang berbeda.
Pertama, kita akan mengimpor pustaka yang diperlukan dan memuat dataset kita:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score

# Load the seeds dataset
file_path = "seeds_dataset.txt"
column_names = ['area', 'perimeter', 'compactness', 'kernel_length',
               'kernel_width', 'asymmetry', 'groove_length', 'variety']

# Read the data with whitespace delimiter (space or tab)
seeds_df = pd.read_csv(file_path, sep='\s+', header=None, names=column_names)

print(f"Dataset shape: {seeds_df.shape}")
seeds_df.head()
Kita akan melihat 5 baris pertama dari dataset yang dimuat di bawah ini:
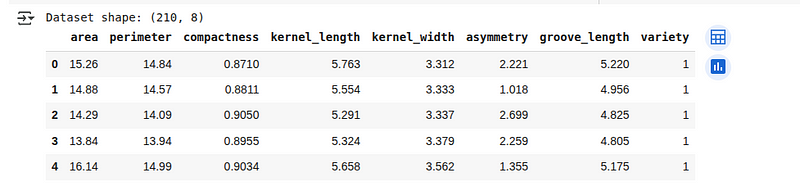 Gambaran umum dataset Seeds. (Gambar oleh Penulis)
Mari kita jelajahi struktur data dan menyiapkannya untuk analisis LDA:
# Check for missing values
print(f"Missing values: {seeds_df.isnull().sum().sum()}")

# Check class distribution
print("\nClass distribution:")
print(seeds_df['variety'].value_counts())

# Separate features and target
X = seeds_df.drop('variety', axis=1)
y = seeds_df['variety']

# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3,
                                                   random_state=42, stratify=y)

# Standardize the features
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
Di sini, kita memeriksa apakah dataset memiliki nilai hilang dan meninjau berapa banyak contoh yang termasuk ke setiap kategori. Lalu, kita menyiapkan data dengan memisahkan masukan dari label, membaginya menjadi bagian pelatihan dan pengujian, serta menstandarkan nilai masukan agar semua fitur berada pada skala yang serupa.
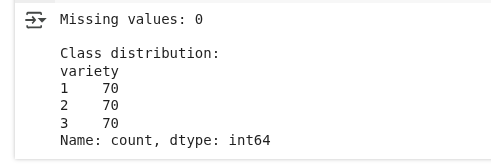
Pra-pemrosesan data. (Gambar oleh Penulis)
Kita melihat bahwa tidak ada nilai hilang, dan distribusi kelas seimbang.
Sekarang kita akan menerapkan LDA untuk mereduksi dimensi data sambil mempertahankan keterpisahan kelas:
# Create and fit LDA model
lda = LinearDiscriminantAnalysis(n_components=2)
X_train_lda = lda.fit_transform(X_train_scaled, y_train)
X_test_lda = lda.transform(X_test_scaled)

# Print explained variance ratio
print("Explained variance ratio:", lda.explained_variance_ratio_)
print("Cumulative explained variance:", np.cumsum(lda.explained_variance_ratio_))
Kita membuat model yang menemukan arah terbaik untuk memisahkan kategori berbeda dalam data. Dengan mereduksi data menjadi dua fitur baru (karena kita memiliki tiga kategori), kita mempertahankan pola paling penting untuk membedakan di antara mereka.
Keluaran adalah sebagai berikut:
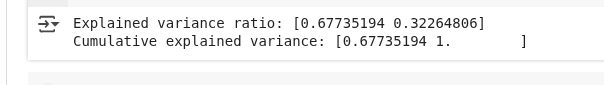 Hasil varians LDA. (Gambar oleh Penulis)
Keluaran ini menunjukkan seberapa banyak informasi pemisah kelas yang ditangkap oleh dua fitur baru yang dibuat oleh LDA:
Mari memvisualisasikan bagaimana LDA mentransformasi data kita dan memisahkan kelas-kelas:
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# Plot the first two original features
ax1.scatter(X_train_scaled[:, 0], X_train_scaled[:, 1],
           c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax1.set_xlabel('Area (standardized)')
ax1.set_ylabel('Perimeter (standardized)')
ax1.set_title('Original Feature Space (First Two Features)')
ax1.grid(True, alpha=0.3)

# Plot LDA-transformed data
scatter = ax2.scatter(X_train_lda[:, 0], X_train_lda[:, 1],
                     c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax2.set_xlabel('First Linear Discriminant')
ax2.set_ylabel('Second Linear Discriminant')
ax2.set_title('LDA-Transformed Space')
ax2.grid(True, alpha=0.3)

plt.colorbar(scatter, ax=ax2, label='Wheat Variety')
plt.tight_layout()
plt.show()
Kode di atas membuat dua bagan berdampingan untuk membantu kita membandingkan seperti apa data sebelum dan sesudah menerapkan teknik reduksi dimensi, seperti yang terlihat di bawah:
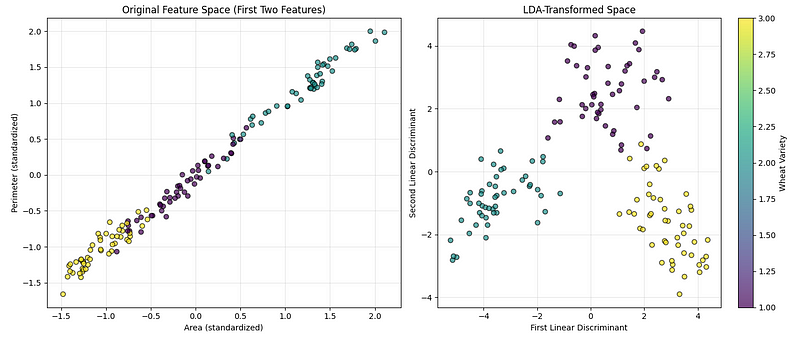 Visualisasi LDA. (Gambar oleh Penulis)
Bagan pertama menunjukkan data asli menggunakan dua fitur yang diukur (luas dan keliling), sehingga kita dapat melihat seberapa baik kategori terpisah secara alami. Bagan kedua menunjukkan data setelah ditransformasikan ke arah paling informatif untuk memisahkan kategori. Sebuah colorbar ditambahkan untuk menunjukkan warna mana yang merepresentasikan jenis gandum tertentu.
LDA juga dapat digunakan langsung sebagai pengklasifikasi.
Mari kita implementasikan:
# Create LDA classifier
lda_classifier = LinearDiscriminantAnalysis()
lda_classifier.fit(X_train_scaled, y_train)

# Make predictions
y_pred = lda_classifier.predict(X_test_scaled)

# Calculate accuracy
accuracy = accuracy_score(y_test, y_pred)
print(f"Classification Accuracy: {accuracy:.4f}")

# Print classification report
print("\nClassification Report:")
print(classification_report(y_test, y_pred))
Kita melatih model untuk mengenali berbagai kategori gandum berdasarkan data pelatihan. Lalu kita menguji kinerjanya pada contoh baru yang belum pernah dilihat dengan memeriksa akurasi keseluruhan dan seberapa baik ia memprediksi tiap kategori.
Kita melihat keluaran berikut:
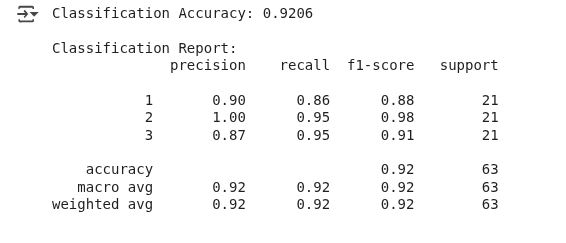
Hasil klasifikasi LDA. (Gambar oleh Penulis)
Model memprediksi jenis gandum dengan benar sekitar 92% dari waktu, yang dapat dianggap sebagai kinerja yang baik.
Contoh ini menunjukkan bahwa meskipun LDA umum digunakan untuk reduksi dimensi, ia juga dapat bertindak sebagai pengklasifikasi dengan memodelkan distribusi probabilitas setiap kelas dan menetapkan data baru ke kelas dengan kemungkinan tertinggi.
Principal Component Analysis adalah teknik reduksi dimensi populer lainnya yang menemukan arah varians maksimum dalam data.
Mari kita perluas contoh sebelumnya untuk membandingkan LDA dengan PCA:
from sklearn.decomposition import PCA
# Apply PCA with 2 components
pca = PCA(n_components=2)
X_train_pca = pca.fit_transform(X_train_scaled)
X_test_pca = pca.transform(X_test_scaled)

# Create comparison visualization
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# Plot PCA results
scatter1 = ax1.scatter(X_train_pca[:, 0], X_train_pca[:, 1],
                      c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax1.set_xlabel('First Principal Component')
ax1.set_ylabel('Second Principal Component')
ax1.set_title(f'PCA Transformation\nExplained Variance: {pca.explained_variance_ratio_.sum():.2%}')
ax1.grid(True, alpha=0.3)

# Plot LDA results
scatter2 = ax2.scatter(X_train_lda[:, 0], X_train_lda[:, 1],
                      c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax2.set_xlabel('First Linear Discriminant')
ax2.set_ylabel('Second Linear Discriminant')
ax2.set_title(f'LDA Transformation\nExplained Variance: {lda.explained_variance_ratio_.sum():.2%}')
ax2.grid(True, alpha=0.3)

plt.colorbar(scatter1, ax=ax1, label='Wheat Variety')
plt.colorbar(scatter2, ax=ax2, label='Wheat Variety')
plt.tight_layout()
plt.show()
Kita melihat plot berikut:
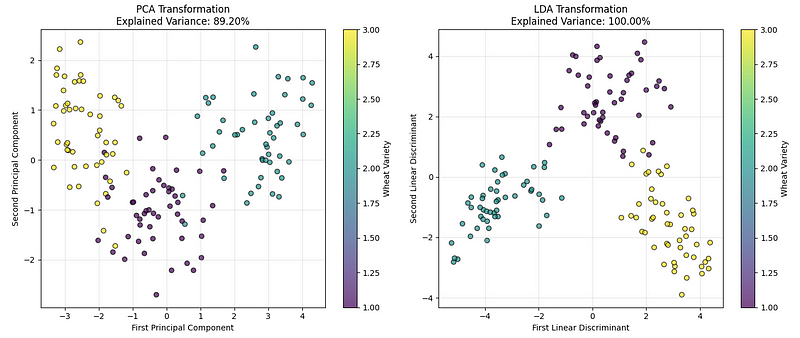 Perbandingan LDA vs. PCA. (Gambar oleh Penulis)
Bagan kiri menampilkan data menggunakan PCA, yang menemukan arah yang menangkap variasi keseluruhan terbanyak dalam data. Bagan kanan menunjukkan hasil LDA, yang menemukan arah yang paling baik memisahkan kategori gandum.
Berdasarkan hasil implementasi dan nilai varians terjelaskan, kita dapat menyimpulkan bahwa meskipun keduanya berkinerja baik, untuk masalah klasifikasi seperti ini, LDA biasanya menciptakan pemisahan antar kelompok yang lebih jelas.
Yang membedakan LDA dari teknik reduksi dimensi lainnya adalah sifatnya yang terawasi. Sementara PCA hanya mempertimbangkan varians dalam data tanpa memperhatikan label kelas, LDA secara eksplisit menggunakan informasi kelas untuk menemukan arah paling diskriminatif. Ini ideal ketika menangani data berdimensi tinggi di mana keterpisahan kelas lebih penting daripada mempertahankan varians keseluruhan.
Dengan demikian, PCA dapat digunakan ketika:
Demikian pula, kita dapat menggunakan LDA ketika:
Seperti algoritme lainnya, LDA memiliki kekuatan dan keterbatasan yang perlu kita perhatikan sebelum menerapkannya dalam proyek.
Memahami trade-off ini membantu kita menentukan apakah LDA adalah algoritme terbaik untuk diterapkan pada masalah yang dihadapi.
Artikel ini memperkenalkan analisis diskriminan linear, sebuah teknik terawasi yang menggabungkan reduksi dimensi dengan klasifikasi dengan memaksimalkan rasio sebar antar-kelas terhadap sebar dalam-kelas.
Kita mengeksplorasi landasan matematis LDA, mengimplementasikannya menggunakan Python, dan membandingkannya dengan PCA untuk memahami kapan masing-masing teknik paling tepat. Kita juga mempelajari aplikasi LDA di dunia nyata serta membahas kelebihan dan keterbatasannya.
Untuk memperdalam pemahaman Anda tentang LDA dan teknik pembelajaran mesin terkait, pertimbangkan untuk mengikuti jalur Supervised Machine Learning in Python, di mana Anda akan menguasai berbagai algoritme dan implementasinya, atau kursus Dimensionality Reduction in Python untuk menggali lebih dalam teknik reduksi dimensi terawasi maupun tanpa supervisi.
Belajar dengan DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



