
Corso
Generalized Linear Models in R
4 ore
22K
La linear discriminant analysis (LDA) viene spesso messa in ombra da un algoritmo più popolare, la principal component analysis (PCA), quando si parla di riduzione della dimensionalità. Tuttavia, LDA offre qualcosa di unico che la PCA non può dare: riduce le dimensioni ottimizzando al contempo la separabilità tra classi.
In questo tutorial vedrai cos’è l’LDA, l’intuizione matematica che la guida e le sue applicazioni nel mondo reale. Inoltre, implementeremo l’LDA su un dataset, la confronteremo con la PCA e analizzeremo vantaggi e svantaggi, con l’obiettivo di fornirti tutto ciò che ti serve per applicare l’LDA nel tuo prossimo progetto.
LDA è una tecnica di riduzione della dimensionalità e classificazione che assume che classi diverse generino dati a partire da differenti distribuzioni gaussiane.
L’obiettivo dell’LDA è trovare una combinazione lineare di feature che separi al meglio queste classi. Massimizza il rapporto tra la dispersione tra classi e la dispersione entro classe. In parole semplici, cerca direzioni nello spazio delle feature in cui le classi siano molto distanti tra loro (alta dispersione tra classi) mentre i punti della stessa classe siano vicini (bassa dispersione entro classe).
Questo duplice obiettivo rende l’LDA particolarmente efficace sia per la riduzione della dimensionalità sia per i compiti di classificazione.
Per capire la matematica dell’LDA, scomponiamo l’algoritmo in tre componenti chiave:
La matrice di dispersione entro classe misura quanto sono dispersi i punti dati all’interno di ciascuna classe.
Per ogni classe i, calcoliamo la matrice di dispersione Si come:
Si = Σ(x - μi)(x - μi)TDove x rappresenta ciascun punto dati nella classe i e μi è la media della classe i. La matrice totale di dispersione entro classe è:
Sw = Σ Si (sum over all classes)La matrice di dispersione tra classi misura quanto le medie di classe sono distanti dalla media complessiva. Si calcola come:
Sb = Σ Ni(μi - μ)(μi - μ)T Dove Ni è il numero di campioni nella classe i, μi è la media della classe i e μ è la media complessiva di tutti i dati.
L’LDA cerca la matrice di proiezione W che massimizza il criterio di Fisher:
J(W) = |WT Sb W| / |WT Sw W|In sostanza, si massimizza il rapporto tra dispersione tra classi e dispersione entro classe nello spazio proiettato. La soluzione consiste nel trovare gli autovettori della matrice Sw-1Sb, che forniscono le direzioni (discriminanti lineari) che separano meglio le classi.
Così, l’LDA riduce questo complesso problema di ottimizzazione a una decomposizione agli autovalori, rendendola computazionalmente efficiente anche per dataset moderatamente ad alta dimensionalità.
Ora che abbiamo compreso il concetto e l’intuizione matematica dietro l’LDA, vediamo le sue applicazioni pratiche.
L’LDA trova applicazione in diversi ambiti in cui sono richieste classificazione e riduzione della dimensionalità:
Vediamo un esempio end-to-end di implementazione dell’LDA con Python.
Useremo il dataset Seeds, scaricabile dalla libreria UCI e anche da Kaggle. Il dataset contiene misurazioni di chicchi di grano appartenenti a tre diverse varietà.
Per prima cosa importiamo le librerie necessarie e carichiamo il dataset:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score

# Load the seeds dataset
file_path = "seeds_dataset.txt"
column_names = ['area', 'perimeter', 'compactness', 'kernel_length',
               'kernel_width', 'asymmetry', 'groove_length', 'variety']

# Read the data with whitespace delimiter (space or tab)
seeds_df = pd.read_csv(file_path, sep='\s+', header=None, names=column_names)

print(f"Dataset shape: {seeds_df.shape}")
seeds_df.head()
Di seguito vedremo le prime 5 righe del dataset caricato:
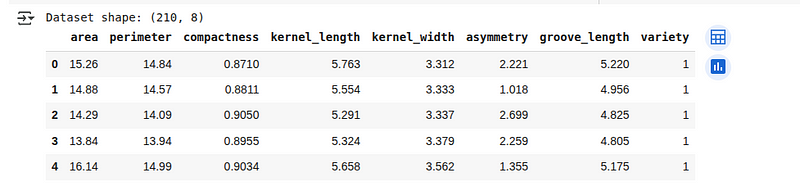 Panoramica del dataset Seeds. (Immagine dell’autore)
Esploriamo la struttura dei dati e prepariamoli per l’analisi LDA:
# Check for missing values
print(f"Missing values: {seeds_df.isnull().sum().sum()}")

# Check class distribution
print("\nClass distribution:")
print(seeds_df['variety'].value_counts())

# Separate features and target
X = seeds_df.drop('variety', axis=1)
y = seeds_df['variety']

# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3,
                                                   random_state=42, stratify=y)

# Standardize the features
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
Qui verifichiamo se il dataset contiene valori mancanti ed esaminiamo quanti esempi appartengono a ciascuna categoria. Poi prepariamo i dati separando input e label, dividendoli in training e test, e standardizzando gli input in modo che tutte le feature siano su una scala simile.
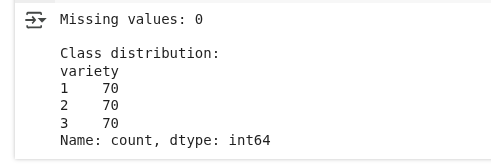
Pre-processing dei dati. (Immagine dell’autore)
Vediamo che non ci sono valori mancanti e che la distribuzione delle classi è equilibrata.
Applichiamo ora l’LDA per ridurre la dimensionalità mantenendo la separabilità tra classi:
# Create and fit LDA model
lda = LinearDiscriminantAnalysis(n_components=2)
X_train_lda = lda.fit_transform(X_train_scaled, y_train)
X_test_lda = lda.transform(X_test_scaled)

# Print explained variance ratio
print("Explained variance ratio:", lda.explained_variance_ratio_)
print("Cumulative explained variance:", np.cumsum(lda.explained_variance_ratio_))
Creiamo un modello che trova le direzioni migliori per separare le diverse categorie nei dati. Riducendo i dati a due nuove feature (dato che abbiamo tre classi), manteniamo i pattern più importanti per distinguerle.
L’output è il seguente:
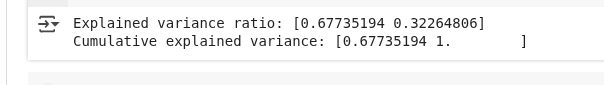 Risultati sulla varianza dell’LDA. (Immagine dell’autore)
Questo output mostra quanta dell’informazione utile a separare le classi è catturata dalle due nuove feature create dall’LDA:
Visualizziamo come l’LDA trasforma i dati e separa le classi:
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# Plot the first two original features
ax1.scatter(X_train_scaled[:, 0], X_train_scaled[:, 1],
           c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax1.set_xlabel('Area (standardized)')
ax1.set_ylabel('Perimeter (standardized)')
ax1.set_title('Original Feature Space (First Two Features)')
ax1.grid(True, alpha=0.3)

# Plot LDA-transformed data
scatter = ax2.scatter(X_train_lda[:, 0], X_train_lda[:, 1],
                     c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax2.set_xlabel('First Linear Discriminant')
ax2.set_ylabel('Second Linear Discriminant')
ax2.set_title('LDA-Transformed Space')
ax2.grid(True, alpha=0.3)

plt.colorbar(scatter, ax=ax2, label='Wheat Variety')
plt.tight_layout()
plt.show()
Il codice sopra crea due grafici affiancati per confrontare l’aspetto dei dati prima e dopo l’applicazione della tecnica di riduzione della dimensionalità, come mostrato di seguito:
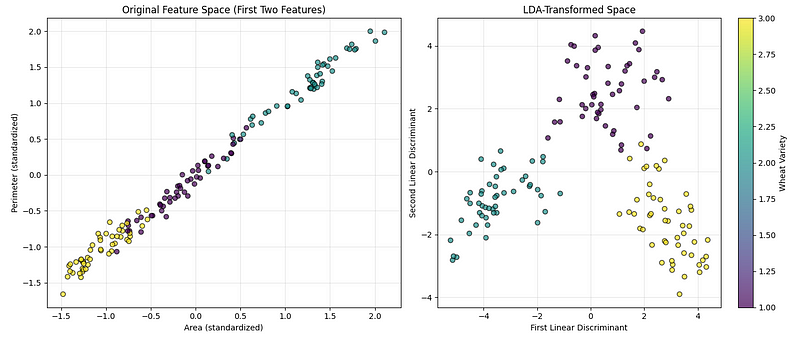 Visualizzazione LDA. (Immagine dell’autore)
Il primo grafico mostra i dati originali usando due delle feature misurate (area e perimetro), così possiamo vedere quanto le categorie siano separabili in modo naturale. Il secondo grafico mostra i dati dopo la trasformazione nelle direzioni più informative per separare le categorie. È stata aggiunta una colorbar per indicare quale colore rappresenta ciascun tipo di grano.
L’LDA può essere usata anche direttamente come classificatore.
Implementiamola:
# Create LDA classifier
lda_classifier = LinearDiscriminantAnalysis()
lda_classifier.fit(X_train_scaled, y_train)

# Make predictions
y_pred = lda_classifier.predict(X_test_scaled)

# Calculate accuracy
accuracy = accuracy_score(y_test, y_pred)
print(f"Classification Accuracy: {accuracy:.4f}")

# Print classification report
print("\nClassification Report:")
print(classification_report(y_test, y_pred))
Alleniamo un modello a riconoscere le diverse categorie di grano basandoci sui dati di addestramento. Poi verifichiamo le sue prestazioni su esempi nuovi, misurando l’accuratezza complessiva e quanto bene predice ciascuna categoria.
Otteniamo il seguente output:
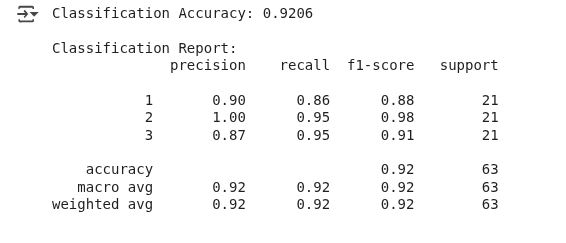
Risultati di classificazione LDA. (Immagine dell’autore)
Il modello ha predetto correttamente il tipo di grano circa nel 92% dei casi, un risultato che può essere considerato buono.
Questo esempio ha mostrato che, sebbene l’LDA sia comunemente usata per la riduzione della dimensionalità, può anche agire da classificatore modellando la distribuzione di probabilità di ciascuna classe e assegnando i nuovi dati alla classe con verosimiglianza più alta.
La Principal Component Analysis è un’altra tecnica popolare di riduzione della dimensionalità che trova le direzioni di massima varianza nei dati.
Estendiamo l’esempio precedente per confrontare LDA e PCA:
from sklearn.decomposition import PCA
# Apply PCA with 2 components
pca = PCA(n_components=2)
X_train_pca = pca.fit_transform(X_train_scaled)
X_test_pca = pca.transform(X_test_scaled)

# Create comparison visualization
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# Plot PCA results
scatter1 = ax1.scatter(X_train_pca[:, 0], X_train_pca[:, 1],
                      c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax1.set_xlabel('First Principal Component')
ax1.set_ylabel('Second Principal Component')
ax1.set_title(f'PCA Transformation\nExplained Variance: {pca.explained_variance_ratio_.sum():.2%}')
ax1.grid(True, alpha=0.3)

# Plot LDA results
scatter2 = ax2.scatter(X_train_lda[:, 0], X_train_lda[:, 1],
                      c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax2.set_xlabel('First Linear Discriminant')
ax2.set_ylabel('Second Linear Discriminant')
ax2.set_title(f'LDA Transformation\nExplained Variance: {lda.explained_variance_ratio_.sum():.2%}')
ax2.grid(True, alpha=0.3)

plt.colorbar(scatter1, ax=ax1, label='Wheat Variety')
plt.colorbar(scatter2, ax=ax2, label='Wheat Variety')
plt.tight_layout()
plt.show()
Otteniamo il seguente grafico:
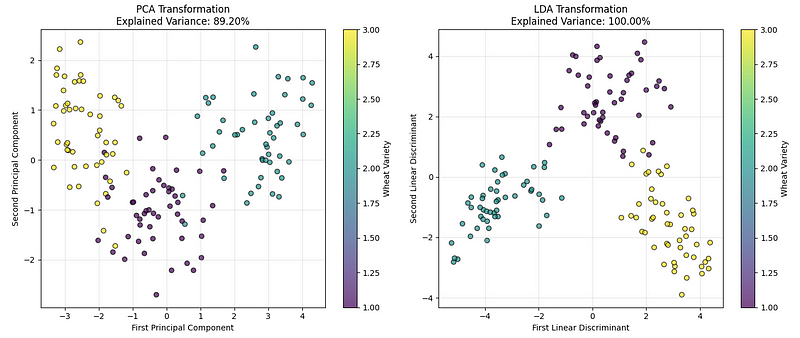 Confronto LDA vs. PCA. (Immagine dell’autore)
Il grafico a sinistra mostra i dati con la PCA, che trova le direzioni che catturano la massima variazione complessiva. Il grafico a destra mostra il risultato dell’LDA, che trova le direzioni che separano meglio le categorie di grano.
Sulla base dei risultati ottenuti e dei valori di varianza spiegata, possiamo concludere che, pur funzionando entrambe bene, per problemi di classificazione come questo l’LDA tende a creare una separazione più netta tra i gruppi.
Ciò che distingue l’LDA da altre tecniche di riduzione della dimensionalità è la sua natura supervisionata. Mentre la PCA considera solo la varianza nei dati senza tener conto delle etichette di classe, l’LDA usa esplicitamente l’informazione di classe per trovare le direzioni più discriminanti. Questo è ideale quando si lavora con dati ad alta dimensionalità in cui la separabilità tra classi è più importante del preservare la varianza complessiva.
La PCA può quindi essere usata quando:
Allo stesso modo, possiamo usare l’LDA quando:
Come ogni algoritmo, l’LDA ha punti di forza e limiti di cui tenere conto prima di applicarla nei nostri progetti.
Capire questi trade-off ci aiuta a stabilire se l’LDA è l’algoritmo migliore per il problema in questione.
Questo articolo ha introdotto la linear discriminant analysis, una tecnica supervisionata che combina la riduzione della dimensionalità con la classificazione massimizzando il rapporto tra dispersione tra classi e dispersione entro classe.
Abbiamo esplorato le basi matematiche dell’LDA, l’abbiamo implementata in Python e l’abbiamo confrontata con la PCA per capire quando ciascuna tecnica è più appropriata. Abbiamo anche visto le applicazioni reali dell’LDA e discusso vantaggi e limitazioni.
Per approfondire la tua comprensione di LDA e tecniche di machine learning correlate, valuta l’iscrizione al nostro percorso Supervised Machine Learning in Python, dove padroneggerai vari algoritmi e le relative implementazioni, oppure al corso Dimensionality Reduction in Python per approfondire le tecniche di riduzione della dimensionalità supervisionate e non supervisionate.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



