
Cursus
Generalized Linear Models in R
4 uur
22K
Lineaire discriminantanalyse (LDA) wordt bij dimensiereductie vaak overschaduwd door een populairder algoritme: principal component analysis (PCA). Toch biedt LDA iets unieks wat PCA niet kan: het reduceert dimensies terwijl het tegelijkertijd optimaliseert voor klassenseparatie.
In deze tutorial maak je kennis met LDA, de wiskundige intuïtie erachter en toepassingen in de praktijk. Verder implementeren we LDA op een dataset, vergelijken we het met PCA, en analyseren we de voor- en nadelen, zodat je alles hebt om LDA in je volgende project toe te passen.
LDA is een techniek voor dimensiereductie en classificatie onder de aanname dat verschillende klassen data genereren op basis van verschillende Gaussiaanse verdelingen.
LDA probeert een lineaire combinatie van features te vinden die deze klassen het best scheidt. Het maximaliseert de verhouding tussen de spreiding tussen klassen en de spreiding binnen klassen. Simpeler gezegd: het zoekt naar richtingen in de feature-ruimte waar verschillende klassen ver uit elkaar liggen (hoge tussen-klassen-spreiding), terwijl punten binnen dezelfde klasse dicht bij elkaar liggen (lage binnen-klasse-spreiding).
Deze dubbele doelstelling maakt LDA bijzonder effectief voor zowel dimensiereductie als classificatietaken.
De wiskunde achter LDA begrijpen vraagt om het algoritme op te delen in drie kernonderdelen:
De binnen-klasse-spreidingsmatrix meet hoe verspreid de datapunten binnen elke klasse zijn.
Voor elke klasse i berekenen we de spreidingsmatrix Si als:
Si = Σ(x - μi)(x - μi)TWaarbij x elk datapunt in klasse i voorstelt, en μi het gemiddelde van klasse i is. De totale binnen-klasse-spreidingsmatrix is:
Sw = Σ Si (sum over all classes)De tussen-klasse-spreidingsmatrix meet hoe ver de klassengemiddelden van het overall gemiddelde liggen. Die wordt berekend als:
Sb = Σ Ni(μi - μ)(μi - μ)T Waarbij Ni het aantal samples in klasse i is, μi het gemiddelde van klasse i, en μ het overall gemiddelde van alle data.
LDA zoekt de projectiematrix W die het Fisher-criterium maximaliseert:
J(W) = |WT Sb W| / |WT Sw W|Dit komt neer op het maximaliseren van de verhouding tussen de spreiding tussen klassen en de spreiding binnen klassen in de geprojecteerde ruimte. De oplossing bestaat uit het vinden van de eigenvectoren van de matrix Sw-1Sb, wat de richtingen (lineaire discriminanten) oplevert die de klassen het best scheiden.
Zo reduceert LDA dit complexe optimalisatieprobleem tot een eigenwaardedecompositie, wat het computationeel efficiënt maakt, zelfs voor datasets met een matig hoge dimensie.
Nu we het concept en de wiskundige intuïtie achter LDA begrijpen, kijken we naar toepassingen in de praktijk.
LDA heeft toepassingen in meerdere domeinen waar classificatie en/of dimensiereductie nodig zijn:
Laten we een end-to-end voorbeeld doorlopen van het implementeren van LDA met Python.
We gebruiken de Seeds-dataset, die je kunt downloaden uit de UCI-bibliotheek en van Kaggle. De dataset be Vat metingen van tarwekorrels die tot drie verschillende tarwerassen behoren.
Eerst importeren we de benodigde bibliotheken en laden we onze dataset:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score

# Load the seeds dataset
file_path = "seeds_dataset.txt"
column_names = ['area', 'perimeter', 'compactness', 'kernel_length',
               'kernel_width', 'asymmetry', 'groove_length', 'variety']

# Read the data with whitespace delimiter (space or tab)
seeds_df = pd.read_csv(file_path, sep='\s+', header=None, names=column_names)

print(f"Dataset shape: {seeds_df.shape}")
seeds_df.head()
Hieronder zie je de eerste 5 regels van de geladen dataset:
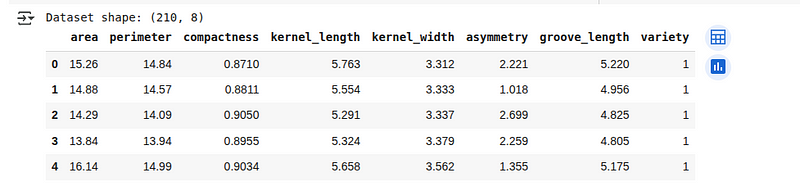 Overzicht van de Seeds-dataset. (Afbeelding door auteur)
Laten we de datastructuur verkennen en voorbereiden voor LDA-analyse:
# Check for missing values
print(f"Missing values: {seeds_df.isnull().sum().sum()}")

# Check class distribution
print("\nClass distribution:")
print(seeds_df['variety'].value_counts())

# Separate features and target
X = seeds_df.drop('variety', axis=1)
y = seeds_df['variety']

# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3,
                                                   random_state=42, stratify=y)

# Standardize the features
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
Hier controleren we of de dataset ontbrekende waarden heeft en bekijken we hoeveel voorbeelden er per categorie zijn. Vervolgens bereiden we de data voor door de invoer van de labels te scheiden, te splitten in train- en testsets, en de invoerwaarden te standaardiseren zodat alle features op een vergelijkbare schaal liggen.
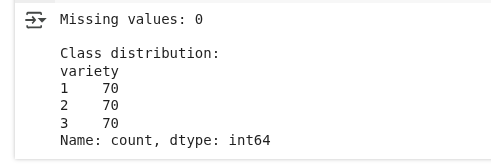
Data-preprocessing. (Afbeelding door auteur)
We zien dat er geen ontbrekende waarden zijn en dat de klassenverdeling gelijk is.
We passen nu LDA toe om de dimensionaliteit van onze data te verlagen, terwijl de scheiding tussen klassen behouden blijft:
# Create and fit LDA model
lda = LinearDiscriminantAnalysis(n_components=2)
X_train_lda = lda.fit_transform(X_train_scaled, y_train)
X_test_lda = lda.transform(X_test_scaled)

# Print explained variance ratio
print("Explained variance ratio:", lda.explained_variance_ratio_)
print("Cumulative explained variance:", np.cumsum(lda.explained_variance_ratio_))
We maken een model dat de beste richtingen vindt om de verschillende categorieën in onze data te scheiden. Door de data terug te brengen naar twee nieuwe features (aangezien we drie categorieën hebben), behouden we de belangrijkste patronen om tussen hen te onderscheiden.
De output is als volgt:
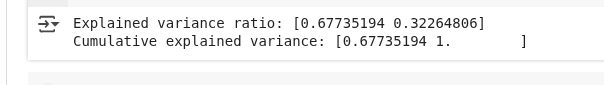 LDA-variantieresultaten. (Afbeelding door auteur)
Deze output laat zien hoeveel van de klassescheidende informatie wordt vastgelegd door de twee nieuwe features die door LDA zijn gecreëerd:
Laten we visualiseren hoe LDA onze data transformeert en de klassen scheidt:
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# Plot the first two original features
ax1.scatter(X_train_scaled[:, 0], X_train_scaled[:, 1],
           c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax1.set_xlabel('Area (standardized)')
ax1.set_ylabel('Perimeter (standardized)')
ax1.set_title('Original Feature Space (First Two Features)')
ax1.grid(True, alpha=0.3)

# Plot LDA-transformed data
scatter = ax2.scatter(X_train_lda[:, 0], X_train_lda[:, 1],
                     c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax2.set_xlabel('First Linear Discriminant')
ax2.set_ylabel('Second Linear Discriminant')
ax2.set_title('LDA-Transformed Space')
ax2.grid(True, alpha=0.3)

plt.colorbar(scatter, ax=ax2, label='Wheat Variety')
plt.tight_layout()
plt.show()
De bovenstaande code maakt twee grafieken naast elkaar om te vergelijken hoe de data eruitziet vóór en na toepassing van de dimensiereductietechniek, zoals hieronder te zien:
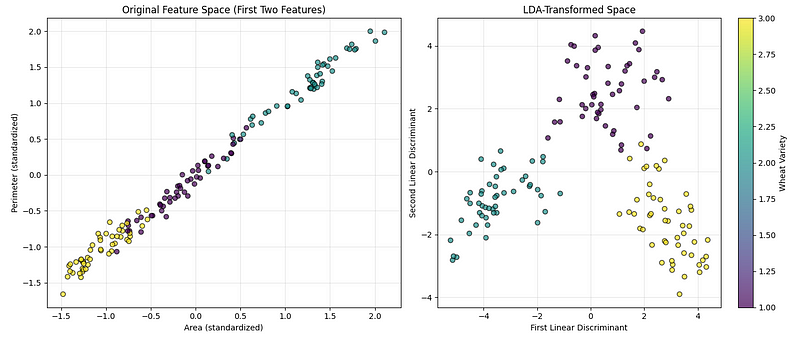 LDA-visualisatie. (Afbeelding door auteur)
De eerste grafiek toont de oorspronkelijke data met twee van de gemeten features (oppervlakte en omtrek), zodat we kunnen zien hoe de categorieën van nature gescheiden zijn. De tweede grafiek toont de data nadat deze is getransformeerd naar de meest informatieve richtingen om de categorieën te scheiden. Een kleurenschaal is toegevoegd om te tonen welke kleur welk type tarwe vertegenwoordigt.
LDA kan ook direct als classifier worden gebruikt.
Laten we het implementeren:
# Create LDA classifier
lda_classifier = LinearDiscriminantAnalysis()
lda_classifier.fit(X_train_scaled, y_train)

# Make predictions
y_pred = lda_classifier.predict(X_test_scaled)

# Calculate accuracy
accuracy = accuracy_score(y_test, y_pred)
print(f"Classification Accuracy: {accuracy:.4f}")

# Print classification report
print("\nClassification Report:")
print(classification_report(y_test, y_pred))
We trainen een model om de verschillende tarwecategorieën te herkennen op basis van de trainingsdata. Daarna testen we hoe goed het presteert op nieuwe, ongeziene voorbeelden door de algehele nauwkeurigheid en de prestaties per categorie te bekijken.
We zien de volgende output:
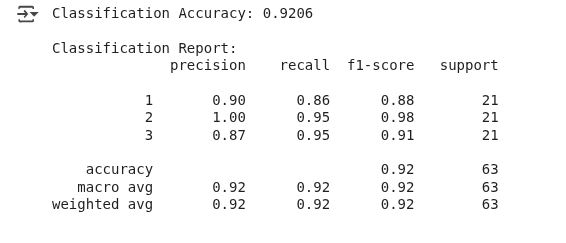
LDA-classificatieresultaten. (Afbeelding door auteur)
Het model voorspelde het tarwetype ongeveer 92% van de tijd correct, wat als een goede prestatie kan worden beschouwd.
Dit voorbeeld laat zien dat LDA, hoewel vaak gebruikt voor dimensiereductie, ook als classifier kan fungeren door de kansverdeling van elke klasse te modelleren en nieuwe data toe te wijzen aan de klasse met de hoogste waarschijnlijkheid.
Principal Component Analysis is een andere populaire techniek voor dimensiereductie die de richtingen van maximale variantie in de data vindt.
Laten we ons eerdere voorbeeld uitbreiden om LDA met PCA te vergelijken:
from sklearn.decomposition import PCA
# Apply PCA with 2 components
pca = PCA(n_components=2)
X_train_pca = pca.fit_transform(X_train_scaled)
X_test_pca = pca.transform(X_test_scaled)

# Create comparison visualization
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# Plot PCA results
scatter1 = ax1.scatter(X_train_pca[:, 0], X_train_pca[:, 1],
                      c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax1.set_xlabel('First Principal Component')
ax1.set_ylabel('Second Principal Component')
ax1.set_title(f'PCA Transformation\nExplained Variance: {pca.explained_variance_ratio_.sum():.2%}')
ax1.grid(True, alpha=0.3)

# Plot LDA results
scatter2 = ax2.scatter(X_train_lda[:, 0], X_train_lda[:, 1],
                      c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax2.set_xlabel('First Linear Discriminant')
ax2.set_ylabel('Second Linear Discriminant')
ax2.set_title(f'LDA Transformation\nExplained Variance: {lda.explained_variance_ratio_.sum():.2%}')
ax2.grid(True, alpha=0.3)

plt.colorbar(scatter1, ax=ax1, label='Wheat Variety')
plt.colorbar(scatter2, ax=ax2, label='Wheat Variety')
plt.tight_layout()
plt.show()
We zien de volgende plot:
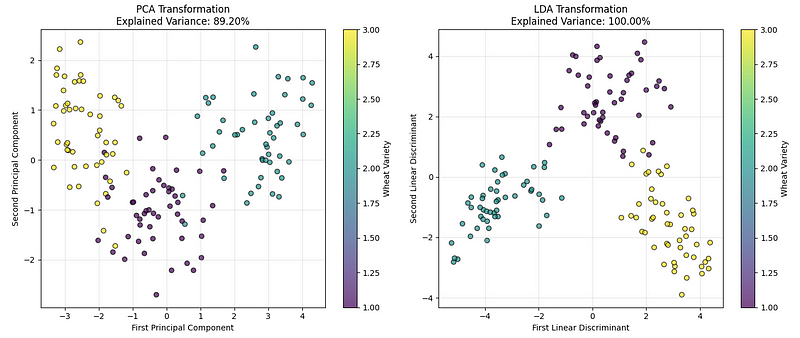 Vergelijking LDA vs. PCA. (Afbeelding door auteur)
De linker grafiek toont de data met PCA, dat de richtingen vindt die de meeste algemene variatie in de data vastleggen. De rechter grafiek toont het resultaat van LDA, dat de richtingen vindt die de tarwecategorieën het best scheiden.
Gebaseerd op onze implementatieresultaten en de verklaarde variantiewaarden kunnen we concluderen dat, hoewel beide goed presteren, LDA voor dit soort classificatieproblemen meestal een duidelijkere scheiding tussen groepen creëert.
Wat LDA onderscheidt van andere dimensiereductietechnieken is het supervised karakter. Terwijl PCA alleen naar de variantie in de data kijkt zonder rekening te houden met klasselabels, gebruikt LDA expliciet klasse-informatie om de meest discriminerende richtingen te vinden. Dit is ideaal bij hoog-dimensionale data waar klassenseparatie belangrijker is dan het behouden van de totale variantie.
Gebruik PCA wanneer:
Gebruik LDA wanneer:
Zoals elk algoritme heeft LDA sterke punten en beperkingen waar we rekening mee moeten houden voordat we het in onze projecten toepassen.
Deze trade-offs begrijpen helpt ons bepalen of LDA het beste algoritme is voor het probleem in kwestie.
Dit artikel introduceerde lineaire discriminantanalyse, een supervised techniek die dimensiereductie combineert met classificatie door de verhouding tussen spreiding tussen en binnen klassen te maximaliseren.
We verkenden de wiskundige basis van LDA, implementeerden het met Python en vergeleken het met PCA om te begrijpen wanneer elke techniek het meest geschikt is. We zagen ook toepassingen van LDA in de praktijk en bespraken de voor- en nadelen.
Wil je je begrip van LDA en aanverwante machinelearning-technieken verdiepen? Overweeg dan onze track Supervised Machine Learning in Python, waarin je diverse algoritmen en implementaties onder de knie krijgt, of onze cursus Dimensionality Reduction in Python om dieper in zowel supervised als unsupervised dimensiereductietechnieken te duiken.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

