
Kurs
R'de Genelleştirilmiş Doğrusal Modeller
4 sa
22K
Doğrusal ayrıştırma analizi (LDA), boyut azaltma söz konusu olduğunda genellikle daha popüler bir algoritma olan temel bileşen analizi (PCA) tarafından gölgede bırakılır. Ancak LDA, PCA’nın sunamadığı benzersiz bir özellik sunar: boyutları azaltırken aynı anda sınıf ayrımını da optimize eder.
Bu eğitimde LDA’yı, arkasındaki matematiksel sezgiyi ve tekniğin gerçek dünya uygulamalarını tanıtacağız. Ayrıca bir veri kümesi üzerinde LDA uygulayıp PCA ile karşılaştıracağız ve artılarını/eksilerini analiz ederek bir sonraki projenizde LDA’yı uygulamaya başlamanız için ihtiyaç duyacağınız her şeyi sunmayı amaçlayacağız.
LDA, farklı sınıfların veriyi farklı Gaussian dağılımlarına göre ürettiği varsayımı altında çalışan bir boyut azaltma ve sınıflandırma tekniğidir.
LDA, bu sınıfları en iyi ayıran özelliklerin doğrusal bir kombinasyonunu bulmayı hedefler. Sınıflar arası saçılımın sınıf içi saçılıma oranını maksimize eder. Daha basit ifade edersek, özellik uzayında farklı sınıfların birbirinden olabildiğince uzak (yüksek sınıflar arası saçılım), aynı sınıftaki noktaların ise birbirine yakın (düşük sınıf içi saçılım) olduğu yönleri bulmaya çalışır.
Bu ikili amaç, LDA’yı hem boyut azaltma hem de sınıflandırma görevleri için özellikle etkili kılar.
LDA’nın matematiğini anlamak, algoritmayı üç temel bileşene ayırmayı gerektirir:
Sınıf içi saçılım matrisi, her bir sınıf içerisindeki veri noktalarının ne kadar saçıldığını ölçer.
Her bir i sınıfı için saçılım matrisi Si şu şekilde hesaplanır:
Si = Σ(x - μi)(x - μi)TBurada x, i sınıfındaki her bir veri noktasını; μi ise i sınıfının ortalamasını temsil eder. Toplam sınıf içi saçılım matrisi ise şöyledir:
Sw = Σ Si (sum over all classes)Sınıflar arası saçılım matrisi, sınıf ortalamalarının genel ortalamadan ne kadar uzak olduğunu ölçer. Şu şekilde hesaplanır:
Sb = Σ Ni(μi - μ)(μi - μ)T Burada Ni, i sınıfındaki örnek sayısını; μi, i sınıfının ortalamasını; μ ise tüm verinin genel ortalamasını ifade eder.
LDA, Fisher ölçütünü maksimize eden yansıtma matrisi W’yi bulmayı amaçlar:
J(W) = |WT Sb W| / |WT Sw W|Bu özünde, yansıtılmış uzayda sınıflar arası saçılımın sınıf içi saçılıma oranını maksimize etmektir. Çözüm, Sw-1Sb matrisinin özvektörlerini bulmayı içerir ve bu da sınıfları en iyi ayıran yönleri (doğrusal ayrıştırıcıları) verir.
Böylece LDA, bu karmaşık optimizasyon problemini bir özdeğer ayrışımına indirger ve bu da orta derecede yüksek boyutlu veri kümeleri için bile hesaplama açısından verimli olmasını sağlar.
Artık LDA’nın arkasındaki kavramı ve matematiksel sezgiyi anladığımıza göre, gerçek dünya uygulamalarını öğrenelim.
LDA, sınıflandırma ve boyut azaltmanın gerekli olduğu çeşitli alanlarda kullanılır:
Python kullanarak uçtan uca bir LDA uygulaması örneğini adım adım inceleyelim.
Tohumlar veri kümesini UCI kütüphanesinden ve ayrıca Kaggle’dan indireceğiz. Veri kümesi, üç farklı buğday çeşidine ait buğday tanelerinin ölçümlerini içerir.
Önce gerekli kütüphaneleri içe aktaracak ve veri kümemizi yükleyeceğiz:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score

# Load the seeds dataset
file_path = "seeds_dataset.txt"
column_names = ['area', 'perimeter', 'compactness', 'kernel_length',
               'kernel_width', 'asymmetry', 'groove_length', 'variety']

# Read the data with whitespace delimiter (space or tab)
seeds_df = pd.read_csv(file_path, sep='\s+', header=None, names=column_names)

print(f"Dataset shape: {seeds_df.shape}")
seeds_df.head()
Aşağıda yüklenen veri kümesinin ilk 5 satırını göreceğiz:
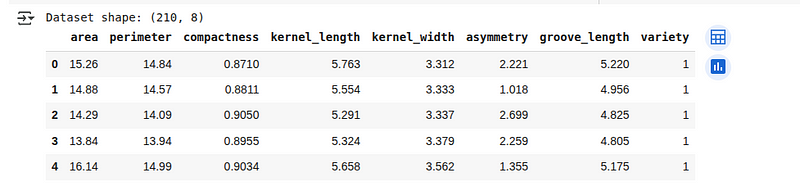 Tohumlar veri kümesine genel bakış. (Görsel: Yazar)
Veri yapısını keşfedelim ve LDA analizine hazırlayalım:
# Check for missing values
print(f"Missing values: {seeds_df.isnull().sum().sum()}")

# Check class distribution
print("\nClass distribution:")
print(seeds_df['variety'].value_counts())

# Separate features and target
X = seeds_df.drop('variety', axis=1)
y = seeds_df['variety']

# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3,
                                                   random_state=42, stratify=y)

# Standardize the features
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
Burada, veri kümesinde eksik değer olup olmadığını kontrol ediyor ve her kategoriye kaç örnek düştüğünü inceliyoruz. Ardından, girdileri etiketlerden ayırarak, veriyi eğitim/test olarak bölüp tüm özelliklerin benzer ölçekte olması için standartlaştırıyoruz.
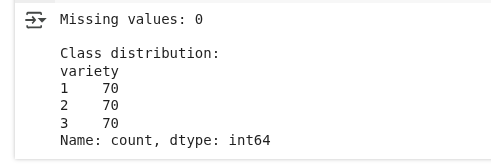
Veri ön işleme. (Görsel: Yazar)
Eksik değer olmadığını ve sınıf dağılımının eşit olduğunu görüyoruz.
Şimdi, sınıf ayrımını korurken verimizin boyutunu azaltmak için LDA uygulayacağız:
# Create and fit LDA model
lda = LinearDiscriminantAnalysis(n_components=2)
X_train_lda = lda.fit_transform(X_train_scaled, y_train)
X_test_lda = lda.transform(X_test_scaled)

# Print explained variance ratio
print("Explained variance ratio:", lda.explained_variance_ratio_)
print("Cumulative explained variance:", np.cumsum(lda.explained_variance_ratio_))
Verimizdeki farklı kategorileri en iyi ayıran yönleri bulan bir model kuruyoruz. Veriyi iki yeni özelliğe indirgerken (üç kategori olduğu için), aralarındaki ayrımı belirlemede en önemli örüntüleri koruyoruz.
Çıktı aşağıdaki gibidir:
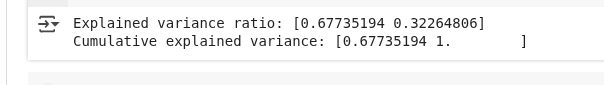 LDA varyans sonuçları. (Görsel: Yazar)
Bu çıktı, LDA tarafından oluşturulan iki yeni özelliğin sınıfları ayıran bilgiyi ne ölçüde yakaladığını gösterir:
LDA’nın verimizi nasıl dönüştürdüğünü ve sınıfları nasıl ayırdığını görselleştirelim:
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# Plot the first two original features
ax1.scatter(X_train_scaled[:, 0], X_train_scaled[:, 1],
           c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax1.set_xlabel('Area (standardized)')
ax1.set_ylabel('Perimeter (standardized)')
ax1.set_title('Original Feature Space (First Two Features)')
ax1.grid(True, alpha=0.3)

# Plot LDA-transformed data
scatter = ax2.scatter(X_train_lda[:, 0], X_train_lda[:, 1],
                     c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax2.set_xlabel('First Linear Discriminant')
ax2.set_ylabel('Second Linear Discriminant')
ax2.set_title('LDA-Transformed Space')
ax2.grid(True, alpha=0.3)

plt.colorbar(scatter, ax=ax2, label='Wheat Variety')
plt.tight_layout()
plt.show()
Yukarıdaki kod, boyut azaltma tekniğini uygulamadan önce ve sonra verinin nasıl göründüğünü karşılaştırmamıza yardımcı olmak için yan yana iki grafik oluşturur; aşağıda görüldüğü gibi:
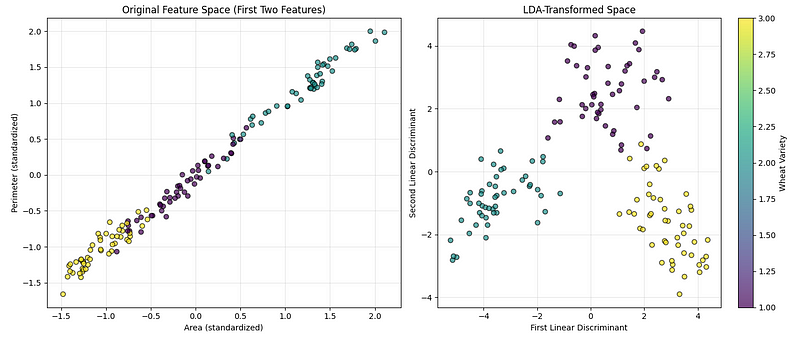 LDA görselleştirmesi. (Görsel: Yazar)
İlk grafik, iki ölçülen özellik (alan ve çevre) kullanılarak orijinal veriyi gösterir; böylece kategorilerin doğal olarak ne kadar ayrıştığını görebiliriz. İkinci grafik, kategorileri ayırmak için en bilgili yönlere dönüştürdükten sonraki veriyi gösterir. Hangi rengin hangi buğday türünü temsil ettiğini göstermek için bir renk çubuğu eklenmiştir.
LDA doğrudan bir sınıflandırıcı olarak da kullanılabilir.
Bunu uygulayalım:
# Create LDA classifier
lda_classifier = LinearDiscriminantAnalysis()
lda_classifier.fit(X_train_scaled, y_train)

# Make predictions
y_pred = lda_classifier.predict(X_test_scaled)

# Calculate accuracy
accuracy = accuracy_score(y_test, y_pred)
print(f"Classification Accuracy: {accuracy:.4f}")

# Print classification report
print("\nClassification Report:")
print(classification_report(y_test, y_pred))
Eğitim verilerine dayanarak farklı buğday kategorilerini tanıyacak bir model eğitiyoruz. Ardından, genel doğruluğunu ve her bir kategoriyi ne kadar iyi tahmin ettiğini kontrol ederek modeli yeni, görülmemiş örnekler üzerinde test ediyoruz.
Aşağıdaki çıktıyı görüyoruz:
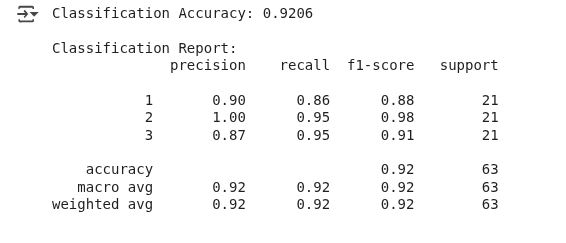
LDA sınıflandırma sonuçları. (Görsel: Yazar)
Model, buğday türünü zamanın yaklaşık %92’sinde doğru tahmin etti; bu iyi bir performans olarak değerlendirilebilir.
Bu örnek, LDA’nın yaygın olarak boyut azaltma için kullanılsa da her bir sınıfın olasılık dağılımını modelleyip yeni veriyi en yüksek olasılığa sahip sınıfa atayarak bir sınıflandırıcı olarak da çalışabildiğini göstermiştir.
Temel Bileşen Analizi, verideki en yüksek varyans yönlerini bulan bir başka popüler boyut azaltma tekniğidir.
Önceki örneğimizi genişletip LDA ile PCA’yı karşılaştıralım:
from sklearn.decomposition import PCA
# Apply PCA with 2 components
pca = PCA(n_components=2)
X_train_pca = pca.fit_transform(X_train_scaled)
X_test_pca = pca.transform(X_test_scaled)

# Create comparison visualization
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# Plot PCA results
scatter1 = ax1.scatter(X_train_pca[:, 0], X_train_pca[:, 1],
                      c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax1.set_xlabel('First Principal Component')
ax1.set_ylabel('Second Principal Component')
ax1.set_title(f'PCA Transformation\nExplained Variance: {pca.explained_variance_ratio_.sum():.2%}')
ax1.grid(True, alpha=0.3)

# Plot LDA results
scatter2 = ax2.scatter(X_train_lda[:, 0], X_train_lda[:, 1],
                      c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax2.set_xlabel('First Linear Discriminant')
ax2.set_ylabel('Second Linear Discriminant')
ax2.set_title(f'LDA Transformation\nExplained Variance: {lda.explained_variance_ratio_.sum():.2%}')
ax2.grid(True, alpha=0.3)

plt.colorbar(scatter1, ax=ax1, label='Wheat Variety')
plt.colorbar(scatter2, ax=ax2, label='Wheat Variety')
plt.tight_layout()
plt.show()
Aşağıdaki grafiği görüyoruz:
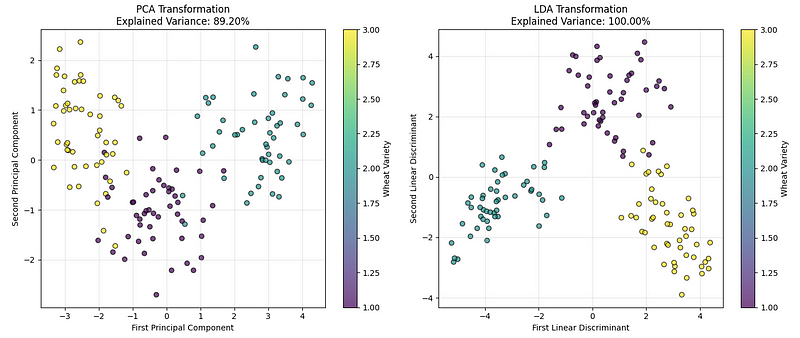 LDA ve PCA karşılaştırması. (Görsel: Yazar)
Sol grafik, veriyi PCA kullanarak gösterir; PCA, verideki toplam varyansı en çok yakalayan yönleri bulur. Sağ grafik ise LDA’nın sonucunu gösterir; LDA, buğday kategorilerini en iyi ayıran yönleri bulur.
Uygulama sonuçlarımıza ve açıklanan varyans değerlerine dayanarak, her ikisi de iyi performans gösterse de bu tür sınıflandırma problemlerinde LDA’nın genellikle gruplar arasında daha net bir ayrım oluşturduğunu söyleyebiliriz.
LDA’yı diğer boyut azaltma tekniklerinden ayıran, denetimli olmasıdır. PCA, sınıf etiketlerini dikkate almadan yalnızca verideki varyansı göz önünde bulundururken, LDA en ayırt edici yönleri bulmak için sınıf bilgisini açıkça kullanır. Bu, sınıf ayrımının genel varyansı korumaktan daha önemli olduğu yüksek boyutlu verilerle çalışırken idealdir.
Dolayısıyla PCA şu durumlarda kullanılabilir:
Benzer şekilde LDA’yı şu durumlarda kullanabiliriz:
Her algoritma gibi LDA’nın da projelerimizde uygulamadan önce dikkat edilmesi gereken güçlü ve zayıf yönleri vardır.
Bu ödünleşimleri anlamak, eldeki probleme LDA’nın en uygun algoritma olup olmadığını belirlememize yardımcı olur.
Bu makalede, sınıflar arası saçılımın sınıf içi saçılıma oranını maksimize ederek sınıflandırma ile boyut azaltmayı birleştiren denetimli bir teknik olan doğrusal ayrıştırma analizini tanıttık.
LDA’nın matematiksel temellerini inceledik, Python ile uyguladık ve her tekniğin hangi durumlarda daha uygun olduğunu anlamak için PCA ile karşılaştırdık. Ayrıca LDA’nın gerçek dünya uygulamalarını öğrendik ve avantajları ile sınırlamalarını tartıştık.
LDA ve ilgili makine öğrenmesi tekniklerini daha derinlemesine öğrenmek için, farklı algoritmaları ve uygulamalarını ustalıkla öğreneceğiniz Python ile Denetimli Makine Öğrenmesi eğitim yolumuza veya hem denetimli hem de denetimsiz boyut azaltma tekniklerini derinlemesine ele alan Python ile Boyut Azaltma kursumuza kaydolmayı düşünebilirsiniz.
DataCamp ile öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




