
कोर्स
Generalized Linear Models in R
4 घंटा
22K
डायमेंशनलिटी रिडक्शन के मामले में लिनीयर डिस्क्रिमिनेंट एनालिसिस (LDA) को अक्सर अधिक लोकप्रिय एल्गोरिथ्म प्रिंसिपल कंपोनेंट एनालिसिस (PCA) के आगे दरकिनार कर दिया जाता है। लेकिन LDA वह विशिष्ट लाभ देता है जो PCA नहीं दे सकता: यह एक साथ डायमेंशन घटाते हुए क्लास की पृथकता को ऑप्टिमाइज़ करता है।
यह ट्यूटोरियल आपको LDA, इसके पीछे के गणितीय अंतर्ज्ञान, और इस तकनीक के वास्तविक दुनिया के उपयोगों से परिचित कराएगा। आगे, हम एक डेटासेट पर LDA लागू करेंगे, उसकी तुलना PCA से करेंगे, और इसके फायदे-नुकसान का विश्लेषण करेंगे—ताकि आप अपने अगले प्रोजेक्ट में LDA लागू करने की शुरुआत के लिए आवश्यक सब कुछ पा सकें।
LDA एक डायमेंशन रिडक्शन और क्लासिफिकेशन तकनीक है जो यह मानती है कि अलग-अलग क्लास अलग-अलग Gaussian वितरणों के आधार पर डेटा जनरेट करती हैं।
LDA का लक्ष्य ऐसे फीचर्स का लिनीयर संयोजन खोजना है जो इन क्लासों को सबसे अच्छी तरह अलग करे। यह between-class scatter और within-class scatter के अनुपात को अधिकतम करता है। सरल शब्दों में, यह फीचर स्पेस में ऐसे दिशा-निर्देश ढूंढता है जहाँ अलग-अलग क्लास एक-दूसरे से बहुत दूर हों (उच्च between-class scatter) जबकि एक ही क्लास के पॉइंट एक-दूसरे के पास हों (निम्न within-class scatter)।
यह दोहरा उद्देश्य LDA को डायमेंशनलिटी रिडक्शन और क्लासिफिकेशन—दोनों कार्यों के लिए खास तौर पर प्रभावी बनाता है।
LDA के गणित को समझने के लिए एल्गोरिथ्म को तीन मुख्य घटकों में बांटना उपयोगी है:
Within-class scatter मैट्रिक्स मापता है कि प्रत्येक क्लास के भीतर डेटा पॉइंट कितने बिखरे हुए हैं।
प्रत्येक क्लास i के लिए, हम scatter मैट्रिक्स Si इस प्रकार निकालते हैं:
Si = Σ(x - μi)(x - μi)Tजहाँ x क्लास i में प्रत्येक डेटा पॉइंट को दर्शाता है, और μi क्लास i का माध्य है। कुल within-class scatter मैट्रिक्स है:
Sw = Σ Si (sum over all classes)Between-class scatter मैट्रिक्स मापता है कि क्लास के माध्य समग्र माध्य से कितनी दूर हैं। इसे इस प्रकार निकाला जाता है:
Sb = Σ Ni(μi - μ)(μi - μ)T जहाँ Ni क्लास i में सैंपल की संख्या है, μi क्लास i का माध्य है, और μ सभी डेटा का समग्र माध्य है।
LDA वह प्रोजेक्शन मैट्रिक्स W ढूंढता है जो Fisher क्राइटेरियन को अधिकतम करता है:
J(W) = |WT Sb W| / |WT Sw W|मूलतः यह प्रोजेक्टेड स्पेस में between-class scatter से within-class scatter के अनुपात को अधिकतम करना है। समाधान में मैट्रिक्स Sw-1Sb के ईजेनवेक्टर्स खोजना शामिल है, जो हमें वे दिशाएँ (लिनीयर डिस्क्रिमिनेंट) देते हैं जो क्लासों को सबसे अच्छी तरह अलग करती हैं।
इस प्रकार, LDA इस जटिल ऑप्टिमाइज़ेशन समस्या को eigenvalue decomposition तक घटा देता है, जिससे यह मध्यम रूप से उच्च-आयामी डेटासेट पर भी संगणनात्मक रूप से कुशल हो जाता है।
अब जबकि हमने LDA की अवधारणा और गणितीय अंतर्ज्ञान समझ लिया है, आइए इसके वास्तविक दुनिया के उपयोग जानें।
LDA के कई ऐसे क्षेत्रों में उपयोग हैं जहाँ क्लासिफिकेशन और डायमेंशनलिटी रिडक्शन की आवश्यकता होती है:
आइए Python का उपयोग करते हुए LDA लागू करने का एक एंड-टू-एंड उदाहरण देखें।
हम Seeds डेटासेट का उपयोग करेंगे, जिसे UCI लाइब्रेरी और Kaggle—दोनों से डाउनलोड किया जा सकता है। इस डेटासेट में तीन अलग-अलग गेहूँ की किस्मों से संबंधित गेहूँ के दानों के माप शामिल हैं।
सबसे पहले, हम आवश्यक लाइब्रेरी आयात करेंगे और अपना डेटासेट लोड करेंगे:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score

# Load the seeds dataset
file_path = "seeds_dataset.txt"
column_names = ['area', 'perimeter', 'compactness', 'kernel_length',
               'kernel_width', 'asymmetry', 'groove_length', 'variety']

# Read the data with whitespace delimiter (space or tab)
seeds_df = pd.read_csv(file_path, sep='\s+', header=None, names=column_names)

print(f"Dataset shape: {seeds_df.shape}")
seeds_df.head()
हम नीचे लोड किए गए डेटासेट की पहली 5 पंक्तियाँ देखेंगे:
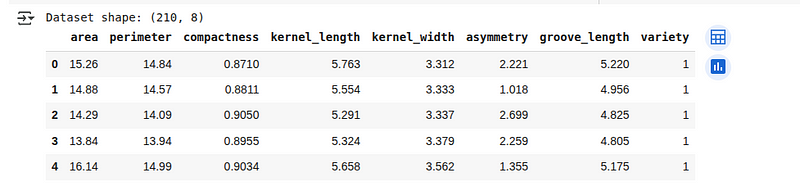 Seeds डेटासेट का अवलोकन। (चित्र: लेखक)
आइए डेटा संरचना का अन्वेषण करें और उसे LDA विश्लेषण के लिए तैयार करें:
# Check for missing values
print(f"Missing values: {seeds_df.isnull().sum().sum()}")

# Check class distribution
print("\nClass distribution:")
print(seeds_df['variety'].value_counts())

# Separate features and target
X = seeds_df.drop('variety', axis=1)
y = seeds_df['variety']

# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3,
                                                   random_state=42, stratify=y)

# Standardize the features
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
यहाँ, हम जाँच रहे हैं कि डेटासेट में कोई मिसिंग वैल्यू तो नहीं है और प्रत्येक श्रेणी में कितने उदाहरण हैं। फिर, हम इनपुट और लेबल अलग करके, डेटा को ट्रेनिंग और टेस्ट भागों में बाँटकर, तथा इनपुट मानों को मानकीकृत करके तैयारी करते हैं ताकि सभी फीचर्स समान स्केल पर आ जाएँ।
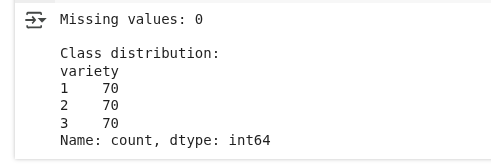
डेटा प्री-प्रोसेसिंग। (चित्र: लेखक)
हम देखते हैं कि कोई मिसिंग वैल्यू नहीं है, और क्लास डिस्ट्रीब्यूशन समान है।
अब हम अपने डेटा की डायमेंशनलिटी घटाते हुए क्लास की पृथकता बनाए रखने के लिए LDA लागू करेंगे:
# Create and fit LDA model
lda = LinearDiscriminantAnalysis(n_components=2)
X_train_lda = lda.fit_transform(X_train_scaled, y_train)
X_test_lda = lda.transform(X_test_scaled)

# Print explained variance ratio
print("Explained variance ratio:", lda.explained_variance_ratio_)
print("Cumulative explained variance:", np.cumsum(lda.explained_variance_ratio_))
हम ऐसा मॉडल बना रहे हैं जो हमारे डेटा में अलग-अलग श्रेणियों को अलग करने के लिए सर्वश्रेष्ठ दिशाएँ ढूंढे। डेटा को दो नए फीचर्स तक घटाकर (क्योंकि हमारे पास तीन श्रेणियाँ हैं), हम उन्हें अलग करने के लिए सबसे महत्वपूर्ण पैटर्न संरक्षित रखते हैं।
आउटपुट इस प्रकार है:
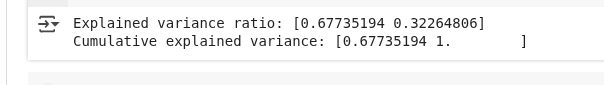 LDA वैरिएंस परिणाम। (चित्र: लेखक)
यह आउटपुट दिखाता है कि LDA द्वारा बनाए गए दो नए फीचर्स क्लासों को अलग करने वाली जानकारी का कितना हिस्सा कैप्चर करते हैं:
आइए देखें कि LDA हमारा डेटा कैसे ट्रांसफॉर्म करता है और क्लासों को कैसे अलग करता है:
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# Plot the first two original features
ax1.scatter(X_train_scaled[:, 0], X_train_scaled[:, 1],
           c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax1.set_xlabel('Area (standardized)')
ax1.set_ylabel('Perimeter (standardized)')
ax1.set_title('Original Feature Space (First Two Features)')
ax1.grid(True, alpha=0.3)

# Plot LDA-transformed data
scatter = ax2.scatter(X_train_lda[:, 0], X_train_lda[:, 1],
                     c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax2.set_xlabel('First Linear Discriminant')
ax2.set_ylabel('Second Linear Discriminant')
ax2.set_title('LDA-Transformed Space')
ax2.grid(True, alpha=0.3)

plt.colorbar(scatter, ax=ax2, label='Wheat Variety')
plt.tight_layout()
plt.show()
ऊपर का कोड दो साथ-साथ चार्ट बनाता है ताकि हम डायमेंशनलिटी रिडक्शन तकनीक लागू करने से पहले और बाद में डेटा कैसा दिखता है, यह तुलना कर सकें, जैसा नीचे दिखाया गया है:
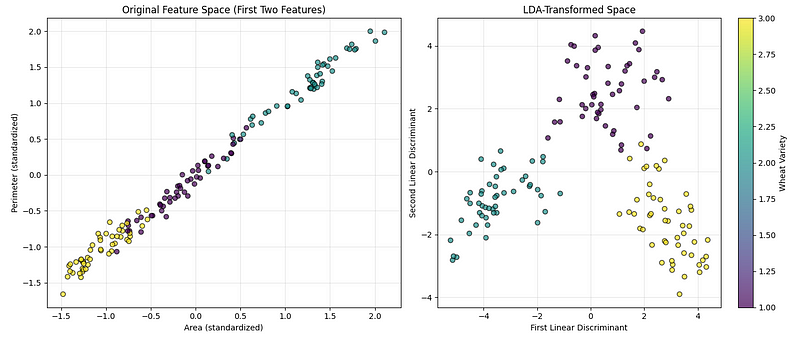 LDA विज़ुअलाइज़ेशन। (चित्र: लेखक)
पहला चार्ट दो मापे गए फीचर्स (एरिया और पेरिमीटर) का उपयोग कर मूल डेटा दिखाता है, ताकि हम देख सकें कि श्रेणियाँ स्वाभाविक रूप से कितनी अलग हैं। दूसरा चार्ट डेटा को उन सबसे सूचनाप्रद दिशाओं में ट्रांसफॉर्म करने के बाद दिखाता है जो श्रेणियों को अलग करने में सहायक हैं। एक कलरबार जोड़ा गया है जो बताता है कि कौन-सा रंग किस गेहूँ की किस्म को दर्शाता है।
LDA को सीधे एक क्लासिफायर के रूप में भी उपयोग किया जा सकता है।
आइए इसे लागू करें:
# Create LDA classifier
lda_classifier = LinearDiscriminantAnalysis()
lda_classifier.fit(X_train_scaled, y_train)

# Make predictions
y_pred = lda_classifier.predict(X_test_scaled)

# Calculate accuracy
accuracy = accuracy_score(y_test, y_pred)
print(f"Classification Accuracy: {accuracy:.4f}")

# Print classification report
print("\nClassification Report:")
print(classification_report(y_test, y_pred))
हम ट्रेनिंग डेटा के आधार पर गेहूँ की विभिन्न श्रेणियों को पहचानने के लिए एक मॉडल प्रशिक्षित कर रहे हैं। फिर हम नए, अनदेखे उदाहरणों पर इसके प्रदर्शन को समग्र सटीकता और प्रत्येक श्रेणी के पूर्वानुमान की गुणवत्ता से जाँचते हैं।
हमें निम्नलिखित आउटपुट दिखाई देता है:
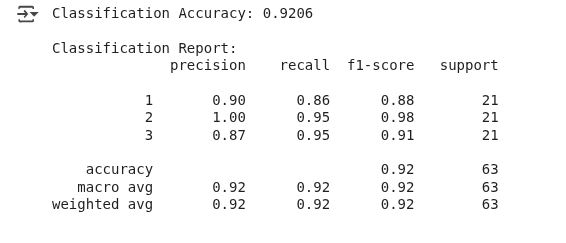
LDA क्लासिफिकेशन परिणाम। (चित्र: लेखक)
मॉडल ने लगभग 92% बार गेहूँ की किस्म को सही ढंग से भविष्यवाणी किया, जिसे अच्छा प्रदर्शन माना जा सकता है।
इस उदाहरण ने दिखाया कि यद्यपि LDA आमतौर पर डायमेंशनलिटी रिडक्शन के लिए उपयोग होता है, यह प्रत्येक क्लास के प्रायिकता वितरण को मॉडल कर और नई प्रविष्टियों को सर्वाधिक संभावना वाली क्लास में असाइन कर एक क्लासिफायर की तरह भी काम कर सकता है।
प्रिंसिपल कंपोनेंट एनालिसिस एक अन्य लोकप्रिय डायमेंशनलिटी रिडक्शन तकनीक है जो डेटा में सर्वाधिक वैरिएंस की दिशाएँ खोजती है।
आइए अपने पहले के उदाहरण का विस्तार कर LDA की तुलना PCA से करें:
from sklearn.decomposition import PCA
# Apply PCA with 2 components
pca = PCA(n_components=2)
X_train_pca = pca.fit_transform(X_train_scaled)
X_test_pca = pca.transform(X_test_scaled)

# Create comparison visualization
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# Plot PCA results
scatter1 = ax1.scatter(X_train_pca[:, 0], X_train_pca[:, 1],
                      c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax1.set_xlabel('First Principal Component')
ax1.set_ylabel('Second Principal Component')
ax1.set_title(f'PCA Transformation\nExplained Variance: {pca.explained_variance_ratio_.sum():.2%}')
ax1.grid(True, alpha=0.3)

# Plot LDA results
scatter2 = ax2.scatter(X_train_lda[:, 0], X_train_lda[:, 1],
                      c=y_train, cmap='viridis', alpha=0.7, edgecolor='k')
ax2.set_xlabel('First Linear Discriminant')
ax2.set_ylabel('Second Linear Discriminant')
ax2.set_title(f'LDA Transformation\nExplained Variance: {lda.explained_variance_ratio_.sum():.2%}')
ax2.grid(True, alpha=0.3)

plt.colorbar(scatter1, ax=ax1, label='Wheat Variety')
plt.colorbar(scatter2, ax=ax2, label='Wheat Variety')
plt.tight_layout()
plt.show()
हमें निम्नलिखित प्लॉट दिखाई देता है:
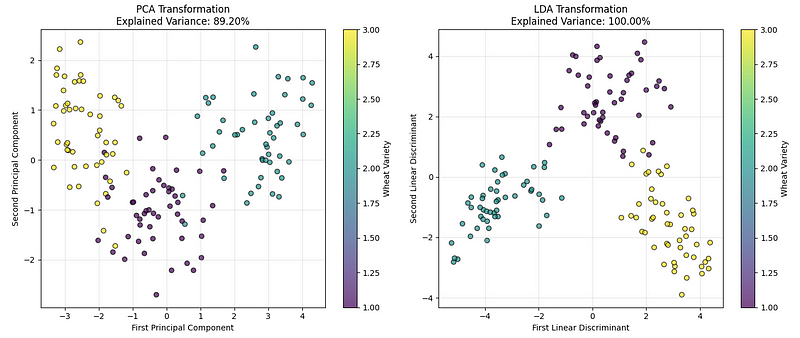 LDA बनाम PCA तुलना। (चित्र: लेखक)
बायाँ चार्ट PCA का उपयोग करते हुए डेटा दिखाता है, जो डेटा में समग्र रूप से सर्वाधिक वैरिएंस पकड़ने वाली दिशाएँ खोजता है। दायाँ चार्ट LDA का परिणाम दिखाता है, जो गेहूँ की श्रेणियों को सबसे अच्छी तरह अलग करने वाली दिशाएँ खोजता है।
हमारे इम्प्लीमेंटेशन परिणामों और explained variance मानों के आधार पर, हम निष्कर्ष निकाल सकते हैं कि जबकि दोनों अच्छा प्रदर्शन करते हैं, इस तरह की क्लासिफिकेशन समस्याओं में LDA आमतौर पर समूहों के बीच अधिक स्पष्ट पृथकता बनाता है।
LDA को अन्य डायमेंशनलिटी रिडक्शन तकनीकों से जो अलग करता है, वह इसका सुपरवाइज्ड स्वभाव है। जहाँ PCA क्लास लेबल पर ध्यान दिए बिना केवल डेटा की वैरिएंस पर विचार करता है, वहीं LDA स्पष्ट रूप से क्लास जानकारी का उपयोग सबसे अधिक भेदकारी दिशाएँ खोजने के लिए करता है। यह तब आदर्श है जब उच्च-आयामी डेटा में क्लास की पृथकता समग्र वैरिएंस के संरक्षण से अधिक महत्वपूर्ण हो।
इस प्रकार, PCA का उपयोग तब किया जा सकता है जब:
इसी प्रकार, LDA का उपयोग तब करें जब:
किसी भी एल्गोरिथ्म की तरह, LDA की भी खूबियाँ और सीमाएँ हैं, जिनका उपयोग से पहले ध्यान रखना चाहिए।
इन ट्रेड-ऑफ्स को समझना हमें यह निर्धारित करने में मदद करता है कि मौजूदा समस्या पर LDA सबसे उपयुक्त एल्गोरिथ्म है या नहीं।
इस लेख में लिनीयर डिस्क्रिमिनेंट एनालिसिस का परिचय दिया गया—एक सुपरवाइज्ड तकनीक जो between-class और within-class scatter के अनुपात को अधिकतम कर डायमेंशनलिटी रिडक्शन को क्लासिफिकेशन के साथ जोड़ती है।
हमने LDA की गणितीय नींवों का अन्वेषण किया, उसे Python में लागू किया, और PCA से तुलना कर समझा कि कब कौन-सी तकनीक अधिक उपयुक्त है। हमने LDA के वास्तविक दुनिया में उपयोग भी सीखे और इसके फायदे व सीमाओं पर चर्चा की।
LDA और संबंधित मशीन लर्निंग तकनीकों की समझ गहरी करने के लिए, हमारे Supervised Machine Learning in Python ट्रैक में नामांकन पर विचार करें, जहाँ आप विभिन्न एल्गोरिथ्म और उनके इम्प्लीमेंटेशन में दक्ष होंगे; या हमारे Dimensionality Reduction in Python कोर्स में शामिल हों ताकि सुपरवाइज्ड और अनसुपरवाइज्ड दोनों प्रकार की डायमेंशन रिडक्शन तकनीकों में गहराई से जाएँ।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स