

构建 Llama 3.2 多模态应用
既然我们已经完成了导入并成功设置了模型,下面进入应用的核心部分——处理输入(文本与图像)并生成响应。
文本到文本生成
我们先定义一个函数,接收用户文本以及可选的图像,然后使用 Llama 3.2 模型生成回复。
def process_ticket(text, image=None):
model, processor = load_model()
try:
if image:
# Resize the image for consistency
image = image.convert("RGB").resize((224, 224))
prompt = f"<|image|><|begin_of_text|>{text}"
# Process both the image and text input
inputs = processor(images=[image], text=prompt, return_tensors="pt").to(model.device)
else:
prompt = f"<|begin_of_text|>{text}"
# Process text-only input
inputs = processor(text=prompt, return_tensors="pt").to(model.device)
# Generate response (restrict token length for faster output)
outputs = model.generate(**inputs, max_new_tokens=200)
# Decode the response from tokens to text
response = processor.decode(outputs[0], skip_special_tokens=True)
return response
except Exception as e:
print(f"Error processing ticket: {e}")
return "An error occurred while processing your request."该函数在循环中处理两类输入:
- 仅文本:如果未提供图像,模型将基于文本输入生成回复。
- 文本 + 图像:如果提供图像,模型会在生成回复前同时处理文本与图像。
识别输入类型后,会将其传入来自 transformers 库的处理器进行处理。随后,模型在 max_new_tokens 指定的范围内生成输出。
创建 Gradio 界面
Gradio 界面将所有内容整合在一起,使我们能够以 Web 形式进行测试。用户可以提交遇到问题的文本与图片,并查看 AI 生成的解决方案。
先看代码,再进行说明。
def create_interface():
text_input = gr.Textbox(
label="Describe your issue",
placeholder="Describe the problem you're experiencing",
lines=4,
)
image_input = gr.Image(label="Upload a Screenshot (Optional)", type="pil")
# Output element
output = gr.Textbox(label="Suggested Solution", lines=5)
# Create the Gradio interface
interface = gr.Interface(
fn=process_ticket, # Function to process inputs
inputs=[text_input, image_input], # User inputs (text and image)
outputs=output, # AI-generated output
title="Multimodal Customer Support Assistant",
description="Submit a description of your issue, along with an optional screenshot, and get AI-powered suggestions.",
)
# Launch the interface with debug mode
interface.launch(debug=True)在上述代码中,我们:
- 定义两个输入:
text_input用于文本image_input用于图像- 指定一个输出框用于显示回复。
- 创建界面,并传入以下参数:
- 输入
- 用于处理输入的函数
- 模型生成的输出
- 界面标题
- 描述(如需)
- 搭建基础用户界面。
- 使用
debug = True启动界面以调试错误。代码稳定后可改回False。
最终界面如下所示:
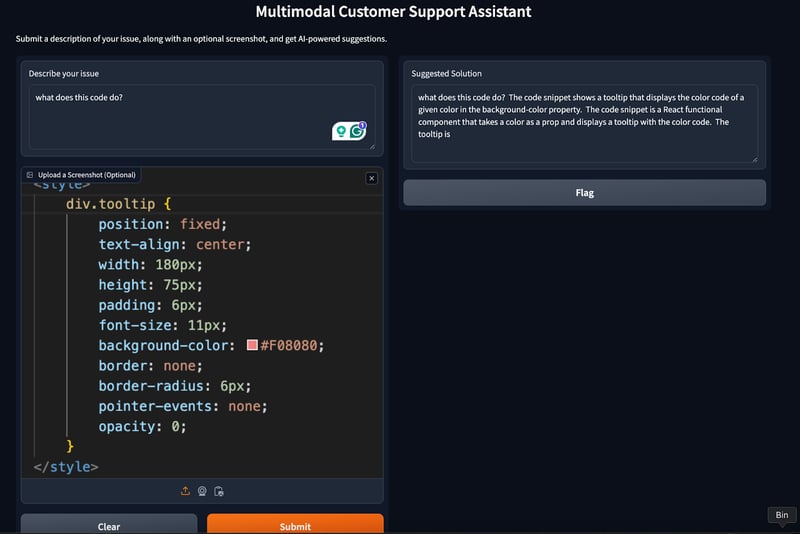
我们的多模态客户支持助手 Gradio 应用已经就绪!为获得理想回复,您可以尝试调整 max_new_tokens 参数,或对提示词做些改动。
Llama 3.2 与 Gradio 的应用场景
除本教程中的演示外,还有一些几乎不需额外工作量的用例,包括:
- 教育与辅导:学生可以在提问时上传图表或示意图等可视化辅助资料,模型则可结合图像与文本信息生成完整解答。
- 内容创作:基于图像生成文本,改进标题、博文与社交媒体内容的创作。
- 房产虚拟助理:通过处理房源图片并解答相关问题来辅助经纪人与客户。生成房源描述或从照片中分析视觉细节。
使用 Llama 3.2 与 Gradio 的开发最佳实践
针对每个用例,开发类似本教程应用时都有一些通用建议。以下是使用 Llama 3.2 等模型时可采纳的最佳实践。
处理时延
多模态任务通常资源开销较大,降低延迟至关重要。可通过缓存、模型剪枝或限制生成的 token 数来优化响应速度。
错误处理
务必设置错误处理机制。当模型因图像质量差等原因无法生成有意义的回复时,可提供回退答案或错误信息。也可以选择引入人工反馈,从而反向促进模型改进。
性能监控
跟踪应用性能(如响应时间与用户交互数据)有助于优化界面并提升用户体验。通过记录耗时,我们可以尝试使用如 bits and bytes 等库优化模型延迟。
结语
在本指南中,我们学会了将 Llama 3.2 的多模态能力与 Gradio 的直观界面相结合。从客户支持到教育与内容创作,其潜在应用广泛而多样。
通过遵循诸如时延管理、错误处理与性能监控等最佳实践,我们可以确保基于 Llama 3.2 与 Gradio 的应用稳健、高效且易用。
想要进一步学习,推荐以下教程:

我是一名 Google Developers 机器学习(生成式 AI)领域的专家、Kaggle 三项专家,以及 Women Techmakers 大使,拥有 3 年以上的技术从业经验。2020 年我共同创办了一家健康科技初创公司,目前在佐治亚理工学院攻读计算机科学硕士,专攻机器学习。
只会处理文本的大型语言模型已难以满足需求。如今我们需要大型语言模型,还能理解并与文本、图像、视频进行交互的多模态 LLM。
这正是Llama 3.2 11B 与 90B 视觉模型的用武之地——Meta AI 的首批开源多模态模型,能够处理文本与图像输入。
在本实践指南中,我将带您借助 Llama 3.2 和 Gradio 构建一个多模态客户支持助手。教程结束时,您将拥有一个完整可用的 Web 应用,既能分析文本描述,也能分析上传的图片,从而生成有用的解决方案——就像工单助手一样!
如果在开始之前您需要快速了解 Llama 3.2,建议先阅读这篇Llama 3.2 指南。
初始设置
在本次演示中,我们将使用 Llama3.2-11B-Vision(多模态)模型。开始编码之前,先确认所有必要依赖已就绪。
我们需要一些库来完成整体工作,核心包括:
运行以下命令安装必要依赖:
加载 Llama 3.2 模型与处理器
现在来加载 Llama 3.2 模型与处理器。我们将使用Hugging Face 的 transformers 库来加载模型与处理器,确保在可用时使用 GPU,否则回退到 CPU。作为 110 亿参数模型,它在 Google Colab 的 A100 GPU 上表现良好。
下面的代码块中:
tie_weight(),用于确保输入与输出嵌入层的权重相同。这可减少内存占用并提升性能。为什么选择 Gradio?
Gradio 是一个轻量级 Python 库,可快速构建带 Web 界面的机器学习应用。无需编写复杂的 HTML 或 JavaScript,只需在 Python 中直接定义应用组件(如文本框、按钮或图像)。
下面是一个基础的 Gradio 界面示例:
Gradio 的优点包括:
在本次演示中,Gradio 让用户可以同时输入文本与图像,并实时查看输出(即对文本与图像的分析)。这非常适合在友好的环境中展示 Llama 3.2 等模型的强大能力。