
{count, plural, one {Cursus} other {Cursussen}}
Werken met Llama 3
{hours} uur
15.6K
De tijd dat we tevreden waren met large language models die alleen tekst kunnen verwerken, is voorbij. We willen nu multimodale LLMs die tekst, afbeeldingen en video's kunnen begrijpen en ermee kunnen omgaan.
Maak kennis met Llama 3.2 11B & 90B vision-modellen, de eerste open-source multimodale modellen van Meta AI, die zowel tekst- als afbeeldingsinvoer kunnen verwerken.
In deze praktische gids neem ik je mee door het proces van het bouwen van een multimodale klantenservice-assistent met behulp van Llama 3.2 en Gradio. Aan het einde van deze tutorial heb je een volledig werkende webapplicatie die tekstuele beschrijvingen en geüploade afbeeldingen kan analyseren om nuttige oplossingen te genereren—precies zoals een supportticket-assistent zou doen!
Heb je een korte introductie tot Llama 3.2 nodig voordat we beginnen? Lees dan deze Llama 3.2-gids.
In deze hands-on demo gebruiken we het Llama3.2-11B-Vision-model (multimodaal). Voordat we gaan coderen, zorgen we dat we alle benodigde dependencies hebben.
We hebben een paar libraries nodig om alles te laten werken. De belangrijkste zijn:
Voer de volgende commando's uit om de benodigde dependencies te installeren:
!pip3 install -U transformers bitsandbytes accelerate peft -q
!pip3 install gradio -qLaten we nu het Llama 3.2-model en de processor laden. We gebruiken de transformers-bibliotheek van Hugging Face om het model en de processor te laden, waarbij we ervoor zorgen dat het model op de GPU draait als die beschikbaar is, of anders standaard op de CPU. Met 11B parameters werkt het goed op een A100-GPU in Google Colab.
In het onderstaande codeblok:
tie_weight(), die ervoor zorgt dat de gewichten van de input- en output-embeddinglagen identiek zijn. Dit verlaagt het geheugengebruik en kan de prestaties verbeteren.import torch
from PIL import Image
import gradio as gr
from transformers import MllamaForConditionalGeneration, AutoProcessor
def load_model():
model_id = "meta-llama/Llama-3.2-11B-Vision-Instruct"
device = "cuda" if torch.cuda.is_available() else "cpu" # Check if GPU is available
model = MllamaForConditionalGeneration.from_pretrained(
model_id,
torch_dtype=torch.float16 if torch.cuda.is_available() else torch.float32,
device_map="auto", # Automatically map to available device
offload_folder="offload", # Offload to disk if necessary
)
model.tie_weights() # Tying weights for efficiency
processor = AutoProcessor.from_pretrained(model_id)
print(f"Model loaded on: {device}")
return model, processorGradio is een lichte Python-bibliotheek waarmee we snel machinelearning-apps met webinterfaces kunnen bouwen. In plaats van complexe HTML of JavaScript te schrijven, kunnen we de componenten van onze app (zoals tekstvakken, knoppen of afbeeldingen) rechtstreeks in Python definiëren.
Zo ziet een basis-UI in Gradio eruit:
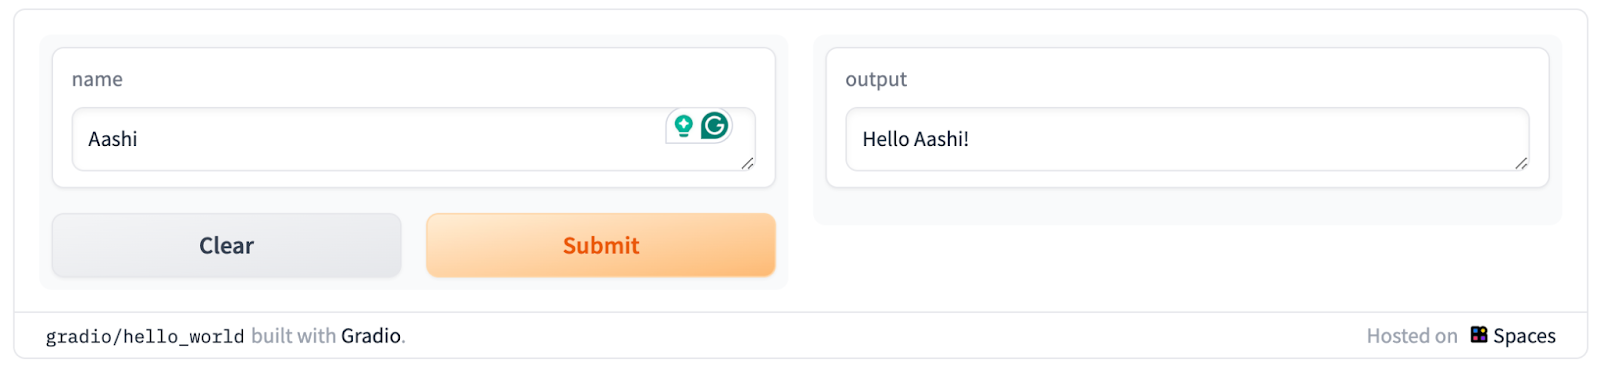
Gradio heeft een paar voordelen:
Voor deze demo maakt Gradio het eenvoudig voor gebruikers om zowel tekst als afbeeldingen in te voeren en de output (analyse van tekst en afbeelding, in dit geval) in realtime te zien. Het is perfect om de kracht van modellen zoals Llama 3.2 te laten zien in een gebruiksvriendelijke omgeving.
Nu we onze imports hebben ingesteld en het model succesvol hebben klaarzetten, gaan we door met het belangrijkste deel van de app—het verwerken van de invoer (tekst en afbeelding) en het genereren van het antwoord.
We beginnen met het definiëren van een functie die tekst van de gebruiker en eventueel een afbeelding aanneemt. Deze functie gebruikt vervolgens het Llama 3.2-model om een antwoord te genereren.
def process_ticket(text, image=None):
    model, processor = load_model()

    try:
        if image:
            # Resize the image for consistency
            image = image.convert("RGB").resize((224, 224))
            prompt = f"<|image|><|begin_of_text|>{text}"
            # Process both the image and text input
            inputs = processor(images=[image], text=prompt, return_tensors="pt").to(model.device)
        else:
            prompt = f"<|begin_of_text|>{text}"
            # Process text-only input
            inputs = processor(text=prompt, return_tensors="pt").to(model.device)

        # Generate response (restrict token length for faster output)
        outputs = model.generate(**inputs, max_new_tokens=200)
        # Decode the response from tokens to text
        response = processor.decode(outputs[0], skip_special_tokens=True)
        return response

    except Exception as e:
        print(f"Error processing ticket: {e}")
        return "An error occurred while processing your request."
Deze functie verwerkt twee soorten invoer binnen de lus:
Zodra het invoertype is vastgesteld, wordt het doorgegeven aan een processor uit de transformers-bibliotheek om de input te verwerken. Vervolgens genereert het model een output binnen de marge van max_new_tokens.
De Gradio-interface bindt alles samen en stelt ons in staat om tests in een webformaat uit te voeren. Met deze interface kunnen gebruikers tekst en afbeeldingen indienen van een probleem waar ze tegenaan lopen en de door AI gegenereerde oplossing zien.
Laten we naar de code kijken en die vervolgens toelichten.
def create_interface():
    text_input = gr.Textbox(
        label="Describe your issue",
        placeholder="Describe the problem you're experiencing",
        lines=4,
    )

    image_input = gr.Image(label="Upload a Screenshot (Optional)", type="pil")

    # Output element
    output = gr.Textbox(label="Suggested Solution", lines=5)

    # Create the Gradio interface
    interface = gr.Interface(
        fn=process_ticket,  # Function to process inputs
        inputs=[text_input, image_input],  # User inputs (text and image)
        outputs=output,  # AI-generated output
        title="Multimodal Customer Support Assistant",
        description="Submit a description of your issue, along with an optional screenshot, and get AI-powered suggestions.",
    )

    # Launch the interface with debug mode
    interface.launch(debug=True)
In de bovenstaande code doen we het volgende:
text_input voor tekstimage_input voor afbeeldingdebug = True om fouten te debuggen. Zodra de code goed werkt, zet je dit terug naar False.De uiteindelijke interface ziet er zo uit:
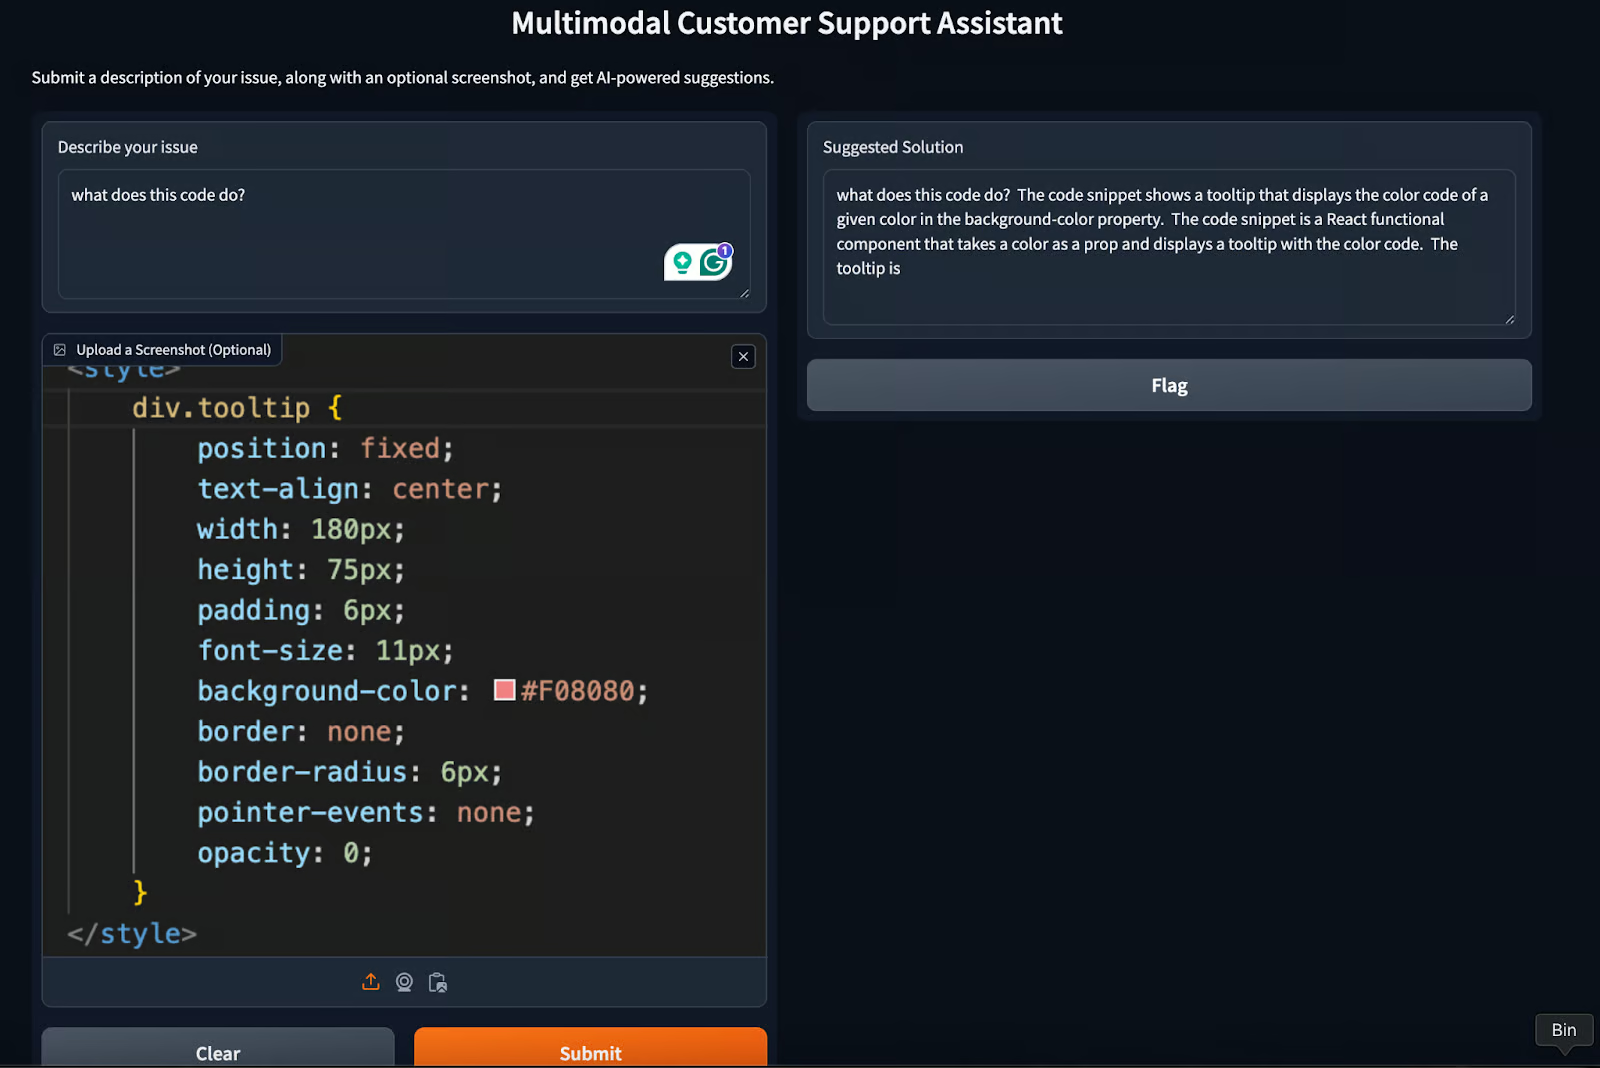
Onze multimodale klantenservice-assistent in Gradio is klaar! Pas voor het gewenste resultaat de parameter max_new_tokens aan of speel een beetje met de prompt.
Naast de demo die we in deze tutorial hebben gemaakt, zijn er nog een paar andere use-cases die minimale inspanning vergen. Deze omvatten:
Voor elke use-case zijn er een paar tips die elke developer kan toepassen tijdens het bouwen van een app zoals die we al hebben gemaakt. Hier zijn enkele best practices die je kunt hanteren bij het werken met modellen zoals Llama 3.2.
Omdat multimodale taken veel resources kunnen vragen, is het beperken van latency essentieel. Overweeg het model te optimaliseren voor snellere reacties door caching te gebruiken, model pruning toe te passen of het aantal te genereren tokens te beperken.
Het is belangrijk om mechanismen in te bouwen om fouten af te handelen. In gevallen waarin het model geen zinvol antwoord kan genereren (bijv. door slechte beeldkwaliteit), kunnen we fallback-antwoorden of foutmeldingen geven. We kunnen zelfs kiezen voor menselijke feedback, wat op zijn beurt helpt om het model te verbeteren.
Het bijhouden van de prestaties van de app, zoals responstijden en gebruikersinteracties, kan helpen de interface te optimaliseren en de gebruikerservaring te verbeteren. Door de verwerkingstijd te meten kunnen we proberen de model-latency te optimaliseren met libraries zoals bits and bytes.
In deze gids hebben we geleerd hoe je de multimodale mogelijkheden van Llama 3.2 combineert met de intuïtieve interface van Gradio. Van klantenservice tot onderwijs en contentcreatie: de toepassingsmogelijkheden zijn groot en divers.
Door best practices te volgen zoals het managen van latency, foutafhandeling en prestatiemonitoring, zorg je ervoor dat je Llama 3.2- en Gradio-applicaties robuust, efficiënt en gebruiksvriendelijk zijn.
Wil je meer leren? Dan raad ik deze tutorials aan:
Leer AI met deze cursussen!
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

