
Cours
Concepts d'IA générative
2 h
117.3K
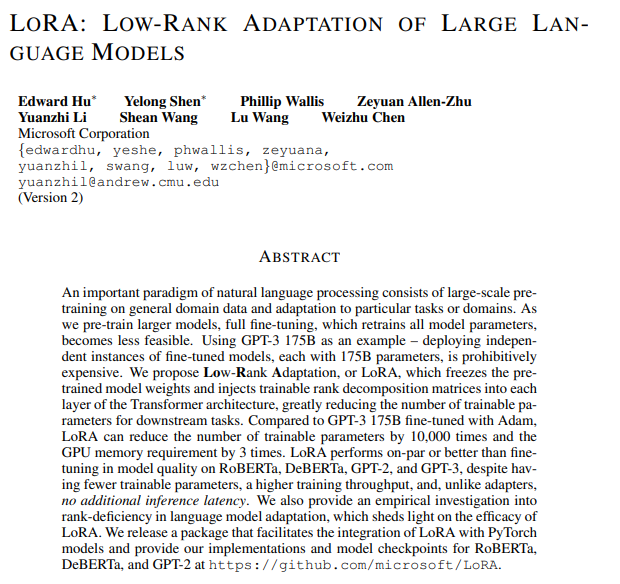
LoRA : Low-Rank Adaptation of Large Language Models
Le domaine de l'apprentissage automatique et du traitement du langage naturel (NLP) a connu une avancée remarquable avec l'émergence des grands modèles de langage (LLM) tels que GPT, LLaMa, Claude 2, etc. Ces modèles affichent des performances exceptionnelles dans de nombreux usages, de la génération de texte à la compréhension du langage.
Cependant, le déploiement en production et le fine-tuning de ces modèles posent des défis majeurs, principalement en raison de leur taille et de leur complexité.
C'est là que la Low-Rank Adaptation (LoRA) entre en jeu, en apportant une réponse efficace à ces défis.
L'objectif de ce tutoriel est de vous donner une compréhension théorique et pratique de ce qu'est LoRA et de la manière d'en tirer parti.
L'idée de LoRA remonte au début de 2021, après la sortie de GPT-3. Microsoft, en collaboration avec OpenAI, devait relever le défi de rendre des modèles géants comme GPT-3 viables commercialement.
Ils ont constaté que le simple one-shot prompting ne suffisait pas pour atteindre des performances optimales en production, en particulier pour des tâches complexes comme la traduction de langage naturel en code. Ils ont donc exploré des méthodes de fine-tuning à la fois économiques et efficaces.
L'invention de LoRA répond au besoin produit de permettre un fine-tuning rapide, efficace et abordable des grands modèles de langage pour offrir de la spécificité métier, un basculement de tâches efficient, ou encore un changement d'utilisateur à l'exécution.
L'article de recherche LoRA a été publié en octobre 2021 par une équipe de chercheurs de Microsoft.
Comprenons d'abord le problème, avant même de voir ce qu'est LoRA et comment cela le résout.
Les grands modèles de langage comme GPT-4, Claude 2, LLaMA 70b, etc., sont excellents, mais très génériques et très volumineux. Pour les adapter à des domaines spécifiques comme la santé ou la banque, ou à des tâches comme la conversion de texte en code, nous avons besoin de ce qu'on appelle le fine-tuning.
Le fine-tuning consiste à réentraîner un modèle pré-entraîné sur un jeu de données plus petit et ciblé afin de spécialiser ses performances sur une tâche ou un domaine donné. À mesure que les modèles grossissent (par exemple, GPT-3 compte 175 milliards de paramètres), le fine-tuning complet, qui réentraîne tous les paramètres, devient de moins en moins réaliste en raison du temps, des coûts et des ressources nécessaires.
LoRA est une technique utilisée pour le fine-tuning de modèles de grande taille.
À un niveau élevé, voici le principe de LoRA :
On conserve le modèle d'origine inchangé et l'on ajoute à chaque couche de petites composantes ajustables. Cela réduit fortement le nombre de paramètres entraînables et la mémoire GPU nécessaire pendant l'entraînement, ce qui est un autre défi majeur pour le fine-tuning ou l'entraînement de grands modèles.
Par exemple, un fine-tuning complet de GPT-3 impose d'entraîner 175 milliards de paramètres. Avec LoRA, les paramètres entraînables pour GPT-3 sont réduits d'environ 10 000 fois et les besoins en mémoire GPU sont divisés par trois.
En substance, LoRA répond à ces problématiques :
Avant d'entrer dans les détails de LoRA, voyons la notion de matrices de rang inférieur.
Les matrices de rang inférieur relèvent des mathématiques, en particulier de l'algèbre linéaire. En termes simples, le rang d'une matrice mesure la « quantité d'information » ou la « dimensionnalité » des données qu'elle représente. Décomposons cela :
Exemple :
Considérons une matrice 3 × 3 :
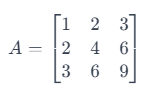
Ici, la deuxième ligne est simplement la première multipliée par 2, et la troisième est la première multipliée par 3. Les lignes ne sont donc pas indépendantes. Le rang de cette matrice est 1 (seule la première ligne est indépendante), inférieur au rang maximal possible pour une 3×3, qui est 3. C'est donc une matrice de rang inférieur.
Les matrices de rang inférieur sont importantes dans de nombreuses applications comme la compression de données, où réduire le rang aide à compresser tout en préservant un maximum d'information.
Le rang d'une matrice s'applique indifféremment aux lignes et aux colonnes. Le point clé est que le rang est identique qu'on le calcule via les lignes ou via les colonnes, en vertu d'un résultat fondamental appelé théorème du rang (Rank-Nullity Theorem).
En termes plus simples, ce théorème indique que les dimensions de l'espace des lignes et de l'espace des colonnes d'une matrice sont égales. Cette dimension commune est précisément le rang de la matrice.
Ainsi, dans l'exemple 3 × 3 ci-dessus, le rang est 1 : une seule ligne et une seule colonne sont linéairement indépendantes.
Très simplement, LoRA exploite le concept de matrices de rang inférieur pour rendre l'entraînement des modèles extrêmement efficace et rapide.
Les grands modèles contiennent énormément de paramètres. Par exemple, GPT-3 en compte 175 milliards. Ces paramètres sont des nombres stockés dans des matrices et leur stockage requiert beaucoup d'espace.
Un fine-tuning complet signifie réentraîner tous les paramètres, ce qui exige des ressources de calcul considérables et peut coûter des millions de dollars pour un modèle de la taille de GPT.
Contrairement au fine-tuning classique qui ajuste l'ensemble du modèle, LoRA se concentre sur la modification d'un sous-ensemble réduit de paramètres (des matrices de rang inférieur), réduisant ainsi la charge de calcul et mémoire.
LoRA repose sur l'idée que les grands modèles présentent intrinsèquement une structure de faible dimension. En tirant parti de matrices de rang inférieur, LoRA adapte ces modèles efficacement. Le principe est que des changements significatifs du modèle peuvent être représentés avec moins de paramètres, rendant l'adaptation plus efficiente.
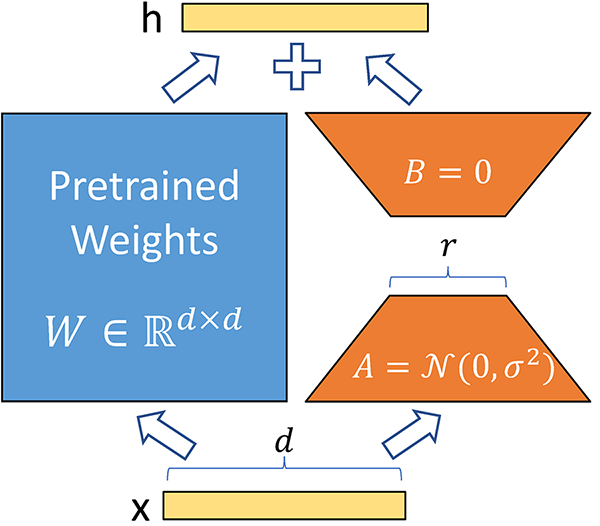
Source : Fine-Tuning LLMs: LoRA or Full-Parameter? An in-depth Analysis with Llama 2
D'abord, on décompose les grandes matrices de poids en matrices plus petites à l'aide de la technique de rang inférieur, comme expliqué plus haut. Cela réduit drastiquement le nombre de paramètres entraînables. Pour un modèle comme GPT-3, on divise par 10 000 le nombre de paramètres à entraîner. Autrement dit, au lieu d'entraîner 175 milliards de paramètres, avec LoRA, vous n'en entraînez plus que 17,5 millions.
Nous ne modifions aucun paramètre du modèle pré-entraîné. Nous n'entraînons que les matrices de rang inférieur, ce qui est beaucoup plus rapide puisqu'il y a bien moins de paramètres.
Les poids sont additifs. Pour l'inférence, on additionne simplement les poids des matrices de rang inférieur aux poids pré-entraînés, sans latence supplémentaire. Ces matrices étant très petites, il est facile de les charger/décharger pour différentes tâches et différents utilisateurs.
L'utilisation de LoRA pour le fine-tuning présente plusieurs atouts :
LoRA allège la charge de calcul et permet d'adapter plus vite les modèles. En nécessitant moins de paramètres entraînables, LoRA rend possible le fine-tuning de grands modèles sur du matériel moins puissant.
Malgré la réduction du nombre de paramètres, LoRA préserve la qualité du modèle d'origine ainsi que sa vitesse d'inférence.
LoRA diminue drastiquement la taille des checkpoints. Par exemple, sur GPT-3, la taille est passée de 1 To à seulement 25 Mo.
LoRA n'introduit aucune latence supplémentaire à l'inférence. Les matrices de rang inférieur servent à l'entraînement, puis sont fusionnées avec les paramètres d'origine pour l'inférence, sans ralentissement. Cela permet de basculer rapidement de modèle à l'exécution, sans surcoût de latence.
LoRA s'applique à tout modèle utilisant des multiplications de matrices (comme une machine à vecteurs de support), ce qui en fait une technique largement transposable à bien d'autres cas. LoRA est d'ailleurs très utilisée avec les modèles Stable Diffusion pour injecter des styles dans de grands modèles d'images.
La technique LoRA est également très adoptée dans les modèles d'images comme Stable Diffusion.
L'idée est très proche de celle des modèles de langage. Plutôt que de faire un fine-tuning complet de grands modèles comme Stable Diffusion, on entraîne uniquement des matrices de rang inférieur sur de petits jeux de données.
Dans le cas des modèles de langage, l'objectif est la spécificité métier. Pour les modèles d'images, l'usage le plus courant est l'adoption d'un style ou d'un personnage cohérent lors de la génération d'images.
Ces matrices de rang inférieur sont appelées adaptateurs ; elles sont très petites, et il en existe des milliers en ligne que vous pouvez télécharger, superposer à votre modèle Stable Diffusion de base et générer des images spécifiques à un style.
Quelques usages fréquents des modèles LoRA pour Stable Diffusion :
Vous pouvez combiner plusieurs LoRA pour obtenir des sorties reflétant plusieurs spécialisations.
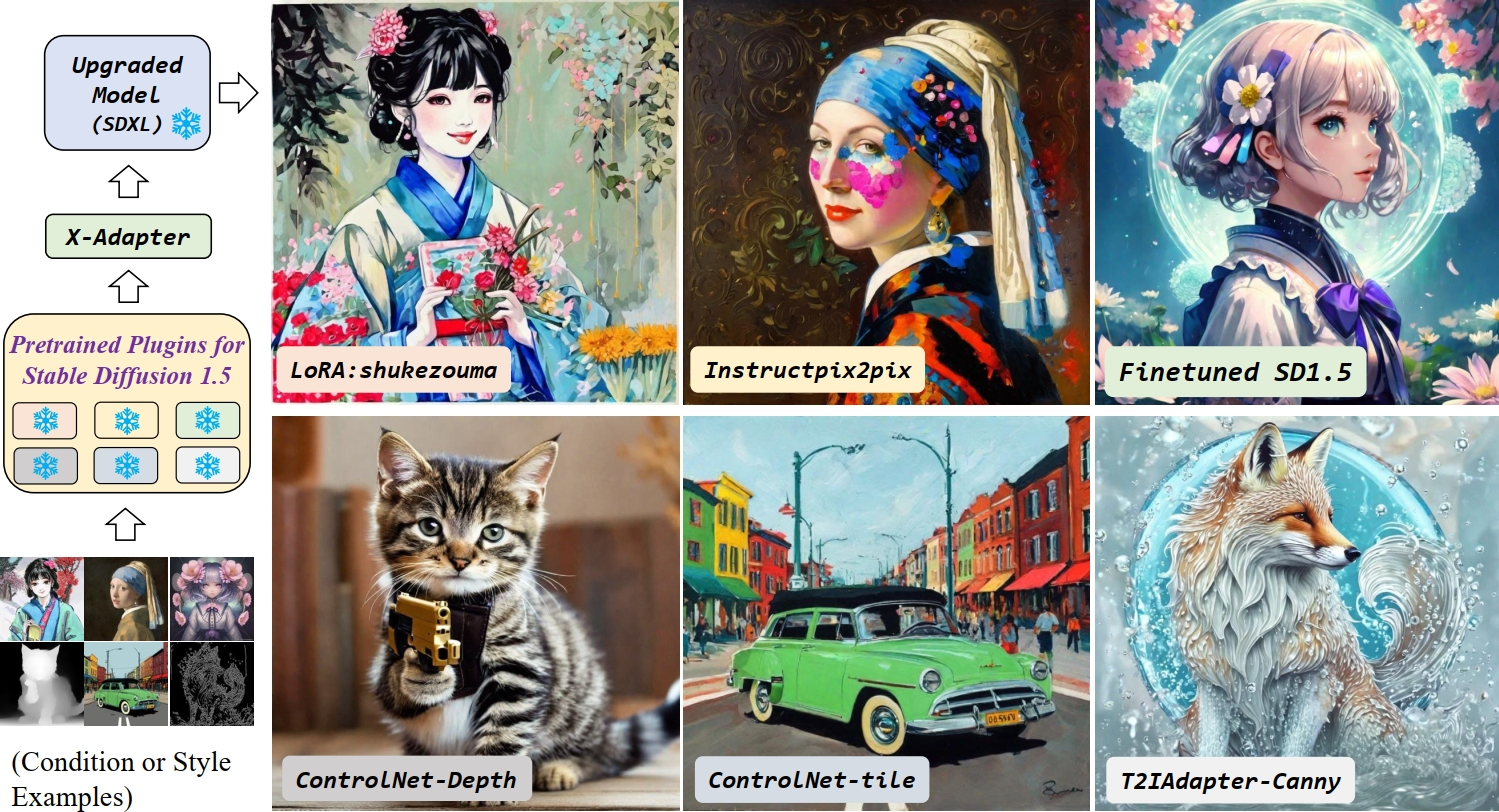
Différents adaptateurs pour les modèles Stable Diffusion (Source de l'image)
Pour apprendre à fine-tuner Stable Diffusion XL sur des photos personnelles, lisez le billet Fine-tuning Stable Diffusion XL with DreamBooth and LoRA sur Datacamp.
Le prefix-tuning est une méthode légère où des vecteurs continus appelés « préfixes » sont optimisés et ajoutés à l'entrée de chaque couche du Transformer. Le modèle est entraîné en ignorant le reste, en se concentrant uniquement sur ces vecteurs.
LoRA et le prefix-tuning peuvent être combinés dans le cadre PEFT (Parameter Efficient Fine-Tuning) :
Pour implémenter LoRA, vous pouvez utiliser la bibliothèque Loralib de Microsoft. Pour installer la bibliothèque :
pip install loralib
La manière d'entraîner votre réseau de neurones ne change quasiment pas avec l'adoption de LoRA.
# ===== Avant =====
# layer = nn.Linear(in_features, out_features)

# ===== Après ======
import loralib as lora
# Ajouter une paire de matrices d'adaptation de rang faible avec r=16
layer = lora.Linear(in_features, out_features, r=16)
Avant de lancer la boucle d'entraînement, il suffit d'ajouter :
import loralib as lora

model = YourNeuralNetwork()

# Cela fixe requires_grad à False pour tous les paramètres
lora.mark_only_lora_as_trainable(model)

# Boucle d'entraînement
for batch in dataloader:
   ...
Au moment d'enregistrer un checkpoint, vous pouvez générer un state_dic qui ne contient que les paramètres LoRA.
# ===== Avant =====
# torch.save(model.state_dict(), checkpoint_path)

# ===== Après =====
torch.save(lora.lora_state_dict(model), checkpoint_path)
Si vous ne maîtrisez pas encore bien les réseaux de neurones, pas d'inquiétude. Consultez le billet How to Train a LLM with PyTorch pour apprendre à entraîner des grands modèles de langage avec PyTorch, de la configuration initiale à la mise en œuvre finale.
Crédits : l'exemple de code est repris du GitHub Microsoft/LoRA.
LoRA s'impose comme une technique incontournable pour relever les défis majeurs liés à la taille et à la complexité des grands modèles.
En exploitant des matrices de rang inférieur, LoRA propose une approche plus efficace et économique de l'adaptation des modèles, en réduisant fortement les paramètres entraînables et la mémoire GPU requise, ce qui permet un entraînement plus rapide et une meilleure efficience mémoire.
Les usages de LoRA dépassent les modèles de langage et s'étendent aux modèles d'images comme Stable Diffusion, où elle facilite la spécialisation de style et la cohérence des personnages lors de la génération d'images.
Si vous êtes curieux et souhaitez explorer ce qu'il est possible de construire avec ces technologies, consultez notre guide 5 Projects You Can Build with Generative AI Models pour en savoir plus.
Commencez votre parcours en IA dès aujourd'hui !
Cours
Cours
Cours