
Kurs
Üretken Yapay Zeka Kavramları
2 sa
121.3K
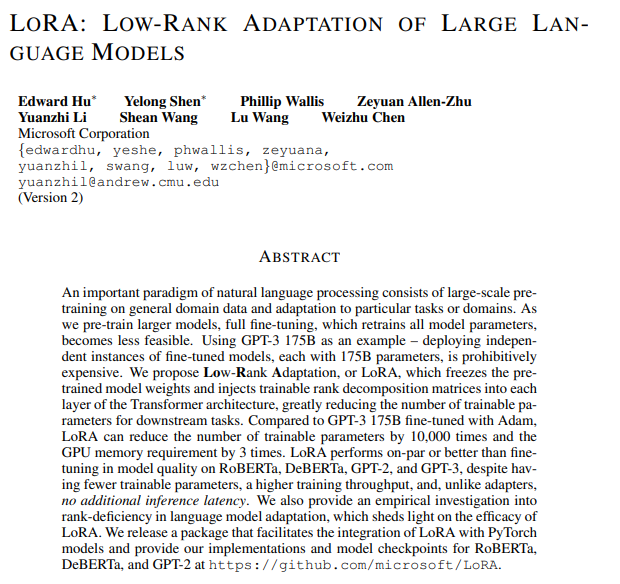
LoRA: Büyük Dil Modellerinin Düşük-Rank Uyumu
Makine öğrenimi ve doğal dil işleme (NLP) alanı, Büyük Dil Modellerinin (LLM)—örneğin GPT, LLaMa, Claude 2 vb.—ortaya çıkışıyla dikkate değer bir ilerleme kaydetti. Bu modeller, metin üretiminden dil anlama görevlerine kadar çok çeşitli uygulamalarda olağanüstü yetenekler sergiledi.
Bununla birlikte, bu modellerin pratik olarak devreye alınması ve ince ayarı özellikle boyutları ve karmaşıklıkları nedeniyle önemli zorluklar barındırır.
İşte bu noktada Düşük-Rank Uyum (LoRA), bu zorluklara etkili bir çözüm sunar.
Bu eğitimin amacı, LoRA’nın ne olduğunu ve ondan nasıl yararlanabileceğinizi teorik ve pratik açıdan kavratmaktır.
LoRA’nın ortaya çıkışı, GPT-3’ün piyasaya sürülmesinin ardından, 2021’in başlarına dayanır. Microsoft, OpenAI ile iş birliği içinde, GPT-3 gibi büyük modelleri ticari olarak uygulanabilir kılma sorunuyla karşı karşıya kaldı.
Tek seferlik istemlemenin üretimde, özellikle doğal dilden koda çeviri gibi karmaşık görevlerde, en iyi performansı elde etmek için yetersiz olduğu görüldü. Bu durum, hem maliyet etkin hem de verimli ince ayarlama yöntemlerinin araştırılmasına yol açtı.
LoRA’nın icadı, büyük dil modellerinin alan özgüllüğünü, görevler arasında verimli geçişi veya çalışma zamanında kullanıcılar arasında geçişi mümkün kılmak için hızlı, verimli ve uygun maliyetli ince ayar ihtiyacına dayanır.
LoRA araştırma makalesi Ekim 2021’de Microsoft’tan bir araştırma ekibi tarafından yayımlandı.
LoRA’nın ne olduğunu ve nasıl çözdüğünü anlamadan önce, önce sorunu kavrayalım.
GPT-4, Claude 2, LLaMA 70B gibi büyük dil modelleri harikadır, ancak oldukça genel amaçlı ve çok büyüktür. Bu büyük dil modellerini sağlık veya bankacılık gibi belirli alanlara ya da metni koda dönüştürmek gibi belirli görevlere uyarlamak için ince ayar adı verilen bir şeye ihtiyaç duyarız.
İnce ayar, önceden eğitilmiş bir modelin belirli bir görev veya alan için performansını uzmanlaştırmak üzere daha küçük, özel bir veri seti üzerinde yeniden eğitilmesidir. Modeller büyüdükçe (örneğin, GPT-3’ün 175 milyar parametresi vardır), tüm model parametrelerinin yeniden eğitildiği tam ince ayar; zaman, maliyet ve kaynaklar nedeniyle daha az uygulanabilir hale gelir.
LoRA, büyük modelleri ince ayar yapmak için kullanılan bir tekniktir.
Yüksek düzeyde bakarsak LoRA şu şekilde çalışır:
Orijinal modeli değiştirmeden bırakır ve modelin her katmanına küçük, değiştirilebilir parçalar ekler. Bu, modelin eğitilebilir parametrelerini önemli ölçüde azaltır ve ince ayar veya büyük modellerin eğitimi söz konusu olduğunda bir diğer önemli zorluk olan eğitim sürecinin GPU bellek gereksinimini düşürür.
Örneğin, GPT-3 modelinin tam ince ayarı 175 milyar parametreyi eğitmeyi gerektirir. LoRA kullanıldığında, GPT-3 için eğitilebilir parametreler yaklaşık 10.000 kat azalır ve GPU bellek gereksinimleri üçte bire iner.
Özetle, LoRA şu sorunları çözer:
LoRA’nın ayrıntılarına girmeden önce, daha düşük ranklı matris kavramını anlayalım.
Daha düşük ranklı matrisler, matematikte, özellikle lineer cebirde bir kavramdır. Basitçe, bir matrisin rank’ı, matrisin temsil ettiği verinin "bilgi içeriği"nin veya "boyutsallığının" bir ölçüsüdür. Bunu açalım:
Örnek:
3 x 3 bir matrisi düşünün:
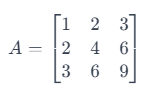
Burada, ikinci satır birinci satırın 2 ile çarpılmış hâlidir ve üçüncü satır birinci satırın 3 ile çarpılmış hâlidir. Bu, satırların lineer bağımsız olmadığını gösterir. Bu matrisin rank’ı 1’dir (yalnızca birinci satır bağımsız olduğu için) ve 3x3 bir matris için mümkün olan azami rank olan 3’ten düşüktür. Dolayısıyla bu, daha düşük ranklı bir matristir.
Daha düşük ranklı matrisler, örneğin verinin mümkün olduğunca çok bilgisini korurken rank’ı azaltmanın veriyi sıkıştırmaya yardımcı olduğu veri sıkıştırma gibi çeşitli uygulamalarda önemlidir.
Bir matriste rank kavramı hem satırlar hem de sütunlar için eşit şekilde geçerlidir. Anlaşılması gereken kritik nokta, rank’ın satırlara ya da sütunlara göre hesaplanmasından bağımsız olarak aynı olduğudur. Bu durum, Rank-Nullity Teoremi olarak bilinen temel bir lineer cebir özelliğinden kaynaklanır.
Daha basit bir ifadeyle, teorem, bir matrisin satır uzayının (satırların oluşturduğu uzay) ve sütun uzayının (sütunların oluşturduğu uzay) boyutlarının eşit olduğunu söyler. Bu ortak boyut, matrisin rank’ı olarak adlandırılır.
Dolayısıyla, yukarıdaki 3 x 3 matris örneğinde rank 1’dir; bu da yalnızca bir lineer bağımsız satır ve yalnızca bir lineer bağımsız sütun olduğu anlamına gelir.
Çok basit bir ifadeyle, LoRA, model eğitim sürecini son derece verimli ve hızlı kılmak için daha düşük ranklı matrisler kavramından yararlanır.
Büyük modellerin çok sayıda parametresi vardır. Örneğin GPT-3’ün 175 milyar parametresi bulunur. Bu parametreler, matrislerde saklanan sayılardır. Bunları saklamak çok fazla depolama gerektirir.
Tam ince ayar, tüm parametrelerin eğitileceği anlamına gelir ve bu da GPT gibi bir model boyutu için milyonlarca dolara varabilen olağanüstü miktarda hesaplama kaynağı gerektirir.
Geleneksel ince ayarın tüm modeli ayarlamayı gerektirmesinin aksine, LoRA, daha küçük bir parametre alt kümesini (daha düşük ranklı matrisleri) değiştirmeye odaklanır; böylece hesaplama ve bellek yükünü azaltır.
LoRA, büyük modellerin doğası gereği düşük boyutlu bir yapıya sahip olduğu anlayışı üzerine kuruludur. Düşük-ranklı matrislerden yararlanarak, bu modelleri etkili biçimde uyarlar. Bu yöntem, anlamlı model değişimlerinin daha az parametreyle temsil edilebileceği temel fikrine odaklanır ve uyarlama sürecini daha verimli kılar.
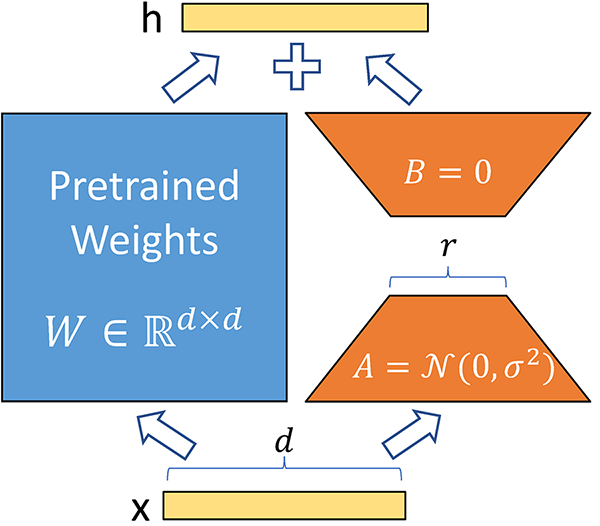
Kaynak: LLM’lerin İnce Ayarı: LoRA mı Tam Parametre mi? Llama 2 ile Derinlemesine Analiz
Önce, büyük ağırlık matrislerini, yukarıda açıklandığı gibi daha düşük ranklı matris tekniğini kullanarak daha küçük matrislere ayırırız. Bu, eğitilebilir parametre sayısını radikal biçimde azaltır. GPT-3 gibi bir model için eğitilebilir parametreler 10.000 kat düşer. Yani 175 milyar parametreyi eğitmek yerine, LoRA uygularsanız yalnızca 17,5 milyon eğitilebilir parametreniz olur.
Önceden eğitilmiş bir modelin hiçbir parametresini değiştirmeyiz. Bunun yerine yalnızca daha düşük ranklı matrisleri eğitiriz; parametreler az olduğu için bu süreç nispeten çok hızlı gerçekleşir.
Ağırlıklar toplanabilirdir. Yani çıkarım sırasında, daha düşük ranklı matrislerin ağırlıklarını, ek gecikme olmaksızın önceden eğitilmiş ağırlıklara ekleriz. Daha düşük ranklı matrisler de çok küçük boyuttadır; bu da onları farklı görevler ve farklı kullanıcılar için yüklemeyi ve kaldırmayı çok kolay kılar.
LoRA’yı ince ayar için kullanmanın çeşitli avantajları vardır:
LoRA, hesaplama yükünü azaltarak modellerin daha hızlı uyarlanmasını sağlar. Daha az eğitilebilir parametre gerektirdiğinden, büyük modellerin daha az güçlü donanımlarda ince ayarını mümkün kılar.
Parametre sayısı azalmış olmasına rağmen, LoRA orijinal modelin kalitesini ve çıkarım hızını korur.
LoRA, model checkpointlerinin boyutunu dramatik biçimde küçültür. Örneğin GPT-3’te checkpoint boyutu 1 TB’dan yalnızca 25 MB’a düşürülmüştür.
LoRA, çıkarım sırasında ek bir gecikme getirmez. Eğitimde düşük-ranklı matrisler kullanılırken, çıkarım için orijinal parametrelerle birleştirilir ve yavaşlama olmaz. Bu da çalışma zamanında ek çıkarım gecikmesi olmadan hızlı model değiştirmeyi mümkün kılar.
LoRA, matris çarpımı kullanan herhangi bir modele (örneğin destek vektör makineleri) uygulanabilir; bu da onu birçok başka kullanım senaryosunda geniş biçimde uygulanabilir bir teknik hâline getirir. Nitekim LoRA, büyük görsel modellerde stil kazandırmak için Stable Diffusion modellerinde yaygın olarak kullanılır.
LoRA tekniği, Stable Diffusion gibi görsel modellerde de yaygın biçimde benimsenmiştir.
Fikir, dil modelleriyle neredeyse aynıdır. Stable Diffusion gibi büyük modelleri tamamen ince ayar yapmak yerine, yalnızca küçük veri setlerinde daha düşük ranklı matrisleri eğitiriz.
Dil modelleri söz konusu olduğunda amaç alan özgüllüğüdür. Görsel modellerde ise en bariz kullanım örneği, görsel üretiminde bir stili veya tutarlı bir karakteri benimsemektir.
Bu daha düşük ranklı matrislere adaptör denir; boyutları çok küçüktür ve internette binlercesi bulunur. Bunları indirip temel Stable Diffusion modelinizin üzerine ekleyerek stile özgü görüntüler üretebilirsiniz.
LoRA’lı Stable Diffusion modellerinin yaygın kullanımları şunlardır:
Birden fazla LoRA’yı birleştirerek birden çok uzmanlaşmayı yansıtan çıktılar elde edebilirsiniz.
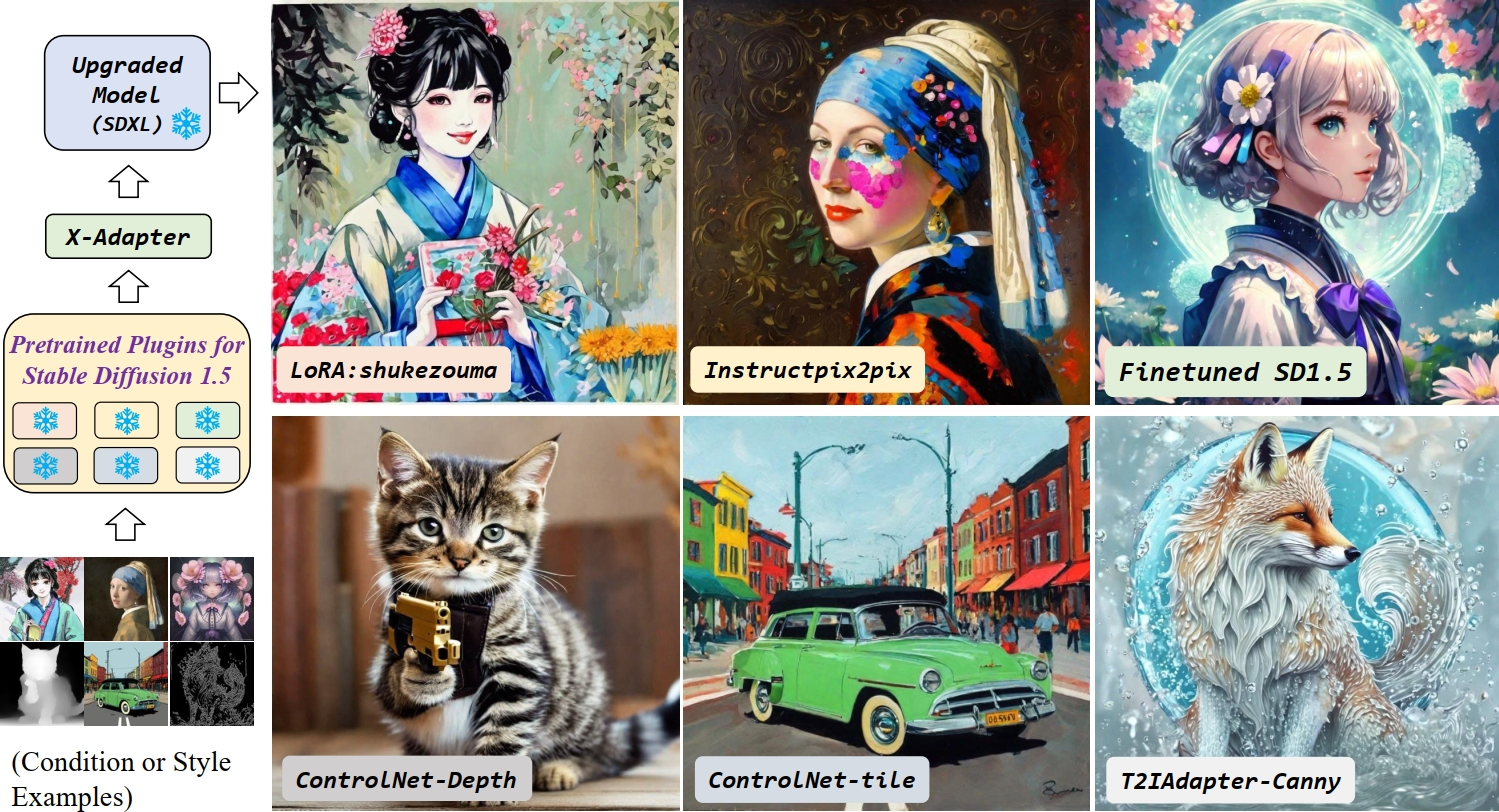
Stable Diffusion Modelleri için farklı adaptörler (Görsel Kaynağı)
Kişisel fotoğraflar üzerinde Stable Diffusion XL’ı başarıyla ince ayar yapmayı öğrenmek isterseniz, Datacamp’teki DreamBooth ve LoRA ile Stable Diffusion XL İnce Ayarı bloguna göz atın.
Prefix tuning, "önekler" olarak adlandırılan sürekli vektörlerin optimize edilerek her Transformer katmanının girişine eklendiği hafif bir yöntemdir. Model, yalnızca bu vektörlere odaklanarak öneği çıkarılmış bir biçimde eğitilir.
LoRA ve prefix tuning, PEFT (Parametre Verimli İnce Ayar) çerçevesi içinde birleştirilebilir:
LoRA’yı uygulamak için Microsoft’un Loralib kütüphanesini kullanabilirsiniz. Kütüphaneyi kurmak için:
pip install loralib
Sinir ağınızı normalde eğitme biçiminiz, LoRA’yı benimsemek için çok fazla değişmez.
# ===== Before =====
# layer = nn.Linear(in_features, out_features)

# ===== After ======
import loralib as lora
# Add a pair of low-rank adaptation matrices with rank r=16
layer = lora.Linear(in_features, out_features, r=16)
Eğitim döngüsü başlamadan önce yalnızca şunu eklemeniz yeterlidir:
import loralib as lora

model = YourNeuralNetwork()

# This sets requires_grad to False for all parameters
lora.mark_only_lora_as_trainable(model)

# Training loop
for batch in dataloader:
   ...
Bir checkpoint kaydederken, yalnızca LoRA parametrelerini içeren bir state_dic oluşturabilirsiniz.
# ===== Before =====
# torch.save(model.state_dict(), checkpoint_path)

# ===== After =====
torch.save(lora.lora_state_dict(model), checkpoint_path)
Sinir Ağlarını yeterince iyi anlamıyorsanız endişelenmeyin. PyTorch kullanarak büyük dil modellerini eğitme sürecini kurulumdan nihai uygulamaya kadar öğrenmek için PyTorch ile Bir LLM Nasıl Eğitilir bloguna göz atın.
Katkı: Kod örneği Microsoft/LoRA GitHub deposundan yeniden üretilmiştir.
LoRA, büyük modellerin boyutu ve karmaşıklığının doğurduğu ciddi zorlukları ele almak için vazgeçilmez bir teknik olarak öne çıkıyor.
Daha düşük ranklı matrislerden yararlanan LoRA, eğitilebilir parametreleri ve GPU bellek gereksinimlerini önemli ölçüde azaltarak, daha hızlı eğitim ve bellek verimliliği sağlayan, model uyarlamasına daha verimli ve maliyet etkin bir yaklaşım sunar.
LoRA’nın uygulama alanı, dil modellerinin ötesine uzanır; görüntü üretiminde stil uzmanlaşması ve karakter tutarlılığı sağladığı Stable Diffusion gibi görsel modellerde de fayda sunar.
Merak ediyor ve bu teknolojilerle neler inşa edebileceğinizi daha fazla öğrenmek istiyorsanız, Üretken Yapay Zekâ Modelleriyle Geliştirebileceğiniz 5 Proje rehberimize göz atın.
Yapay Zekâ Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




