
Kurs
Konzeptuelle Einführung in generative KI
2 Std.
117.2K
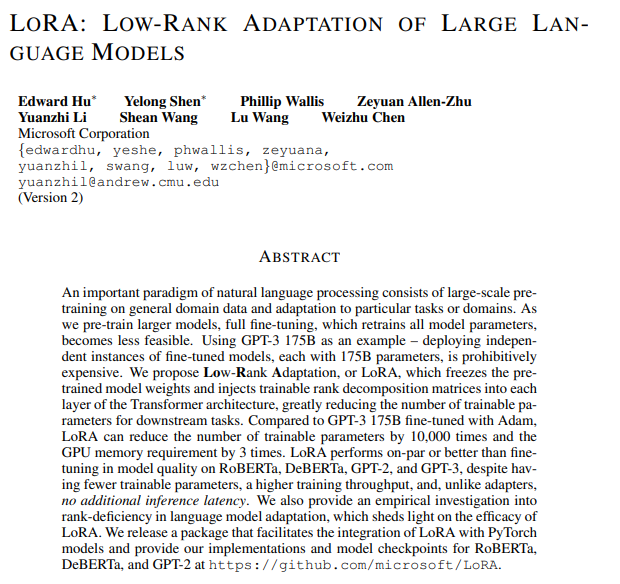
LoRA: Low-Rank Adaptation für Large Language Models
Mit der Einführung von Large Language Models (LLMs) wie GPT, LLaMa, Claude 2 und anderen hat das Feld des maschinellen Lernens und der Verarbeitung natürlicher Sprache (NLP) einen bemerkenswerten Sprung nach vorn gemacht. Diese Modelle zeigen außergewöhnliche Fähigkeiten in Anwendungen von Textgenerierung bis Sprachverständnis.
Die praktische Nutzung und das Finetuning dieser Modelle bringt jedoch erhebliche Herausforderungen mit sich – vor allem wegen ihrer Größe und Komplexität.
Genau hier setzt Low-Rank Adaptation (LoRA) an und bietet eine wirksame Lösung.
Ziel dieses Tutorials ist es, ein theoretisches und praktisches Verständnis dafür aufzubauen, was LoRA ist und wie du davon profitieren kannst.
Die Entstehung von LoRA reicht ins frühe Jahr 2021 zurück, kurz nach der Veröffentlichung von GPT-3. Microsoft stand gemeinsam mit OpenAI vor der Aufgabe, große Modelle wie GPT-3 wirtschaftlich nutzbar zu machen.
Es zeigte sich, dass One-Shot-Prompting allein für den produktiven Einsatz nicht ausreicht – insbesondere bei komplexen Aufgaben wie der Übersetzung von natürlicher Sprache in Code. Daher wurden Finetuning-Methoden erforscht, die sowohl kosteneffizient als auch performant sind.
Die Erfindung von LoRA entsprang dem Bedarf, große Sprachmodelle schnell, effizient und kostengünstig feinzujustieren – für Domainspezifik, effizientes Taskswitching oder sogar Nutzerswitching zur Laufzeit.
Das LoRA-Research-Paper wurde im Oktober 2021 von einem Forschungsteam bei Microsoft veröffentlicht.
Lass uns das Problem verstehen, bevor wir klären, was LoRA ist und wie es dieses löst.
Große Sprachmodelle wie GPT-4, Claude 2, LLaMA 70B und andere sind beeindruckend – aber sehr generisch und sehr groß. Um sie für spezifische Domänen wie Gesundheitswesen oder Banken oder für spezifische Aufgaben wie die Umwandlung von Text in Code einzusetzen, brauchen wir Finetuning.
Unter Finetuning versteht man das Training eines vortrainierten Modells auf einem kleineren, spezifischen Datensatz, um seine Leistung auf eine bestimmte Aufgabe oder Domäne zu spezialisieren. Je größer die Modelle werden (zum Beispiel hat GPT-3 175 Milliarden Parameter), desto weniger praktikabel wird Full-Finetuning – also das erneute Trainieren aller Modellparameter – wegen Zeit-, Kosten- und Ressourcenaufwand.
LoRA ist eine Technik zum Finetuning großer Modelle.
Auf hoher Ebene funktioniert LoRA so:
Das ursprüngliche Modell bleibt unverändert. Stattdessen werden in jede Schicht kleine, veränderbare Bausteine eingefügt. Dadurch sinkt die Zahl der trainierbaren Parameter drastisch und der GPU-Speicherbedarf im Training wird reduziert – ein weiterer großer Engpass beim Finetuning oder Training großer Modelle.
Beispielsweise erfordert Full-Finetuning von GPT-3 das Training von 175 Milliarden Parametern. Mit LoRA wird die Zahl der trainierbaren Parameter für GPT-3 grob um den Faktor 10.000 reduziert, und der GPU-Speicherbedarf sinkt um das Dreifache.
Im Kern löst LoRA diese Probleme:
Bevor wir ins Detail von LoRA gehen, lass uns das Konzept von Matrizen niedrigen Rangs klären.
Matrizen niedrigen Rangs sind ein Begriff aus der linearen Algebra. Vereinfacht gesagt misst der Rang einer Matrix den „Informationsgehalt“ bzw. die „Dimensionalität“ der durch die Matrix repräsentierten Daten. Im Überblick:
Beispiel:
Betrachte eine 3 x 3 Matrix:
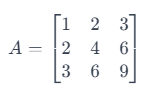
Hier ist die zweite Zeile lediglich die erste Zeile mal 2, und die dritte Zeile ist die erste Zeile mal 3. Die Zeilen sind also nicht linear unabhängig. Der Rang dieser Matrix ist 1 (nur die erste Zeile ist unabhängig) und damit niedriger als der maximale Rang 3 einer 3x3-Matrix. Es handelt sich also um eine Matrix niedrigen Rangs.
Matrizen niedrigen Rangs sind in vielen Anwendungen wichtig, etwa bei der Datenkompression: Ein niedrigerer Rang ermöglicht Kompression bei möglichst geringem Informationsverlust.
Der Rang bezieht sich gleichermaßen auf Zeilen und Spalten. Entscheidend ist: Der Rang ist identisch, egal ob du ihn über die Zeilen- oder über die Spaltenräume bestimmst. Das folgt aus einem grundlegenden Satz der linearen Algebra, dem Rang-Nullitätssatz.
Vereinfacht gesagt besagt er, dass die Dimension des Zeilenraums (aufgespannt von den Zeilen) der Dimension des Spaltenraums (aufgespannt von den Spalten) entspricht. Diese gemeinsame Dimension ist der Rang der Matrix.
Im obigen 3x3-Beispiel ist der Rang 1, das heißt: genau eine linear unabhängige Zeile und genau eine linear unabhängige Spalte.
Ganz einfach gesagt nutzt LoRA das Konzept von Matrizen niedrigen Rangs, um das Modelltraining extrem effizient und schnell zu machen.
Große Modelle besitzen sehr viele Parameter. GPT-3 hat zum Beispiel 175 Milliarden davon. Diese Parameter sind Zahlen, die in Matrizen gespeichert werden – und das benötigt enorme Speicherkapazität.
Full-Finetuning bedeutet, dass alle Parameter trainiert werden. Das erfordert außergewöhnlich viele Rechenressourcen und kann bei Modellen wie GPT schnell Millionenbeträge kosten.
Anders als beim traditionellen Finetuning, das das gesamte Modell anpasst, konzentriert sich LoRA auf die Veränderung einer kleineren Teilmenge an Parametern (Matrizen niedrigen Rangs). So sinken Rechenaufwand und Speicherbedarf deutlich.
LoRA basiert auf der Erkenntnis, dass große Modelle von Natur aus eine niederdimensionale Struktur aufweisen. Durch die Nutzung von Matrizen niedrigen Rangs passt LoRA diese Modelle wirkungsvoll an. Die Grundidee: Wesentliche Modelländerungen lassen sich mit deutlich weniger Parametern abbilden – dadurch wird die Adaption effizienter.
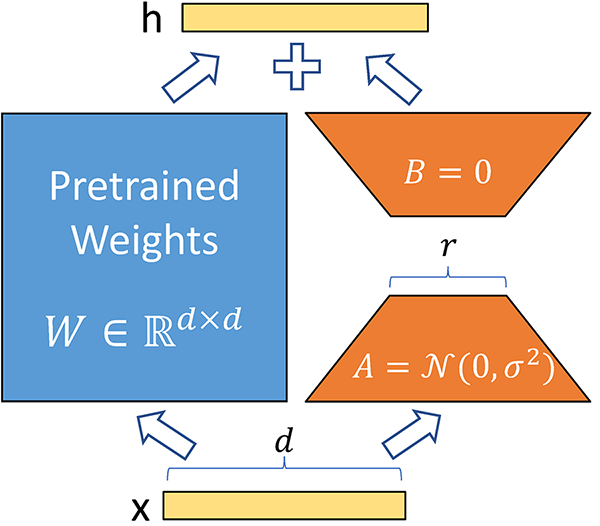
Quelle: Fine-Tuning LLMs: LoRA or Full-Parameter? An in-depth Analysis with Llama 2
Zuerst zerlegen wir die großen Gewichtsmatrizen mithilfe der Technik der Matrizen niedrigen Rangs in kleinere Matrizen. So sinkt die Zahl der trainierbaren Parameter drastisch. Bei einem Modell wie GPT-3 schrumpfen die trainierbaren Parameter um den Faktor 10.000. Statt 175 Milliarden Parametern trainierst du mit LoRA nur 17,5 Millionen.
Die Parameter des vortrainierten Modells bleiben unverändert. Trainiert werden nur die Matrizen niedrigen Rangs – und das geht wegen der geringeren Parameterzahl vergleichsweise schnell.
Die Gewichte sind additiv. Für die Inferenz addieren wir einfach die Gewichte der Matrizen niedrigen Rangs auf die vortrainierten Gewichte – ohne zusätzliche Latenz. Da diese Matrizen sehr klein sind, lassen sie sich zur Laufzeit leicht für unterschiedliche Aufgaben oder Nutzer laden und entladen.
LoRA bietet beim Finetuning mehrere Vorteile:
LoRA reduziert die Rechenlast und ermöglicht eine schnellere Adaption von Modellen. Mit weniger trainierbaren Parametern wird Finetuning großer Modelle auch auf schwächerer Hardware machbar.
Trotz weniger Parameter bleiben die Qualität des ursprünglichen Modells und die Inferenzgeschwindigkeit erhalten.
LoRA verkleinert Modell-Checkpoints drastisch. Bei GPT-3 schrumpfte die Checkpoint-Größe beispielsweise von 1 TB auf nur 25 MB.
LoRA verursacht während der Inferenz keine zusätzliche Latenz. Die Matrizen niedrigen Rangs werden im Training genutzt und für die Inferenz mit den ursprünglichen Parametern zusammengeführt. So ist auch schnelles Modellswitching zur Laufzeit ohne Zusatzlatenz möglich.
LoRA lässt sich auf jedes Modell anwenden, das Matrixmultiplikation nutzt (zum Beispiel Support Vector Machines) und ist damit breit einsetzbar. In der Praxis wird LoRA auch in Stable-Diffusion-Modellen genutzt, um Stile in großen Bildmodellen zu integrieren.
Die LoRA-Technik ist auch in Bildmodellen wie Stable Diffusion weit verbreitet.
Die Grundidee ist die gleiche wie bei Sprachmodellen: Anstatt ein großes Modell wie Stable Diffusion komplett feinzujustieren, trainieren wir nur Matrizen niedrigen Rangs auf kleinen Datensätzen.
Bei Sprachmodellen geht es meist um Domainspezifik. Bei Bildmodellen ist der naheliegendste Anwendungsfall die Übernahme eines Stils oder eines konsistenten Charakters bei der Bildgenerierung.
Diese Matrizen niedrigen Rangs werden Adapter genannt. Sie sind sehr klein, und es gibt Tausende davon im Netz, die du herunterladen, auf dein Basis-Stable-Diffusion-Modell aufsetzen und damit stilgetreue Bilder generieren kannst.
Häufige Einsätze von LoRA in Stable-Diffusion-Modellen sind:
Du kannst mehrere LoRAs kombinieren, um Ausgaben mit mehreren Spezialisierungen zu erhalten.
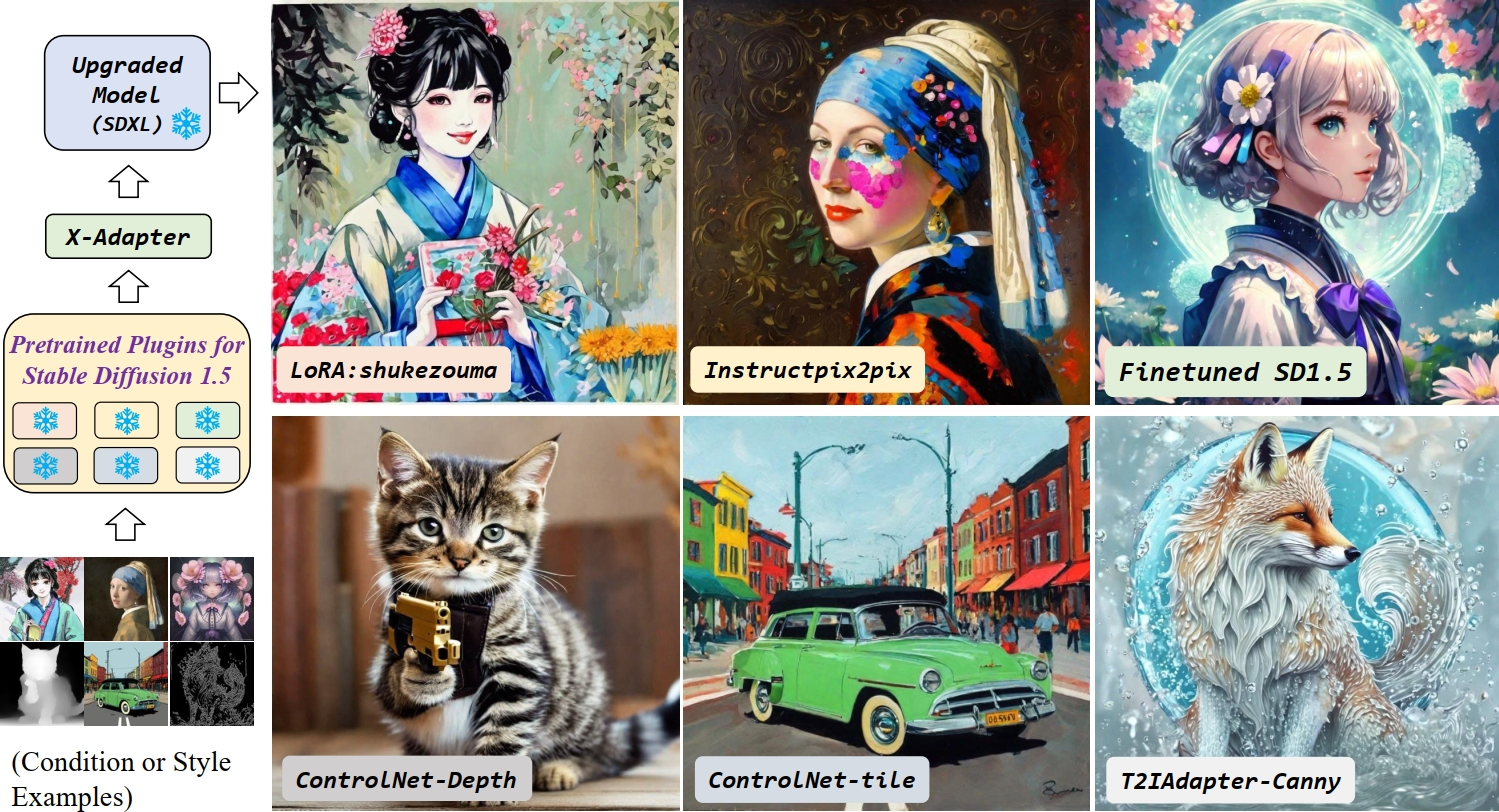
Verschiedene Adapter für Stable-Diffusion-Modelle (Bildquelle)
Wenn du lernen willst, wie du Stable Diffusion XL erfolgreich mit eigenen Fotos feinabstimmst, lies den Blogbeitrag Fine-tuning Stable Diffusion XL with DreamBooth and LoRA auf DataCamp.
Prefix-Tuning ist eine leichtgewichtige Methode, bei der kontinuierliche Vektoren, sogenannte „Präfixe“, optimiert und an den Eingang jeder Transformer-Schicht angehängt werden. Das Modell wird präfix-reduziert trainiert und fokussiert sich dabei nur auf diese Vektoren.
LoRA und Prefix-Tuning lassen sich im PEFT-Framework (Parameter Efficient Fine-Tuning) kombinieren:
Zur Implementierung von LoRA kannst du die Loralib-Bibliothek von Microsoft verwenden. Installation:
pip install loralib
Die Art, wie du dein neuronales Netz trainierst, ändert sich für den Einsatz von LoRA kaum.
# ===== Before =====
# layer = nn.Linear(in_features, out_features)

# ===== After ======
import loralib as lora
# Add a pair of low-rank adaptation matrices with rank r=16
layer = lora.Linear(in_features, out_features, r=16)
Vor Beginn der Trainingsschleife fügst du einfach Folgendes hinzu:
import loralib as lora

model = YourNeuralNetwork()

# This sets requires_grad to False for all parameters
lora.mark_only_lora_as_trainable(model)

# Training loop
for batch in dataloader:
   ...
Beim Speichern eines Checkpoints kannst du ein state_dic erzeugen, das nur LoRA-Parameter enthält.
# ===== Before =====
# torch.save(model.state_dict(), checkpoint_path)

# ===== After =====
torch.save(lora.lora_state_dict(model), checkpoint_path)
Wenn dir neuronale Netze noch nicht ganz vertraut sind, kein Problem. Schau dir den Beitrag How to Train a LLM with PyTorch an und lerne, wie du große Sprachmodelle mit PyTorch vom Setup bis zur Implementierung trainierst.
Credits: Das Codebeispiel wurde aus dem Microsoft/LoRA GitHub übernommen.
LoRA ist eine unverzichtbare Technik, um die erheblichen Herausforderungen durch Größe und Komplexität großer Modelle zu adressieren.
Dank Matrizen niedrigen Rangs ermöglicht LoRA eine effizientere und kostengünstigere Modelladaption, reduziert die Zahl der trainierbaren Parameter und den GPU-Speicherbedarf deutlich und sorgt so für schnelleres Training und bessere Speichernutzung.
Der Einsatz von LoRA geht über Sprachmodelle hinaus – auch in Bildmodellen wie Stable Diffusion sorgt es für Stilspezialisierung und konsistente Charaktere bei der Bildgenerierung.
Wenn du neugierig bist, was sich mit diesen Technologien bauen lässt, wirf einen Blick in unseren Guide 5 Projects You Can Build with Generative AI Models.
Starte heute deine KI-Reise!
Kurs
Kurs
Kurs