
Khóa học
Các khái niệm về Generative AI
2 giờ
121.1K
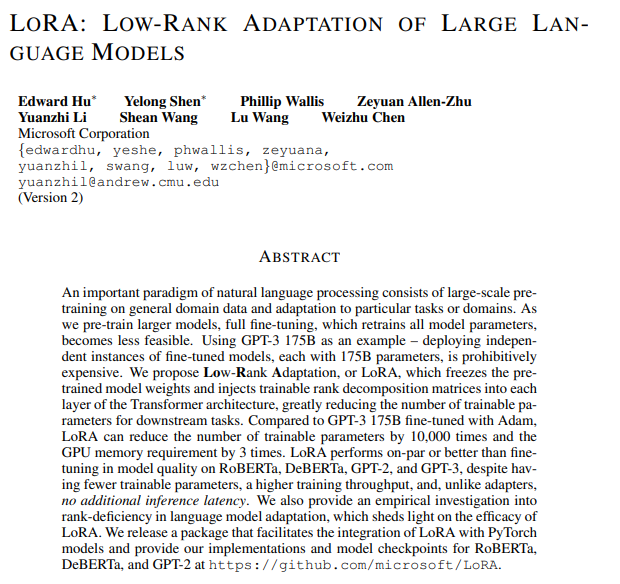
LoRA: Thích ứng hạng thấp cho các Mô hình Ngôn ngữ Lớn
Lĩnh vực học máy và xử lý ngôn ngữ tự nhiên (NLP) đã chứng kiến một bước tiến vượt bậc với sự ra đời của Mô hình Ngôn ngữ Lớn (LLM) như GPT, LLaMa, Claude 2, v.v. Các mô hình này thể hiện năng lực vượt trội ở nhiều ứng dụng, từ sinh văn bản đến hiểu ngôn ngữ.
Tuy nhiên, việc triển khai thực tế và fine-tune các mô hình này đi kèm những thách thức đáng kể, chủ yếu do kích thước và độ phức tạp của chúng.
Đây chính là lúc Low-Rank Adaptation (LoRA) phát huy tác dụng, mang đến một giải pháp hiệu quả cho những thách thức này.
Mục tiêu của hướng dẫn này là xây dựng hiểu biết lý thuyết và thực tiễn về LoRA là gì và bạn có thể hưởng lợi từ nó như thế nào.
Sự ra đời của LoRA bắt đầu từ đầu năm 2021, sau khi GPT-3 được phát hành. Microsoft, hợp tác với OpenAI, đối mặt với thách thức làm cho các mô hình lớn như GPT-3 khả thi về mặt thương mại.
Họ phát hiện rằng chỉ dùng one-shot prompting là không đủ để đạt hiệu năng tối ưu trong sản xuất, đặc biệt với các tác vụ phức tạp như dịch ngôn ngữ tự nhiên sang mã. Điều này dẫn đến việc khám phá các phương pháp fine-tune vừa tiết kiệm chi phí vừa hiệu quả.
LoRA được phát minh dựa trên nhu cầu sản phẩm: cho phép fine-tune các mô hình ngôn ngữ lớn một cách nhanh chóng, hiệu quả và tiết kiệm, nhằm hỗ trợ đặc thù miền, chuyển đổi tác vụ hiệu quả hoặc chuyển đổi người dùng ở thời điểm chạy.
Bài báo nghiên cứu về LoRA được xuất bản vào tháng 10 năm 2021 bởi nhóm nghiên cứu từ Microsoft.
Hãy hiểu vấn đề trước khi tìm hiểu LoRA là gì và nó giải quyết vấn đề ra sao.
Các mô hình ngôn ngữ lớn như GPT-4, Claude 2, LLaMA 70b, v.v. rất mạnh, nhưng chúng rất tổng quát và rất lớn. Để áp dụng các mô hình này cho những lĩnh vực cụ thể như y tế hay ngân hàng hoặc cho các tác vụ cụ thể như chuyển văn bản thành mã, chúng ta cần fine-tune.
Fine-tune là quá trình huấn luyện một mô hình đã được tiền huấn luyện trên một tập dữ liệu nhỏ, chuyên biệt để tối ưu hiệu năng cho một tác vụ hoặc miền cụ thể. Khi mô hình ngày càng lớn (ví dụ, GPT-3 có 175 tỷ tham số), việc fine-tune toàn bộ, tức huấn luyện lại tất cả tham số, trở nên kém khả thi do thời gian, chi phí và tài nguyên.
LoRA là một kỹ thuật dùng để fine-tune các mô hình lớn.
Ở mức khái quát, LoRA hoạt động như sau:
Nó giữ nguyên mô hình gốc và bổ sung những phần nhỏ, có thể thay đổi vào mỗi tầng của mô hình. Điều này làm giảm đáng kể số tham số có thể huấn luyện và giảm nhu cầu bộ nhớ GPU cho quá trình huấn luyện, vốn là một thách thức lớn khác khi fine-tune hoặc huấn luyện các mô hình lớn.
Ví dụ, fine-tune toàn phần mô hình GPT-3 sẽ yêu cầu huấn luyện 175 tỷ tham số. Dùng LoRA, số tham số có thể huấn luyện cho GPT-3 giảm xấp xỉ 10.000 lần và nhu cầu bộ nhớ GPU giảm ba lần.
Tóm lại, LoRA giải quyết các vấn đề sau:
Trước khi đi vào chi tiết LoRA, hãy hiểu khái niệm ma trận hạng thấp.
Ma trận hạng thấp là một khái niệm trong toán học, cụ thể là đại số tuyến tính. Nói đơn giản, hạng của một ma trận là thước đo "hàm lượng thông tin" hoặc "số chiều" của dữ liệu được biểu diễn bởi ma trận. Cùng phân tích:
Ví dụ:
Xét một ma trận 3 x 3:
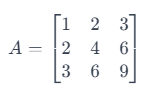
Ở đây, hàng thứ hai chỉ là hàng thứ nhất nhân 2, và hàng thứ ba là hàng thứ nhất nhân 3. Điều này có nghĩa các hàng không độc lập tuyến tính. Hạng của ma trận này là 1 (vì chỉ hàng đầu tiên là độc lập), thấp hơn hạng tối đa của ma trận 3x3 là 3. Vậy đây là một ma trận hạng thấp.
Ma trận hạng thấp quan trọng trong nhiều ứng dụng như nén dữ liệu, nơi giảm hạng ma trận giúp nén dữ liệu trong khi vẫn giữ được tối đa thông tin.
Hạng của ma trận áp dụng như nhau cho cả hàng và cột. Điểm mấu chốt cần hiểu là hạng của một ma trận là như nhau dù bạn tính theo hàng hay theo cột. Điều này là do một tính chất cơ bản trong đại số tuyến tính gọi là định lý Hạng - Không gian Null.
Nói dễ hiểu, định lý cho biết số chiều của không gian hàng (không gian do các hàng sinh ra) và không gian cột (không gian do các cột sinh ra) của một ma trận là bằng nhau. Số chiều chung này chính là hạng của ma trận.
Vì vậy, trong ví dụ ma trận 3 x 3 ở trên, hạng là 1, tức chỉ có một hàng độc lập tuyến tính và chỉ có một cột độc lập tuyến tính.
Nói rất đơn giản, LoRA tận dụng khái niệm ma trận hạng thấp để khiến quá trình huấn luyện mô hình cực kỳ hiệu quả và nhanh chóng.
Các mô hình lớn có rất nhiều tham số. Ví dụ, GPT-3 có 175 tỷ tham số. Các tham số này chỉ là những con số được lưu trong các ma trận. Lưu trữ chúng đòi hỏi dung lượng rất lớn.
Fine-tune toàn phần nghĩa là tất cả tham số sẽ được huấn luyện, và điều này sẽ đòi hỏi lượng tài nguyên tính toán khổng lồ, dễ dàng tốn đến hàng triệu đô la với mô hình cỡ như GPT.
Khác với cách fine-tune truyền thống cần điều chỉnh toàn bộ mô hình, LoRA tập trung sửa đổi một tập con nhỏ các tham số (các ma trận hạng thấp), từ đó giảm chi phí tính toán và bộ nhớ.
LoRA được xây dựng trên hiểu biết rằng các mô hình lớn vốn dĩ có cấu trúc chiều thấp. Bằng cách tận dụng các ma trận hạng thấp, LoRA thích ứng các mô hình này một cách hiệu quả. Phương pháp này dựa trên ý tưởng cốt lõi rằng các thay đổi đáng kể của mô hình có thể được biểu diễn bằng ít tham số hơn, nhờ đó quá trình thích ứng trở nên hiệu quả hơn.
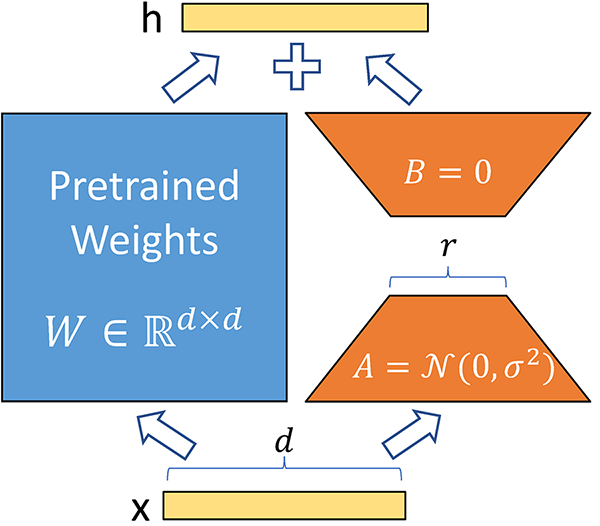
Nguồn: Fine-Tuning LLMs: LoRA or Full-Parameter? Phân tích chuyên sâu với Llama 2
Đầu tiên, chúng ta phân rã các ma trận trọng số lớn thành các ma trận nhỏ hơn bằng kỹ thuật ma trận hạng thấp như đã giải thích ở trên. Điều này cắt giảm mạnh số tham số có thể huấn luyện. Với một mô hình như GPT-3, tham số có thể huấn luyện giảm 10.000 lần. Tức là thay vì huấn luyện 175 tỷ tham số, nếu áp dụng LoRA, bạn chỉ có 17,5 triệu tham số có thể huấn luyện.
Chúng ta không thay đổi bất kỳ tham số nào của mô hình đã tiền huấn luyện. Thay vào đó, chỉ huấn luyện các ma trận hạng thấp, vốn diễn ra rất nhanh do ít tham số.
Trọng số là dạng cộng thêm. Nghĩa là khi suy luận, chúng ta chỉ cần cộng trọng số của các ma trận hạng thấp vào trọng số đã tiền huấn luyện mà không phát sinh độ trễ bổ sung. Các ma trận hạng thấp cũng rất nhỏ nên rất dễ nạp và dỡ cho các tác vụ và người dùng khác nhau.
Có một số ưu điểm khi dùng LoRA để fine-tune:
LoRA giảm gánh nặng tính toán, cho phép mô hình thích ứng nhanh hơn. Nhờ cần ít tham số có thể huấn luyện hơn, LoRA giúp việc fine-tune các mô hình lớn trên phần cứng kém mạnh mẽ trở nên khả thi.
Dù số lượng tham số giảm, LoRA vẫn duy trì chất lượng mô hình gốc và tốc độ suy luận.
LoRA cắt giảm mạnh kích thước checkpoint của mô hình. Chẳng hạn, với GPT-3, kích thước checkpoint giảm từ 1 TB xuống chỉ còn 25 MB.
LoRA không tạo thêm độ trễ trong quá trình suy luận. Trong khi ma trận hạng thấp được dùng khi huấn luyện, chúng được trộn vào tham số gốc khi suy luận, đảm bảo không chậm đi. Điều này cho phép chuyển đổi mô hình nhanh ở thời điểm chạy mà không thêm độ trễ suy luận.
LoRA có thể áp dụng cho bất kỳ mô hình nào sử dụng phép nhân ma trận (như máy vector hỗ trợ), khiến nó trở thành kỹ thuật có thể áp dụng rộng rãi ở nhiều trường hợp khác. Thực tế, LoRA được dùng rộng rãi trong các mô hình Stable Diffusion để đưa phong cách vào các mô hình ảnh lớn.
Kỹ thuật LoRA cũng được áp dụng rộng rãi trong các mô hình ảnh như Stable Diffusion.
Ý tưởng hầu như giống với mô hình ngôn ngữ. Thay vì fine-tune toàn phần các mô hình lớn như Stable Diffusion, chúng ta chỉ huấn luyện các ma trận hạng thấp trên tập dữ liệu nhỏ.
Với mô hình ngôn ngữ, mục tiêu là đặc thù miền. Với mô hình ảnh, trường hợp sử dụng rõ ràng nhất là áp dụng một phong cách hoặc một nhân vật nhất quán khi sinh ảnh.
Các ma trận hạng thấp này được gọi là adapter; chúng rất nhỏ, và có hàng nghìn adapter trên internet mà bạn có thể tải về, đặt lên mô hình Stable Diffusion nền tảng của mình để sinh ảnh theo phong cách cụ thể.
Một số cách dùng phổ biến của các mô hình LoRA cho Stable Diffusion:
Bạn có thể kết hợp nhiều LoRA để tạo đầu ra phản ánh nhiều chuyên biệt khác nhau.
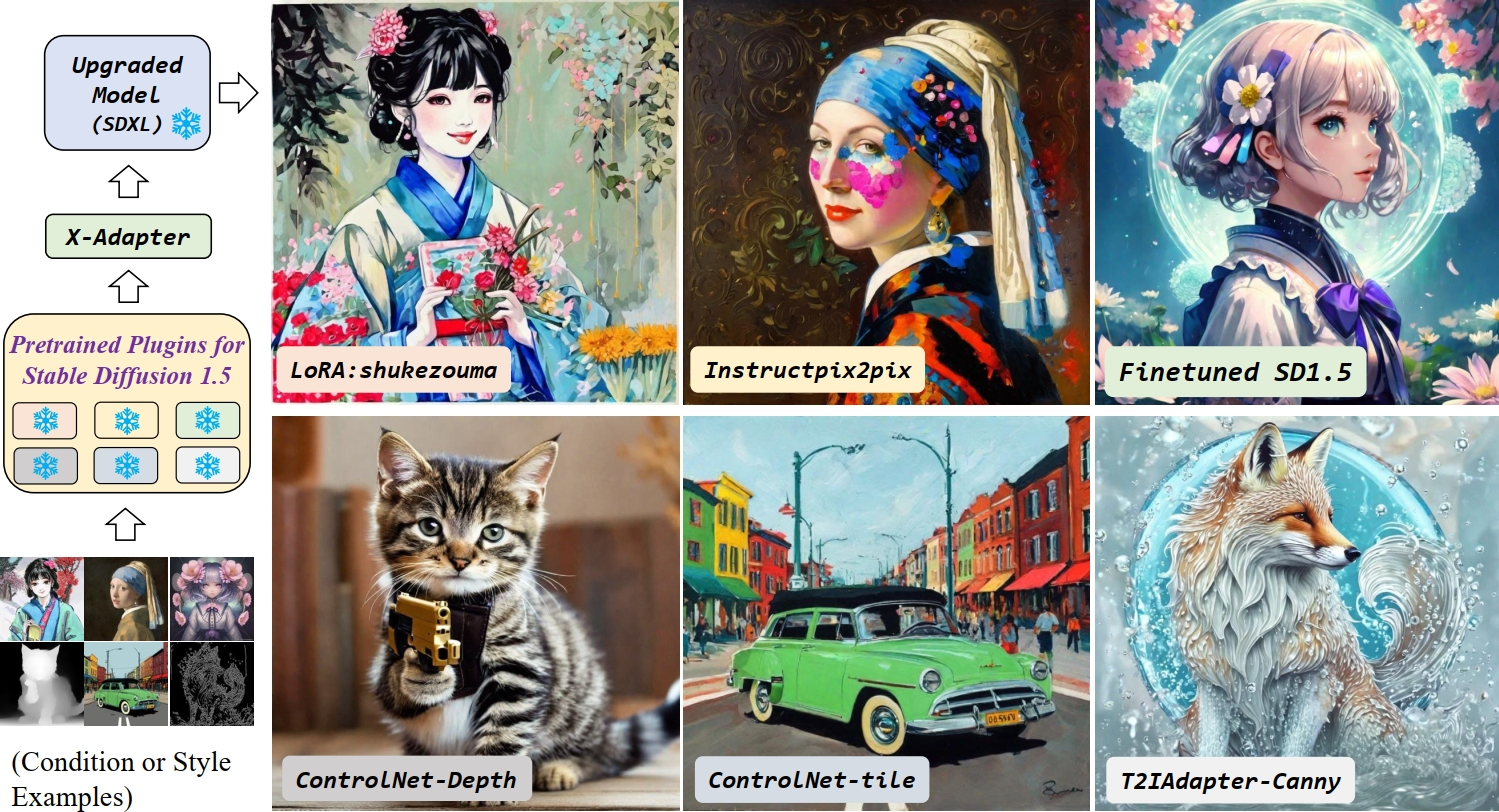
Các adapter khác nhau cho mô hình Stable Diffusion (Nguồn ảnh)
Nếu bạn muốn học cách fine-tune thành công Stable Diffusion XL trên ảnh cá nhân, hãy xem bài blog Fine-tune Stable Diffusion XL với DreamBooth và LoRA trên Datacamp.
Prefix tuning là một phương pháp gọn nhẹ, trong đó các vector liên tục gọi là "prefix" được tối ưu và thêm vào đầu vào của mỗi tầng Transformer. Mô hình được huấn luyện theo cách loại bỏ phần thân, chỉ tập trung vào các vector này.
LoRA và prefix tuning có thể được kết hợp trong khung PEFT (Parameter Efficient Fine-Tuning):
Để triển khai LoRA, bạn có thể dùng thư viện Loralib của Microsoft. Để cài đặt thư viện:
pip install loralib
Cách bạn huấn luyện mạng nơ-ron như thường lệ gần như không thay đổi khi áp dụng LoRA.
# ===== Before =====
# layer = nn.Linear(in_features, out_features)

# ===== After ======
import loralib as lora
# Add a pair of low-rank adaptation matrices with rank r=16
layer = lora.Linear(in_features, out_features, r=16)
Trước khi vòng lặp huấn luyện bắt đầu, bạn chỉ cần thêm:
import loralib as lora

model = YourNeuralNetwork()

# This sets requires_grad to False for all parameters
lora.mark_only_lora_as_trainable(model)

# Training loop
for batch in dataloader:
   ...
Khi lưu checkpoint, bạn có thể tạo một state_dic chỉ chứa các tham số của LoRA.
# ===== Before =====
# torch.save(model.state_dict(), checkpoint_path)

# ===== After =====
torch.save(lora.lora_state_dict(model), checkpoint_path)
Nếu bạn chưa hiểu rõ về Mạng Nơ-ron, đừng lo. Hãy xem bài blog Cách huấn luyện một LLM với PyTorch để nắm vững quy trình huấn luyện các mô hình ngôn ngữ lớn bằng PyTorch, từ thiết lập ban đầu đến triển khai cuối cùng.
Ghi công: Ví dụ mã được tái hiện từ Microsoft/LoRA trên GitHub.
LoRA nổi lên như một kỹ thuật không thể thiếu để giải quyết những thách thức lớn do kích thước và độ phức tạp của các mô hình lớn đặt ra.
Bằng cách tận dụng các ma trận hạng thấp, LoRA mang đến một cách tiếp cận thích ứng mô hình hiệu quả và tiết kiệm chi phí hơn, giảm đáng kể số tham số có thể huấn luyện và nhu cầu bộ nhớ GPU, từ đó cho phép huấn luyện nhanh hơn và hiệu quả bộ nhớ cao hơn.
Ứng dụng của LoRA vượt ra ngoài các mô hình ngôn ngữ, còn hữu ích với các mô hình ảnh như Stable Diffusion, nơi nó hỗ trợ chuyên biệt hóa phong cách và tính nhất quán của nhân vật trong sinh ảnh.
Nếu bạn tò mò và muốn tìm hiểu thêm về những gì có thể xây dựng với các công nghệ này, hãy xem hướng dẫn 5 dự án bạn có thể xây dựng với các mô hình AI sinh để biết thêm.
Bắt đầu hành trình AI của bạn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
