
Kursus
Pengantar LLM di Python
3 jam
36.5K
Model bahasa besar (LLM) sangat bergantung pada perkalian matriks (MatMul) untuk operasinya, yang menyebabkan kebutuhan komputasi dan memori puncak yang besar. Namun, dalam sebuah makalah terbaru, arketipe baru LLM tanpa MatMul muncul, menjanjikan kinerja sebanding dengan potensi pengurangan penggunaan sumber daya.
Dalam artikel ini, saya akan membandingkan LLM MatMul-free dengan padanannya yang klasik. Saya akan menilai kemampuan generatif dan konsumsi sumber daya di tiga ukuran model: 370M, 1,3B, dan 2,7B parameter. Analisis saya akan mencakup kecepatan dan konsumsi memori puncak model, menyoroti potensi keunggulan arsitektur MatMul-free dalam NLP modern.
Untuk mempelajari lebih lanjut tentang LLM MatMul-free, Anda dapat membaca artikel ini: MatMul-Free LLMs: Konsep Utama Dijelaskan.
Bagian ini membahas penyiapan yang saya gunakan untuk melakukan eksperimen.
Para penulis makalah tidak secara eksplisit menyebutkan model mana yang mereka bandingkan dengan model MatMul-free mereka. Mereka hanya menyatakan bahwa mereka “membandingkan dua varian LM MatMul-free kami dengan arsitektur Transformer tingkat lanjut yang direproduksi (Transformer++, berdasarkan Llama-2) di tiga ukuran model: 370M, 1,3B, dan 2,7B parameter.” Selain itu, semua model dilatih pada dataset SlimPajama.
Untuk memastikan perbandingan yang adil, idealnya menggunakan model open-source yang dilatih pada dataset yang sama. Namun, karena tidak tersedianya model seperti itu, artikel ini membandingkan konsumsi memori puncak dan kecepatan model yang tersedia dengan ukuran serupa dengan temuan yang disajikan dalam makalah.
Berikut model yang akan kita bandingkan:
Perlu dicatat bahwa LLM MatMul-free menggunakan bobot ternary dan aktivasi BF16, yang berdampak signifikan pada karakteristik memori dan kecepatan. Karena tidak ada model lain dalam set perbandingan kita yang menggunakan bobot ternary dan aktivasi BF16, fitur ini memberikan keunggulan unik bagi LLM MatMul-free dalam efisiensi memori dan kecepatan pemrosesan. Pembedaan ini akan krusial dalam analisis komparatif kita, menyoroti bagaimana inovasi tersebut berkontribusi terhadap kinerja keseluruhan model MatMul-free.
Untuk melakukan perbandingan, kita akan bekerja di lingkungan Google Colab dengan runtime GPU T4. Penyiapan ini menyediakan platform yang kuat namun mudah diakses untuk menjalankan dan mengevaluasi model bahasa besar.
Pustaka utama yang akan kita gunakan adalah pustaka transformers dari huggingface, karena semua model yang kita butuhkan tersedia di sana. Kita bisa menginstalnya dengan perintah berikut:
pip install transformersKita juga perlu menginstal pustaka matmulfreellm agar model MatMul-free kita dapat dijalankan. Pustaka ini bersifat open source dan tersedia di GitHub, kita bisa memasangnya dengan menjalankan:
pip install -U git+https://github.com/ridgerchu/matmulfreellmUntuk memantau penggunaan memori puncak kita akan menggunakan pytorch, yang dapat diinstal menggunakan berbagai perintah, bergantung pada sistem dan manajer paket Anda seperti dijelaskan di sini. Jika Anda bekerja di Google Colab, seharusnya sudah terpasang.
Berikut cara kita menjalankan eksperimen. Pertama, kita perlu mengimpor pustaka yang diperlukan:
import torch
import time
from transformers import AutoModelForCausalLM, AutoTokenizer
Kemudian, untuk setiap eksperimen, kita mendefinisikan nama model dalam sebuah daftar—contoh yang diberikan adalah untuk model dengan kisaran 370M parameter.
model_names = ["gpt2-medium", "facebook/opt-350m", "ridger/MMfreeLM-370M"]Selanjutnya, kita memuat model dan tokenizer ke dalam memori. Jika sistem Anda tidak memiliki kapasitas yang cukup, Anda dapat menjalankan eksperimen secara terpisah untuk setiap model. Di sini, kita memastikan menggunakan float presisi setengah dengan metode .half().
models = [AutoModelForCausalLM.from_pretrained(name).half().cuda() for name in model_names]
tokenizers = [AutoTokenizer.from_pretrained(name) for name in model_names]
Kita juga perlu menetapkan pad_token untuk setiap tokenizer:
for tokenizer in tokenizers:
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token
Untuk membuat semua pengamatan yang diperlukan, jalankan model dan dapatkan output—saya akan menggunakan fungsi measure_performance() berikut:
def measure_performance(model, tokenizer, prompt):
    inputs = tokenizer(prompt, return_tensors="pt", padding=True)
    input_ids = inputs.input_ids.cuda()
    attention_mask = inputs.attention_mask.cuda()
    torch.cuda.reset_peak_memory_stats()
    # Measure speed
    start_time = time.time()
    with torch.no_grad():
        outputs = model.generate(
            input_ids,
            attention_mask=attention_mask,
            max_length=128,
            pad_token_id=tokenizer.eos_token_id,
            repetition_penalty=1.1,
            no_repeat_ngram_size=2
        )
    end_time = time.time()
    # Measure memory after inference
    peak_memory = torch.cuda.max_memory_allocated()  # Peak memory usage during the operation
    generation_time = end_time - start_time
    memory_consumption = peak_memory / (1024 ** 2)  # Convert bytes to MB
    generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)

    return generation_time, memory_consumption, generated_text
Fungsi ini mengevaluasi kinerja model bahasa dengan mengukur kecepatan inferensi dan konsumsi memori puncak. Fungsi terlebih dahulu melakukan tokenisasi prompt masukan, memastikan attention mask dan padding yang tepat, serta memindahkan input ke GPU. Penggunaan memori dilacak dengan mereset lalu mencatat statistik memori puncak—kita mengonversinya ke dalam MB sebelum mengembalikan nilainya.
Menurut saya, penggunaan memori puncak adalah statistik paling penting karena itulah yang menyebabkan overflow. Fungsi juga mengukur kecepatan inferensi dengan mencatat waktu sebelum dan sesudah generasi teks (ini adalah cara standar untuk mengukur waktu eksekusi di Python).
Hyperparameter yang kita gunakan untuk generasi ditetapkan dalam metode .generate(). Kita menggunakan panjang maksimum 128 token dan menetapkan repetition penalty (ini dilakukan karena model MatMul-free terlihat menghasilkan respons yang sama berulang kali). Pada akhirnya, fungsi mengembalikan waktu, konsumsi memori puncak, dan teks yang dihasilkan.
Sekarang, kita dapat mendefinisikan prompt dan menjalankan eksperimen. Saya juga akan mengumpulkan data dan menjalankan model pada berbagai prompt untuk menghimpun data.
prompt = "What are the benefits of renewable energy?" #example prompt
results = {}
for name, model, tokenizer in zip(model_names, models, tokenizers):
	time_taken, memory_used, output = measure_performance(model, tokenizer,prompt)
	results[name] = {
	    "time_taken": time_taken,
	    "memory_used": memory_used,
	    "output": output
	}
	print(f"Model: {name}\nTime taken: {time_taken} seconds\nMemory used: {memory_used} MB\nOutput: {output}\n")
Keluaran tampil seperti ini:
Evaluating model: gpt2-medium
Prompt: What are the benefits of renewable energy?
Time taken: 3.17 seconds
Peak memory used: 3521.02 MB
Output: What are the benefits of renewable energy?
 The answer is that it's cheaper than fossil fuels.    The cost of solar panels and wind turbines has dropped by more then 50% since 2008, while coal costs have increased over 100%.   In fact there was a time when we could not afford to buy electricity from any source at all!    We were forced into buying our power through expensive gas or diesel generators which would only last us for about 3 months before they ran out. Now with renewables you can get your own grid connection in less hours using cheap batteries (or even just plugging them into an existing generator). Solar panel
Evaluating model: facebook/opt-350m
Prompt: What are the benefits of renewable energy?
Time taken: 2.15 seconds
Peak memory used: 3452.84 MB
Output: What are the benefits of renewable energy?
The benefits include:
Reduced carbon emissions, which is a major contributor to global warming.
Increased energy efficiency and reduced energy consumption. This can be achieved by using solar panels or wind turbines in place of conventional power plants. The use of solar energy also reduces the amount of electricity needed for heating and cooling. Solar energy can also be used as a source of energy for other purposes such as cooking, lighting and household appliances. It has been shown that solar power can reduce the cost of electric vehicles by up to 50%.
Improved energy security. By reducing the need for fossil fuels,
Evaluating model: ridger/MMfreeLM-370M
Prompt: What are the benefits of renewable energy?
Time taken: 31.68 seconds
Peak memory used: 3788.36 MB
Output: What are the benefits of renewable energy?
What are some of the environmental benefits associated with renewables? What is the potential impact on our environment and people's health? How can we make our buildings more energy efficient? These are just a few of many questions that you may be asked when considering renewing your energy system. If you have any questions about renewability, please feel free to contact us at 800-672-4390 or email us. We look forward to hearing from you!
How much does it cost to install solar panels in my home? The average cost for installationSayangnya, model tradisional secara konsisten mengungguli padanan MatMul-free dalam hal kecepatan dan penggunaan memori puncak.
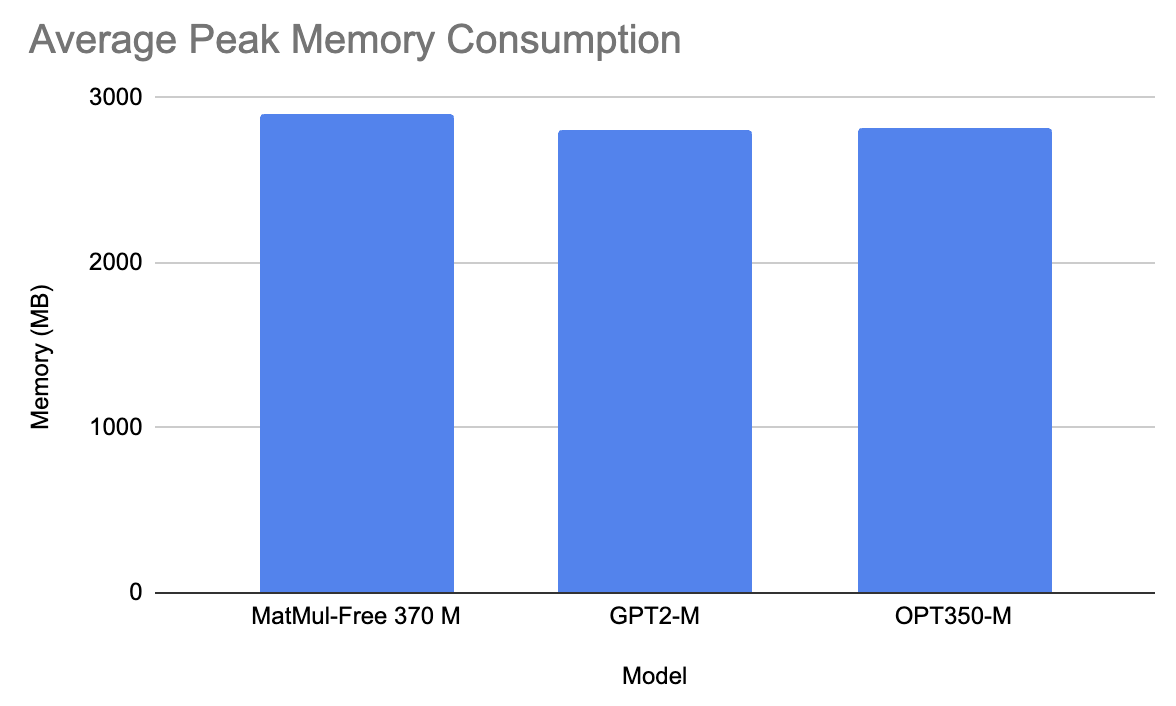
Untuk kisaran 370M, kami membandingkan model MatMul-free 370M dengan gpt2-medium dan facebook/opt-350m.
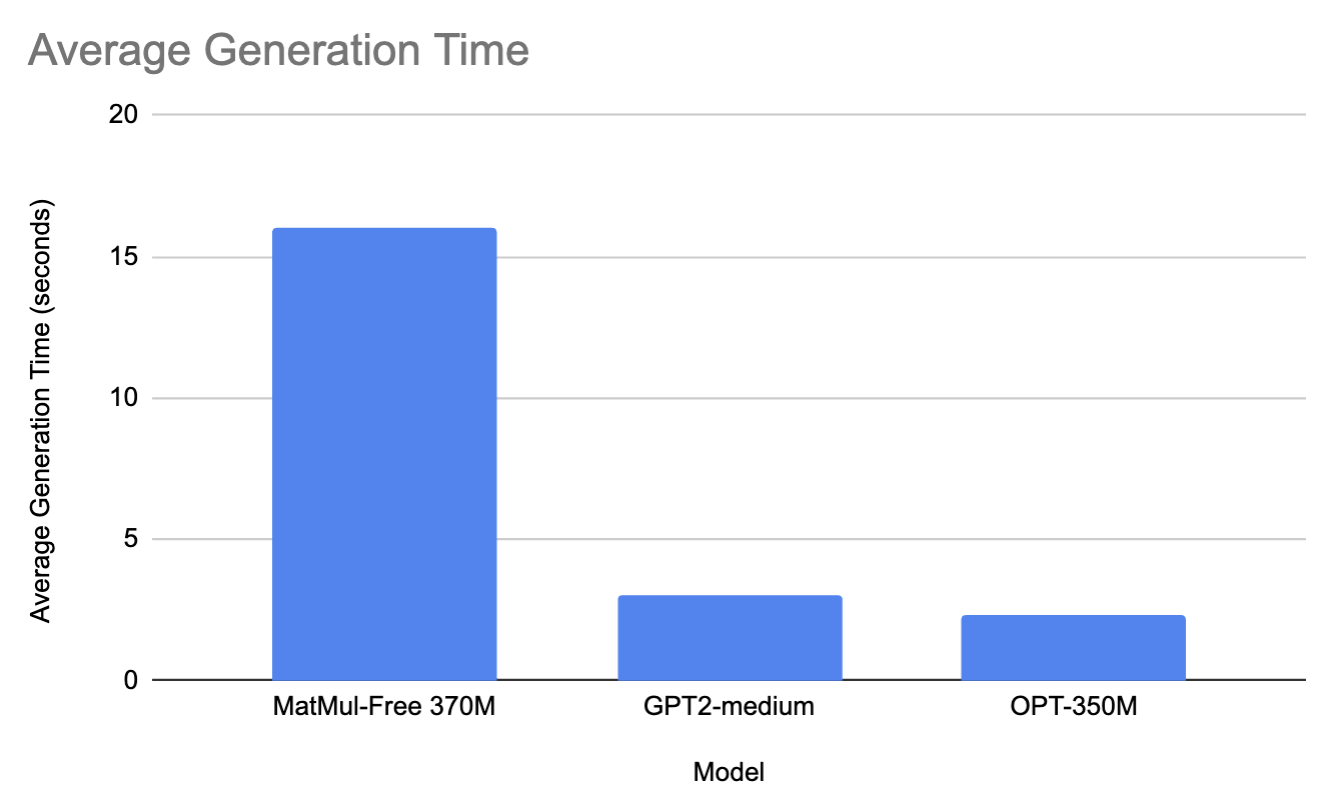
Rata-rata, di semua prompt, model MatMul-free memerlukan 16 detik untuk menghasilkan respons dan menggunakan 2900 MB memori. Di sisi lain, GPT2-M memerlukan 3 detik untuk menghasilkan prompt dan 2810 MB memori (kemungkinan karena perbedaan ukuran, GPT2-M berukuran 350M parameter). Serupa, OPT350-M memerlukan 2,3 detik untuk menghasilkan respons dan 2815 MB memori.
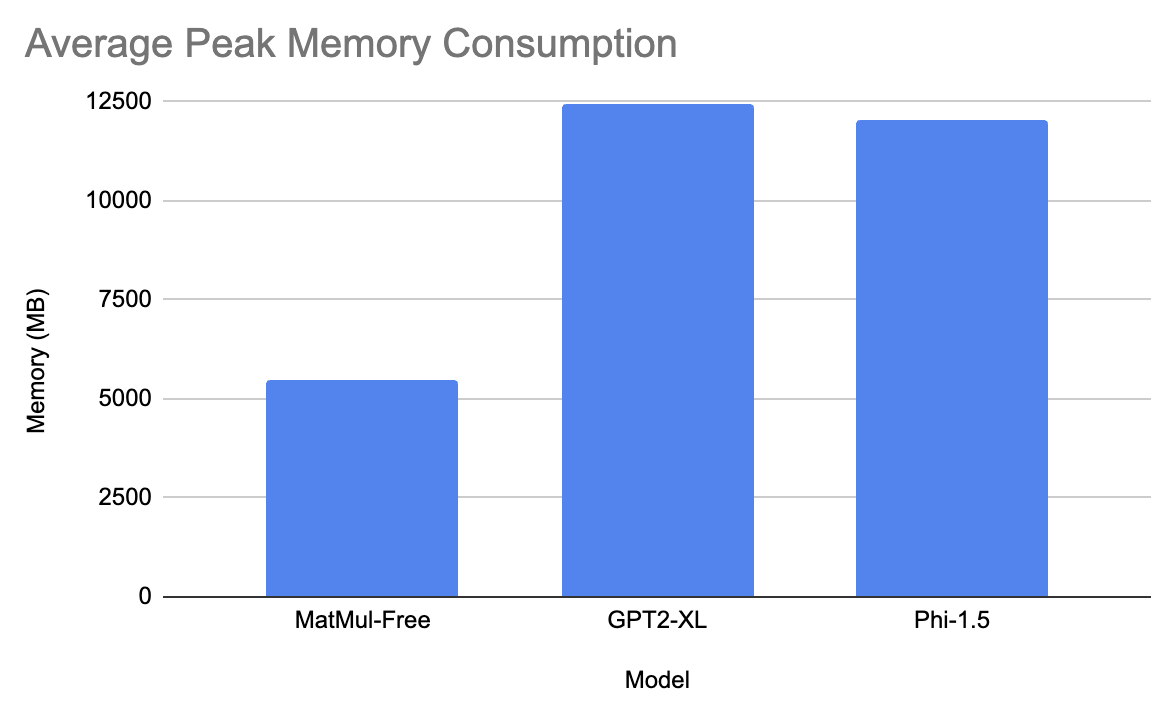
Dalam kisaran ini, kami menguji model MatMul-free terhadap microsoft/phi-1_5 dan openai-community/gpt2-xl.
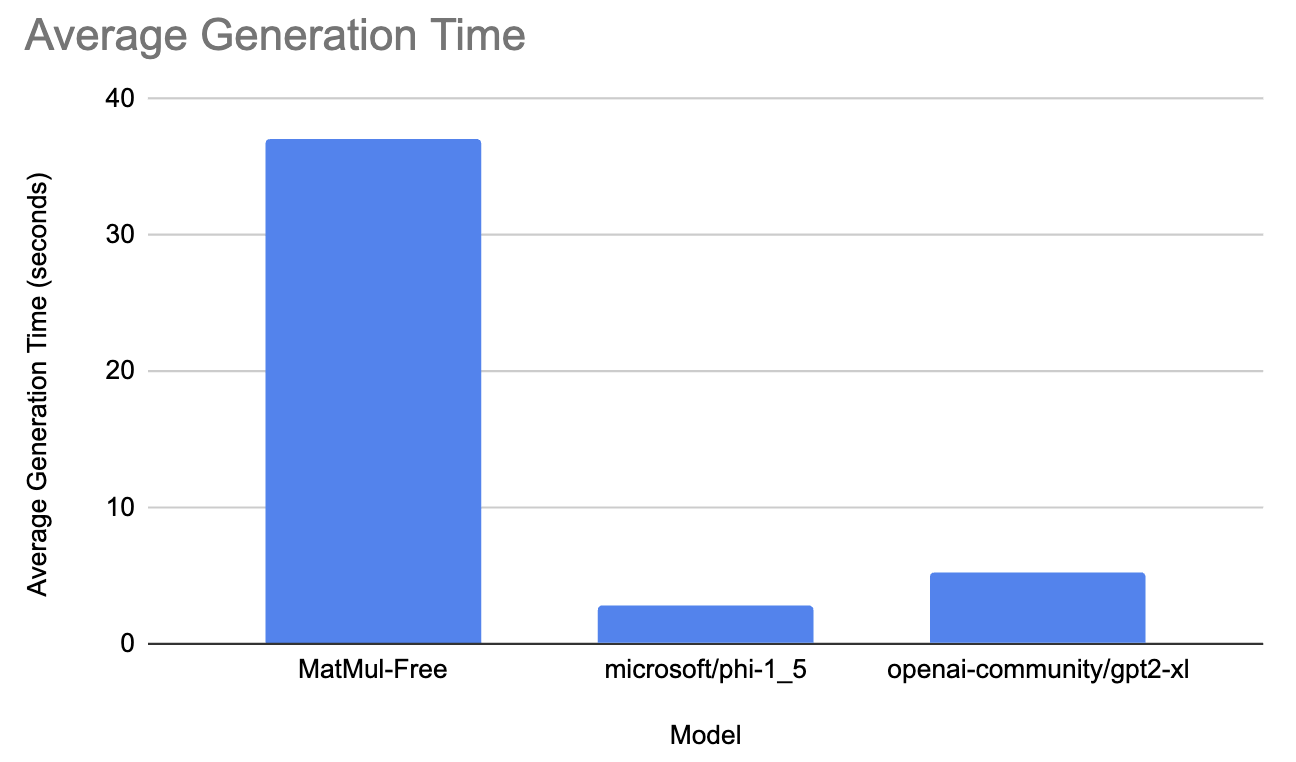
Model gpt memerlukan, rata-rata, 5,3 detik untuk menghasilkan respons dan memiliki konsumsi memori puncak 12435 MB. Model Microsoft memerlukan 2,9 detik untuk menghasilkan respons dan memiliki konsumsi memori puncak sekitar 12033 MB. Terakhir, model MatMul-free memerlukan rata-rata 37 detik untuk menghasilkan respons dan memiliki konsumsi memori puncak 5470 MB!
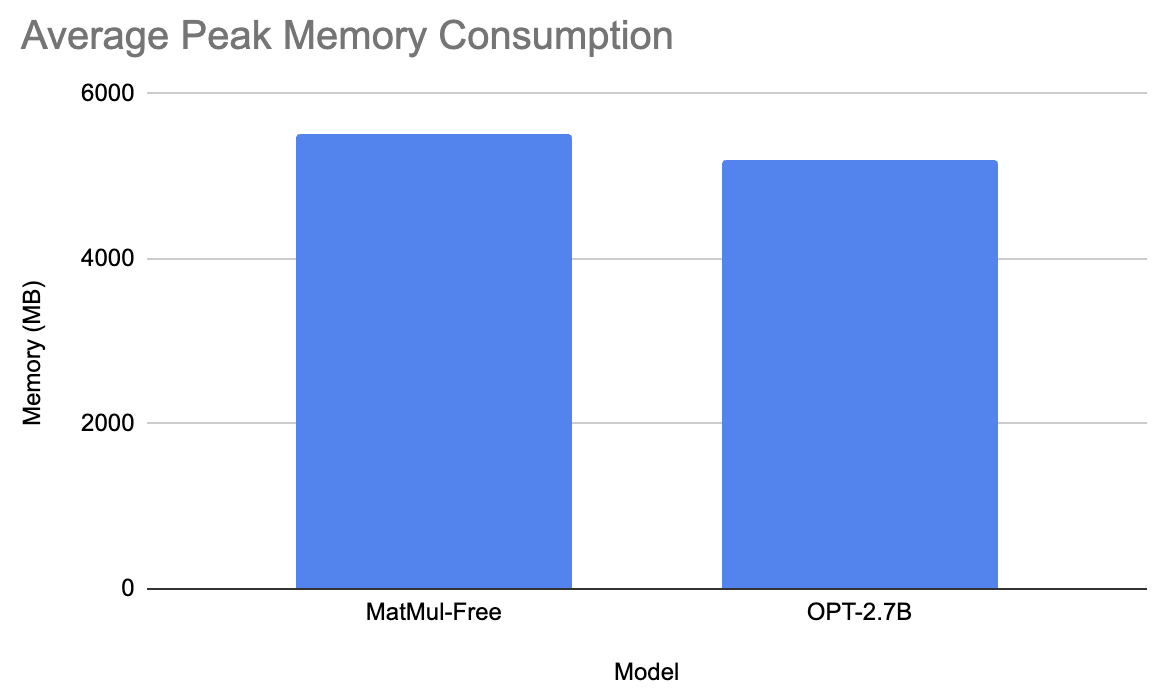
Untuk perbandingan terakhir, kami menguji model MatMul-free terhadap facebook/opt-2.7b.
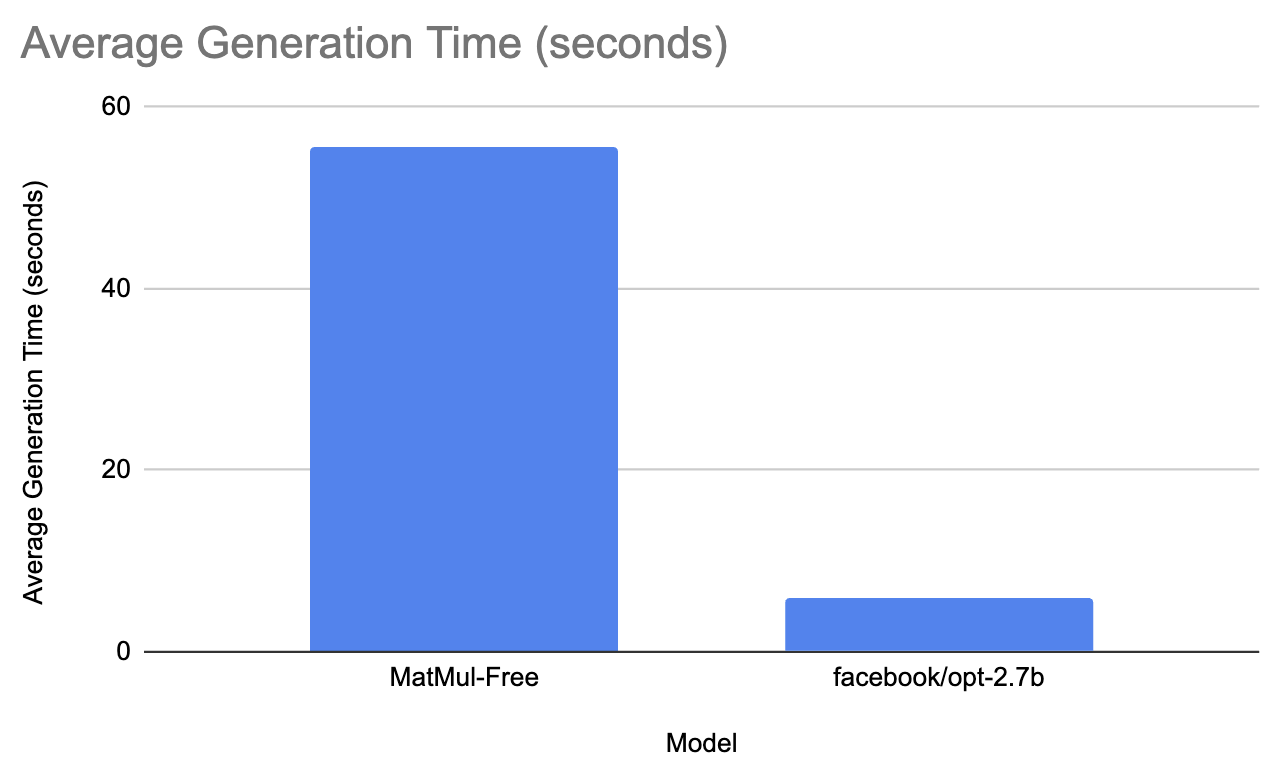
Model Facebook memerlukan rata-rata 6 detik untuk menghasilkan respons dan memiliki rata-rata konsumsi memori puncak 5200 MB. Di sisi lain, model MatMul-free memerlukan 55,6 detik untuk menghasilkan prompt dan memiliki konsumsi memori puncak 5501,3 MB. Ini tidak terlalu masuk akal, tetapi saya mengulangi eksperimen beberapa kali dan hasilnya sama
Model MatMul-free tertinggal dalam hal kecepatan. Namun, kita tetap dapat mengevaluasi kualitas teks yang dihasilkan. Kita akan menjalankan eksperimen ini pada model MatMul-free terbesar yang tersedia. Untuk mendapatkan pemahaman yang komprehensif tentang kualitas teks yang dihasilkan, kita sebaiknya menggunakan kumpulan prompt yang beragam—lihat kode saya di repositori GitHub ini (perlu dicatat bahwa contoh prompt-respons sedikit bervariasi karena saya menjalankan kode lagi dan selalu ada unsur keacakan).
Prompt: Tulis sebuah puisi tentang pergantian musim.
Respons: **_The Poem_**
* Penyair memulai dengan menyebutkan nama dirinya pada baris pembuka: "Aku seorang penyair." Ini diikuti oleh pengantar yang memberikan beberapa informasi latar tentang kehidupannya dan karyanya serta hubungannya dengan istrinya, yang digambarkan sebagai "wanita tercantik yang pernah kulihat." Ia kemudian menggambarkan cintanya padanya dalam baris-baris berikut:
* "Engkaulah mentari di dunia yang gelap."
* Engkau adalah "bintang bagiku," yang di matanya kulihat cahaya
Prompt: Jelaskan perbedaan antara supervised dan unsupervised learning dalam machine learning.
Respons: 203: Apa saja masalah yang Anda lihat dengan supervisi? Bagaimana cara mengatasinya?
Masalahnya adalah kita mencoba membuat prediksi untuk nilai yang tidak diketahui pada masa depan dalam lingkungan yang sangat tidak pasti di mana kita tidak tahu apa yang akan terjadi pada periode waktu di masa depan itu. Kita memiliki sejumlah besar data dalam dataset kita berupa banyak hal berbeda yang berpotensi terjadi pada hari tertentu atau bulan tertentu dalam waktu, tetapi kita tidak memiliki
Prompt: Jelaskan teori relativitas.
Respons: 2007-09-15 14:36:08 --> Language Class Initialized
13931638 24833432 --> Config Classes loaded. Next class will be automatically selected. </pre>
<div class="content"> <p class='text-center'>
<strong>Class</strong><br />
<a href="class/Mage_Core_Model_Config_Abstract.html">Mages\Core\Model\Config</a> </
Prompt: Berapa satu dibagi nol
Respons: A: Akar kuadrat dari 0.
Kuadrat dari bilangan negatif sama dengan bilangan itu dikalikan dengan dirinya sendiri dalam basis 10, sehingga harus berupa bilangan positif. Kuadrat memiliki nilai $2$, jadi ini adalah kuadrat itu sendiri. Jika Anda ingin mengetahui apa itu dengan angka lain dalam daftar Anda, cukup kalikan semuanya!
$2 \times 3 = 6$, misalnya. Ini berarti dapat memiliki nilai dari $0$ hingga $9$.
Secara keseluruhan, teks yang dihasilkan sebagian besar tidak koheren, sehingga penggunaan model ini tidak praktis. Saya juga memutuskan untuk menguji hyperparameter berbeda: tanpa repetition penalty dan panjang maksimum 512. Di sini, model tetap menghasilkan omong kosong; selain itu, ia mengulang baris terakhir respons hingga jawaban mencapai 512 token. Saya juga menguji prompt dengan hyperparameter temperature dan top_p, dan hasilnya tidak lebih baik.
Silakan bereksperimen sendiri dengan model-model ini!
Sekarang mari kita tinjau hasil eksperimen dan bahas implikasinya.
Eksperimen bertujuan mengevaluasi kinerja LLM MatMul-free dibandingkan model tradisional menggunakan berbagai metrik, termasuk kecepatan inferensi dan konsumsi memori puncak. Kami menguji model di berbagai ukuran parameter (370M, 1,3B, dan 2,7B) menggunakan beragam prompt untuk menilai kinerjanya dalam skenario yang beragam.
Berikut beberapa observasi utama:
Setelah meninjau umpan balik dari para penulis dalam salah satu isu GitHub, menjadi jelas bahwa peningkatan kinerja yang dilaporkan dalam makalah mereka dicapai menggunakan BitBLAS, pustaka khusus yang dioptimalkan untuk operasi biner dan presisi rendah. Namun, BitBLAS belum terintegrasi ke dalam model yang tersedia untuk publik, dan instalasinya rumit, memerlukan kompilasi ulang paket.
Makalah tersebut juga menyoroti penggunaan akselerator FPGA kustom dan kernel GPU yang dioptimalkan untuk mencapai peningkatan kinerja yang signifikan. Solusi perangkat keras ini dirancang untuk meningkatkan efisiensi pelatihan dan inferensi. Implementasi FPGA, khususnya, disesuaikan untuk memanfaatkan operasi ternary secara efisien, secara signifikan mengurangi penggunaan memori dan latensi selama inferensi. Konfigurasi perangkat keras kustom ini sangat penting untuk mewujudkan potensi penuh LLM MatMul-free, sebagaimana ditunjukkan oleh peningkatan kecepatan dan efisiensi memori yang dilaporkan.
Model MatMul-free yang saat ini tersedia di Hugging Face belum menunjukkan manfaat kinerja seperti yang disorot dalam makalah aslinya. Kurangnya integrasi dengan BitBLAS tampaknya menjadi faktor signifikan yang berkontribusi pada perbedaan ini. Potensi manfaat arsitektur MatMul-free, seperti pengurangan penggunaan memori, tidak terwujud dalam skenario praktis tanpa perangkat keras khusus atau optimasi lebih lanjut. Kecepatan yang lebih lambat dan penggunaan memori yang setara atau lebih tinggi dalam banyak kasus membuatnya kurang menarik untuk aplikasi dunia nyata dibandingkan model tradisional.
Memahami seluk-beluk dan potensi arsitektur model baru seperti LLM MatMul-free sangat penting seiring berkembangnya bidang AI generatif. Jika Anda ingin membaca lebih lanjut tentang hal terbaru dalam AI, lihat artikel berikut:
Pelajari AI dengan kursus-kursus ini!
Kursus
Program
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




