
Kurs
Python ile LLM'lere Giriş
3 sa
36.6K
Büyük dil modelleri (LLM’ler), işlemlerinde yoğun biçimde matris çarpımlarına (MatMul) dayanır; bu da ciddi hesaplama ve tepe bellek gereksinimlerine yol açar. Ancak yakın tarihli bir makalede, potansiyel olarak daha az kaynak kullanımıyla benzer performans vadeden yeni bir MatMul’suz LLM arketipi ortaya çıktı.
Bu yazıda, MatMul’suz LLM’leri klasik muadilleriyle karşılaştıracağım. 370M, 1.3B ve 2.7B parametreli üç farklı model boyutunda üretim yeteneklerini ve kaynak tüketimlerini inceleyeceğim. Analizim, modellerin hızını ve tepe bellek tüketimini kapsayarak, modern NLP’de MatMul’suz mimarilerin olası avantajlarını vurgulayacak.
MatMul’suz LLM’ler hakkında daha fazla bilgi için şu makaleyi okuyabilirsiniz: MatMul’suz LLM’ler: Temel Kavramların Açıklaması.
Bu bölümde deneyleri yürütmek için kullandığım kurulumu ele alacağım.
Makalenin yazarları, MatMul’suz modellerini hangi modellerle karşılaştırdıklarını açıkça belirtmiyor. Sadece “üç model boyutunda (370M, 1.3B ve 2.7B parametre) MatMul’suz LM’imizin iki varyantını, yeniden üretilmiş gelişmiş bir Transformer mimarisi (Transformer++, Llama-2 tabanlı) ile karşılaştırıyoruz.” ifadesine yer veriyorlar. Ayrıca tüm modeller SlimPajama veri seti üzerinde eğitilmiş.
Adil bir karşılaştırma için ideal olan, aynı veri setinde eğitilmiş açık kaynak modelleri kullanmaktır. Ancak böyle modellerin bulunmaması nedeniyle, bu yazı; mevcut benzer boyuttaki modellerin tepe bellek tüketimi ve hızını, makaledeki bulgularla karşılaştırıyor.
Karşılaştıracağımız modeller şunlar:
MatMul’suz LLM’lerin üç değerli (ternary) ağırlıklar ve BF16 aktivasyonlar kullandığını, bunun da bellek ve hız özelliklerini önemli ölçüde etkilediğini not etmek önemlidir. Karşılaştırma setimizdeki diğer modellerin hiçbiri üç değerli ağırlıklar ve BF16 aktivasyonlar kullanmadığından, bu özellikler MatMul’suz LLM’lere bellek verimliliği ve işlem hızı açısından benzersiz avantajlar sağlar. Bu ayrım, karşılaştırmalı analizimizde kritik olacaktır ve bu yeniliklerin MatMul’suz modellerin genel performansına nasıl katkıda bulunduğunu öne çıkaracaktır.
Karşılaştırmalarımızı gerçekleştirmek için T4 GPU çalışma zamanı ile bir Google Colab ortamında çalışacağız. Bu kurulum, büyük dil modellerini çalıştırmak ve değerlendirmek için güçlü ve erişilebilir bir platform sunar.
Kullanacağımız birincil kütüphane, ihtiyaç duyduğumuz tüm modellere erişebildiğimiz için huggingface’in transformers kütüphanesidir. Aşağıdaki komutla kurabiliriz:
pip install transformersMatMul’suz modellerimizi çalıştırmak için matmulfreellm kütüphanesini de kurmamız gerekecek. Kütüphane açık kaynaklıdır ve GitHub’da mevcuttur; şu komutla kurabiliriz:
pip install -U git+https://github.com/ridgerchu/matmulfreellmTepe bellek kullanımını izlemek için pytorch kullanacağız; sisteminize ve paket yöneticinize bağlı olarak farklı komutlarla kurulabilir; ayrıntılar burada açıklanmıştır. Google Colab kullanıyorsanız önceden kurulu olmalıdır.
Deneyleri şu şekilde çalıştırıyoruz. Önce gerekli kütüphaneleri içe aktarmamız gerekiyor:
import torch
import time
from transformers import AutoModelForCausalLM, AutoTokenizer
Ardından, her deney için model adlarını bir listede tanımlarız—verilen örnek, 370M parametre aralığındaki modeller içindir.
model_names = ["gpt2-medium", "facebook/opt-350m", "ridger/MMfreeLM-370M"]Sonra, modelleri ve belirteçleyicileri (tokenizer) belleğe yüklüyoruz. Sisteminizde yeterli bellek yoksa deneyleri her model için ayrı ayrı çalıştırabilirsiniz. Burada .half() yöntemiyle yarım kesinlikli float kullandığımızdan emin oluyoruz.
models = [AutoModelForCausalLM.from_pretrained(name).half().cuda() for name in model_names]
tokenizers = [AutoTokenizer.from_pretrained(name) for name in model_names]
Ayrıca her tokenizer için pad_token değerini ayarlamamız gerekir:
for tokenizer in tokenizers:
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token
Gerekli tüm gözlemleri yapmak için modelleri çalıştırıp çıktıyı alıyoruz—ben şu measure_performance() fonksiyonunu kullanacağım:
def measure_performance(model, tokenizer, prompt):
    inputs = tokenizer(prompt, return_tensors="pt", padding=True)
    input_ids = inputs.input_ids.cuda()
    attention_mask = inputs.attention_mask.cuda()
    torch.cuda.reset_peak_memory_stats()
    # Measure speed
    start_time = time.time()
    with torch.no_grad():
        outputs = model.generate(
            input_ids,
            attention_mask=attention_mask,
            max_length=128,
            pad_token_id=tokenizer.eos_token_id,
            repetition_penalty=1.1,
            no_repeat_ngram_size=2
        )
    end_time = time.time()
    # Measure memory after inference
    peak_memory = torch.cuda.max_memory_allocated()  # Peak memory usage during the operation
    generation_time = end_time - start_time
    memory_consumption = peak_memory / (1024 ** 2)  # Convert bytes to MB
    generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)

    return generation_time, memory_consumption, generated_text
Bu fonksiyon, bir dil modelinin performansını çıkarım hızı ve tepe bellek tüketimini ölçerek değerlendirir. Önce girdi istemini belirteçleyerek uygun dikkat maskeleri ve dolgu sağlar ve girdileri GPU’ya aktarır. Bellek kullanımı, tepe bellek istatistikleri sıfırlanıp ardından kaydedilerek izlenir—döndürmeden önce MB cinsine çeviririz.
Bence tepe bellek kullanımı en önemli istatistiktir; çünkü taşmaya yol açan odur. Fonksiyon ayrıca, metin üretiminden önce ve sonra zamanı kaydederek çıkarım hızını ölçer (Python’da çalışma süresi ölçmenin standart yolu budur).
Üretim için kullandığımız hiperparametreler .generate() metodunda ayarlanır. 128 belirteçlik azami uzunluk ve tekrar cezası kullanıyoruz (bu, MatMul’suz modelin aynı yanıtı defalarca üretmiş görünmesinden dolayı yapılmıştır). Sonuçta fonksiyon süreyi, tepe bellek tüketimini ve üretilen metni döndürür.
Artık istemi tanımlayıp deneyleri çalıştırabiliriz. Ayrıca verileri toplayacak ve farklı istemlerde modelleri çalıştırarak veri toplayacağım.
prompt = "What are the benefits of renewable energy?" #example prompt
results = {}
for name, model, tokenizer in zip(model_names, models, tokenizers):
	time_taken, memory_used, output = measure_performance(model, tokenizer,prompt)
	results[name] = {
	    "time_taken": time_taken,
	    "memory_used": memory_used,
	    "output": output
	}
	print(f"Model: {name}\nTime taken: {time_taken} seconds\nMemory used: {memory_used} MB\nOutput: {output}\n")
Çıktı şu şekilde görünüyor:
Evaluating model: gpt2-medium
Prompt: What are the benefits of renewable energy?
Time taken: 3.17 seconds
Peak memory used: 3521.02 MB
Output: What are the benefits of renewable energy?
 The answer is that it's cheaper than fossil fuels.    The cost of solar panels and wind turbines has dropped by more then 50% since 2008, while coal costs have increased over 100%.   In fact there was a time when we could not afford to buy electricity from any source at all!    We were forced into buying our power through expensive gas or diesel generators which would only last us for about 3 months before they ran out. Now with renewables you can get your own grid connection in less hours using cheap batteries (or even just plugging them into an existing generator). Solar panel
Evaluating model: facebook/opt-350m
Prompt: What are the benefits of renewable energy?
Time taken: 2.15 seconds
Peak memory used: 3452.84 MB
Output: What are the benefits of renewable energy?
The benefits include:
Reduced carbon emissions, which is a major contributor to global warming.
Increased energy efficiency and reduced energy consumption. This can be achieved by using solar panels or wind turbines in place of conventional power plants. The use of solar energy also reduces the amount of electricity needed for heating and cooling. Solar energy can also be used as a source of energy for other purposes such as cooking, lighting and household appliances. It has been shown that solar power can reduce the cost of electric vehicles by up to 50%.
Improved energy security. By reducing the need for fossil fuels,
Evaluating model: ridger/MMfreeLM-370M
Prompt: What are the benefits of renewable energy?
Time taken: 31.68 seconds
Peak memory used: 3788.36 MB
Output: What are the benefits of renewable energy?
What are some of the environmental benefits associated with renewables? What is the potential impact on our environment and people's health? How can we make our buildings more energy efficient? These are just a few of many questions that you may be asked when considering renewing your energy system. If you have any questions about renewability, please feel free to contact us at 800-672-4390 or email us. We look forward to hearing from you!
How much does it cost to install solar panels in my home? The average cost for installationNe yazık ki, geleneksel modeller hız ve tepe bellek kullanımı açısından MatMul’suz muadillerini tutarlı biçimde geride bıraktı.
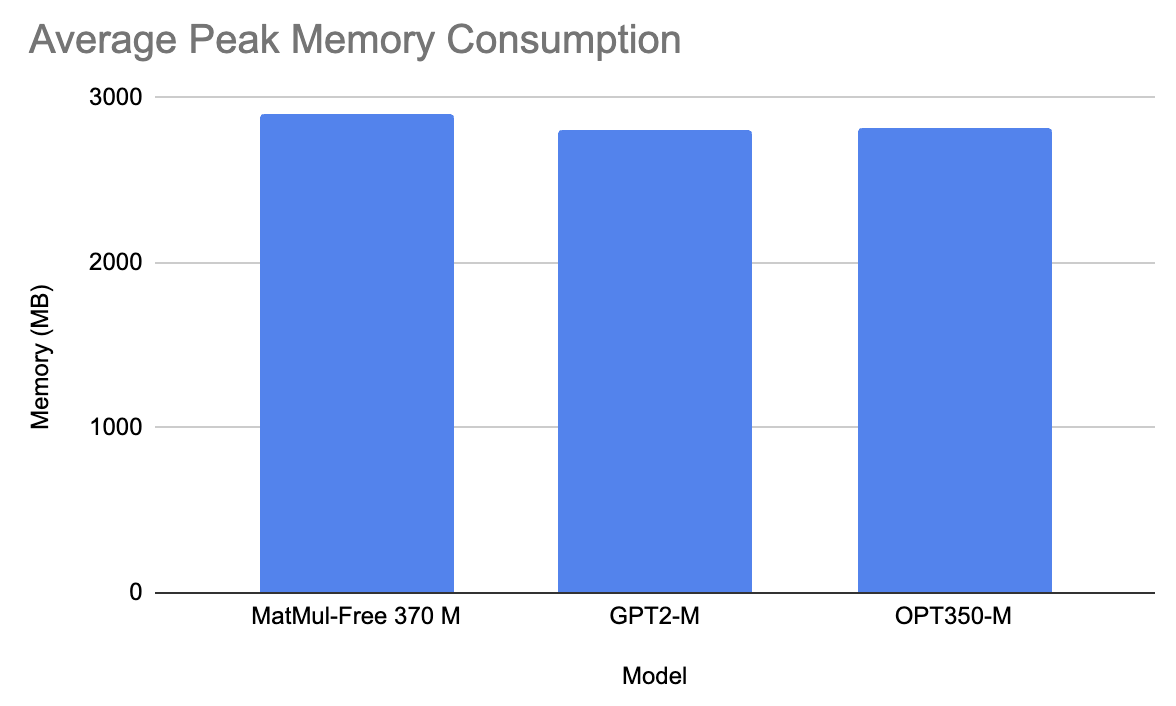
370M aralığı için, 370M MatMul’suz modeli gpt2-medium ve facebook/opt-350m ile karşılaştırdık.
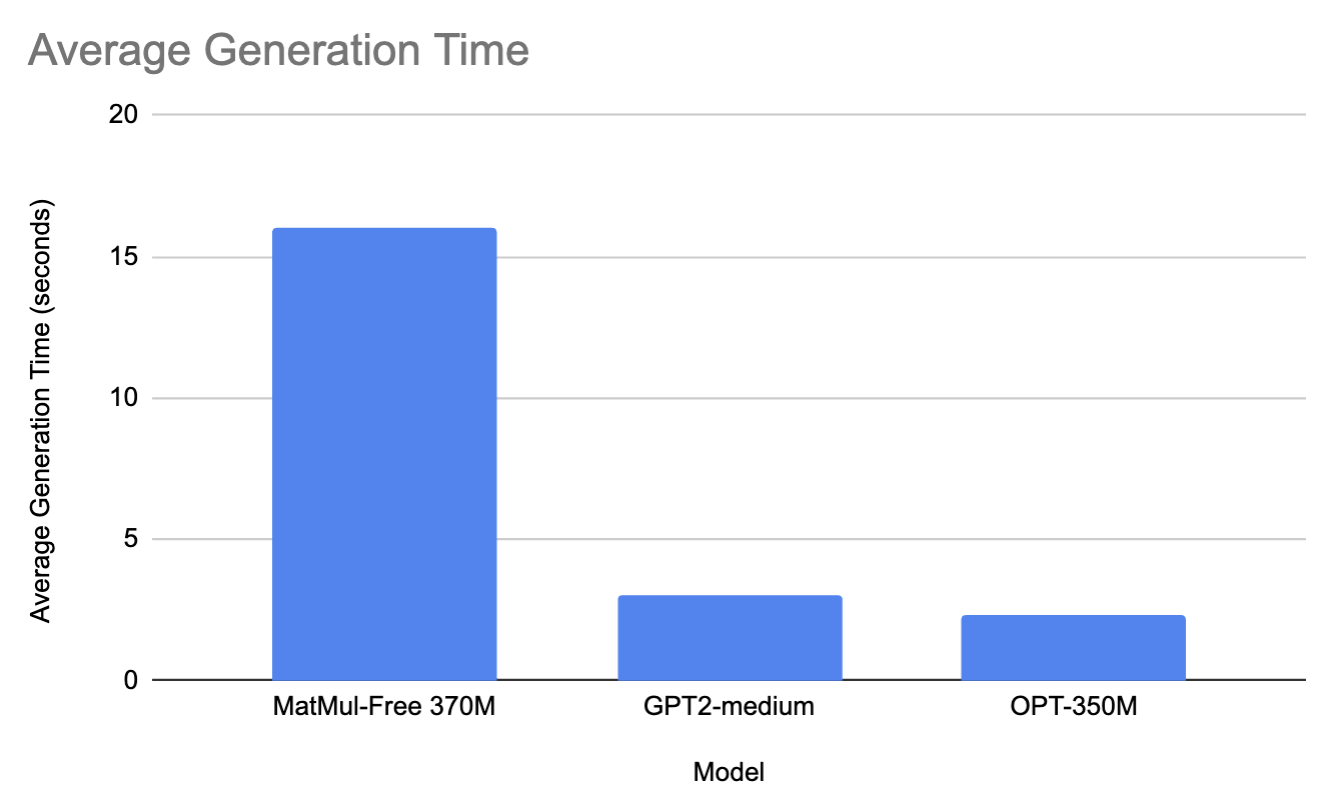
Tüm istemler genelinde ortalama olarak, MatMul’suz model bir yanıt üretmek için 16 saniye aldı ve 2900 MB bellek kullandı. Öte yandan GPT2-M bir istem üretmek için 3 saniye ve 2810 MB bellek kullandı (muhtemelen boyut farkından, GPT2-M’nin 350M parametre olmasından kaynaklı). Benzer şekilde, OPT350-M bir yanıt üretmek için 2,3 saniye ve 2815 MB bellek kullandı.
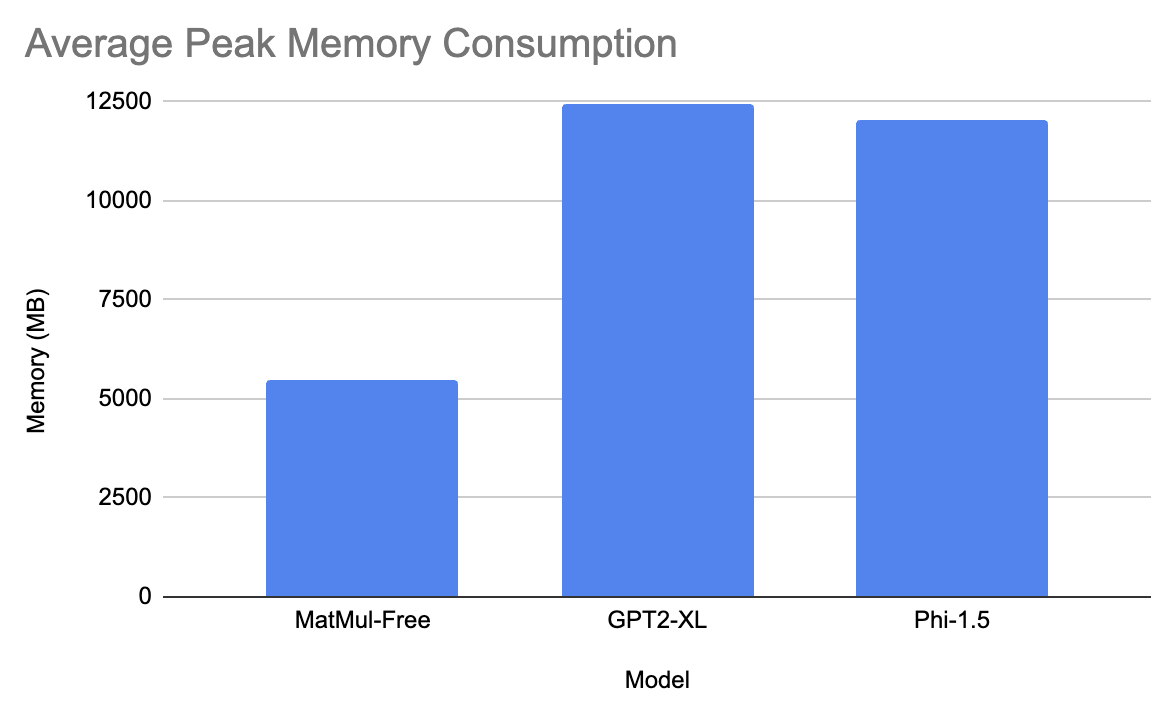
Bu aralıkta, MatMul’suz modeli microsoft/phi-1_5 ve openai-community/gpt2-xl ile test ettik.
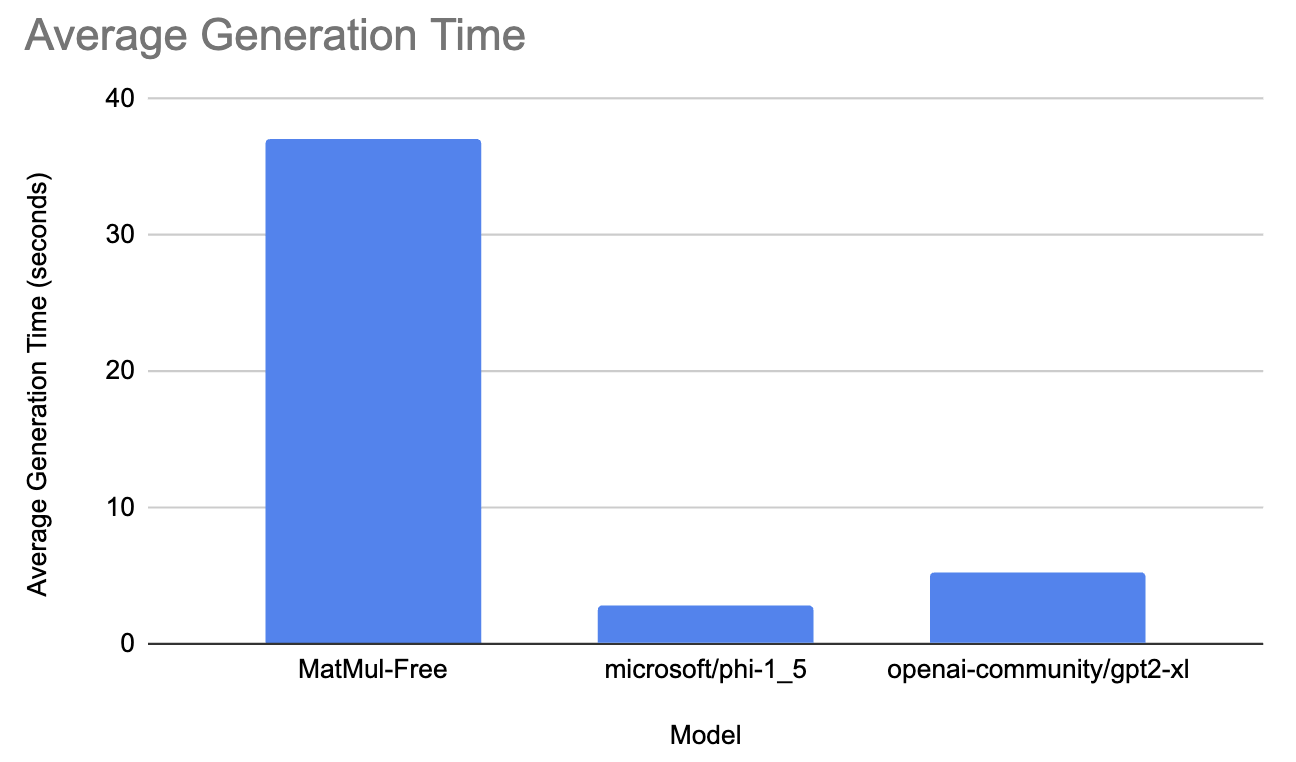
gpt modeli ortalama 5,3 saniyede yanıt üretti ve 12435 MB tepe bellek tüketimine ulaştı. Microsoft’un modeli 2,9 saniyede yanıt üretti ve yaklaşık 12033 MB tepe bellek tüketimine sahipti. Son olarak, MatMul’suz model ortalama 37 saniyede yanıt üretti ve 5470 MB tepe bellek tüketimine sahipti!
Son karşılaştırma için, MatMul’suz modeli facebook/opt-2.7b ile test ettik.
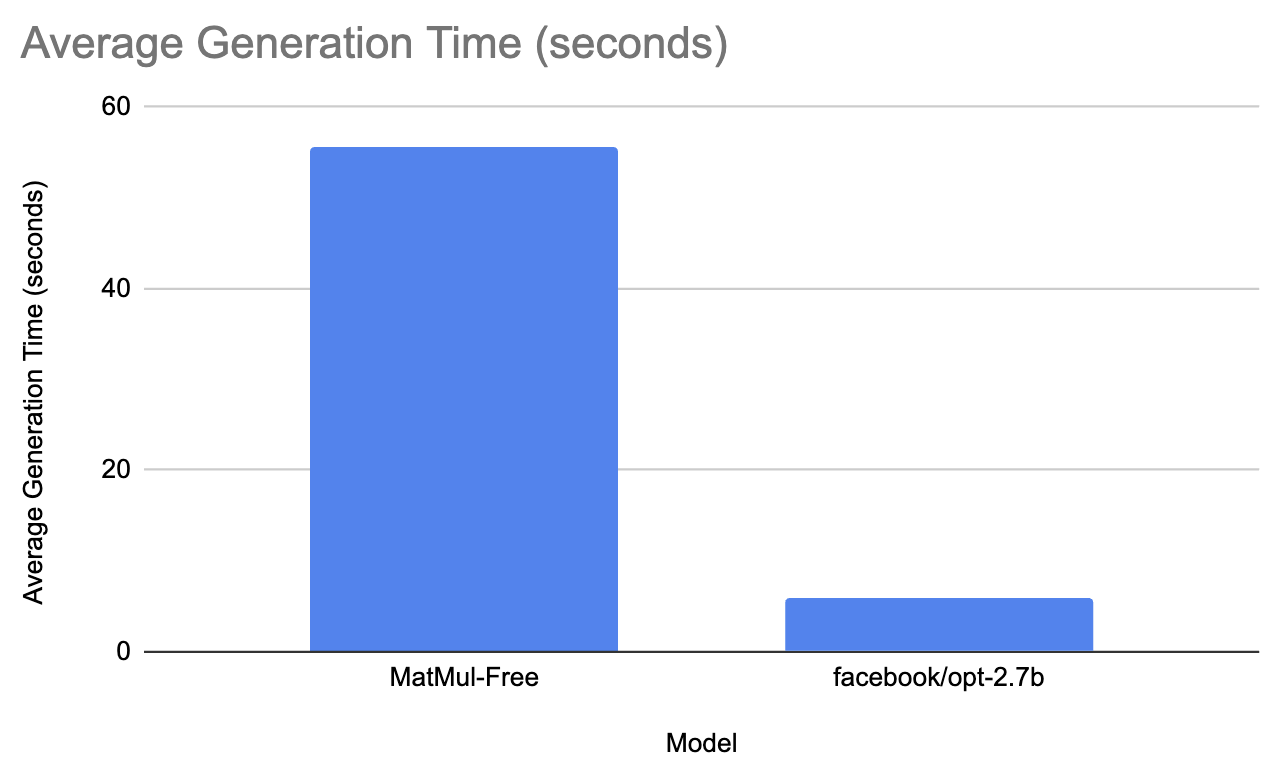
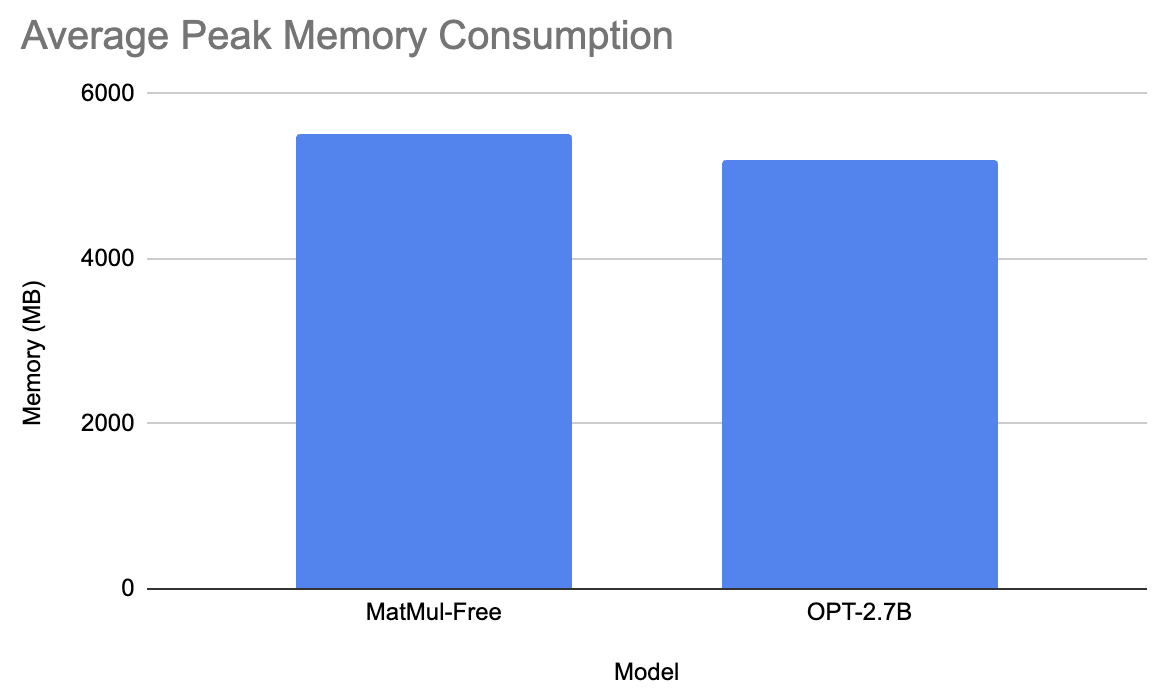
Facebook’un modeli ortalama 6 saniyede yanıt üretti ve ortalama 5200 MB tepe bellek tüketimine sahipti. Öte yandan MatMul’suz model, istemi üretmek için 55,6 saniye aldı ve 5501,3 MB tepe bellek tüketimine ulaştı. Bu pek mantıklı görünmese de deneyi birkaç kez tekrarladım ve sonuçlar aynı.
MatMul’suz modeller hız açısından yetersiz kaldı. Yine de ürettikleri metnin kalitesine göre değerlendirme yapabiliriz. Bu deneyi mevcut en büyük MatMul’suz modelde çalıştıracağız. Üretilen metnin kalitesini kapsamlı biçimde anlamak için çeşitli istemler kullanmalıyız—kodu şu GitHub deposunda görebilirsiniz (kodunu yeniden çalıştırdığım ve her zaman bir miktar rastgelelik olduğu için istem-yanıt örneklerinin biraz değiştiğini unutmayın).
İstem: Mevsimlerin değişimi hakkında bir şiir yazın.
Yanıt: **_The Poem_**
* Şair bu açılış satırında adını vererek başlar: "Ben bir şairim." Bunu, yaşamına ve eserlerine dair bazı arka plan bilgileri ile eşiyle ilişkisini anlatan bir giriş izler; eşi "gördüğüm en güzel kadın" olarak tanımlanmıştır. Ardından şu dizelerde ona olan aşkını betimler:
* "Karanlık bir dünyada güneşimsin."
* Sen benim için "bir yıldızsın", gözlerinde ışığı gördüğüm kişi
İstem: Makine öğreniminde denetimli ve denetimsiz öğrenme arasındaki farkları açıklayın.
Yanıt: 203: Denetimle ilgili gördüğünüz bazı sorunlar nelerdir? Nasıl çözülebilir?
Sorun şu ki, bu durumda gelecekte bilinmeyen bir değer için bir tahmin yapmaya çalışıyoruz; ne olacağını bilmediğimiz, oldukça belirsiz bir ortamda, gelecekteki bir zaman diliminde. Veri kümemizde o gün veya belirli bir ayda potansiyel olarak gerçekleşebilecek pek çok farklı şeye dair çok büyük miktarda veri var, ancak elimizde yok ki
İstem: Görelilik kuramını açıklayın.
Yanıt: 2007-09-15 14:36:08 --> Language Class Initialized
13931638 24833432 --> Config Classes loaded. Next class will be automatically selected. </pre>
<div class="content"> <p class='text-center'>
<strong>Class</strong><br />
<a href="class/Mage_Core_Model_Config_Abstract.html">Mages\Core\Model\Config</a> </
İstem: Bir bölü sıfır nedir
Yanıt: A: 0’ın kareköküdür.
Negatif bir sayının karesi, 10 tabanında o sayının kendisiyle çarpımına eşittir; dolayısıyla pozitif bir sayı olmalıdır. Karenin değeri $2$’dir, bu yüzden kendi başına bir karedir. Listenizdeki diğer sayıların ne olduğunu bulmak istiyorsanız, onları sadece birbiriyle çarpın!
Örneğin $2 \times 3 = 6$. Bu, $0$ ile $9$ arasında herhangi bir değere sahip olabileceği anlamına gelir.
Genel olarak, üretilen metin çoğunlukla tutarlı değil; bu da bu modellerin kullanımını pratik olmaktan çıkarıyor. Farklı hiperparametreleri de test etmeye karar verdim: tekrar cezası olmadan ve 512 azami uzunlukla. Burada da model anlamsız çıktılar üretti; ayrıca yanıt 512 belirtece ulaşana kadar son satırları tekrar etti. İstemleri temperature ve top_p hiperparametreleriyle de denedim; sonuç daha iyi olmadı.
Bu modellerle kendi başınıza denemeler yapmaktan çekinmeyin!
Şimdi deney sonuçlarını gözden geçirip çıkarımlarını tartışalım.
Deneyler, MatMul’suz LLM’lerin performansını, çıkarım hızı ve tepe bellek tüketimi gibi çeşitli metrikler kullanarak geleneksel modellerle karşılaştırmayı amaçladı. Farklı senaryolardaki performanslarını değerlendirmek için farklı parametre boyutlarındaki (370M, 1.3B ve 2.7B) modelleri çeşitli istemlerle test ettik.
İşte bazı temel gözlemler:
Yazarlardan birinin GitHub konusundaki geri bildirimini incelediğimizde, makalelerinde bildirilen performans artışlarının, ikili ve düşük kesinlikli işlemler için optimize edilmiş uzmanlaşmış bir kütüphane olan BitBLAS kullanılarak elde edildiği anlaşılıyor. Ancak BitBLAS henüz herkese açık modellere entegre edilmemiştir ve kurulumu paketin yeniden derlenmesini gerektiren karmaşık bir süreçtir.
Makale ayrıca, kayda değer performans iyileştirmeleri elde etmek için özel bir FPGA hızlandırıcı ve optimize edilmiş GPU çekirdeklerinin kullanımını vurguluyor. Bu donanım çözümleri, hem eğitim hem de çıkarım verimliliğini artırmak üzere tasarlanmıştır. Özellikle FPGA uygulaması, üç değerli işlemleri verimli şekilde kullanacak biçimde uyarlanmıştır; bu da çıkarım sırasında bellek kullanımını ve gecikmeyi önemli ölçüde azaltır. Bu özel donanım yapılandırmaları, bildirilen hız ve bellek verimliliği iyileştirmelerinin gösterdiği gibi, MatMul’suz LLM’lerin tam potansiyelini gerçekleştirmek için gereklidir.
Hugging Face’te şu an mevcut olan MatMul’suz modeller, orijinal makalede vurgulanan performans faydalarını sergilemiyor. BitBLAS entegrasyonunun eksikliği, bu tutarsızlığa önemli ölçüde katkıda bulunan bir etken gibi görünüyor. MatMul’suz mimarilerin olası faydaları—örneğin azaltılmış bellek kullanımı—özel donanım veya daha ileri optimizasyonlar olmadan pratik senaryolarda hayata geçmiyor. Daha yavaş hızlar ve çoğu durumda karşılaştırılabilir veya daha yüksek bellek kullanımı, onları gerçek dünya uygulamaları için geleneksel modellere kıyasla daha az cazip kılıyor.
Jeneratif yapay zekâ alanı evrilmeye devam ederken MatMul’suz LLM gibi yeni model mimarilerinin inceliklerini ve potansiyelini anlamak kritik önemdedir. Yapay zekâdaki en güncel gelişmeler hakkında daha fazla okumak isterseniz şu makalelere göz atın:
Bu kurslarla yapay zekâyı öğrenin!
Kurs
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




