Cours
Introduction aux LLM en Python
3 h
36.2K
Les grands modèles de langage (LLMs) s'appuient fortement sur les multiplications de matrices (MatMul) pour leurs opérations, ce qui entraîne des besoins importants en calcul et en mémoire de crête. Cependant, dans un article récent, une nouvelle famille de LLMs sans MatMul a fait son apparition, promettant des performances comparables avec une consommation potentiellement réduite de ressources.
Dans cet article, je compare les LLMs sans MatMul à leurs homologues classiques. J'examine leurs capacités génératives et leur consommation de ressources sur trois tailles de modèles : 370 M, 1,3 B et 2,7 B de paramètres. Mon analyse couvre la vitesse des modèles et la mémoire de crête, afin de mettre en lumière les avantages potentiels des architectures sans MatMul en NLP moderne.
Pour en savoir plus sur les LLMs sans MatMul, consultez cet article : MatMul-Free LLMs : key concepts explained.
Cette section présente l'environnement utilisé pour conduire les expériences.
Les auteurs de l'article n'indiquent pas explicitement quels modèles ont servi de référence pour comparer leurs modèles sans MatMul. Ils précisent seulement qu'ils « comparent deux variantes de notre LM sans MatMul à une architecture Transformer avancée reproduite (Transformer++, basée sur Llama-2) sur trois tailles de modèles : 370 M, 1,3 B et 2,7 B de paramètres. » De plus, tous les modèles ont été entraînés sur le jeu de données SlimPajama.
Pour une comparaison équitable, l'idéal serait d'utiliser des modèles open source entraînés sur le même jeu de données. Faute de disponibilité, cet article met en regard la mémoire de crête et la vitesse de modèles disponibles de taille comparable avec les résultats présentés dans la publication.
Voici les modèles de référence :
Il est important de noter que les LLMs sans MatMul utilisent des poids ternaires et des activations BF16, ce qui impacte fortement leur profil mémoire et leurs performances. Aucun autre modèle de notre panel n'exploite ces caractéristiques, qui confèrent donc aux LLMs sans MatMul des avantages uniques en termes d'efficacité mémoire et de vitesse de traitement. Cette distinction sera déterminante dans notre analyse comparative, en montrant comment ces innovations contribuent aux performances globales des modèles sans MatMul.
Pour nos comparaisons, nous utilisons un environnement Google Colab avec un runtime GPU T4. Ce cadre offre une plateforme à la fois puissante et accessible pour exécuter et évaluer des LLMs.
La principale bibliothèque utilisée est transformers de huggingface, puisque tous les modèles requis y sont disponibles. Installez-la avec la commande suivante :
pip install transformersNous aurons également besoin d'installer la bibliothèque matmulfreellm pour exécuter nos modèles sans MatMul. Cette bibliothèque est open source et disponible sur GitHub. Installez-la via :
pip install -U git+https://github.com/ridgerchu/matmulfreellmPour surveiller la mémoire de crête, nous utilisons pytorch, installable selon différentes commandes en fonction de votre système et de votre gestionnaire de paquets, comme décrit ici. Sous Google Colab, il est généralement préinstallé.
Voici la procédure : commencez par importer les bibliothèques nécessaires :
import torch
import time
from transformers import AutoModelForCausalLM, AutoTokenizer
Ensuite, pour chaque expérience, définissez la liste des noms de modèles — l'exemple ci-dessous concerne les modèles autour de 370 M de paramètres.
model_names = ["gpt2-medium", "facebook/opt-350m", "ridger/MMfreeLM-370M"]Chargez ensuite les modèles et les tokenizers en mémoire. Si votre machine ne dispose pas de suffisamment de mémoire, exécutez l'expérience modèle par modèle. Ici, nous forçons la demi-précision flottante avec la méthode .half().
models = [AutoModelForCausalLM.from_pretrained(name).half().cuda() for name in model_names]
tokenizers = [AutoTokenizer.from_pretrained(name) for name in model_names]
Nous devons aussi définir le pad_token pour chaque tokenizer :
for tokenizer in tokenizers:
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token
Pour effectuer nos mesures, faisons tourner les modèles et récupérons la sortie ; j'utilise la fonction measure_performance() suivante :
def measure_performance(model, tokenizer, prompt):
    inputs = tokenizer(prompt, return_tensors="pt", padding=True)
    input_ids = inputs.input_ids.cuda()
    attention_mask = inputs.attention_mask.cuda()
    torch.cuda.reset_peak_memory_stats()
    # Measure speed
    start_time = time.time()
    with torch.no_grad():
        outputs = model.generate(
            input_ids,
            attention_mask=attention_mask,
            max_length=128,
            pad_token_id=tokenizer.eos_token_id,
            repetition_penalty=1.1,
            no_repeat_ngram_size=2
        )
    end_time = time.time()
    # Measure memory after inference
    peak_memory = torch.cuda.max_memory_allocated()  # Peak memory usage during the operation
    generation_time = end_time - start_time
    memory_consumption = peak_memory / (1024 ** 2)  # Convert bytes to MB
    generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)

    return generation_time, memory_consumption, generated_text
Cette fonction évalue les performances d'un modèle de langage en mesurant la vitesse d'inférence et la mémoire de crête. Elle tokenize d'abord l'invite en gérant masques d'attention et padding, puis transfère les tenseurs sur le GPU. L'utilisation mémoire est suivie en réinitialisant puis en enregistrant la mémoire de crête — convertie en Mo avant le retour.
Selon moi, la mémoire de crête est la statistique la plus importante, car c'est elle qui provoque un dépassement. La fonction mesure également la vitesse d'inférence en enregistrant le temps avant et après la génération (méthode standard en Python).
Les hyperparamètres de génération sont passés à .generate(). Nous fixons une longueur maximale de 128 tokens et une pénalité de répétition (car le modèle sans MatMul avait tendance à répéter sa réponse). Au final, la fonction renvoie le temps, la mémoire de crête et le texte généré.
Nous pouvons maintenant définir l'invite et lancer les expériences. Je collecte également des données sur différentes invites.
prompt = "What are the benefits of renewable energy?" #example prompt
results = {}
for name, model, tokenizer in zip(model_names, models, tokenizers):
	time_taken, memory_used, output = measure_performance(model, tokenizer,prompt)
	results[name] = {
	    "time_taken": time_taken,
	    "memory_used": memory_used,
	    "output": output
	}
	print(f"Model: {name}\nTime taken: {time_taken} seconds\nMemory used: {memory_used} MB\nOutput: {output}\n")
La sortie ressemble à ceci :
Evaluating model: gpt2-medium
Prompt: What are the benefits of renewable energy?
Time taken: 3.17 seconds
Peak memory used: 3521.02 MB
Output: What are the benefits of renewable energy?
 The answer is that it's cheaper than fossil fuels.    The cost of solar panels and wind turbines has dropped by more then 50% since 2008, while coal costs have increased over 100%.   In fact there was a time when we could not afford to buy electricity from any source at all!    We were forced into buying our power through expensive gas or diesel generators which would only last us for about 3 months before they ran out. Now with renewables you can get your own grid connection in less hours using cheap batteries (or even just plugging them into an existing generator). Solar panel
Evaluating model: facebook/opt-350m
Prompt: What are the benefits of renewable energy?
Time taken: 2.15 seconds
Peak memory used: 3452.84 MB
Output: What are the benefits of renewable energy?
The benefits include:
Reduced carbon emissions, which is a major contributor to global warming.
Increased energy efficiency and reduced energy consumption. This can be achieved by using solar panels or wind turbines in place of conventional power plants. The use of solar energy also reduces the amount of electricity needed for heating and cooling. Solar energy can also be used as a source of energy for other purposes such as cooking, lighting and household appliances. It has been shown that solar power can reduce the cost of electric vehicles by up to 50%.
Improved energy security. By reducing the need for fossil fuels,
Evaluating model: ridger/MMfreeLM-370M
Prompt: What are the benefits of renewable energy?
Time taken: 31.68 seconds
Peak memory used: 3788.36 MB
Output: What are the benefits of renewable energy?
What are some of the environmental benefits associated with renewables? What is the potential impact on our environment and people's health? How can we make our buildings more energy efficient? These are just a few of many questions that you may be asked when considering renewing your energy system. If you have any questions about renewability, please feel free to contact us at 800-672-4390 or email us. We look forward to hearing from you!
How much does it cost to install solar panels in my home? The average cost for installationMalheureusement, les modèles traditionnels ont systématiquement surpassé leurs homologues sans MatMul, tant en vitesse qu'en mémoire de crête.
Pour la gamme 370 M, nous avons comparé le modèle sans MatMul 370 M à gpt2-medium et facebook/opt-350m.
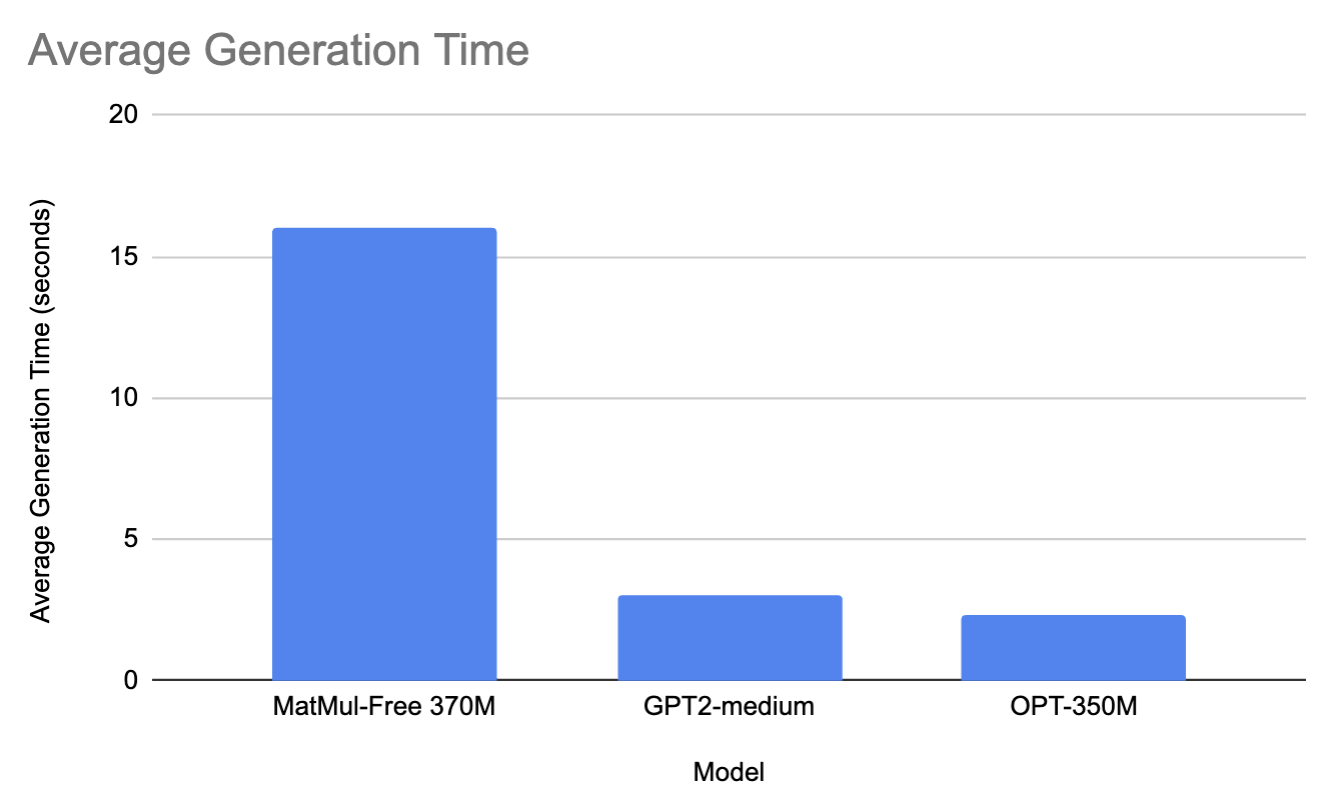
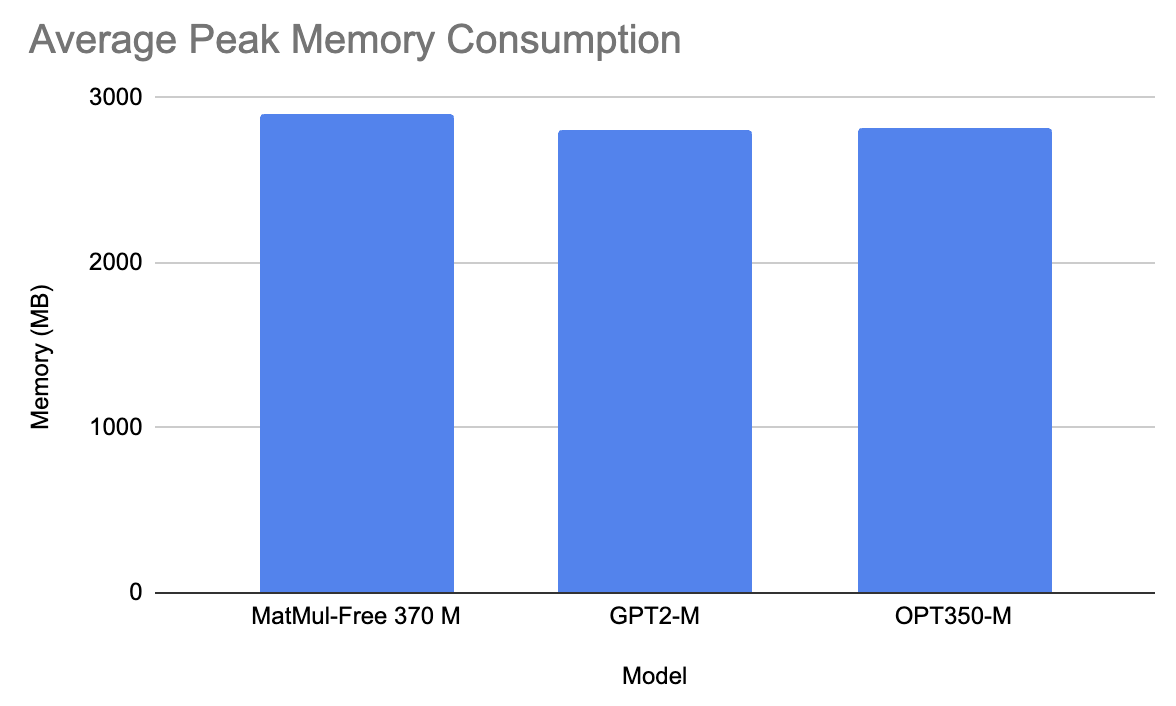
En moyenne, sur toutes les invites, le modèle sans MatMul a mis 16 secondes pour générer une réponse et utilisé 2©00 Mo de mémoire. De son côté, GPT2-M a mis 3 secondes et 2¨10 Mo (probablement en raison de la différence de taille, GPT2-M comptant 350 M de paramètres). De même, OPT350-M a mis 2,3 secondes et 2¨15 Mo.
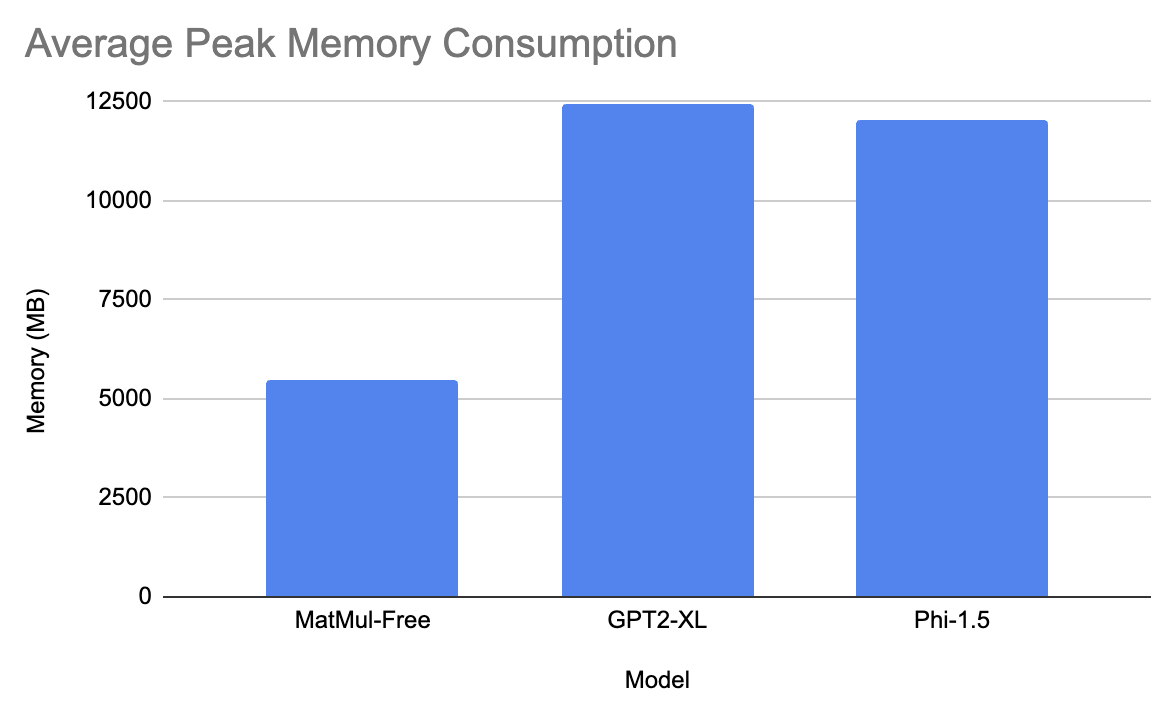
Dans cette gamme, nous avons testé le modèle sans MatMul face à microsoft/phi-1_5 et openai-community/gpt2-xl.
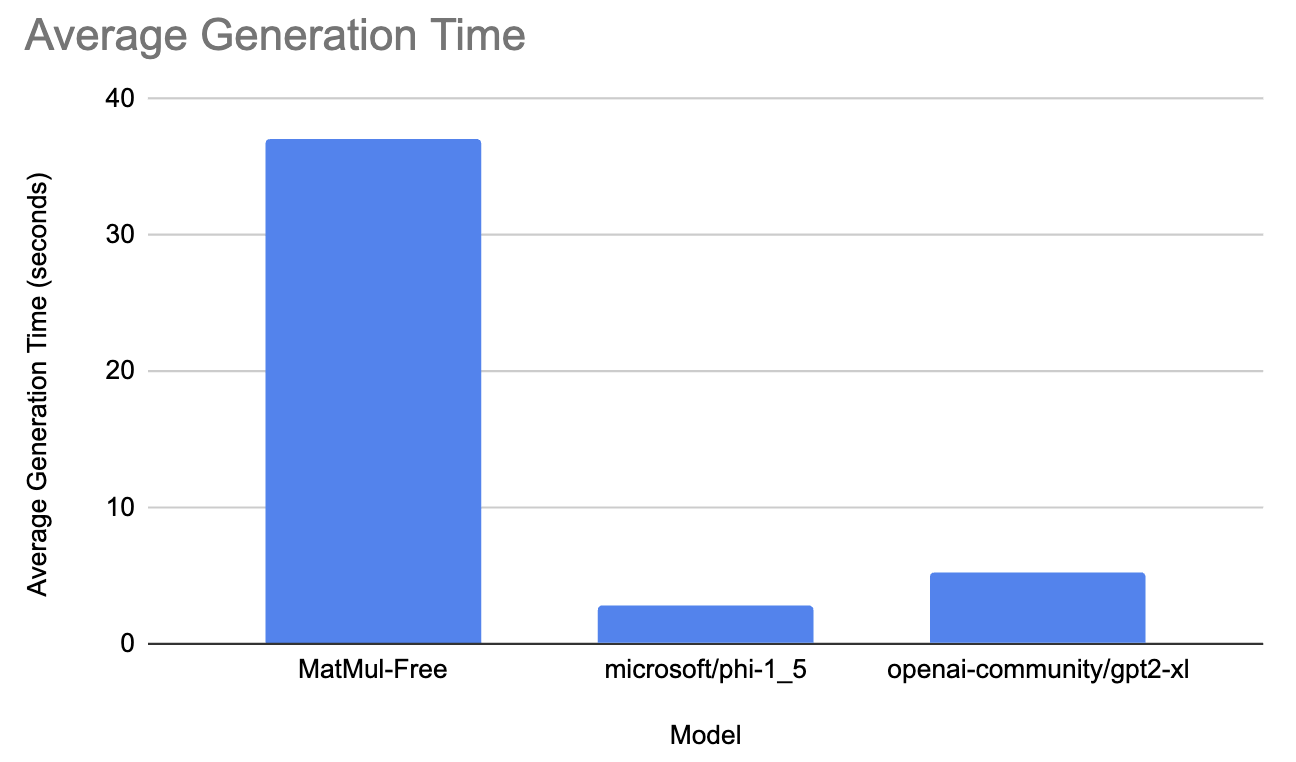
Le modèle gpt a mis en moyenne 5,3 secondes pour générer la réponse, avec 12 435 Mo de mémoire de crête. Le modèle de Microsoft a mis 2,9 secondes, avec environ 12 033 Mo. Enfin, le modèle sans MatMul a mis 37 secondes en moyenne, avec 5¤70 Mo de mémoire de crête !
Pour la dernière comparaison, nous avons opposé le modèle sans MatMul à facebook/opt-2.7b.
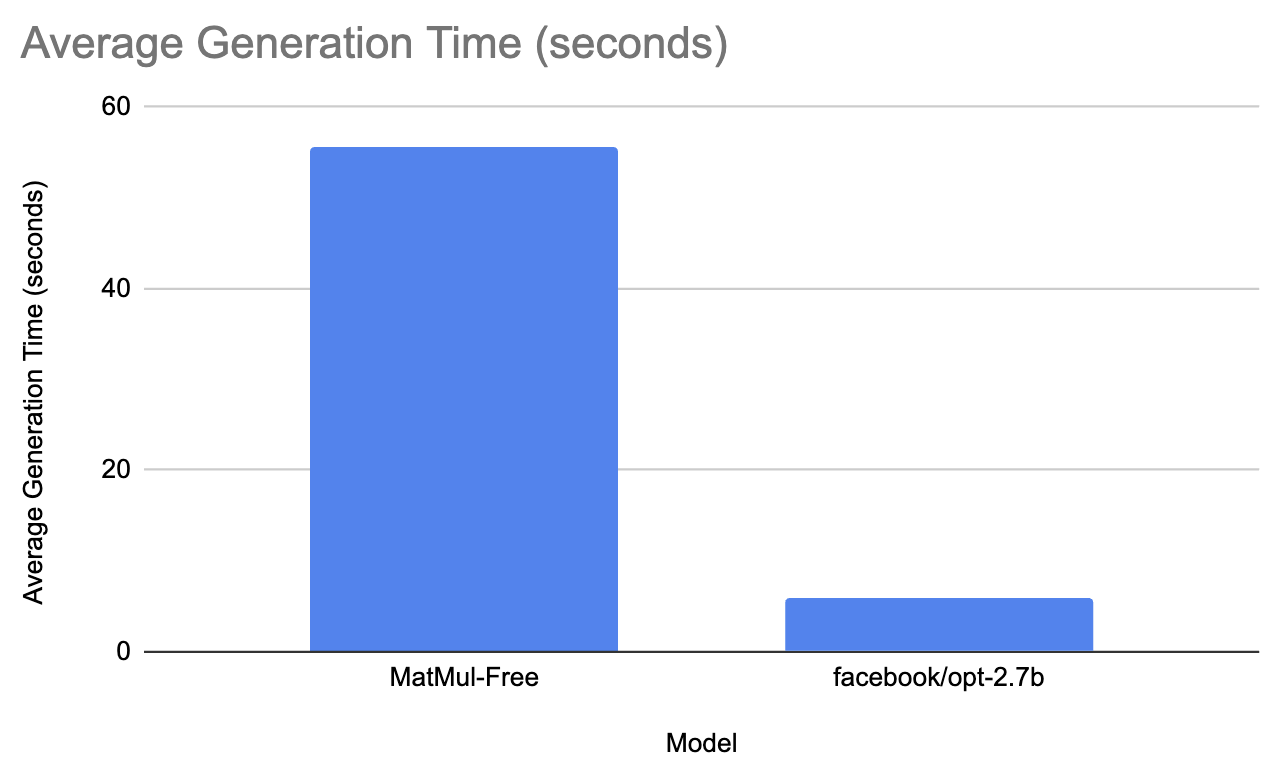
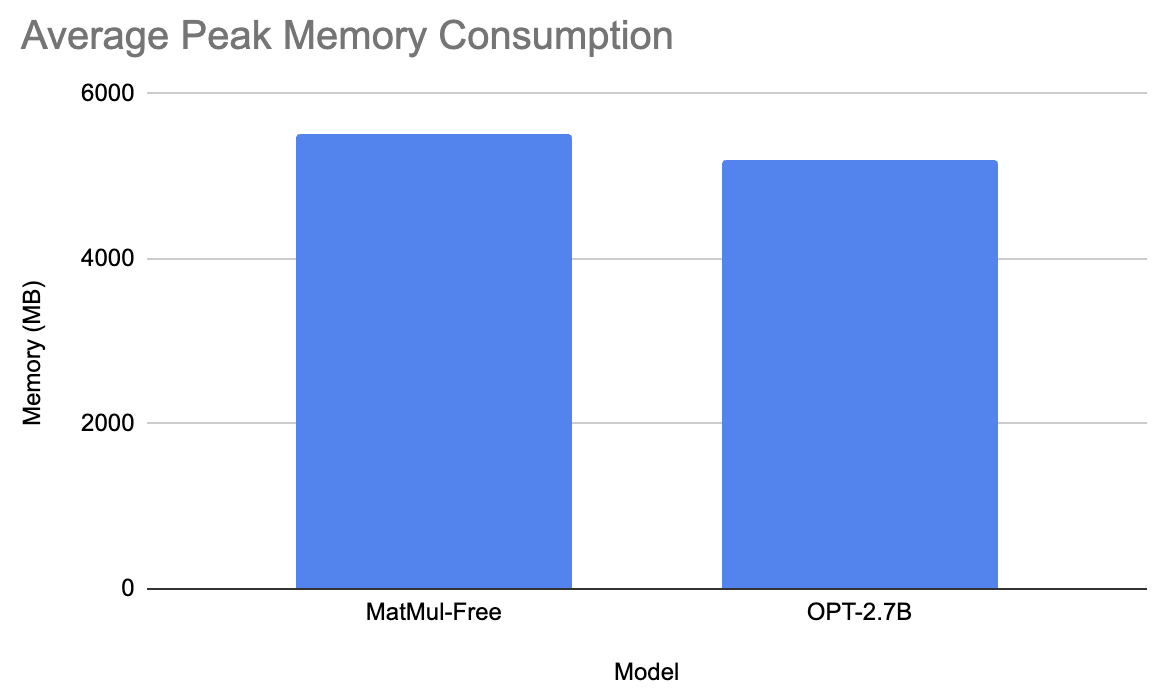
Le modèle de Facebook a mis en moyenne 6 secondes pour produire la réponse, avec une mémoire de crête moyenne de 5¢00 Mo. De son côté, le modèle sans MatMul a mis 55,6 secondes pour générer l'invite et présenté une mémoire de crête de 5¥01,3 Mo. Cela peut surprendre, mais après plusieurs relances, les résultats sont restés inchangés.
Les modèles sans MatMul sont à la traîne en vitesse. Évaluons tout de même la qualité des textes générés. Nous exécuterons cette expérience sur le plus grand modèle sans MatMul disponible. Pour juger correctement la qualité, il faut un panel d'invites varié — voyez mon code dans ce dépôt GitHub (notez que les exemples peuvent légèrement varier : j'ai relancé le code et une part d'aléatoire subsiste).
Invite : Composez un poème sur le changement des saisons.
Réponse : **_The Poem_**
* Le ou la poète commence par donner son nom dans cette première ligne : « I am a poet. » Puis vient une introduction qui apporte des éléments de contexte sur sa vie et son œuvre ainsi que sa relation avec son épouse, décrite comme « la plus belle femme que j'aie jamais vue ». Il décrit ensuite son amour pour elle dans les vers suivants :
* « You are my sunshine in a world of dark. »
* Vous êtes « a star to me », celle dont les yeux font jaillir la lumière
Invite : Expliquez les différences entre l'apprentissage supervisé et non supervisé en apprentissage automatique.
Réponse : 203 : Quels problèmes avez-vous observés avec la supervision ? Comment les résoudre ?
Le problème est que nous tentons de prédire une valeur inconnue à l'avenir dans un environnement très incertain, où nous ne savons pas ce qui se produira à ce moment-là. Notre jeu de données contient une quantité considérable d'informations sur de nombreux facteurs qui pourraient potentiellement survenir tel jour ou tel mois, mais nous n'avons tout simplement pas
Invite : Expliquez la théorie de la relativité.
Réponse : 2007-09-15 14:36:08 --> Language Class Initialized
13931638 24833432 --> Config Classes loaded. Next class will be automatically selected. </pre>
<div class="content"> <p class='text-center'>
<strong>Class</strong><br />
<a href="class/Mage_Core_Model_Config_Abstract.html">Mages\Core\Model\Config</a> </
Invite : Combien font un divisé par zéro ?
Réponse : A : C'est la racine carrée de 0.
Le carré d'un nombre négatif est égal à ce nombre multiplié par lui-même en base 10, donc il doit être positif. Le carré vaut $2$, c'est donc un carré à part entière. Si vous voulez le retrouver avec les autres nombres de votre liste, multipliez-les simplement !
$2 \times 3 = 6$, par exemple. Cela signifie qu'il peut prendre n'importe quelle valeur de $0$ à $9$.
Globalement, le texte généré manque le plus souvent de cohérence, ce qui rend ces modèles peu exploitables. J'ai également testé d'autres hyperparamètres : pas de pénalité de répétition et longueur max 512. Le modèle a tout de même produit du charabia et a répété les dernières lignes jusqu'à atteindre 512 tokens. Des tests avec temperature et top_p n'ont pas donné de meilleurs résultats.
N'hésitez pas à expérimenter vous-même ces modèles !
Passons en revue les résultats des expériences et leurs implications.
Les expériences visaient à évaluer les performances des LLMs sans MatMul par rapport aux modèles traditionnels selon plusieurs critères, dont la vitesse d'inférence et la mémoire de crête. Nous avons testé des modèles de différentes tailles (370 M, 1,3 B et 2,7 B) avec une variété d'invites pour observer leur comportement dans des scénarios divers.
Voici les principaux enseignements :
Après lecture des commentaires des auteurs dans l'un des tickets GitHub, il apparaît que les gains présentés dans leur article reposent sur BitBLAS, une bibliothèque spécialisée optimisée pour les opérations binaires et basse précision. Or, BitBLAS n'est pas encore intégré aux modèles publics, et son installation est complexe, nécessitant une recompilation du paquet.
L'article met également en avant l'usage d'un accélérateur FPGA personnalisé et de noyaux GPU optimisés pour obtenir des améliorations substantielles. Ces solutions matérielles améliorent l'efficacité en entraînement comme en inférence. L'implémentation FPGA, en particulier, exploite efficacement les opérations ternaires, réduisant significativement l'empreinte mémoire et la latence en inférence. Ces configurations spécifiques sont essentielles pour réaliser tout le potentiel des LLMs sans MatMul, comme l'attestent les gains rapportés en vitesse et en efficacité mémoire.
Les modèles sans MatMul actuellement disponibles sur Hugging Face ne reproduisent pas les gains annoncés dans l'article d'origine. L'absence d'intégration de BitBLAS semble jouer un rôle majeur dans cet écart. Les bénéfices potentiels des architectures sans MatMul, comme la réduction de la mémoire, ne se concrétisent pas en pratique sans matériel spécialisé ou optimisations supplémentaires. La lenteur et une mémoire comparable voire plus élevée dans la plupart des cas les rendent moins attractifs pour des usages réels que les modèles traditionnels.
Comprendre les subtilités et le potentiel de nouvelles architectures comme les LLMs sans MatMul est crucial alors que l'IA générative évolue. Pour aller plus loin, lisez aussi :
Formez-vous à l'IA avec ces cours !
Cours
Cursus
Cours