Kurs
Einführung in LLMs mit Python
3 Std.
36.2K
Große Sprachmodelle (LLMs) stützen sich stark auf Matrixmultiplikationen (MatMul), was zu erheblichem Rechenaufwand und hohen Spitzenwerten beim Speicherbedarf führt. In einer aktuellen Veröffentlichung ist jedoch ein neuer Archetyp MatMul-freier LLMs entstanden, der vergleichbare Leistung bei potenziell geringerem Ressourcenverbrauch verspricht.
In diesem Artikel vergleiche ich MatMul-freie LLMs mit ihren klassischen Gegenstücken. Ich untersuche ihre Generierungsfähigkeiten und den Ressourcenverbrauch über drei Modellgrößen hinweg: 370M, 1,3B und 2,7B Parameter. Meine Analyse betrachtet Geschwindigkeit und maximale Speicherauslastung und zeigt die potenziellen Vorteile MatMul-freier Architekturen im modernen NLP auf.
Wenn du mehr über MatMul-freie LLMs erfahren willst, lies diesen Artikel: MatMul-Free LLMs: Key Concepts Explained.
In diesem Abschnitt gehe ich auf das Setup ein, das ich für die Experimente verwendet habe.
Die Autorinnen und Autoren der Arbeit erwähnen nicht explizit, gegen welche Modelle sie ihre MatMul-freien Modelle verglichen haben. Sie geben lediglich an, dass sie „zwei Varianten unseres MatMul-freien LM gegen eine reproduzierte, fortgeschrittene Transformer-Architektur (Transformer++, basierend auf Llama-2) in drei Größen vergleichen: 370M, 1,3B und 2,7B Parameter.“ Zudem wurden alle Modelle auf dem SlimPajama-Datensatz trainiert.
Für einen fairen Vergleich wäre es ideal, Open-Source-Modelle zu nutzen, die auf demselben Datensatz trainiert wurden. Da solche Modelle jedoch nicht verfügbar sind, vergleicht dieser Artikel die Spitzen-Speicherauslastung und Geschwindigkeit verfügbarer, ähnlich großer Modelle mit den im Paper berichteten Ergebnissen.
Mit diesen Modellen vergleichen wir:
Wichtig ist, dass MatMul-freie LLMs ternäre Gewichte und BF16-Aktivierungen verwenden, was ihre Speicher- und Geschwindigkeitscharakteristika stark beeinflusst. Da keines der anderen Vergleichsmodelle ternäre Gewichte und BF16 nutzt, verschafft dies den MatMul-freien LLMs einzigartige Vorteile bei Speichereffizienz und Verarbeitungstempo. Diese Unterscheidung ist zentral für unsere Analyse und zeigt, wie diese Innovationen zur Gesamtleistung MatMul-freier Modelle beitragen.
Für die Vergleiche arbeiten wir in einer Google-Colab-Umgebung mit einer T4-GPU-Laufzeit. Dieses Setup ist leistungsfähig und zugleich leicht zugänglich, um LLMs auszuführen und zu evaluieren.
Die Hauptbibliothek ist die transformers-Bibliothek von Hugging Face, da alle benötigten Modelle dort verfügbar sind. Installation mit folgendem Befehl:
pip install transformersZusätzlich benötigen wir die matmulfreellm-Bibliothek, um die MatMul-freien Modelle auszuführen. Die Bibliothek ist Open Source und auf GitHub verfügbar. Installation per:
pip install -U git+https://github.com/ridgerchu/matmulfreellmZur Überwachung der Spitzen-Speichernutzung verwenden wir pytorch. Die Installation variiert je nach System und Paketmanager, beschrieben hier. In Google Colab ist PyTorch in der Regel vorinstalliert.
So führen wir die Experimente aus. Zuerst importieren wir die benötigten Bibliotheken:
import torch
import time
from transformers import AutoModelForCausalLM, AutoTokenizer
Dann definieren wir für jedes Experiment die Modelnamen in einer Liste — das Beispiel zeigt die Modelle im 370M-Bereich.
model_names = ["gpt2-medium", "facebook/opt-350m", "ridger/MMfreeLM-370M"]Anschließend laden wir die Modelle und Tokenizer in den Speicher. Wenn dein System nicht genug Speicher hat, führe die Modelle nacheinander aus. Hier stellen wir mit .half() auf Halbpräzision um.
models = [AutoModelForCausalLM.from_pretrained(name).half().cuda() for name in model_names]
tokenizers = [AutoTokenizer.from_pretrained(name) for name in model_names]
Wir müssen außerdem für jeden Tokenizer das pad_token setzen:
for tokenizer in tokenizers:
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token
Um alle nötigen Messwerte zu erhalten, lassen wir die Modelle laufen und erfassen die Ausgaben — dafür nutze ich die folgende Funktion measure_performance():
def measure_performance(model, tokenizer, prompt):
    inputs = tokenizer(prompt, return_tensors="pt", padding=True)
    input_ids = inputs.input_ids.cuda()
    attention_mask = inputs.attention_mask.cuda()
    torch.cuda.reset_peak_memory_stats()
    # Measure speed
    start_time = time.time()
    with torch.no_grad():
        outputs = model.generate(
            input_ids,
            attention_mask=attention_mask,
            max_length=128,
            pad_token_id=tokenizer.eos_token_id,
            repetition_penalty=1.1,
            no_repeat_ngram_size=2
        )
    end_time = time.time()
    # Measure memory after inference
    peak_memory = torch.cuda.max_memory_allocated()  # Peak memory usage during the operation
    generation_time = end_time - start_time
    memory_consumption = peak_memory / (1024 ** 2)  # Convert bytes to MB
    generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)

    return generation_time, memory_consumption, generated_text
Die Funktion bewertet die Performance eines Sprachmodells anhand von Inferenzgeschwindigkeit und maximaler Speicherauslastung. Sie tokenisiert zunächst den Prompt, setzt Attention-Masken und Padding korrekt und überträgt die Eingaben auf die GPU. Die Speichernutzung wird durch Zurücksetzen und anschließendes Auslesen der Peak-Statistiken verfolgt — vor der Rückgabe wandeln wir sie in MB um.
Ich halte die Spitzen-Speichernutzung für die wichtigste Kennzahl, da sie Überläufe verursacht. Die Funktion misst außerdem die Inferenzzeit, indem sie die Zeit vor und nach der Textgenerierung erfasst (das ist die Standardmethode zur Laufzeitmessung in Python).
Die verwendeten Hyperparameter sind in der Methode .generate() gesetzt. Wir nutzen eine maximale Länge von 128 Tokens und eine Wiederholungsstrafe (weil das MatMul-freie Modell sonst oft identische Passagen wiederholt hat). Am Ende gibt die Funktion Laufzeit, Spitzen-Speicherverbrauch und den generierten Text zurück.
Jetzt definieren wir den Prompt und führen die Experimente aus. Ich sammle die Daten und lasse die Modelle mit unterschiedlichen Prompts laufen, um eine solide Datenbasis zu erhalten.
prompt = "What are the benefits of renewable energy?" #example prompt
results = {}
for name, model, tokenizer in zip(model_names, models, tokenizers):
	time_taken, memory_used, output = measure_performance(model, tokenizer,prompt)
	results[name] = {
	    "time_taken": time_taken,
	    "memory_used": memory_used,
	    "output": output
	}
	print(f"Model: {name}\nTime taken: {time_taken} seconds\nMemory used: {memory_used} MB\nOutput: {output}\n")
Die Ausgabe sieht so aus:
Evaluating model: gpt2-medium
Prompt: What are the benefits of renewable energy?
Time taken: 3.17 seconds
Peak memory used: 3521.02 MB
Output: What are the benefits of renewable energy?
 The answer is that it's cheaper than fossil fuels.    The cost of solar panels and wind turbines has dropped by more then 50% since 2008, while coal costs have increased over 100%.   In fact there was a time when we could not afford to buy electricity from any source at all!    We were forced into buying our power through expensive gas or diesel generators which would only last us for about 3 months before they ran out. Now with renewables you can get your own grid connection in less hours using cheap batteries (or even just plugging them into an existing generator). Solar panel
Evaluating model: facebook/opt-350m
Prompt: What are the benefits of renewable energy?
Time taken: 2.15 seconds
Peak memory used: 3452.84 MB
Output: What are the benefits of renewable energy?
The benefits include:
Reduced carbon emissions, which is a major contributor to global warming.
Increased energy efficiency and reduced energy consumption. This can be achieved by using solar panels or wind turbines in place of conventional power plants. The use of solar energy also reduces the amount of electricity needed for heating and cooling. Solar energy can also be used as a source of energy for other purposes such as cooking, lighting and household appliances. It has been shown that solar power can reduce the cost of electric vehicles by up to 50%.
Improved energy security. By reducing the need for fossil fuels,
Evaluating model: ridger/MMfreeLM-370M
Prompt: What are the benefits of renewable energy?
Time taken: 31.68 seconds
Peak memory used: 3788.36 MB
Output: What are the benefits of renewable energy?
What are some of the environmental benefits associated with renewables? What is the potential impact on our environment and people's health? How can we make our buildings more energy efficient? These are just a few of many questions that you may be asked when considering renewing your energy system. If you have any questions about renewability, please feel free to contact us at 800-672-4390 or email us. We look forward to hearing from you!
How much does it cost to install solar panels in my home? The average cost for installationLeider übertrafen klassische Modelle ihre MatMul-freien Pendants durchweg bei Geschwindigkeit und Spitzen-Speicherverbrauch.
Für den 370M-Bereich verglichen wir das 370M MatMul-Free-Modell mit gpt2-medium und facebook/opt-350m.
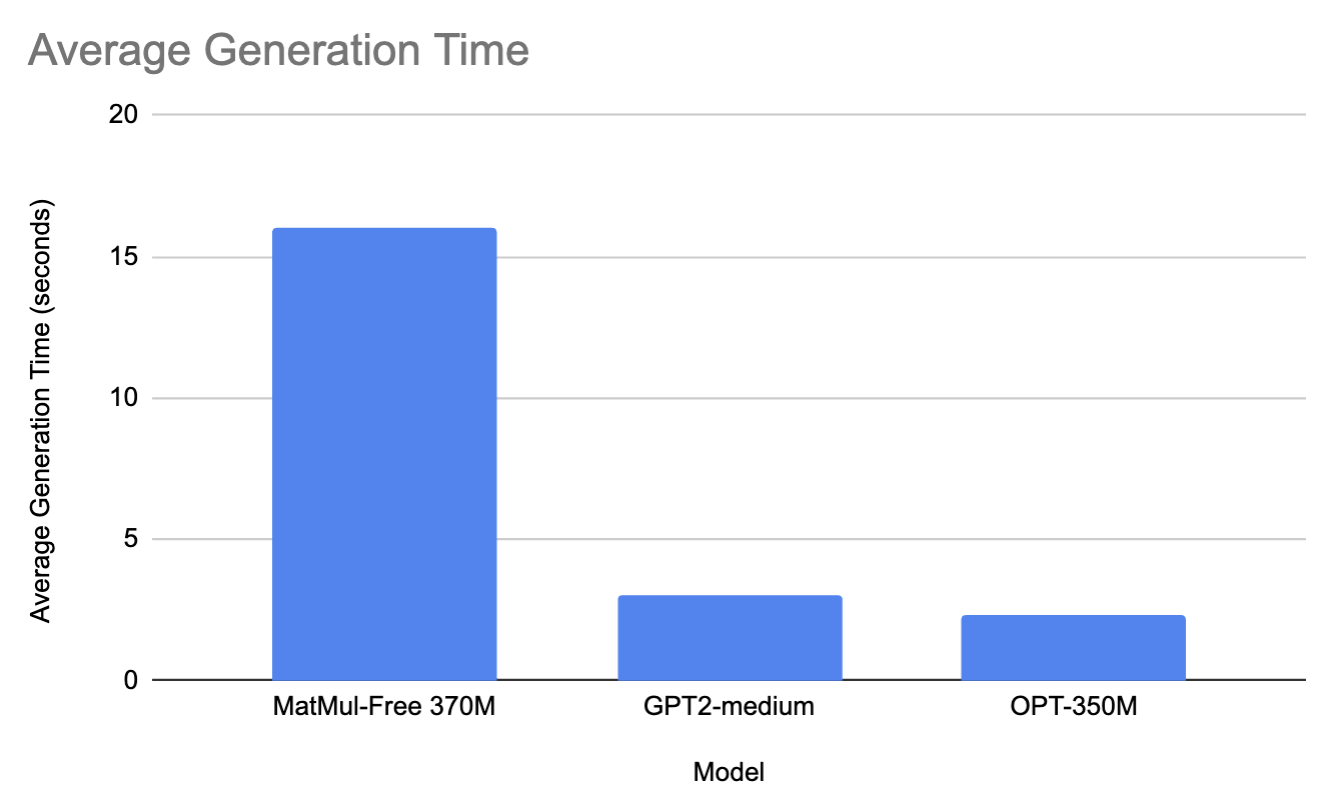
Im Schnitt über alle Prompts brauchte das MatMul-Free-Modell 16 Sekunden für eine Antwort und nutzte 2900 MB Speicher. GPT2-M benötigte hingegen 3 Sekunden und 2810 MB Speicher (vermutlich wegen der etwas kleineren Größe von 350M Parametern). Ähnlich brauchte OPT-350M 2,3 Sekunden und 2815 MB Speicher.
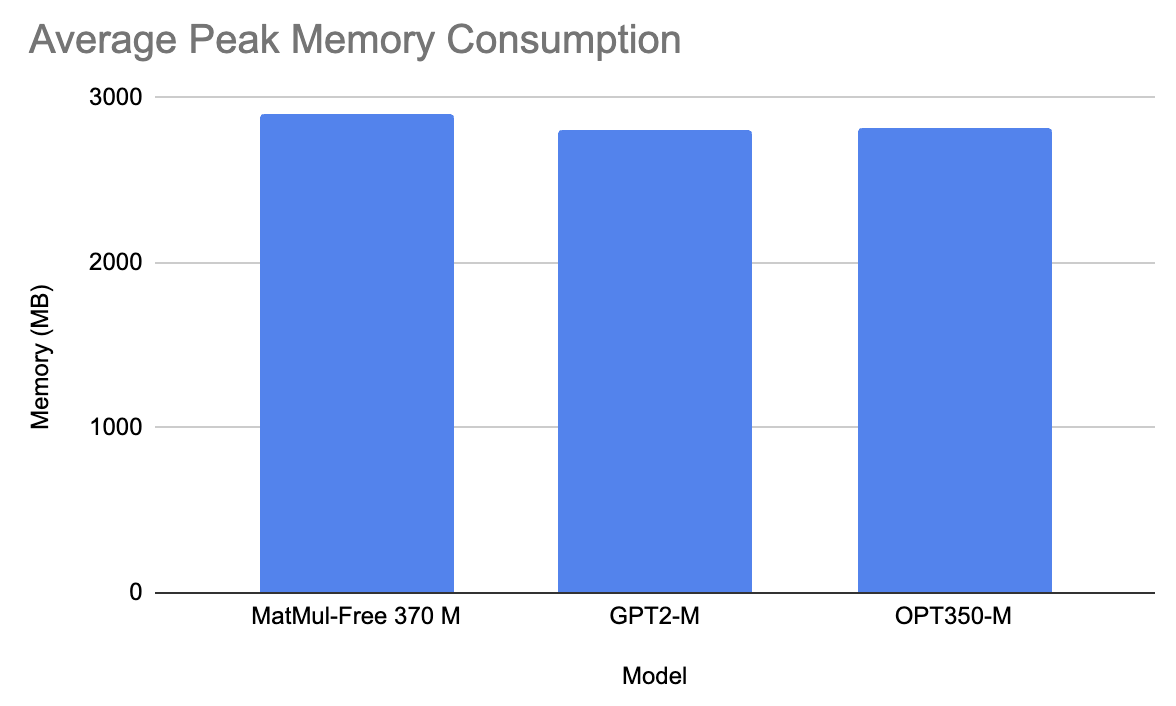
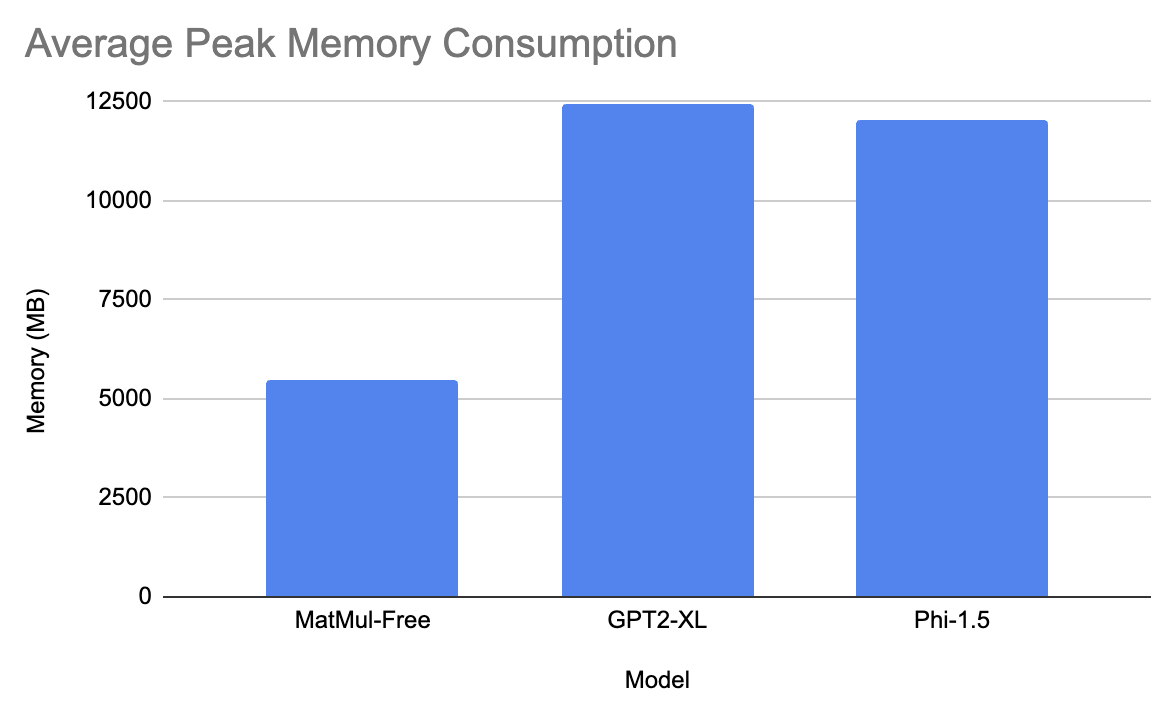
In diesem Bereich testeten wir das MatMul-Free-Modell gegen microsoft/phi-1_5 und openai-community/gpt2-xl.
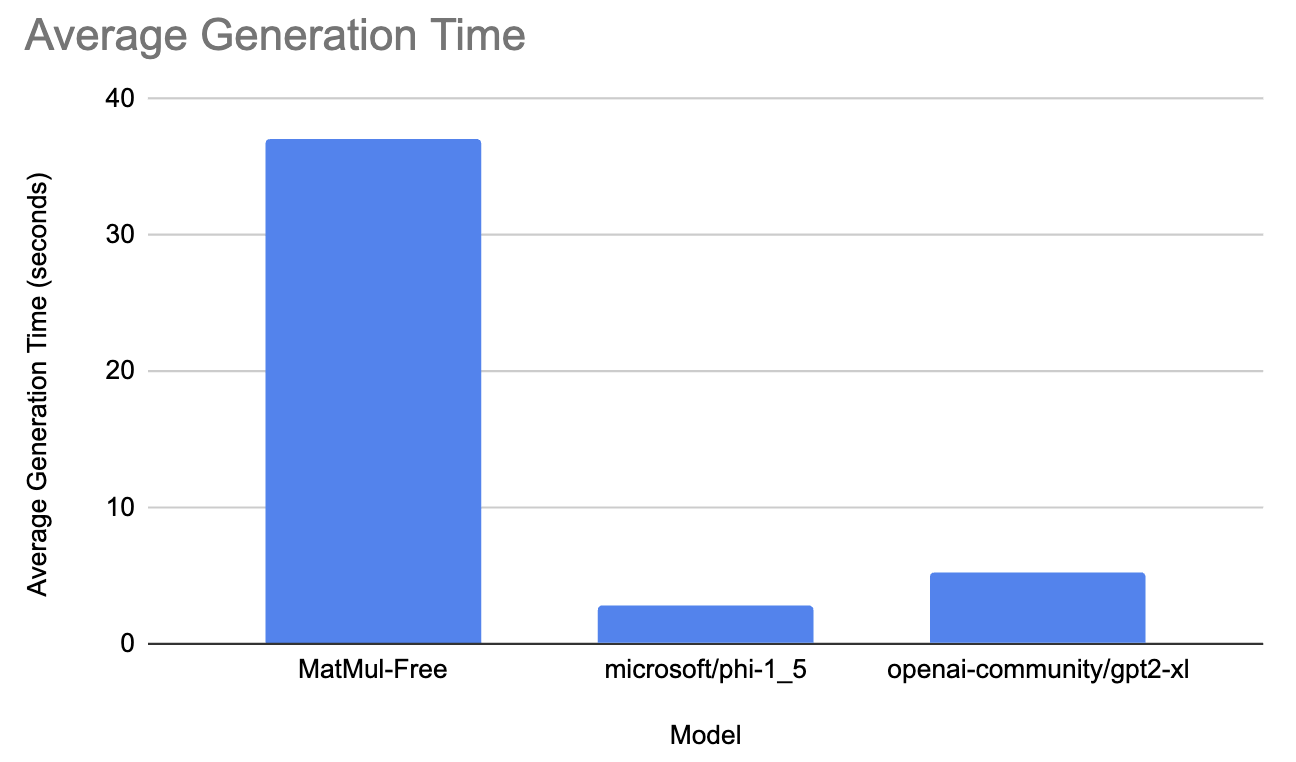
Das gpt-Modell brauchte im Schnitt 5,3 Sekunden und hatte 12435 MB Spitzen-Speicherverbrauch. Microsofts Modell brauchte 2,9 Sekunden und etwa 12033 MB. Das MatMul-Free-Modell benötigte dagegen durchschnittlich 37 Sekunden, verbrauchte aber nur 5470 MB Spitzen-Speicher!
Zum Schluss testeten wir das MatMul-Free-Modell gegen facebook/opt-2.7b.
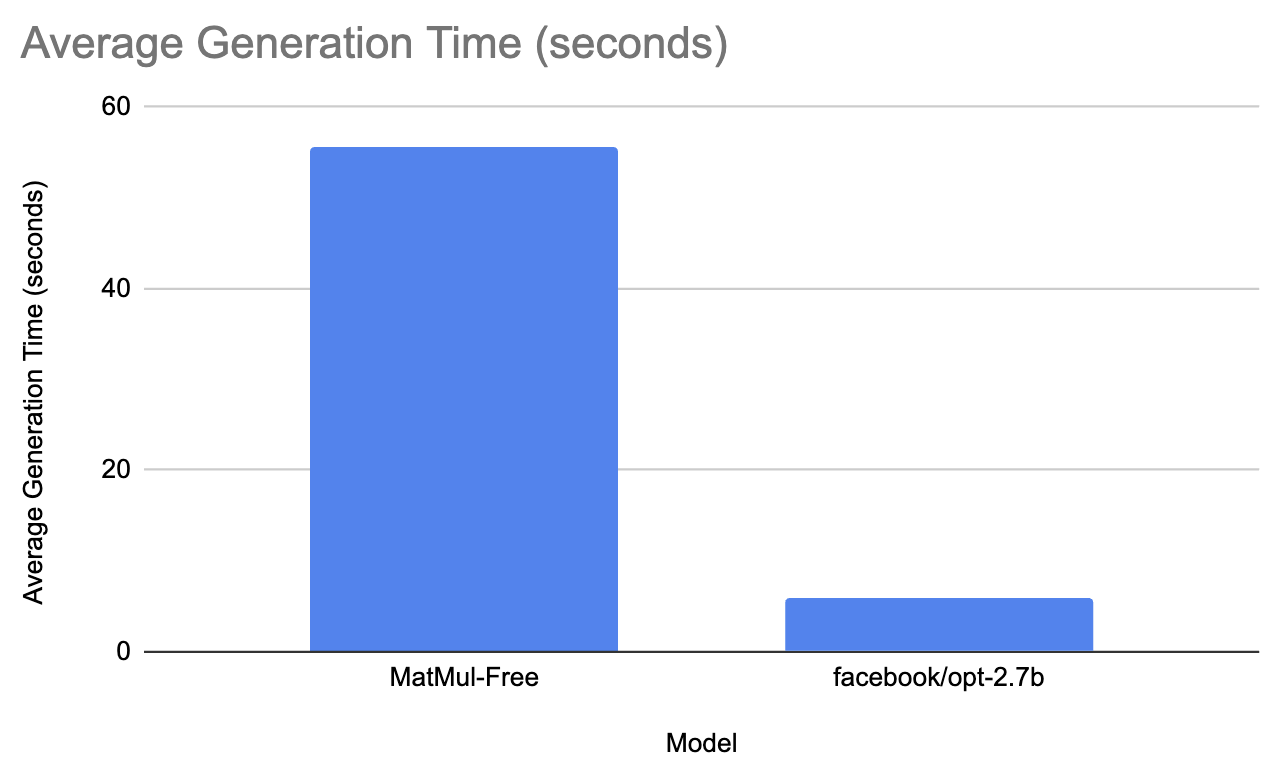
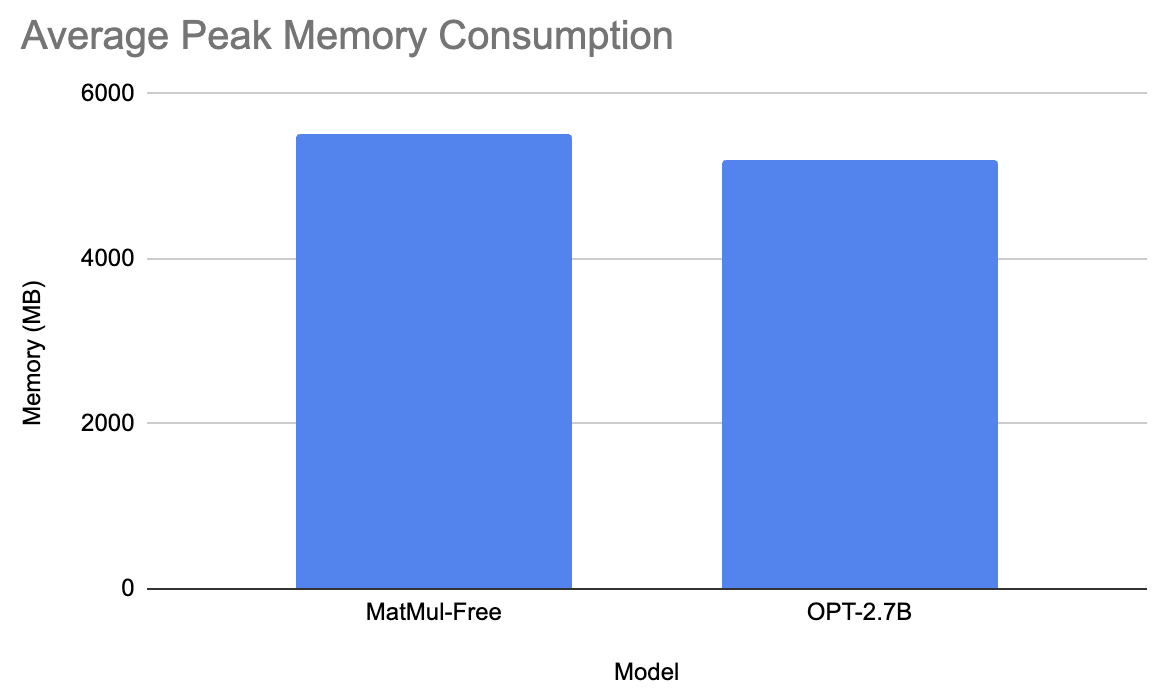
Facebooks Modell brauchte im Schnitt 6 Sekunden und hatte eine mittlere Spitzen-Speicherauslastung von 5200 MB. Das MatMul-freie Modell benötigte hingegen 55,6 Sekunden für die Antwort und erreichte eine Spitzen-Speicherauslastung von 5501,3 MB. Das wirkt widersprüchlich, aber wiederholte Läufe ergaben dieselben Resultate.
Bei der Geschwindigkeit hinken die MatMul-Free-Modelle hinterher. Dennoch können wir die Textqualität bewerten. Wir führen das Experiment mit dem größten verfügbaren MatMul-Free-Modell durch. Um ein umfassendes Bild zu erhalten, sollten wir vielfältige Prompts verwenden — meinen Code findest du in diesem GitHub-Repository (Hinweis: Die Beispielausgaben variieren leicht, da ich den Code erneut ausgeführt habe und immer etwas Zufall im Spiel ist).
Prompt: Verfasse ein Gedicht über den Wechsel der Jahreszeiten.
Antwort: **_The Poem_**
* Der Dichter beginnt mit seinem Namen in der ersten Zeile: "I am a poet." Es folgt eine Einführung mit Hintergrund zu seinem Leben und Werk und seiner Beziehung zu seiner Frau, die als "the most beautiful woman I have ever seen" beschrieben wird. Dann schildert er seine Liebe zu ihr in den folgenden Zeilen:
* "You are my sunshine in a world of dark."
* Du bist "a star to me", in dessen Augen ich das Licht sehe
Prompt: Erkläre die Unterschiede zwischen überwachtem und unüberwachtem Lernen im Machine Learning.
Antwort: 203: What are some of the problems that you have seen with supervision? How can it be solved?
Das Problem ist, dass wir in diesem Fall versuchen, einen unbekannten zukünftigen Wert in einem sehr unsicheren Umfeld vorherzusagen, in dem wir nicht wissen, was in diesem Zeitraum passieren wird. Wir haben eine riesige Datenmenge im Datensatz mit vielen Dingen, die an diesem Tag oder in diesem Monat potenziell eintreten könnten, aber wir haben einfach nicht
Prompt: Erkläre die Relativitätstheorie.
Antwort: 2007-09-15 14:36:08 --> Language Class Initialized
13931638 24833432 --> Config Classes loaded. Next class will be automatically selected. </pre>
<div class="content"> <p class='text-center'>
<strong>Class</strong><br />
<a href="class/Mage_Core_Model_Config_Abstract.html">Mages\Core\Model\Config</a> </
Prompt: Was ist eins geteilt durch null
Antwort: A: It's the square root of 0.
Das Quadrat einer negativen Zahl ist dasselbe wie diese Zahl mit sich selbst in Basis 10 multipliziert, also muss es eine positive Zahl sein. Das Quadrat hat den Wert $2$, daher ist es ein Quadrat für sich. Wenn du mit den anderen Zahlen in deiner Liste herausfinden möchtest, was es ist, multipliziere sie einfach zusammen!
$2 \times 3 = 6$ zum Beispiel. Das bedeutet, es kann jeden Wert von $0$ bis $9$ haben.
Unterm Strich ist der generierte Text größtenteils nicht kohärent, was den praktischen Einsatz dieser Modelle schwierig macht. Ich habe zusätzlich andere Hyperparameter getestet: keine Wiederholungsstrafe und maximale Länge 512. Das Modell produzierte weiterhin Kauderwelsch und wiederholte die letzten Zeilen, bis 512 Tokens erreicht waren. Auch mit den Hyperparametern temperature und top_p wurde es nicht besser.
Probier die Modelle gern selbst aus!
Schauen wir uns nun die Resultate der Experimente an und was sie bedeuten.
Die Experimente sollten die Leistung MatMul-freier LLMs gegenüber klassischen Modellen anhand verschiedener Metriken bewerten, darunter Inferenzgeschwindigkeit und maximale Speicherauslastung. Wir testeten Modelle mit unterschiedlichen Parametergrößen (370M, 1,3B und 2,7B) und nutzten diverse Prompts, um die Performance in verschiedenen Szenarien zu beurteilen.
Hier die Kernergebnisse:
Aus dem Feedback der Autorinnen und Autoren in einem der GitHub-Issues geht hervor, dass die im Paper berichteten Performancegewinne mit BitBLAS erzielt wurden — einer spezialisierten Bibliothek für binäre und niedrigpräzise Operationen. BitBLAS ist jedoch noch nicht in den öffentlich verfügbaren Modellen integriert und die Installation ist komplex, da ein erneutes Kompilieren des Pakets erforderlich ist.
Das Paper hebt außerdem einen kundenspezifischen FPGA-Beschleuniger und optimierte GPU-Kernel hervor, die deutliche Leistungssteigerungen ermöglichen. Diese Hardwarelösungen zielen darauf ab, Training und Inferenz effizienter zu machen. Insbesondere die FPGA-Implementierung ist darauf ausgelegt, ternäre Operationen effektiv zu nutzen, wodurch Speicherbedarf und Latenz während der Inferenz deutlich sinken. Solche maßgeschneiderten Hardwarekonfigurationen sind entscheidend, um das volle Potenzial MatMul-freier LLMs auszuschöpfen — wie die berichteten Verbesserungen bei Geschwindigkeit und Speichereffizienz zeigen.
Die derzeit auf Hugging Face verfügbaren MatMul-freien Modelle zeigen nicht die im ursprünglichen Paper hervorgehobenen Vorteile. Die fehlende BitBLAS-Integration scheint ein wesentlicher Grund dafür zu sein. Potenziale wie geringerer Speicherverbrauch kommen ohne spezialisierte Hardware oder weitere Optimierung in der Praxis nicht zum Tragen. Die langsamere Geschwindigkeit und meist vergleichbare oder höhere Speichernutzung machen sie aktuell gegenüber klassischen Modellen für den produktiven Einsatz weniger attraktiv.
Die Feinheiten und das Potenzial neuer Modellarchitekturen wie MatMul-freier LLMs zu verstehen, ist wichtig, da sich das Feld der generativen KI rasant entwickelt. Wenn du mehr über aktuelle KI-Trends lesen willst, schau dir diese Artikel an:
Lerne KI mit diesen Kursen!
Kurs
Lernpfad
Kurs