
Last chance! 50% off DataCamp Premium
Sale ends in
बड़े भाषा मॉडल (LLMs) अपने संचालन के लिए मैट्रिक्स गुणा (MatMul) पर काफी निर्भर होते हैं, जिसके कारण उच्च संगणनात्मक और पीक मेमोरी आवश्यकताएँ पैदा होती हैं। हालांकि, हालिया पेपर में, MatMul-रहित LLMs का एक नया रूप सामने आया है, जो संभावित रूप से संसाधन उपयोग में कमी के साथ तुलनीय प्रदर्शन का वादा करता है।
इस लेख में, मैं MatMul-रहित LLMs की उनके पारंपरिक समकक्षों से तुलना करूँगा। मैं 370M, 1.3B, और 2.7B पैरामीटर वाले तीन अलग-अलग मॉडल आकारों में उनकी जनरेटिव क्षमता और संसाधन खपत की जाँच करूँगा। मेरा विश्लेषण मॉडलों की गति और पीक मेमोरी खपत को कवर करेगा, और आधुनिक NLP में MatMul-रहित आर्किटेक्चर के संभावित लाभों को उजागर करेगा।
MatMul-रहित LLMs के बारे में और जानने के लिए, यह लेख पढ़ें: MatMul-रहित LLMs: प्रमुख अवधारणाएँ समझाई गईं.
इस खंड में मैं उन सेटअप की चर्चा करूँगा जिनका उपयोग प्रयोग करने के लिए किया गया।
पेपर के लेखकों ने स्पष्ट रूप से यह नहीं बताया कि उन्होंने अपने MatMul-रहित मॉडलों की तुलना किन मॉडलों से की। उन्होंने केवल इतना कहा है कि वे “हमारे MatMul-रहित LM के दो वेरिएंट्स की तुलना पुनरुत्पादित उन्नत ट्रांसफॉर्मर आर्किटेक्चर (Transformer++, Llama-2 पर आधारित) से तीन मॉडल आकारों में करते हैं: 370M, 1.3B, और 2.7B पैरामीटर।” अतिरिक्त रूप से, सभी मॉडलों को SlimPajama डेटासेट पर प्रशिक्षित किया गया था।
निष्पक्ष तुलना सुनिश्चित करने के लिए आदर्श रूप से उसी डेटासेट पर प्रशिक्षित ओपन-सोर्स मॉडल का उपयोग करना चाहिए। हालांकि, ऐसे मॉडलों की अनुपलब्धता के कारण, यह लेख समान आकार के उपलब्ध मॉडलों की पीक मेमोरी खपत और गति की तुलना पेपर में प्रस्तुत निष्कर्षों से करता है।
हम जिन मॉडलों से तुलना करेंगे, वे ये हैं:
यह नोट करना महत्वपूर्ण है कि MatMul-रहित LLMs टर्नरी वेट्स और BF16 एक्टिवेशन्स का उपयोग करते हैं, जो उनकी मेमोरी और गति की विशेषताओं पर महत्वपूर्ण प्रभाव डालते हैं। चूँकि हमारी तुलना सूची में अन्य कोई मॉडल टर्नरी वेट्स और BF16 एक्टिवेशन्स का उपयोग नहीं करता, ये फीचर्स मेमोरी दक्षता और प्रसंस्करण गति के संदर्भ में MatMul-रहित LLMs को विशिष्ट लाभ देते हैं। यह भेद हमारे तुलनात्मक विश्लेषण में अहम होगा, यह दिखाते हुए कि ये नवाचार MatMul-रहित मॉडलों के समग्र प्रदर्शन में कैसे योगदान करते हैं।
तुलनाएँ करने के लिए हम Google Colab वातावरण में T4 GPU रनटाइम के साथ काम करेंगे। यह सेटअप बड़े भाषा मॉडलों को चलाने और मूल्यांकन करने के लिए एक शक्तिशाली और सुलभ प्लेटफ़ॉर्म प्रदान करता है।
मुख्य लाइब्रेरी जिसका हम उपयोग करेंगे वह huggingface की transformers लाइब्रेरी है, क्योंकि हमें जिन सभी मॉडलों की ज़रूरत है, वे वहीं उपलब्ध हैं। इसे हम निम्न कमांड से इंस्टॉल कर सकते हैं:
pip install transformersहमें अपने MatMul-रहित मॉडलों को चलाने के लिए matmulfreellm लाइब्रेरी भी इंस्टॉल करनी होगी। यह लाइब्रेरी ओपन सोर्स है और GitHub पर उपलब्ध है, इसे हम चलाकर इंस्टॉल कर सकते हैं:
pip install -U git+https://github.com/ridgerchu/matmulfreellmपीक मेमोरी उपयोग की निगरानी के लिए हम pytorch का उपयोग करेंगे, जिसे आपके सिस्टम और पैकेज मैनेजर के अनुसार अलग-अलग कमांड से इंस्टॉल किया जा सकता है, जैसा कि यहाँ वर्णित है। यदि आप Google Colab में काम कर रहे हैं, तो यह पहले से इंस्टॉल होगा।
यहाँ बताया गया है कि हम प्रयोग कैसे चलाते हैं। पहले, हमें आवश्यक लाइब्रेरीज़ इम्पोर्ट करनी होंगी:
import torch
import time
from transformers import AutoModelForCausalLM, AutoTokenizer
फिर, प्रत्येक प्रयोग के लिए, हम मॉडल के नामों को एक सूची में परिभाषित करते हैं—दिया गया उदाहरण 370M पैरामीटर रेंज के मॉडलों के लिए है।
model_names = ["gpt2-medium", "facebook/opt-350m", "ridger/MMfreeLM-370M"]फिर, हम मॉडलों और टोकनाइज़र को मेमोरी में लोड करते हैं। यदि आपके सिस्टम में पर्याप्त मेमोरी नहीं है, तो आप प्रत्येक मॉडल के लिए प्रयोग अलग-अलग चला सकते हैं। यहाँ, हम .half() मेथड का उपयोग करके हाफ-प्रिसिशन फ्लोट्स का उपयोग सुनिश्चित करते हैं।
models = [AutoModelForCausalLM.from_pretrained(name).half().cuda() for name in model_names]
tokenizers = [AutoTokenizer.from_pretrained(name) for name in model_names]
हमें प्रत्येक टोकनाइज़र के लिए pad_token भी सेट करना होगा:
for tokenizer in tokenizers:
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token
सभी आवश्यक प्रेक्षण करने के लिए, मॉडलों को चलाएँ और आउटपुट प्राप्त करें—मैं निम्न measure_performance() फ़ंक्शन का उपयोग करूँगा:
def measure_performance(model, tokenizer, prompt):
    inputs = tokenizer(prompt, return_tensors="pt", padding=True)
    input_ids = inputs.input_ids.cuda()
    attention_mask = inputs.attention_mask.cuda()
    torch.cuda.reset_peak_memory_stats()
    # Measure speed
    start_time = time.time()
    with torch.no_grad():
        outputs = model.generate(
            input_ids,
            attention_mask=attention_mask,
            max_length=128,
            pad_token_id=tokenizer.eos_token_id,
            repetition_penalty=1.1,
            no_repeat_ngram_size=2
        )
    end_time = time.time()
    # Measure memory after inference
    peak_memory = torch.cuda.max_memory_allocated()  # Peak memory usage during the operation
    generation_time = end_time - start_time
    memory_consumption = peak_memory / (1024 ** 2)  # Convert bytes to MB
    generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)

    return generation_time, memory_consumption, generated_text
यह फ़ंक्शन इन्फरेंस गति और पीक मेमोरी खपत को मापकर एक भाषा मॉडल के प्रदर्शन का मूल्यांकन करता है। यह पहले इनपुट प्रॉम्प्ट को टोकनाइज़ करता है, उपयुक्त अटेंशन मास्क और पैडिंग सुनिश्चित करता है, और इनपुट्स को GPU पर ट्रांसफ़र करता है। मेमोरी उपयोग को पहले रीसेट करके और फिर पीक मेमोरी आँकड़े रिकॉर्ड करके ट्रैक किया जाता है—वापस करने से पहले हम इसे MB में बदलते हैं।
मेरे विचार में पीक मेमोरी उपयोग सबसे महत्वपूर्ण आँकड़ा है क्योंकि यही ओवरफ़्लो का कारण बनता है। फ़ंक्शन इन्फरेंस गति को भी मापता है, टेक्स्ट जनरेशन से पहले और बाद का समय रिकॉर्ड करके (Python में रनिंग टाइम मापने का यह मानक तरीका है)।
जनरेशन के लिए हम जिन हाइपरपैरामीटर्स का उपयोग करते हैं, वे .generate() मेथड में सेट होते हैं। हम 128-टोकन अधिकतम लंबाई और रिपेटिशन पेनल्टी का उपयोग करते हैं (यह इसलिए किया गया क्योंकि MatMul-रहित मॉडल कई बार एक ही उत्तर जनरेट करता दिखा)। अंत में, फ़ंक्शन समय, पीक मेमोरी खपत, और जनरेटेड टेक्स्ट लौटाता है।
अब, हम प्रॉम्प्ट परिभाषित कर सकते हैं और प्रयोग चला सकते हैं। मैं डेटा एकत्र करूँगा और अलग-अलग प्रॉम्प्ट्स पर मॉडल चलाकर डेटा जुटाऊँगा।
prompt = "What are the benefits of renewable energy?" #example prompt
results = {}
for name, model, tokenizer in zip(model_names, models, tokenizers):
	time_taken, memory_used, output = measure_performance(model, tokenizer,prompt)
	results[name] = {
	    "time_taken": time_taken,
	    "memory_used": memory_used,
	    "output": output
	}
	print(f"Model: {name}\nTime taken: {time_taken} seconds\nMemory used: {memory_used} MB\nOutput: {output}\n")
आउटपुट कुछ इस प्रकार दिखता है:
Evaluating model: gpt2-medium
Prompt: What are the benefits of renewable energy?
Time taken: 3.17 seconds
Peak memory used: 3521.02 MB
Output: What are the benefits of renewable energy?
 The answer is that it's cheaper than fossil fuels.    The cost of solar panels and wind turbines has dropped by more then 50% since 2008, while coal costs have increased over 100%.   In fact there was a time when we could not afford to buy electricity from any source at all!    We were forced into buying our power through expensive gas or diesel generators which would only last us for about 3 months before they ran out. Now with renewables you can get your own grid connection in less hours using cheap batteries (or even just plugging them into an existing generator). Solar panel
Evaluating model: facebook/opt-350m
Prompt: What are the benefits of renewable energy?
Time taken: 2.15 seconds
Peak memory used: 3452.84 MB
Output: What are the benefits of renewable energy?
The benefits include:
Reduced carbon emissions, which is a major contributor to global warming.
Increased energy efficiency and reduced energy consumption. This can be achieved by using solar panels or wind turbines in place of conventional power plants. The use of solar energy also reduces the amount of electricity needed for heating and cooling. Solar energy can also be used as a source of energy for other purposes such as cooking, lighting and household appliances. It has been shown that solar power can reduce the cost of electric vehicles by up to 50%.
Improved energy security. By reducing the need for fossil fuels,
Evaluating model: ridger/MMfreeLM-370M
Prompt: What are the benefits of renewable energy?
Time taken: 31.68 seconds
Peak memory used: 3788.36 MB
Output: What are the benefits of renewable energy?
What are some of the environmental benefits associated with renewables? What is the potential impact on our environment and people's health? How can we make our buildings more energy efficient? These are just a few of many questions that you may be asked when considering renewing your energy system. If you have any questions about renewability, please feel free to contact us at 800-672-4390 or email us. We look forward to hearing from you!
How much does it cost to install solar panels in my home? The average cost for installationदुर्भाग्य से, पारंपरिक मॉडलों ने गति और पीक मेमोरी उपयोग दोनों में अपने MatMul-रहित समकक्षों को लगातार पीछे छोड़ा।
370M रेंज के लिए, हमने 370M MatMul-रहित मॉडल की gpt2-medium और facebook/opt-350m से तुलना की।
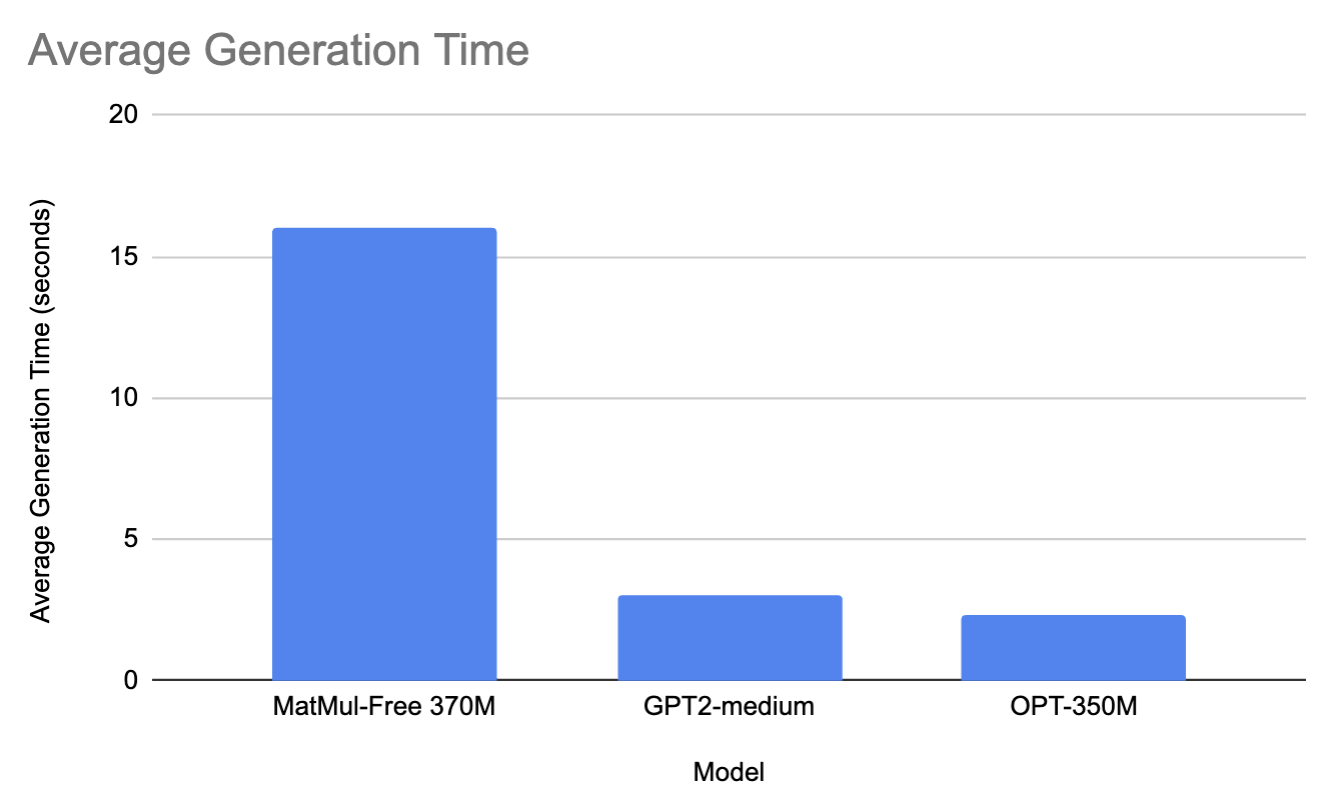
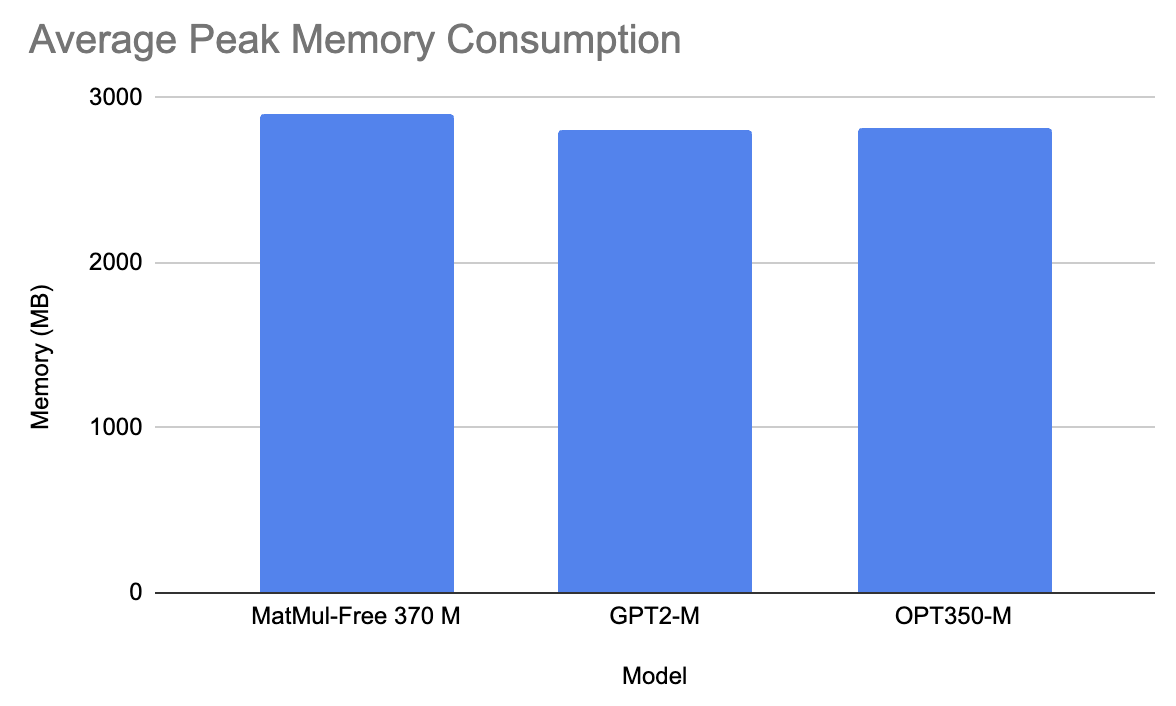
औसतन, सभी प्रॉम्प्ट्स में MatMul-रहित मॉडल को उत्तर जनरेट करने में 16 सेकंड लगे और 2900 MB मेमोरी का उपयोग हुआ। दूसरी ओर, GPT2-M को प्रॉम्प्ट जनरेट करने में 3 सेकंड लगे और 2810 MB मेमोरी उपयोग हुई (संभवतः आकार के अंतर के कारण, GPT2-M 350M पैरामीटर्स का है)। इसी तरह, OPT350-M को उत्तर जनरेट करने में 2.3 सेकंड लगे और 2815 MB मेमोरी उपयोग हुई।
इस रेंज में, हमने MatMul-रहित मॉडल की microsoft/phi-1_5 और openai-community/gpt2-xl से तुलना की।
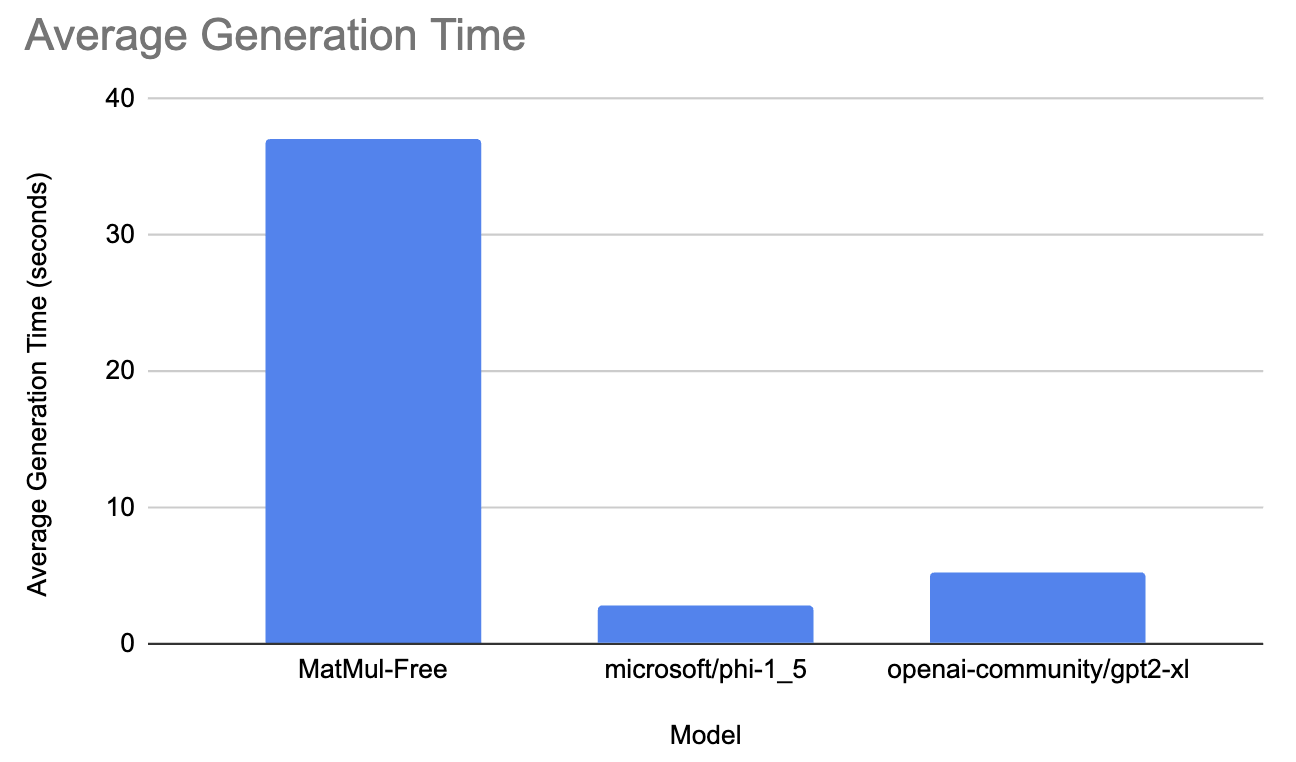
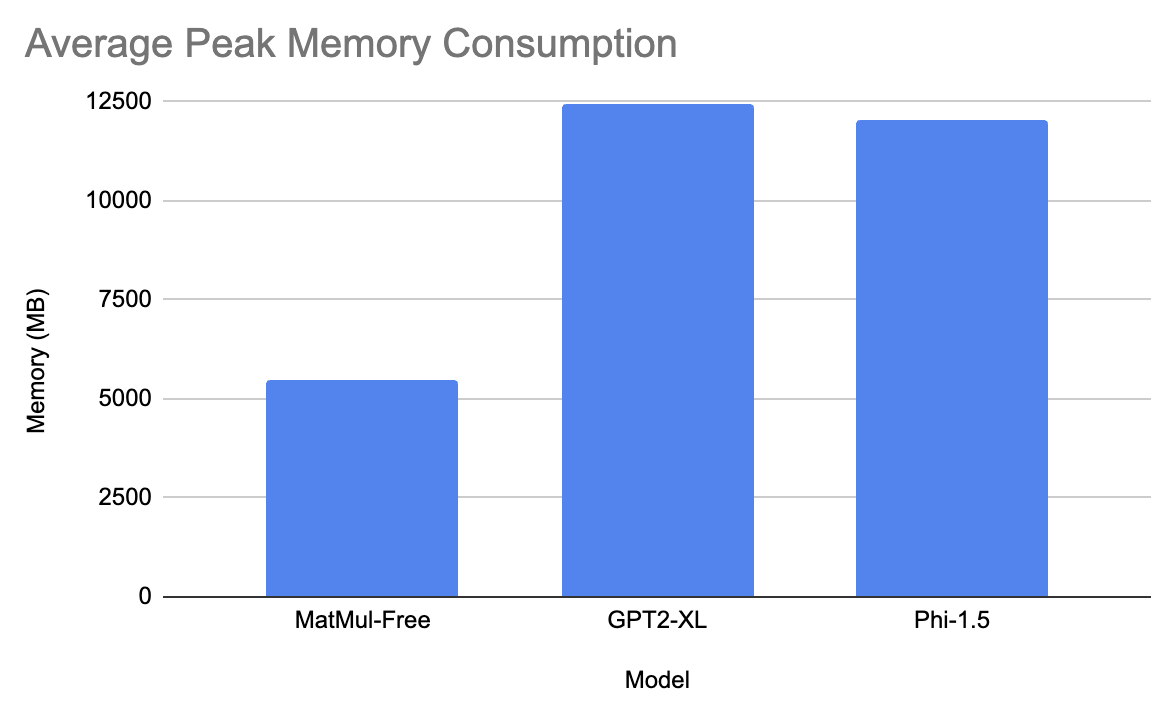
gpt मॉडल को औसतन उत्तर जनरेट करने में 5.3 सेकंड लगे और 12435 MB की पीक मेमोरी खपत रही। Microsoft के मॉडल को उत्तर जनरेट करने में 2.9 सेकंड लगे और लगभग 12033 MB की पीक मेमोरी खपत रही। अंततः, MatMul-रहित मॉडल को औसतन 37 सेकंड लगे और इसकी पीक मेमोरी खपत 5470MB रही!
अंतिम तुलना के लिए, हमने MatMul-रहित मॉडल की facebook/opt-2.7b से तुलना की।
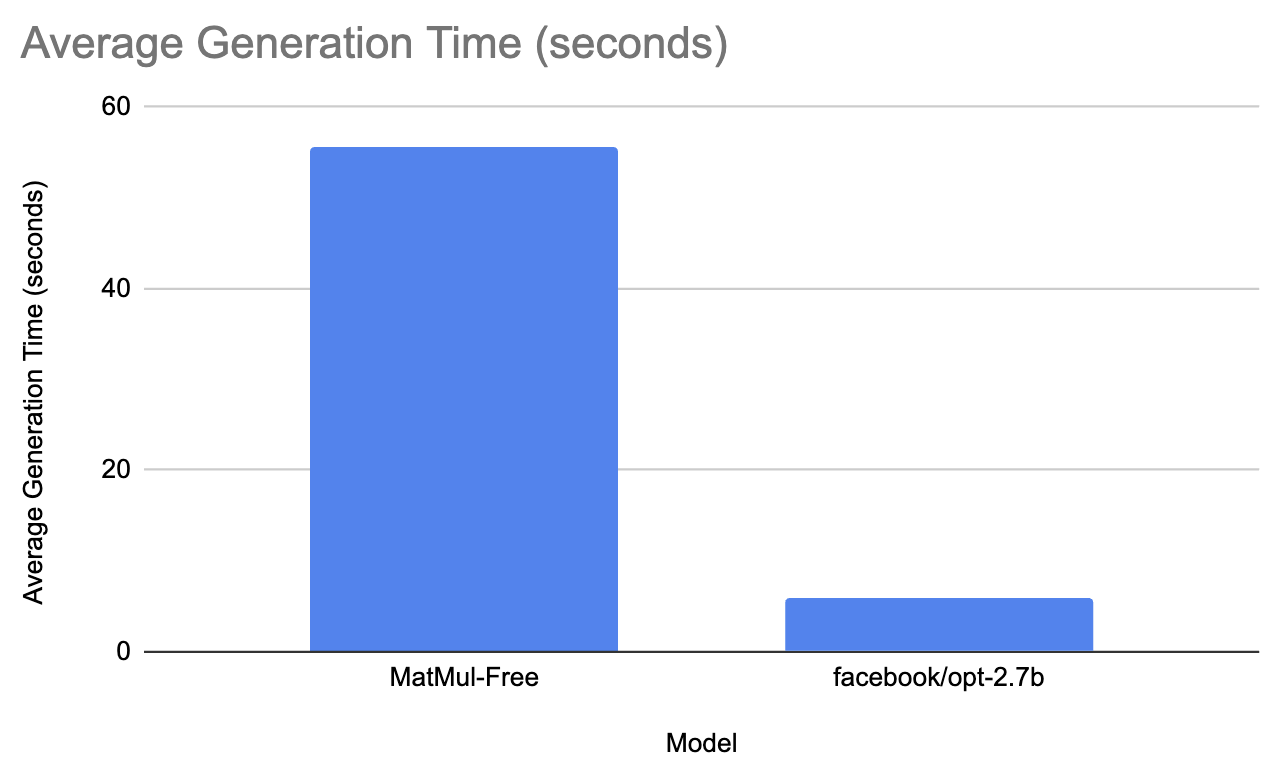
Facebook के मॉडल को औसतन उत्तर जनरेट करने में 6 सेकंड लगे और औसत पीक मेमोरी खपत 5200 MB रही। दूसरी ओर MatMul-रहित मॉडल को प्रॉम्प्ट जनरेट करने में 55.6 सेकंड लगे और पीक मेमोरी खपत 5501.3 MB रही। यह बहुत समझ में नहीं आता, लेकिन मैंने प्रयोग कुछ बार दोहराया और परिणाम समान रहे।
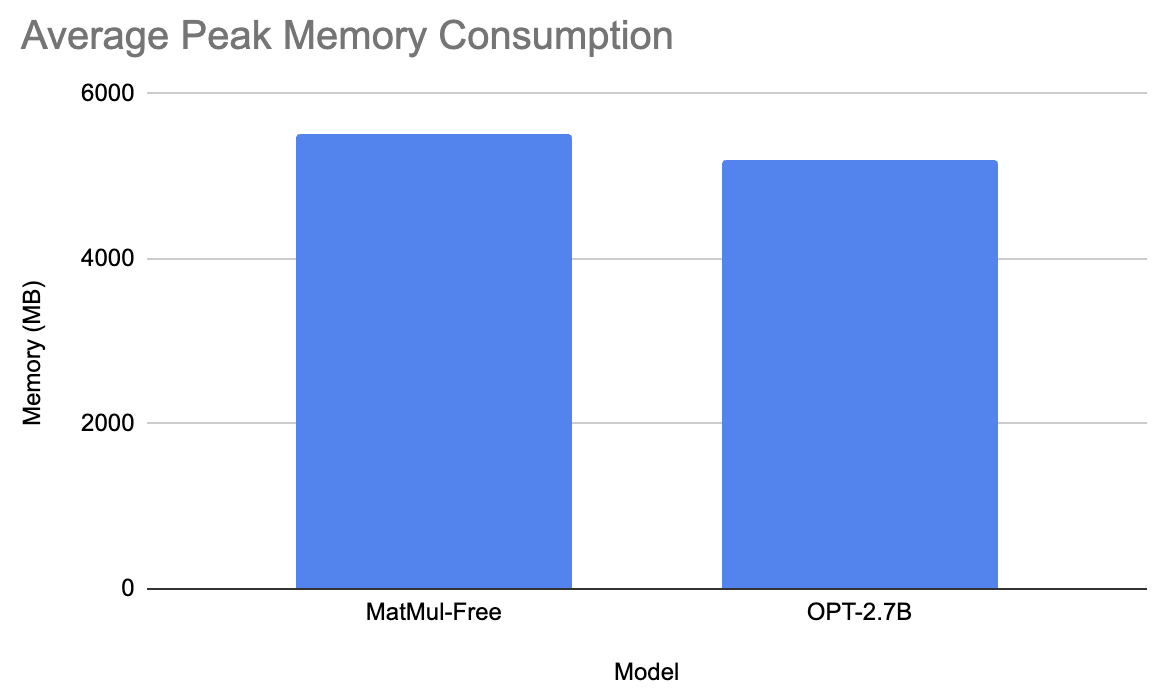
गति के लिहाज़ से MatMul-रहित मॉडल पीछे रहे। फिर भी, हम उनके द्वारा जनरेट किए गए टेक्स्ट की गुणवत्ता का मूल्यांकन कर सकते हैं। हम यह प्रयोग उपलब्ध सबसे बड़े MatMul-रहित मॉडल पर चलाएँगे। जनरेटेड टेक्स्ट की गुणवत्ता को समग्र रूप से समझने के लिए, हमें विविध प्रॉम्प्ट्स का सेट उपयोग करना चाहिए—मेरा कोड इस GitHub रिपॉज़िटरी में देखें (ध्यान दें कि प्रॉम्प्ट-रेस्पॉन्स उदाहरण थोड़े अलग हैं क्योंकि मैंने कोड फिर से चलाया और हमेशा कुछ रैंडमनेस होती है)।
प्रॉम्प्ट: बदलते मौसमों पर एक कविता लिखिए।
उत्तर: **_The Poem_**
* कवि इस शुरुआती पंक्ति में अपना नाम देकर शुरू करता है: "I am a poet." इसके बाद एक परिचय आता है जो उसके जीवन और कार्य के बारे में कुछ पृष्ठभूमि जानकारी देता है, साथ ही उसकी पत्नी के साथ उसके संबंध के बारे में भी, जिसे "the most beautiful woman I have ever seen" कहा गया है। फिर वह निम्न पंक्तियों में उसके प्रति अपने प्रेम का वर्णन करता है:
* "You are my sunshine in a world of dark."
* आप "a star to me," हैं, जिसकी आँखों में मैं रोशनी देखता हूँ
प्रॉम्प्ट: मशीन लर्निंग में सुपरवाइज़्ड और अनसुपरवाइज़्ड लर्निंग में अंतर समझाइए।
उत्तर: 203: निगरानी (supervision) के साथ आपने कौन-सी समस्याएँ देखी हैं? इसे कैसे हल किया जा सकता है?
समस्या यह है कि हम एक अज्ञात मान के लिए भविष्यवाणी करने की कोशिश कर रहे हैं, जो भविष्य में एक अत्यंत अनिश्चित वातावरण में है जहाँ हमें नहीं पता कि उस भविष्य अवधि में क्या होगा। हमारे डेटासेट में बहुत-सी अलग-अलग चीज़ों के संदर्भ में बहुत अधिक डेटा है जो किसी विशेष दिन या विशेष माह में संभावित रूप से हो सकता है, लेकिन हमारे पास बस इतना नहीं है
प्रॉम्प्ट: सापेक्षता के सिद्धांत की व्याख्या कीजिए।
उत्तर: 2007-09-15 14:36:08 --> Language Class Initialized
13931638 24833432 --> Config Classes loaded. Next class will be automatically selected. </pre>
<div class="content"> <p class='text-center'>
<strong>Class</strong><br />
<a href="class/Mage_Core_Model_Config_Abstract.html">Mages\Core\Model\Config</a> </
प्रॉम्प्ट: एक को शून्य से विभाजित करने पर क्या होता है
उत्तर: A: यह 0 का वर्गमूल है।
ऋणात्मक संख्या का वर्ग उसी संख्या के आधार 10 में स्वयं से गुणा के बराबर होता है, इसलिए यह एक धनात्मक संख्या होना चाहिए। वर्ग का मान $2$ है, अतः यह अपने आप में एक वर्ग है। यदि आप जानना चाहते हैं कि यह आपकी अन्य संख्याओं के साथ क्या है, तो बस उन्हें एक साथ गुणा करें!
उदाहरण के लिए, $2 \times 3 = 6$। इसका अर्थ है कि यह $0$ से $9$ तक कोई भी मान ले सकता है।
कुल मिलाकर, जनरेटेड टेक्स्ट अधिकतर मामलों में सुसंगत नहीं है, जिससे इन मॉडलों का उपयोग अव्यावहारिक हो जाता है। मैंने अलग-अलग हाइपरपैरामीटर्स भी जाँचे: बिना रिपेटिशन पेनल्टी और 512 अधिकतम लंबाई। यहाँ भी, मॉडल ने बेतुका पाठ उत्पन्न किया; साथ ही, उसने उत्तर की अंतिम पंक्तियों को दोहराया जब तक कि 512 टोकन पूरे न हो गए। मैंने temperature और top_p हाइपरपैरामीटर्स के साथ भी प्रॉम्प्ट्स का परीक्षण किया, और परिणाम बेहतर नहीं थे।
आप इन मॉडलों के साथ स्वयं भी प्रयोग कर सकते हैं!
अब आइए प्रयोगों के परिणामों की समीक्षा करें और उनके निहितार्थों पर चर्चा करें।
इन प्रयोगों का उद्देश्य इन्फरेंस गति और पीक मेमोरी खपत सहित विभिन्न मीट्रिक्स का उपयोग करके MatMul-रहित LLMs के प्रदर्शन की पारंपरिक मॉडलों से तुलना करना था। हमने अलग-अलग पैरामीटर आकारों (370M, 1.3B, और 2.7B) में, विविध परिदृश्यों में उनके प्रदर्शन का आकलन करने के लिए कई प्रॉम्प्ट्स का उपयोग करके मॉडल परीक्षण किए।
कुछ मुख्य प्रेक्षण इस प्रकार हैं:
एक GitHub इश्यू में लेखकों की प्रतिक्रियाओं की समीक्षा करने पर स्पष्ट हुआ कि उनके पेपर में रिपोर्ट किए गए प्रदर्शन बढ़ोतरी BitBLAS का उपयोग करके हासिल हुई थीं—यह एक विशेषीकृत लाइब्रेरी है जो बाइनरी और लो-प्रिसिशन ऑपरेशन्स के लिए अनुकूलित है। हालाँकि, BitBLAS अभी तक सार्वजनिक रूप से उपलब्ध मॉडलों में एकीकृत नहीं है, और इसकी स्थापना जटिल है, जिसमें पैकेज का पुनःकम्पाइलेशन करना पड़ता है।
पेपर में एक कस्टम FPGA एक्सेलरेटर और अनुकूलित GPU कर्नेल्स के उपयोग को भी रेखांकित किया गया है, जिनसे उल्लेखनीय प्रदर्शन सुधार हासिल हुए। ये हार्डवेयर समाधान प्रशिक्षण और इन्फरेंस दोनों की दक्षता बढ़ाने के लिए डिज़ाइन किए गए हैं। विशेषकर FPGA इम्प्लीमेंटेशन टर्नरी ऑपरेशन्स का कुशलतापूर्वक लाभ उठाने के लिए अनुकूलित है, जिससे इन्फरेंस के दौरान मेमोरी उपयोग और विलंबता में उल्लेखनीय कमी आती है। MatMul-रहित LLMs की पूरी क्षमता को साकार करने के लिए ये कस्टम हार्डवेयर कॉन्फ़िगरेशन आवश्यक हैं, जैसा कि गति और मेमोरी दक्षता में रिपोर्टेड सुधारों से प्रदर्शित होता है।
Hugging Face पर वर्तमान में उपलब्ध MatMul-रहित मॉडल, मूल पेपर में रेखांकित प्रदर्शन लाभ नहीं दिखाते। BitBLAS के साथ एकीकरण की कमी, इस असंगति का एक महत्वपूर्ण कारण प्रतीत होती है। MatMul-रहित आर्किटेक्चर के संभावित लाभ, जैसे मेमोरी उपयोग में कमी, विशेष हार्डवेयर या आगे के अनुकूलन के बिना व्यावहारिक परिदृश्यों में साकार नहीं होते। धीमी गति और अधिकतर मामलों में तुलनीय या अधिक मेमोरी उपयोग उन्हें पारंपरिक मॉडलों की तुलना में वास्तविक दुनिया के अनुप्रयोगों के लिए कम आकर्षक बनाते हैं।
जेनरेटिव AI के क्षेत्र के निरंतर विकास के साथ, MatMul-रहित LLMs जैसे नए मॉडल आर्किटेक्चर की बारीकियों और संभावनाओं को समझना महत्वपूर्ण है। यदि आप AI में नवीनतम के बारे में और पढ़ना चाहते हैं, तो ये लेख देखें:
इन कोर्सेज़ के साथ AI सीखें!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
