
Last chance! 50% off DataCamp Premium
Sale ends in
I large language model (LLM) fanno grande affidamento sulle moltiplicazioni di matrici (MatMul) per le loro operazioni, con requisiti notevoli sia in termini di calcolo sia di memoria di picco. Tuttavia, in un lavoro recente è emerso un nuovo archetipo di LLM senza MatMul, che promette prestazioni paragonabili con un potenziale risparmio di risorse.
In questo articolo confronterò gli LLM senza MatMul con le loro controparti classiche. Esaminerò le capacità generative e il consumo di risorse su tre dimensioni di modello: 370M, 1,3B e 2,7B parametri. La mia analisi coprirà la velocità dei modelli e il consumo massimo di memoria, evidenziando i potenziali vantaggi delle architetture senza MatMul nell'NLP moderno.
Per saperne di più sugli LLM senza MatMul, puoi leggere questo articolo: LLM senza MatMul: concetti chiave spiegati.
Questa sezione illustra il setup utilizzato per condurre gli esperimenti.
Gli autori dell'articolo non menzionano esplicitamente con quali modelli abbiano confrontato i loro modelli senza MatMul. Affermano soltanto di “confrontare due varianti del nostro LM senza MatMul con un'architettura Transformer avanzata riprodotta (Transformer++, basata su Llama-2) su tre dimensioni di modello: 370M, 1,3B e 2,7B parametri.” Inoltre, tutti i modelli sono stati addestrati sul dataset SlimPajama.
Per garantire un confronto equo, l'ideale sarebbe usare modelli open source addestrati sullo stesso dataset. Tuttavia, data l'indisponibilità di tali modelli, questo articolo confronta il consumo di memoria di picco e la velocità dei modelli disponibili di dimensioni simili con i risultati presentati nel paper.
Questi sono i modelli con cui li confronteremo:
È importante notare che gli LLM senza MatMul usano pesi ternari e attivazioni BF16, che incidono sensibilmente sulle loro caratteristiche di memoria e velocità. Poiché nessun altro modello nel nostro set di confronto utilizza pesi ternari e attivazioni BF16, queste funzionalità conferiscono agli LLM senza MatMul vantaggi unici in termini di efficienza della memoria e velocità di elaborazione. Questa distinzione sarà cruciale nella nostra analisi comparativa, evidenziando come queste innovazioni contribuiscano alle prestazioni complessive dei modelli senza MatMul.
Per eseguire i nostri confronti, lavoreremo in un ambiente Google Colab con runtime GPU T4. Questo setup offre una piattaforma potente ma accessibile per l’esecuzione e la valutazione di LLM.
La libreria principale che useremo è transformers di Hugging Face, dato che tutti i modelli di cui abbiamo bisogno sono disponibili lì. Possiamo installarla con il seguente comando:
pip install transformersDovremo anche installare la libreria matmulfreellm per eseguire i nostri modelli senza MatMul. La libreria è open source e disponibile su GitHub; possiamo installarla eseguendo:
pip install -U git+https://github.com/ridgerchu/matmulfreellmPer monitorare l'uso massimo di memoria useremo pytorch, che può essere installato con diversi comandi a seconda del sistema e del gestore pacchetti, come descritto qui. Se lavori in Google Colab, dovrebbe essere preinstallato.
Ecco come eseguiamo gli esperimenti. Per prima cosa, dobbiamo importare le librerie necessarie:
import torch
import time
from transformers import AutoModelForCausalLM, AutoTokenizer
Poi, per ogni esperimento, definiamo i nomi dei modelli in una lista: l'esempio fornito è per i modelli nell'intervallo di 370M parametri.
model_names = ["gpt2-medium", "facebook/opt-350m", "ridger/MMfreeLM-370M"]Quindi carichiamo i modelli e i tokenizer in memoria. Se il tuo sistema non ne ha abbastanza, puoi eseguire gli esperimenti separatamente per ciascun modello. Qui ci assicuriamo di usare i float a mezza precisione tramite il metodo .half().
models = [AutoModelForCausalLM.from_pretrained(name).half().cuda() for name in model_names]
tokenizers = [AutoTokenizer.from_pretrained(name) for name in model_names]
Dobbiamo anche impostare il pad_token per ciascun tokenizer:
for tokenizer in tokenizers:
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token
Per effettuare tutte le osservazioni necessarie, esegui i modelli e ottieni l'output: userò la seguente funzione measure_performance():
def measure_performance(model, tokenizer, prompt):
    inputs = tokenizer(prompt, return_tensors="pt", padding=True)
    input_ids = inputs.input_ids.cuda()
    attention_mask = inputs.attention_mask.cuda()
    torch.cuda.reset_peak_memory_stats()
    # Measure speed
    start_time = time.time()
    with torch.no_grad():
        outputs = model.generate(
            input_ids,
            attention_mask=attention_mask,
            max_length=128,
            pad_token_id=tokenizer.eos_token_id,
            repetition_penalty=1.1,
            no_repeat_ngram_size=2
        )
    end_time = time.time()
    # Measure memory after inference
    peak_memory = torch.cuda.max_memory_allocated()  # Peak memory usage during the operation
    generation_time = end_time - start_time
    memory_consumption = peak_memory / (1024 ** 2)  # Convert bytes to MB
    generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)

    return generation_time, memory_consumption, generated_text
La funzione valuta le prestazioni di un modello linguistico misurando velocità di inferenza e consumo massimo di memoria. Prima tokenizza il prompt di input, assicurando maschere di attenzione e padding corretti, e trasferisce gli input sulla GPU. L’uso di memoria viene monitorato prima azzerando e poi registrando le statistiche di picco: lo convertiamo in MB prima di restituirlo.
Ritengo che l'uso massimo di memoria sia la statistica più importante, perché è ciò che provoca un overflow. La funzione misura anche la velocità di inferenza registrando il tempo prima e dopo la generazione del testo (questo è il modo standard di misurare il tempo di esecuzione in Python).
Gli iperparametri usati per la generazione sono impostati nel metodo .generate(). Usiamo una lunghezza massima di 128 token e impostiamo la penalità di ripetizione (questo perché il modello senza MatMul sembrava generare più volte la stessa risposta). Alla fine, la funzione restituisce tempo, consumo massimo di memoria e il testo generato.
Ora possiamo definire il prompt ed eseguire gli esperimenti. Raccoglierò anche i dati ed eseguirò i modelli su prompt diversi per raccogliere i risultati.
prompt = "What are the benefits of renewable energy?" #example prompt
results = {}
for name, model, tokenizer in zip(model_names, models, tokenizers):
	time_taken, memory_used, output = measure_performance(model, tokenizer,prompt)
	results[name] = {
	    "time_taken": time_taken,
	    "memory_used": memory_used,
	    "output": output
	}
	print(f"Model: {name}\nTime taken: {time_taken} seconds\nMemory used: {memory_used} MB\nOutput: {output}\n")
L'output si presenta così:
Evaluating model: gpt2-medium
Prompt: What are the benefits of renewable energy?
Time taken: 3.17 seconds
Peak memory used: 3521.02 MB
Output: What are the benefits of renewable energy?
 The answer is that it's cheaper than fossil fuels.    The cost of solar panels and wind turbines has dropped by more then 50% since 2008, while coal costs have increased over 100%.   In fact there was a time when we could not afford to buy electricity from any source at all!    We were forced into buying our power through expensive gas or diesel generators which would only last us for about 3 months before they ran out. Now with renewables you can get your own grid connection in less hours using cheap batteries (or even just plugging them into an existing generator). Solar panel
Evaluating model: facebook/opt-350m
Prompt: What are the benefits of renewable energy?
Time taken: 2.15 seconds
Peak memory used: 3452.84 MB
Output: What are the benefits of renewable energy?
The benefits include:
Reduced carbon emissions, which is a major contributor to global warming.
Increased energy efficiency and reduced energy consumption. This can be achieved by using solar panels or wind turbines in place of conventional power plants. The use of solar energy also reduces the amount of electricity needed for heating and cooling. Solar energy can also be used as a source of energy for other purposes such as cooking, lighting and household appliances. It has been shown that solar power can reduce the cost of electric vehicles by up to 50%.
Improved energy security. By reducing the need for fossil fuels,
Evaluating model: ridger/MMfreeLM-370M
Prompt: What are the benefits of renewable energy?
Time taken: 31.68 seconds
Peak memory used: 3788.36 MB
Output: What are the benefits of renewable energy?
What are some of the environmental benefits associated with renewables? What is the potential impact on our environment and people's health? How can we make our buildings more energy efficient? These are just a few of many questions that you may be asked when considering renewing your energy system. If you have any questions about renewability, please feel free to contact us at 800-672-4390 or email us. We look forward to hearing from you!
How much does it cost to install solar panels in my home? The average cost for installationPurtroppo, i modelli tradizionali hanno costantemente superato le controparti senza MatMul sia in velocità sia nell'uso massimo di memoria.
Per l’intervallo 370M, abbiamo confrontato il modello senza MatMul da 370M con gpt2-medium e facebook/opt-350m.
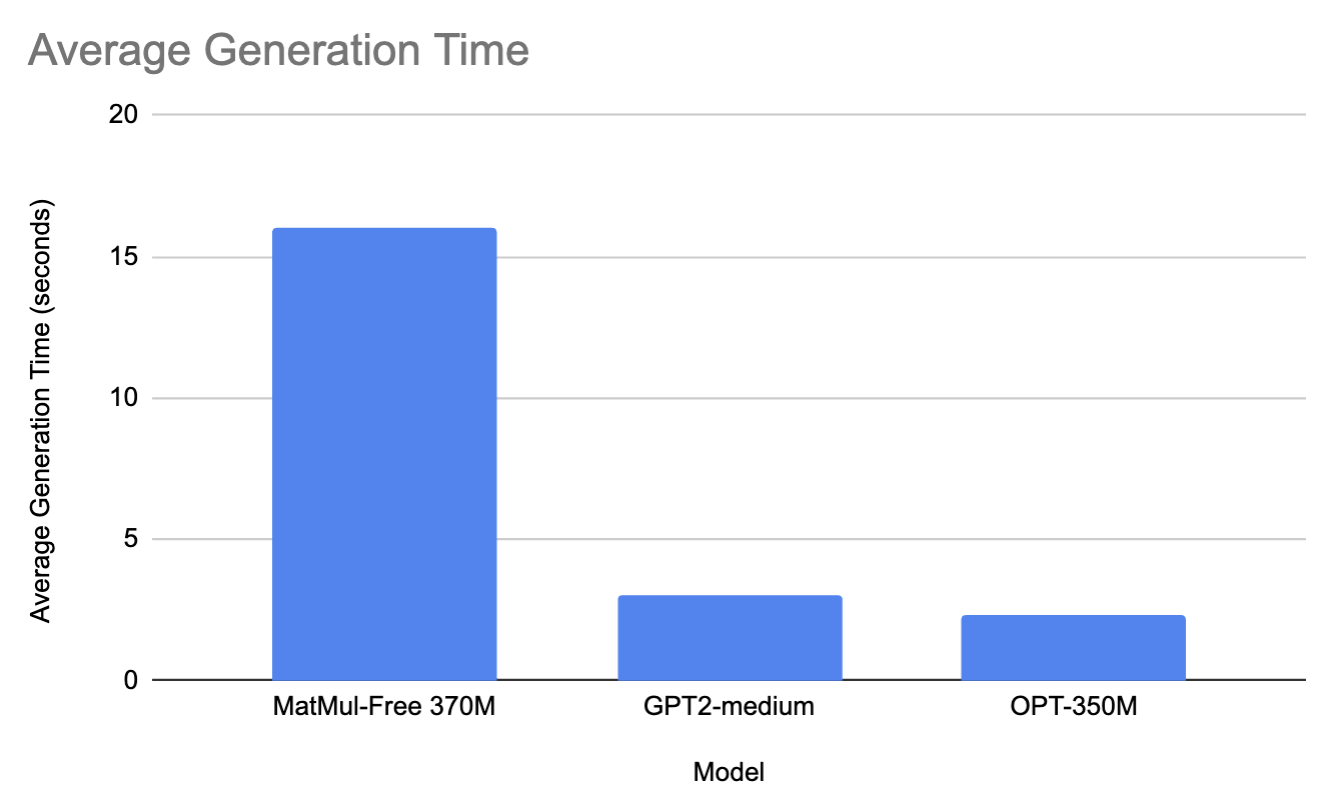
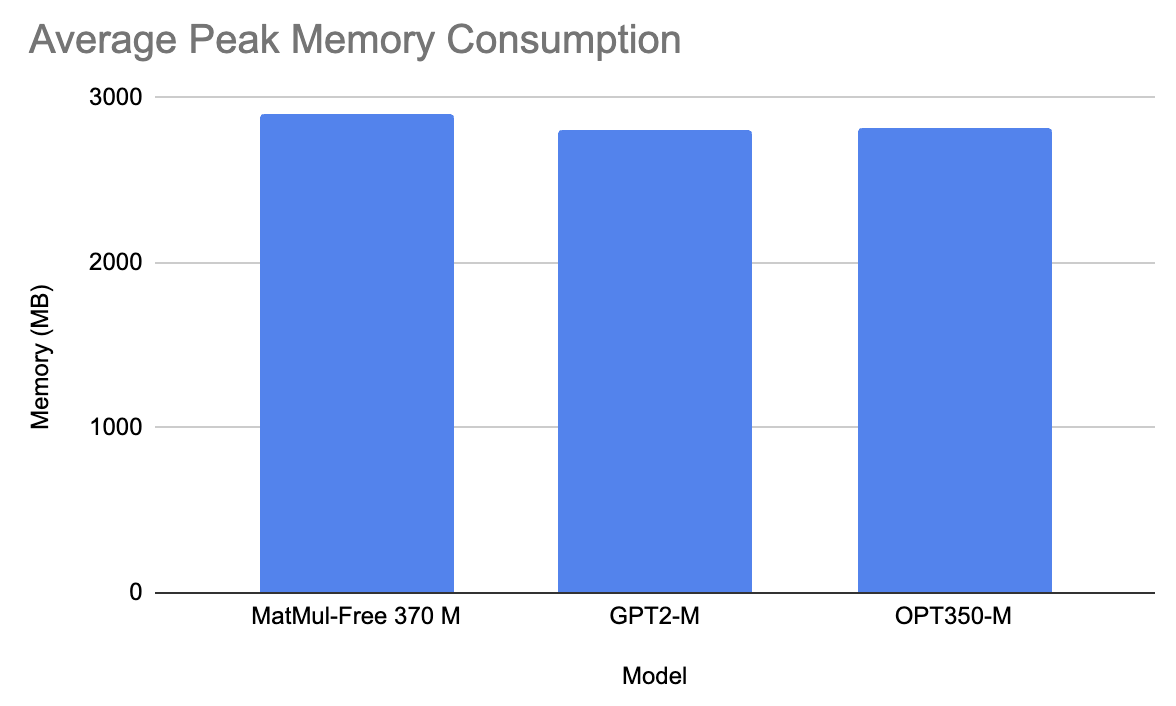
In media, su tutti i prompt, il modello senza MatMul ha impiegato 16 secondi per generare una risposta e ha usato 2900 MB di memoria. GPT2-M, invece, ha impiegato 3 secondi per generare un prompt e 2810 MB di memoria (probabilmente per via della differenza di dimensioni, GPT2-M è di 350M parametri). In modo analogo, OPT350-M ha impiegato 2,3 secondi per generare una risposta e 2815 MB di memoria.
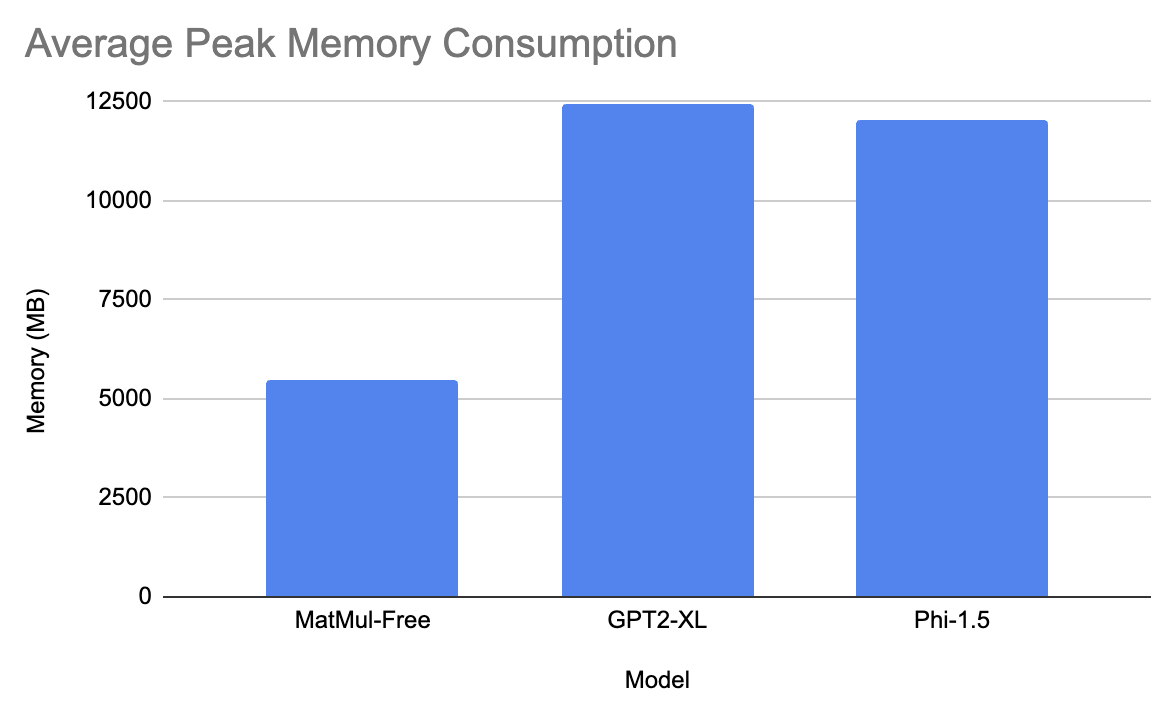
In questo intervallo, abbiamo testato il modello senza MatMul contro microsoft/phi-1_5 e openai-community/gpt2-xl.
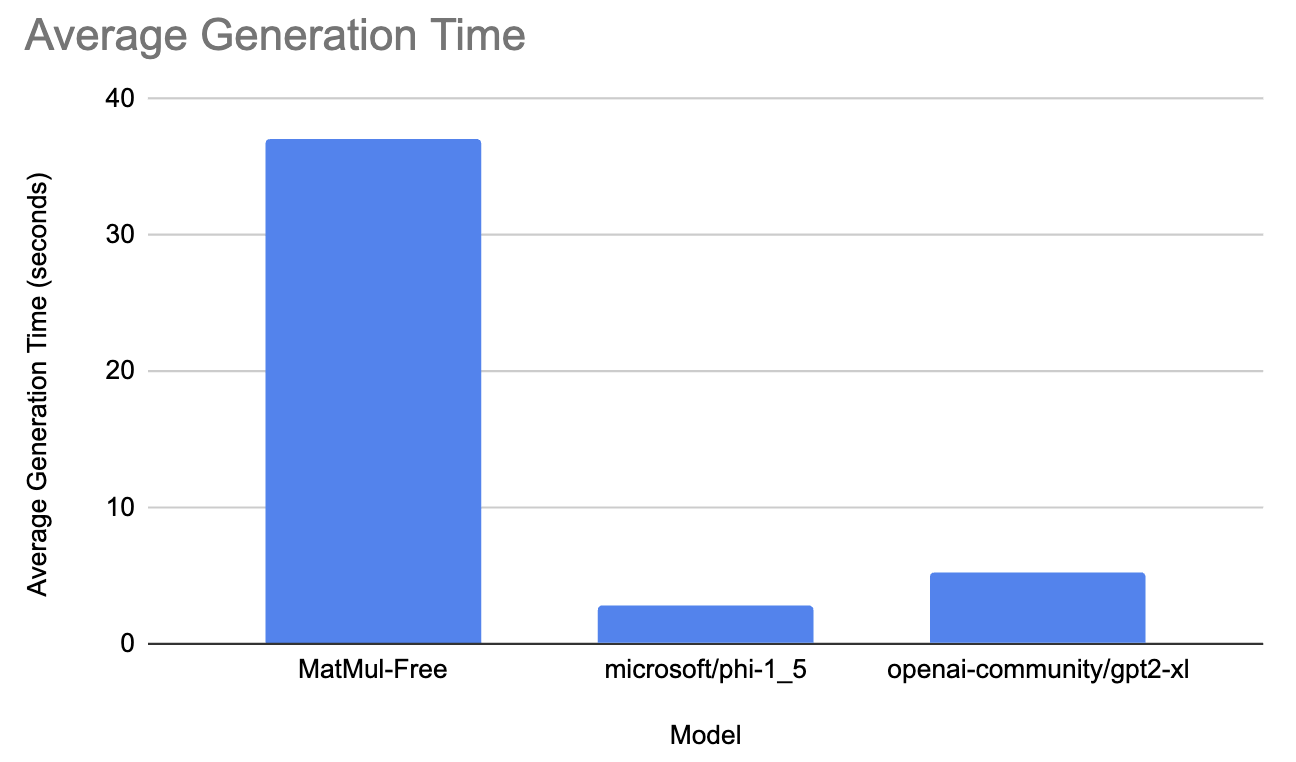
In media, il modello gpt ha impiegato 5,3 secondi per generare la risposta e ha avuto 12435 MB di consumo massimo di memoria. Il modello di Microsoft ha impiegato 2,9 secondi per generare la risposta e circa 12033 MB di consumo massimo di memoria. Infine, il modello senza MatMul ha impiegato in media 37 secondi per generare la risposta e ha avuto 5470 MB di consumo massimo di memoria!
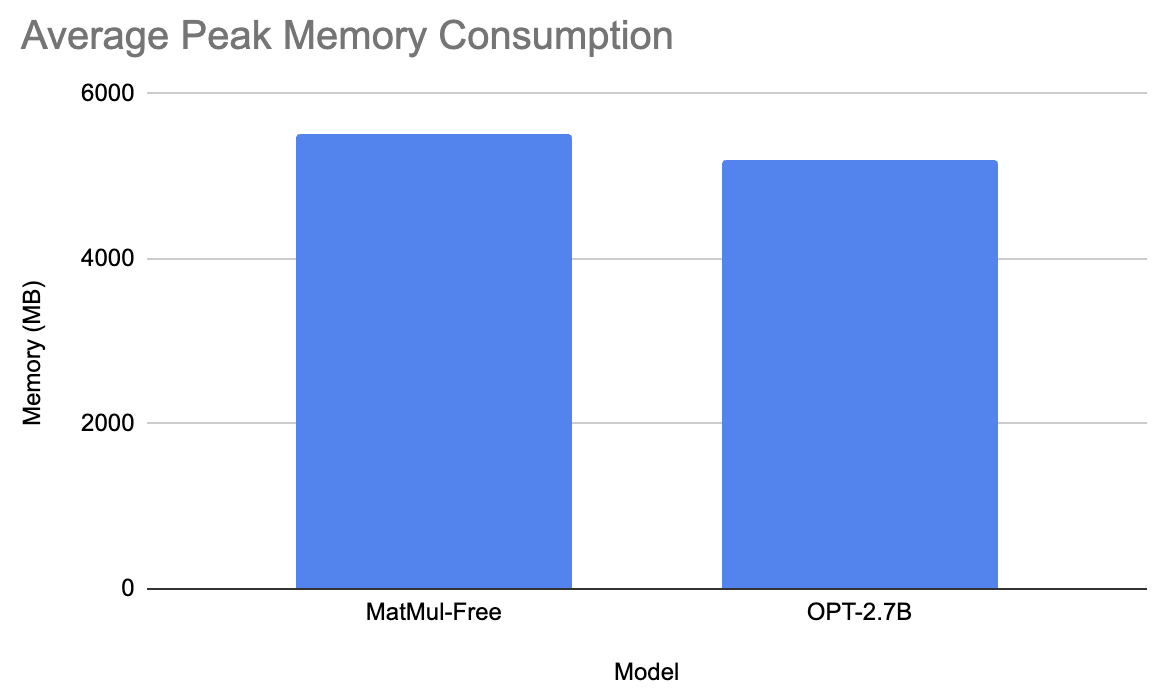
Per l'ultimo confronto, abbiamo testato il modello senza MatMul contro facebook/opt-2.7b.
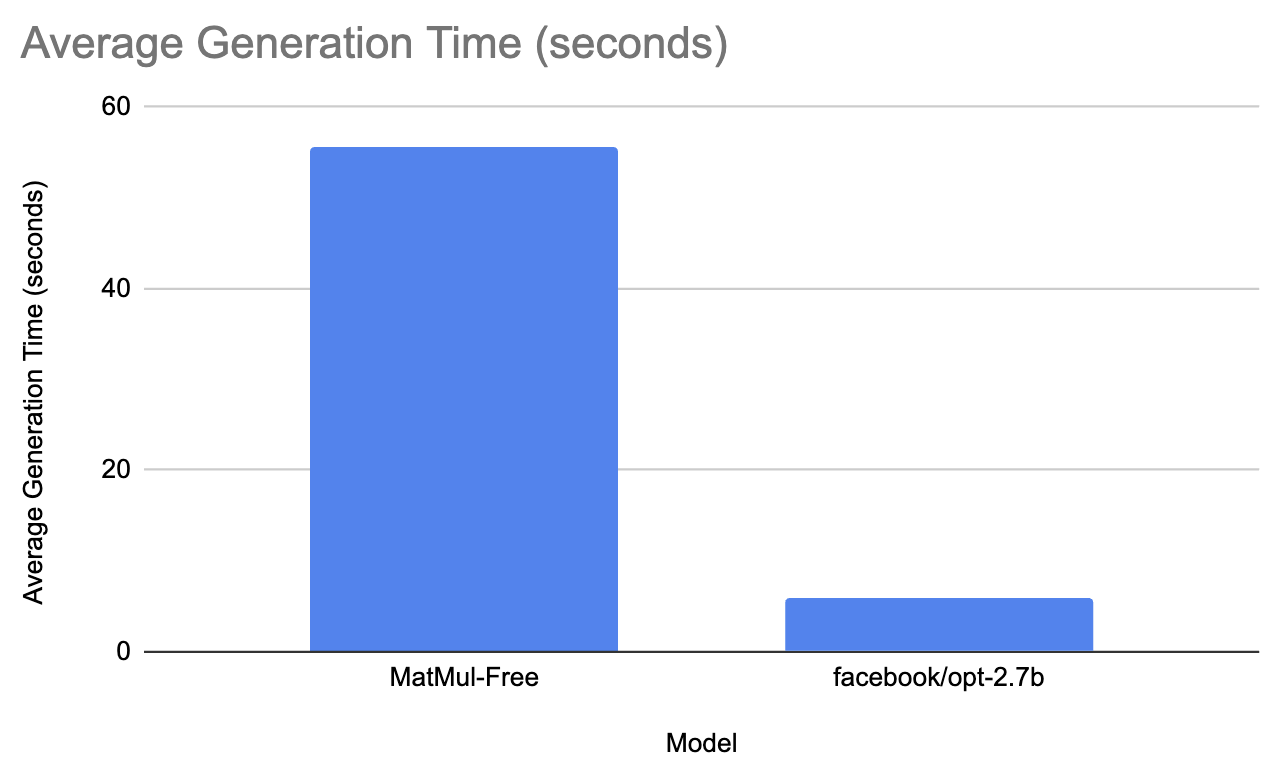
Il modello di Facebook ha impiegato in media 6 secondi per generare la risposta e ha avuto un consumo medio di memoria di picco di 5200 MB. Il modello senza MatMul, invece, ha impiegato 55,6 secondi per generare il prompt e ha avuto un consumo massimo di memoria di 5501,3 MB. Non ha molto senso, ma ho ripetuto l'esperimento un paio di volte e i risultati sono gli stessi
I modelli senza MatMul sono risultati carenti in termini di velocità. Possiamo però valutarli comunque per la qualità del testo generato. Eseguiremo questo esperimento sul più grande modello senza MatMul disponibile. Per avere una comprensione completa della qualità del testo generato, dovremmo usare un set diversificato di prompt: vedi il mio codice in questa repository GitHub (nota che gli esempi prompt-risposta variano un po’ perché ho rieseguito il codice e c'è sempre un po’ di casualità).
Prompt: Componi una poesia sul mutare delle stagioni.
Risposta: **_La poesia_**
* Il poeta inizia presentando il proprio nome in questo verso di apertura: "Sono un poeta." Segue un'introduzione che fornisce alcune informazioni sul suo vissuto e sul suo lavoro, nonché sul rapporto con la moglie, descritta come "la donna più bella che abbia mai visto". Poi descrive il suo amore per lei nelle seguenti righe:
* "Sei il mio raggio di sole in un mondo di buio."
* Sei "una stella per me", quella nei cui occhi vedo la luce
Prompt: Spiega le differenze tra apprendimento supervisionato e non supervisionato nel machine learning.
Risposta: 203: Quali sono alcuni dei problemi che hai visto con la supervisione? Come si può risolvere?
Il problema è che stiamo cercando di fare una previsione per un valore sconosciuto in questo caso nel futuro in un ambiente molto incerto in cui non sappiamo cosa accadrà in quel periodo futuro. Abbiamo questa enorme quantità di dati nel nostro dataset in termini di molte cose diverse che potrebbero potenzialmente accadere in quel particolare giorno o in quel mese specifico, ma semplicemente non abbiamo
Prompt: Spiega la teoria della relatività.
Risposta: 2007-09-15 14:36:08 --> Language Class Initialized
13931638 24833432 --> Config Classes loaded. Next class will be automatically selected. </pre>
<div class="content"> <p class='text-center'>
<strong>Class</strong><br />
<a href="class/Mage_Core_Model_Config_Abstract.html">Mages\Core\Model\Config</a> </
Prompt: Quanto fa uno diviso zero
Risposta: A: È la radice quadrata di 0.
Il quadrato di un numero negativo è lo stesso di quel numero moltiplicato per se stesso in base 10, quindi deve essere un numero positivo. Il quadrato ha valore $2$, quindi è un quadrato a sé stante. Se vuoi scoprire cos'è con gli altri numeri nella tua lista, basta moltiplicarli insieme!
$2 \times 3 = 6$, per esempio. Questo significa che può avere qualsiasi valore da $0$ a $9$.
Nel complesso, il testo generato non è per lo più coerente, rendendo l'uso di questi modelli poco pratico. Ho deciso di testare anche iperparametri diversi: nessuna penalità di ripetizione e lunghezza massima 512. Qui il modello ha comunque prodotto nonsense; inoltre, ha ripetuto le ultime righe della risposta finché non ha raggiunto i 512 token. Ho anche testato i prompt con gli iperparametri temperature e top_p, e il risultato non è stato migliore.
Sentiti libero di sperimentare tu stesso con questi modelli!
Rivediamo ora i risultati degli esperimenti e discutiamone le implicazioni.
Gli esperimenti miravano a valutare le prestazioni degli LLM senza MatMul rispetto ai modelli tradizionali usando varie metriche, tra cui velocità di inferenza e consumo massimo di memoria. Abbiamo testato modelli con diverse dimensioni di parametri (370M, 1,3B e 2,7B) utilizzando una varietà di prompt per valutarne le prestazioni in scenari diversi.
Ecco alcune osservazioni chiave:
Dalla lettura del feedback degli autori in una delle issue su GitHub, è emerso che i miglioramenti di prestazioni riportati nel loro paper sono stati ottenuti usando BitBLAS, una libreria specializzata e ottimizzata per operazioni binarie e a bassa precisione. Tuttavia, BitBLAS non è ancora integrata nei modelli pubblicamente disponibili e la sua installazione è complessa, richiedendo la ricompilazione del pacchetto.
Il paper evidenzia anche l’uso di un acceleratore FPGA personalizzato e di kernel GPU ottimizzati per ottenere notevoli miglioramenti prestazionali. Queste soluzioni hardware sono progettate per migliorare l’efficienza sia in addestramento sia in inferenza. L’implementazione FPGA, in particolare, è pensata per sfruttare in modo efficiente le operazioni ternarie, riducendo sensibilmente l’uso di memoria e la latenza durante l’inferenza. Queste configurazioni hardware personalizzate sono essenziali per realizzare appieno il potenziale degli LLM senza MatMul, come dimostrato dai miglioramenti riportati in termini di velocità ed efficienza della memoria.
I modelli senza MatMul attualmente disponibili su Hugging Face non mostrano i benefici prestazionali evidenziati nel paper originale. La mancata integrazione con BitBLAS sembra essere un fattore significativo che contribuisce a questa discrepanza. I potenziali vantaggi delle architetture senza MatMul, come il minor uso di memoria, non si realizzano in pratica senza hardware specializzato o ulteriori ottimizzazioni. Le velocità inferiori e un uso di memoria comparabile o superiore nella maggior parte dei casi li rendono meno attraenti per applicazioni reali rispetto ai modelli tradizionali.
Capire le sfumature e il potenziale di nuove architetture di modelli come gli LLM senza MatMul è cruciale mentre il campo dell’IA generativa continua a evolvere. Se vuoi leggere altro sulle ultime novità in AI, dai un’occhiata a questi articoli:
Impara l'AI con questi corsi!
Corso
Programma
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min




