{count, plural, one {Kursus} other {Kursus}}
Menerapkan Solusi AI dalam Bisnis
{hours} jam
55.8K
Sebagai seseorang yang rutin menggunakan model canggih seperti ChatGPT dari OpenAI dan Claude dari Anthropic, saya melihat langsung bagaimana kinerjanya menurun seiring bertambahnya panjang prompt masukan, yang menimbulkan masalah dalam menjaga koherensi dan relevansi pada teks yang panjang.
Untuk mengatasi keterbatasan ini, para peneliti di Microsoft dan University of Illinois memperkenalkan SAMBA—sebuah arsitektur hibrida baru yang menggabungkan state space models (SSM) dengan sliding window attention (SWA).
Pendekatan mereka memanfaatkan kekuatan SSM, yang unggul dalam mengelola ketergantungan jangka panjang, serta SWA, yang menangani jendela konteks dan menjaga keterkelolaan komputasi. Dengan menyatukan teknik-teknik ini, SAMBA mencapai pemodelan bahasa yang efisien dengan panjang konteks praktis tak terbatas.
Dalam artikel ini, kita akan membahas arsitektur SAMBA dan kemampuannya yang unik untuk menangani rentang teks panjang tanpa kehilangan konteks. Kami juga menyoroti potensinya untuk secara signifikan meningkatkan kemampuan model bahasa dalam memproses dan menghasilkan rangkaian panjang, menetapkan standar baru dalam pemodelan bahasa.
Untuk memahami mengapa SAMBA sangat inovatif, pertama-tama kita perlu memahami tantangan yang dihadapi model bahasa tradisional saat berurusan dengan rangkaian teks panjang.
Model berbasis Transformer tradisional, meski sangat kuat, menghadapi tantangan besar saat menangani rangkaian teks panjang karena kompleksitas kuadratik terhadap panjang konteks. Kompleksitas kuadratik ini muncul dari mekanisme self-attention, yang menuntut setiap token memperhatikan setiap token lain dalam urutan.
Akibatnya, biaya komputasi dan memori meningkat pesat seiring bertambahnya panjang urutan, membuat model-model ini tidak praktis untuk tugas yang memerlukan pemrosesan teks yang sangat panjang.
Keterbatasan ini sering memaksa kita memotong masukan atau menggunakan strategi suboptimal lainnya agar sesuai dengan keterbatasan perangkat keras yang tersedia. Pada akhirnya, kompromi ini mengurangi kemampuan model untuk mempertahankan kinerja pada urutan panjang, sebuah tantangan yang saya alami saat mengembangkan aplikasi yang perlu memproses dokumen panjang.
State Space Models (SSM) menawarkan alternatif dengan kompleksitas linear, sehingga lebih efisien secara komputasi untuk menangani urutan panjang. SSM mempertahankan keadaan yang terus berkembang, memungkinkan penanganan ketergantungan jangka panjang tanpa biaya besar seperti pada transformer.
Namun, SSM juga memiliki keterbatasan. Karena sifat Markovian-nya, di mana keadaan saat ini hanya bergantung pada keadaan sebelumnya, model ini sering kesulitan dalam mengingat memori pada urutan yang panjang. Daya ingat yang terbatas ini mengurangi efektivitasnya dalam pemodelan konteks yang komprehensif, terutama pada aplikasi yang memerlukan retensi dan rujukan informasi dari jauh lebih awal dalam urutan.
Mengingat kelebihan dan kekurangan Transformer dan SSM, ada kebutuhan mendesak untuk pendekatan hibrida yang dapat memanfaatkan keunggulan masing-masing sekaligus mengurangi keterbatasannya. Menggabungkan SSM dengan mekanisme attention merupakan solusi yang menjanjikan.
Pendekatan hibrida ini memanfaatkan efisiensi dan kemampuan menangani ketergantungan jarak jauh dari SSM, bersama mekanisme attention yang dinamis dan terfokus dari Transformer. Dengan mengintegrasikan kedua metode ini, kita dapat menciptakan model yang mulus memproses urutan panjang dengan peningkatan daya ingat dan pemahaman konteks.
SAMBA menawarkan solusi elegan untuk bottleneck konteks ini dengan menggabungkan kekuatan dari dua pendekatan yang berbeda.
Gagasan inti di balik SAMBA adalah menyelang-selingkan Mamba, sebuah SSM, dengan lapisan SwiGLU dan sliding window attention (SWA). Struktur hibrida ini menangkap struktur berulang dan pengambilan memori yang presisi.
SAMBA mencontohkan pendekatan ini dengan menggabungkan kekuatan SSM dan mekanisme attention untuk mengelola konteks panjang sekaligus mempertahankan informasi detail.
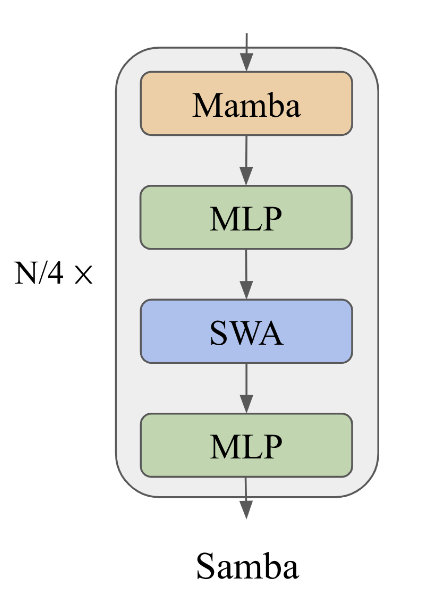
Diagram yang menggambarkan arsitektur SAMBA. Sumber: Ren dkk. (2024)
Lapisan Mamba dalam SAMBA mahir menangkap semantik yang bergantung pada waktu, menyediakan kerangka kerja yang tangguh untuk menangani data berurutan. Lapisan-lapisan ini beroperasi dengan mempertahankan dan memperbarui suatu keadaan yang mencerminkan ketergantungan temporal dalam data.
Mamba mencapai hal ini dengan memanfaatkan state space selektif yang memungkinkan model memfokuskan pada masukan yang relevan dan mempertahankan informasi penting pada urutan panjang. Mekanisme pengaturan gerbang selektif ini penting untuk decoding yang cepat dan memastikan model dapat menafsirkan serta memprediksi pola berurutan dengan akurasi tinggi dan beban komputasi minimal.
Lapisan sliding window attention melengkapi lapisan Mamba dengan menangani ketergantungan non-Markovian yang kompleks dalam jendela konteks terbatas. SWA beroperasi pada ukuran jendela yang meluncur sepanjang urutan masukan, memastikan kompleksitas komputasi linear.
Ini memungkinkan model mengambil sinyal definisi-tinggi dari sejarah menengah hingga jangka pendek yang tidak dapat ditangkap oleh keadaan berulang Mamba. Dengan menyesuaikan fokusnya secara dinamis, lapisan SWA memungkinkan model mempertahankan koherensi dan konteks, terutama untuk tugas yang memerlukan respons relevan secara kontekstual pada masukan yang panjang.
Lapisan SwiGLU dalam SAMBA memfasilitasi transformasi non-linear dan meningkatkan pengingatan pengetahuan. Lapisan-lapisan ini memperkenalkan non-linearitas ke dalam model, memungkinkannya menangkap pola dan interaksi yang lebih kompleks dalam data.
Selain itu, lapisan SwiGLU memastikan model dapat memproses dan mengingat informasi, berkontribusi pada ketangguhan dan versatilitasnya. Transformasi non-linear ini penting bagi kemampuan model untuk menggeneralisasi dari data pelatihan ke aplikasi dunia nyata.
Setelah mengeksplorasi arsitektur SAMBA, sekarang mari kita tinjau kinerja dan efisiensinya dibandingkan model lain.
SAMBA menunjukkan kinerja baik di berbagai tolok ukur pemahaman bahasa dan penalaran, melampaui model berbasis attention murni maupun SSM murni. Secara khusus, SAMBA dievaluasi pada tugas seperti MMLU, GSM8K, dan HumanEval, meraih skor 71,2 untuk MMLU, 69,6 untuk GSM8K, dan 54,9 untuk HumanEval.
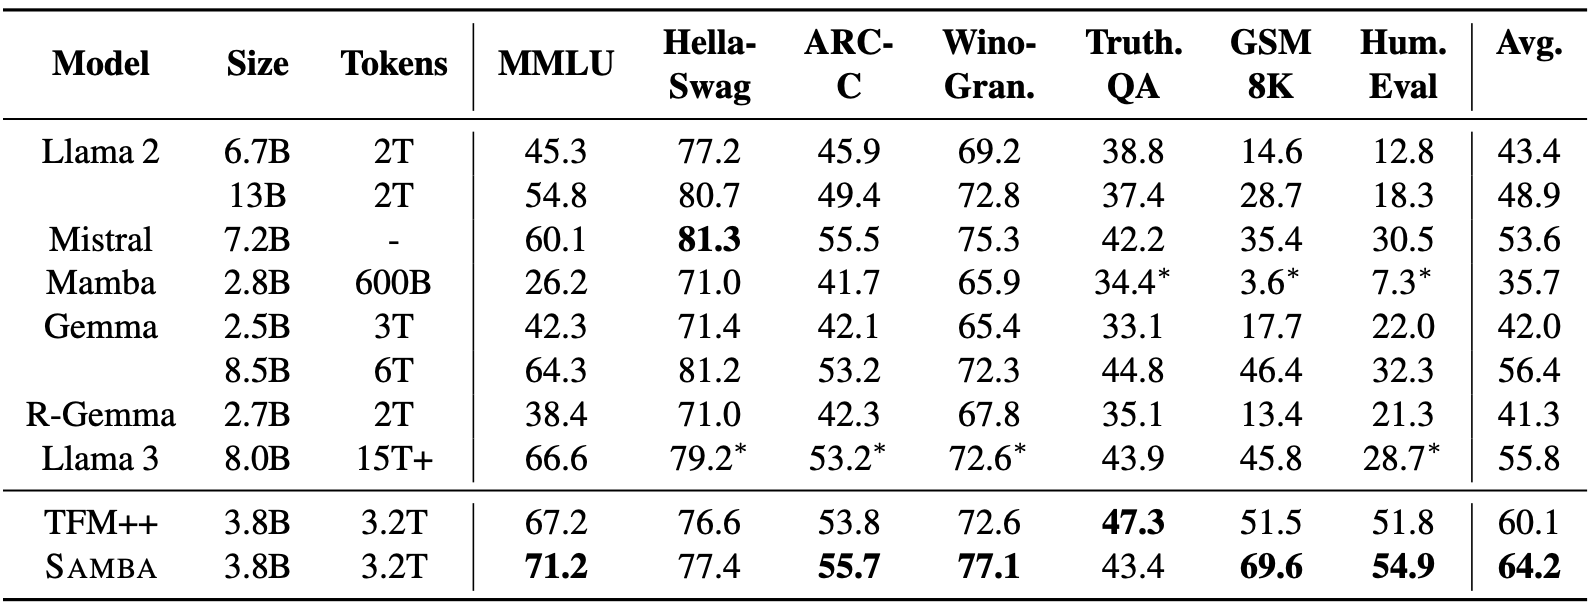
Sumber: Ren dkk. (2024)
Hasil ini secara signifikan melampaui model mutakhir lainnya, termasuk TFM++ dan Llama-3, menunjukkan kemampuan SAMBA dalam menangani beragam tugas pemahaman bahasa. Misalnya, SAMBA meraih akurasi 18,1% lebih tinggi pada GSM8K dibandingkan TFM++, menyoroti kemahiran arsitektur hibridanya yang menggabungkan SSM dengan mekanisme attention.
Salah satu fitur paling menonjol dari SAMBA adalah kemampuannya menangani panjang konteks yang jauh lebih besar sambil tetap efisien. Meski dilatih awal pada urutan sepanjang 4K, SAMBA dapat mengekstrapolasi hingga 1M token dengan perplexity yang membaik dan tetap mempertahankan kompleksitas waktu decoding linear.
Ini dicapai melalui kombinasi per lapisan antara state space selektif milik Mamba dan SWA, memungkinkan model mempertahankan kinerja tinggi tanpa kompleksitas komputasi kuadratik.
Secara praktis, SAMBA mencapai throughput decoding 3,64× lebih cepat dibandingkan arsitektur Llama-3, khususnya untuk urutan hingga 128K token, menunjukkan skalabilitas dan kemampuannya dalam memproses konteks panjang.
Arsitektur hibrida SAMBA secara signifikan memperkuat kemampuan mengingat dibandingkan SSM murni. Dalam pengujian seperti Passkey Retrieval, SAMBA menunjukkan pengingatan hampir sempurna hingga panjang konteks 256K setelah fine-tuning hanya 500 langkah, sementara model berbasis SWA kesulitan melampaui 4K.
Kinerja luar biasa ini dikaitkan dengan perpaduan kekuatan struktur berulang Mamba untuk semantik bergantung waktu dan kemampuan pengambilan memori SWA. Alhasil, SAMBA unggul pada tugas pengingatan jangka pendek maupun panjang, menjadikannya solusi tangguh bagi aplikasi yang memerlukan pemahaman konteks luas.
Mari kita cermati pilihan desain dan strategi spesifik yang berkontribusi pada kinerja impresif SAMBA.
SAMBA menerapkan strategi hibridasi canggih yang menggabungkan lapisan Mamba, SWA, dan Multi-Layer Perceptron (MLP). Pendekatan ini mengoptimalkan kinerja untuk pemodelan bahasa berkonteks panjang dengan memanfaatkan karakteristik unik tiap komponen:
Makalah SAMBA mengeksplorasi berbagai model rekuren linear dan mekanisme attention untuk mengidentifikasi kombinasi paling optimal. Alternatif seperti Multi-Scale Retention dan GLA dipertimbangkan sebagai pengganti potensial untuk Mamba. Anda dapat menemukan informasi lebih lanjut tentang arsitektur Mamba dalam panduan pengantar arsitektur Mamba LLM ini.
Eksplorasi ini bertujuan menyeimbangkan efisiensi komputasi dan kinerja dalam tugas pemodelan bahasa. Perbandingan menunjukkan bahwa meskipun alternatif tersebut menawarkan beberapa manfaat, kombinasi Mamba dengan lapisan SWA dan MLP mencapai kinerja dan skalabilitas keseluruhan terbaik.
Menganalisis entropi distribusi attention menghasilkan wawasan berharga tentang kinerja SAMBA dan model sebanding seperti Mistral. Analisis entropi attention menunjukkan bahwa SAMBA mempertahankan pengingatan memori yang lebih stabil dan andal pada konteks yang panjang.
Sebagai contoh, pada tugas Passkey Retrieval, SAMBA menunjukkan pengambilan hampir sempurna hingga panjang konteks 256K, secara signifikan melampaui Mistral. Analisis heatmap mengindikasikan bahwa arsitektur hibrida SAMBA memungkinkannya mempertahankan akurasi pengambilan tinggi di berbagai posisi pass-key, menegaskan kemampuan pengambilan jarak jauh yang luar biasa.
Dengan kemampuannya memproses urutan panjang secara efektif, SAMBA membuka beragam potensi aplikasi.
Kemampuan SAMBA untuk menangani panjang konteks tak terbatas membuka peluang besar untuk berbagai tugas berkonteks panjang. Model ini mampu menjaga koherensi dan relevansi sepanjang rangkaian yang luas, sehingga sangat cocok untuk aplikasi seperti:
Arsitektur SAMBA dirancang dengan mempertimbangkan efisiensi, mengatasi keterbatasan khas model berbasis attention murni dan SSM murni. Beberapa manfaat utama meliputi:
Ke depan, terdapat beberapa jalur menarik untuk pengembangan lebih lanjut yang dapat meningkatkan kapabilitas SAMBA:
SAMBA merepresentasikan kemajuan signifikan dalam pemodelan bahasa, menawarkan arsitektur hibrida baru yang menggabungkan SSM dengan SWA dan lapisan MLP. Inovasi dan keunggulan utama arsitektur SAMBA meliputi hibridasi SSM dan mekanisme attention, efisiensi dalam menangani konteks panjang, serta peningkatan daya ingat.
Sambil menutup pembahasan arsitektur SAMBA, cara yang baik untuk mendapatkan pemahaman lebih mendalam tentang arsitektur dan inovasinya adalah dengan bereksperimen menggunakan implementasi yang tersedia di GitHub.
Jika Anda ingin mempelajari lebih lanjut tentang inovasi AI terbaru, saya merekomendasikan artikel blog berikut:
Pelajari AI dengan kursus-kursus ini!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



