Biaya komputasi untuk melatih model bahasa besar (LLM) semakin tidak terkendali. Misalnya, pelatihan GPT-4 menelan biaya sekitar 100 juta dolar bagi OpenAI. Biaya ini terutama berasal dari operasi perkalian matriks (singkatnya MatMul), dan wajar jika para peneliti serta pengembang berupaya menghilangkannya sepenuhnya atau membuatnya lebih efisien.
Makalah "Scalable MatMul-free Language Modeling" memperkenalkan pendekatan terobosan yang menghadapi isu ini secara langsung. Dengan sepenuhnya menghilangkan MatMul dari LLM, para penulis mengembangkan model yang mempertahankan kinerja kompetitif sekaligus secara signifikan mengurangi kebutuhan komputasi dan memori.
Sumber: Rui-Jie Zhu dkk.
Semua model dari makalah tersebut tersedia di HuggingFace—Anda bisa mencobanya secara daring atau lokal menggunakan pustaka HuggingFace. Selain itu, para peneliti telah menyediakan kode mereka di GitHub, sehingga orang lain dapat melatih model mereka.
Jika Anda ingin lebih memahami kompleksitas waktu kubik dari perkalian matriks, saya merekomendasikan pengantar tentang Notasi Big-O dan Kompleksitas Waktu, yang memiliki bagian khusus tentang kompleksitas waktu LLM MatMul.
Saya juga melakukan perbandingan antara LLM bebas MatMul dan LLM berbasis MatMul—Anda dapat menemukannya di artikel ini: Matmul-Free vs MatMul LLMs: Kecepatan dan Konsumsi Memori.
Bottleneck MatMul pada Model Bahasa Besar
LLM modern berbasis transformer sangat bergantung pada operasi perkalian matriks, yang menjadi inti dari komponen utama seperti mekanisme attention dan lapisan feedforward. Biaya komputasi dan memori yang terkait dengan operasi MatMul sangat besar, memengaruhi fase pelatihan maupun inferensi. Seiring bertambahnya ukuran LLM, jumlah parameter dan kompleksitas komputasi meningkat, menjadikan MatMul sebagai bottleneck utama.
Contoh umum masalah ini adalah ketika VRAM GPU tidak cukup untuk menangani ukuran model, sehingga pengguna terpaksa melatih atau menjalankan inferensi di CPU. CPU tidak dioptimalkan untuk operasi MatMul terparalel seperti GPU, yang menyebabkan komputasi jauh lebih lambat. Ini menciptakan lingkaran yang membuat frustrasi, di mana perangkat keras yang tersedia tidak dapat dimanfaatkan sepenuhnya karena keterbatasan memori, meskipun daya komputasinya memadai.
Selama bertahun-tahun, para peneliti mengeksplorasi berbagai strategi untuk mengurangi beban komputasi MatMul. Kuantisasi, yaitu mengurangi presisi bobot dan aktivasi, menjadi pendekatan populer. Dengan merepresentasikan angka menggunakan lebih sedikit bit, kuantisasi dapat menurunkan biaya komputasi dan jejak memori operasi MatMul.
Namun, metode ini sering mengorbankan akurasi model dan tidak sepenuhnya menghilangkan MatMul. Upaya penting seperti BitNet dari Microsoft menunjukkan bahwa LLM dapat diskalakan dengan kuantisasi biner atau ternary, tetapi model-model ini masih bergantung pada operasi MatMul untuk bagian tertentu, seperti mekanisme self-attention.
Arsitektur alternatif juga telah diusulkan untuk mengatasi ketidakefisienan MatMul. Pendekatan seperti AdderNet mengganti perkalian dengan penjumlahan pada komponen jaringan tertentu, dan jaringan saraf biner/ternary memanfaatkan operasi aritmetika yang disederhanakan
Meskipun metode-metode ini menawarkan beberapa peningkatan, biasanya tidak berhasil menghapus MatMul sepenuhnya dan hanya menargetkan bagian tertentu dari model. Akibatnya, biaya komputasi secara keseluruhan tetap tinggi, membatasi skalabilitas dan efisiensi LLM.
Cara Kerja Model Bahasa Bebas MatMul
Untuk memahami cara kerja LM bebas MatMul, mari kita telusuri arsitektur dasar dan komponen kuncinya.
Mengganti MatMul dengan operasi ternary
Dalam jaringan saraf tradisional, lapisan padat (yang menghubungkan semua neuron antara dua lapisan berurutan) mengandalkan MatMul untuk mentransformasikan data masukan. Para penulis menggantinya dengan lapisan BitLinear, yang menggunakan bobot ternary. Alih-alih bobot yang bisa berupa bilangan real apa pun, bobot dibatasi hanya pada tiga nilai: -1, 0, atau 1.
Bobot awalnya dilatih sebagai nilai presisi penuh, lalu selama pelatihan, dikuantisasi menjadi nilai ternary menggunakan proses yang disebut "absmean quantization." Proses ini menskalakan matriks bobot dengan nilai absolut rata-ratanya, kemudian membulatkan setiap elemen ke bilangan bulat ternary terdekat (-1, 0, atau 1).
Penyederhanaan ini memungkinkan mereka mengganti perkalian dalam MatMul dengan penjumlahan dan pengurangan. Misalnya, mengalikan suatu angka dengan -1 sama dengan menegasikannya, mengalikan dengan 0 menghasilkan 0, dan mengalikan dengan 1 membuat angka tetap sama.
Komponen inti: MLGRU DAN GLU
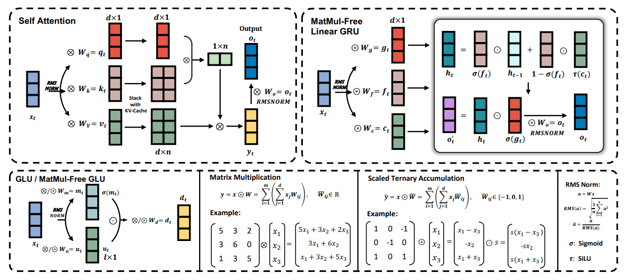
Gambar di bawah ini memberikan gambaran umum tentang komponen kunci Model Bahasa Bebas MatMul, termasuk MatMul-Free Linear Gated Recurrent Unit (MLGRU) dan MatMul-Free Gated Linear Unit (GLU):
Sumber: Rui-Jie Zhu dkk.
Gambar tersebut dibagi menjadi beberapa bagian (dari kiri atas ke kanan bawah):
- Self-attention: Bagian ini menunjukkan cara kerja mekanisme self-attention tradisional dengan perkalian matriks.
- Linear GRU bebas MatMul: Bagian ini mengilustrasikan arsitektur MLGRU, menyoroti bagaimana ia memproses urutan masukan menggunakan operasi per-elemen dan mekanisme penggembok (gating) alih-alih MatMul.
- GLU / GLU bebas MatMul: Bagian ini menunjukkan bagaimana GLU mencampurkan informasi di berbagai dimensi embedding model, menggunakan bobot ternary untuk menghilangkan MatMul.
- Perkalian matriks vs. akumulasi ternary terskala: Perbandingan ini menunjukkan bagaimana perkalian matriks standar diganti dengan akumulasi ternary terskala, menyederhanakan komputasi.
- RMS norm: Bagian ini merinci operasi RMSNorm, yang menormalkan aktivasi sebelum kuantisasi.
MLGRU beroperasi dengan memproses urutan masukan satu token pada satu waktu. Pada setiap langkah, ia mengambil embedding token saat ini dan state tersembunyi sebelumnya sebagai masukan. State tersembunyi bertindak sebagai memori, menyimpan informasi dari token sebelumnya. MLGRU kemudian memperbarui state tersembunyi ini menggunakan serangkaian operasi per-elemen dan mekanisme penggembok. Gerbang-gerbang ini, pada dasarnya vektor angka antara 0 dan 1, mengontrol aliran informasi dengan menentukan bagian mana dari state tersembunyi sebelumnya dan embedding token saat ini yang paling relevan untuk langkah berikutnya. Proses ini berlanjut hingga seluruh urutan selesai diproses.
Gated linear unit (GLU) bebas MatMul adalah komponen kunci lain dari model bahasa bebas MatMul. Ia mencampurkan informasi di berbagai dimensi representasi internal kata (embedding) model. Sederhananya, ini membantu model memahami berbagai aspek atau fitur dari setiap kata.
GLU mencapai hal ini dengan menggunakan mekanisme penggembok untuk mengontrol aliran informasi antar kanal embedding. Mekanisme penggembok ini mirip dengan gerbang pada MLGRU, tetapi beroperasi pada dimensi kanal, bukan dimensi token.
GLU bebas MatMul adalah versi modifikasi dari GLU standar, diadaptasi untuk menghilangkan perkalian matriks dengan menggunakan lapisan BitLinear, yaitu lapisan padat yang memakai bobot ternary (bobot yang hanya dapat bernilai -1, 0, atau 1). Dalam GLU bebas MatMul, masukan terlebih dahulu ditransformasikan menggunakan dua lapisan BitLinear terpisah. Keluaran salah satu lapisan dilewatkan melalui fungsi aktivasi SiLU lalu dikalikan per-elemen dengan keluaran lapisan lainnya. Keluaran bertingkat (gated) ini kemudian dilewatkan melalui lapisan BitLinear lain untuk menghasilkan keluaran akhir.
Ini hanyalah penjelasan tingkat tinggi tentang komponen MLGRU dan GLU. Saya mendorong Anda untuk merujuk pada makalah penelitian asli untuk pemahaman lebih rinci tentang cara kerja internal dan formulasi matematisnya.
Riset ini menyelidiki hukum penskalaan model bebas MatMul, membandingkan kinerjanya dengan arsitektur Transformer tradisional saat ukuran model meningkat.
Kinerja dan skalabilitas
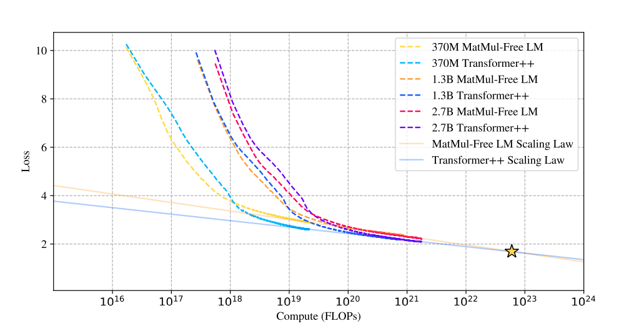
Secara mengejutkan, temuan menunjukkan bahwa kesenjangan kinerja antara kedua pendekatan ini menyempit seiring pertumbuhan ukuran model. Ini merupakan pengamatan penting karena menyiratkan bahwa model bebas MatMul semakin kompetitif dengan Transformer tradisional saat diskalakan, dan berpotensi melampauinya pada skala yang sangat besar.
Sumber: Rui-Jie Zhu dkk.
Grafik perbandingan hukum penskalaan ini menunjukkan bahwa kurva loss LM bebas MatMul dan transformer tradisional konvergen seiring meningkatnya jumlah operasi floating-point (FLOP).
Awalnya, LM bebas MatMul menunjukkan loss yang lebih tinggi karena kendala bobot ternary. Namun, kesenjangan ini menyusut saat ukuran model meningkat, dan pada titik tertentu (bintang), kurva loss berpotongan, menandakan kinerja yang sebanding. Ini menyiratkan hukum penskalaan yang lebih curam untuk model bebas MatMul, artinya kinerjanya meningkat lebih cepat seiring bertambahnya ukuran dibanding Transformer tradisional.
Hasil benchmark
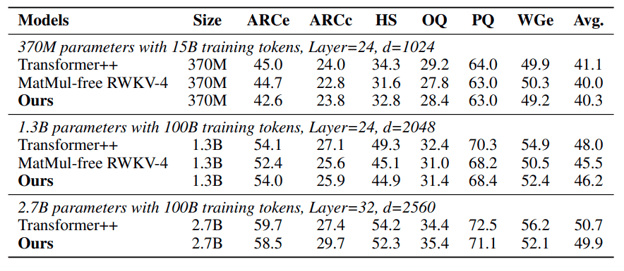
Kinerja kompetitif LM bebas MatMul semakin ditegaskan oleh hasil yang kuat pada berbagai benchmark pembelajaran zero-shot. Dalam tugas seperti ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA, dan OpenbookQA, model-model ini sering tampil sebanding atau bahkan melampaui Transformer tradisional, meskipun kompleksitas komputasinya jauh lebih rendah. Ini menjadi bukti efektivitas operasi alternatif dan pilihan arsitektural yang digunakan dalam LM bebas MatMul.
Sumber: Rui-Jie Zhu dkk.
Tabel akurasi zero-shot menunjukkan bahwa LM bebas MatMul tampil kompetitif di berbagai tugas. Misalnya, pada ARC-Challenge, benchmark yang sangat sulit, LM bebas MatMul dengan 2,7 miliar parameter mencapai akurasi yang lebih tinggi daripada model transformer tradisional.
Demikian pula, pada tugas Winogrande dan OpenbookQA, LM bebas MatMul menunjukkan performa yang tangguh, mengindikasikan bahwa penghapusan MatMul tidak mengompromikan kemampuan model untuk memahami dan menghasilkan bahasa.
Efisiensi memori
Salah satu keunggulan paling mencolok dari LM bebas MatMul adalah efisiensi memorinya yang luar biasa. Dengan mengganti operasi yang sarat perkalian dengan penjumlahan dan pengurangan yang dimungkinkan oleh bobot ternary, model-model ini mencapai pengurangan penggunaan memori yang substansial.
Selama pelatihan, implementasi GPU yang dioptimalkan dapat mengurangi konsumsi memori hingga 61% dibandingkan model yang tidak dioptimalkan. Pada inferensi, penghematan memori bahkan lebih dramatis, dengan pengurangan lebih dari sepuluh kali lipat. Ini membuat LM bebas MatMul sangat menarik untuk diterapkan pada perangkat dengan sumber daya terbatas seperti ponsel pintar, di mana memori sering menjadi faktor pembatas.
Sumber: Rui-Jie Zhu dkk.
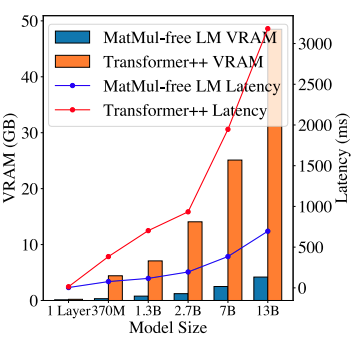
Grafik perbandingan memori GPU dan latensi ini menggambarkan peningkatan efisiensi LM bebas MatMul. Konsumsi memori inferensi LM bebas MatMul dengan 2,7 miliar parameter jauh lebih rendah dibanding Transformer tradisional yang sebanding. Jejak memori yang berkurang ini tidak hanya memungkinkan penerapan model yang lebih besar pada perangkat keras terbatas, tetapi juga berujung pada latensi yang lebih rendah, menjadikan model-model ini lebih cocok untuk aplikasi waktu nyata yang menuntut respons cepat.
Dari GPU Teroptimasi hingga Desain FPGA Kustom
Salah satu kemajuan kunci yang disajikan dalam makalah ini adalah implementasi GPU yang dioptimalkan untuk LM bebas MatMul. Para penulis mencapai peningkatan kecepatan pelatihan sebesar 25,6% dan pengurangan penggunaan memori hingga 61,0% dengan menggunakan kernel terfusi dalam implementasi GPU mereka. Kernel ini menggabungkan beberapa operasi menjadi satu proses yang lebih efisien, mengurangi overhead yang terkait dengan akses memori dan pergerakan data.
Untuk lebih memanfaatkan operasi ringan dari LM bebas MatMul, para penulis mengembangkan akselerator FPGA kustom dalam SystemVerilog. FPGA (Field-Programmable Gate Array) menawarkan platform perangkat keras yang fleksibel dan efisien untuk mengimplementasikan tugas komputasi khusus.
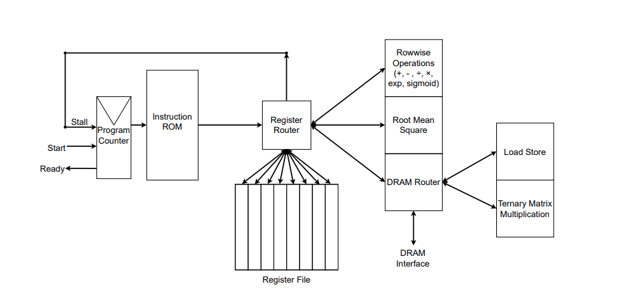
Akselerator kustom tersebut dirancang untuk memanfaatkan kesederhanaan operasi ternary dan produk per-elemen, sehingga meraih peningkatan efisiensi yang substansial. Implementasi RTL (Register Transfer Level) adalah hal kritis dalam proses desain FPGA. Ini melibatkan penentuan perilaku perangkat keras pada tingkat tinggi, yang kemudian disintesis menjadi konfigurasi FPGA aktual. Desain RTL kustom untuk LM bebas MatMul memastikan FPGA dapat menangani operasi ringan secara efisien, mengurangi konsumsi daya dan meningkatkan throughput.
Sumber: Rui-Jie Zhu dkk.
Gambar tersebut mengilustrasikan implementasi RTL dari akselerator FPGA kustom. Anda dapat melihat fungsi yang diimplementasikannya di sebelah kanan Register Router. Para penulis juga mengembangkan assembler mereka sendiri untuk mengonversi berkas assembly dengan instruksi kustom menjadi instruction ROM, yang dapat Anda lihat di sisi kanan gambar. Instruksi diberikan ke Register Router yang mengelola memori (Register File) dan mengeksekusi instruksi.
Selain itu, para penulis menyebutkan dalam komentar pada isu GitHub bahwa spesifikasi lengkap dari implementasi FPGA mereka masih dioptimalkan, dan kode SystemVerilog akan dipublikasikan nanti.
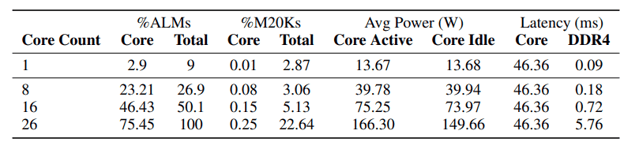
Tabel di bawah ini menunjukkan pemanfaatan sumber daya dan metrik kinerja untuk implementasi FPGA dari generasi token bebas MatMul.
Sumber: Rui-Jie Zhu dkk.
Data menunjukkan bahwa seiring bertambahnya jumlah inti (unit pemrosesan) dalam FPGA, latensi keseluruhan pada awalnya tetap relatif stabil. Namun, latensi meningkat signifikan dari 16 ke 26 inti, yang menunjukkan bahwa antarmuka DDR4, yang bertanggung jawab atas transfer data, menjadi bottleneck ketika permintaan transfer data tumbuh seiring jumlah inti.
Sementara operasi perkalian matriks ternary saat ini mendominasi latensi keseluruhan, para penulis memperkirakan bahwa pengoptimalan unit ini pada implementasi mendatang akan menggeser bottleneck ke antarmuka DDR4.
Salah satu klaim paling menarik dari makalah ini adalah bahwa pendekatan bebas MatMul membawa LLM lebih dekat ke efisiensi mirip otak dalam hal komputasi dan konsumsi energi. Para penulis berargumen bahwa model mereka meniru efisiensi jaringan saraf biologis dan mencapai kecepatan membaca yang mirip manusia.
Namun, secara langsung membandingkan efisiensi model-model ini dengan cara kerja kompleks jaringan saraf biologis adalah isu rumit yang memerlukan penyelidikan lebih lanjut. Mekanisme komputasi otak sangat berbeda dan jauh lebih kompleks daripada operasi yang disederhanakan yang digunakan dalam LM bebas MatMul.
Bebas MatMul: Implikasi dan Arah Masa Depan
Makalah "Scalable MatMul-free Language Modeling" menantang asumsi mendasar dalam pemrosesan bahasa alami: bahwa perkalian matriks (MatMul) itu esensial untuk membangun LLM berkinerja tinggi.
Dengan menunjukkan kelayakan arsitektur bebas MatMul, riset ini membuka frontier baru dalam desain LLM, mendorong eksplorasi operasi alternatif dan paradigma komputasi. Ini bisa memicu gelombang inovasi, dengan peneliti mengembangkan arsitektur model yang baru.
Akselerasi perangkat keras untuk model ringan
Peralihan menuju model bebas MatMul bukan hanya soal perangkat lunak—ini juga menyangkut perangkat keras. Chip tradisional seperti GPU unggul dalam perkalian matriks tetapi belum tentu paling cocok untuk model-model ringan yang baru ini.
Akselerator FPGA kustom yang dibangun para peneliti memberikan gambaran tentang masa depan perangkat keras AI—chip khusus yang dirancang untuk memeras setiap ons kinerja dari model-model efisien ini. Ini dapat melahirkan generasi baru perangkat bertenaga AI yang lebih cepat, lebih hemat energi, dan dapat diakses oleh khalayak yang lebih luas.
Dampak lingkungan dan keberlanjutan
Sebagai seseorang yang peduli pada lingkungan, saya sangat antusias dengan potensi model bebas MatMul untuk mengurangi jejak karbon AI. Konsumsi energi masif dari model bahasa besar saat ini adalah kekhawatiran nyata. Dengan secara signifikan mengurangi tuntutan komputasi, riset ini dapat membuka jalan bagi teknologi AI yang lebih hemat energi dengan jejak lingkungan yang lebih kecil.
Pertanyaan riset terbuka dan arah selanjutnya
Walaupun makalah "Scalable MatMul-free Language Modeling" menghadirkan lompatan besar, ia juga membuka sejumlah jalur riset lanjutan—mengeksplorasi beragam arsitektur bebas MatMul, mengevaluasi kinerjanya pada rentang tugas yang lebih luas, dan memahami secara matematis batas teoretis pendekatan ini hanyalah beberapa arah riset yang menarik.
Selain itu, pengembangan benchmark dan metrik evaluasi standar khusus untuk model bebas MatMul akan memfasilitasi perbandingan yang adil dan mempercepat kemajuan di bidang ini. Perjalanan menuju AI yang benar-benar efisien dan mudah diakses baru saja dimulai, dan kemungkinannya tak terbatas. Saya pribadi juga sangat antusias untuk mencoba chatbot asisten bebas MatMul di masa depan!
Kesimpulan
Makalah "Scalable MatMul-free Language Modeling" memberikan kontribusi signifikan pada bidang LLM dengan memperkenalkan pendekatan baru yang menghilangkan operasi perkalian matriks (MatMul).
Terobosan ini mengatasi bottleneck komputasi dan memori yang terkait dengan LLM tradisional, membuka jalan bagi model yang lebih efisien dan dapat diskalakan. Dengan memanfaatkan operasi aditif dan bobot ternary, para penulis menunjukkan bahwa mungkin untuk mempertahankan kinerja kompetitif sambil secara signifikan mengurangi kebutuhan sumber daya.
Dampak potensial dari riset ini terhadap masa depan pengembangan dan penerapan LLM sangat besar. Model bebas MatMul menawarkan alternatif yang layak bagi arsitektur konvensional, memungkinkan pembuatan model ringan dan efisien yang sangat cocok untuk lingkungan dengan sumber daya terbatas seperti perangkat edge dan platform seluler.
Jika Anda ingin mempelajari lebih lanjut tentang kecerdasan buatan, lihat kursus AI ini.







Biaya komputasi untuk melatih model bahasa besar (LLM) semakin tidak terkendali. Misalnya, pelatihan GPT-4 menelan biaya sekitar 100 juta dolar bagi OpenAI. Biaya ini terutama berasal dari operasi perkalian matriks (singkatnya MatMul), dan wajar jika para peneliti serta pengembang berupaya menghilangkannya sepenuhnya atau membuatnya lebih efisien.
Makalah "Scalable MatMul-free Language Modeling" memperkenalkan pendekatan terobosan yang menghadapi isu ini secara langsung. Dengan sepenuhnya menghilangkan MatMul dari LLM, para penulis mengembangkan model yang mempertahankan kinerja kompetitif sekaligus secara signifikan mengurangi kebutuhan komputasi dan memori.
Sumber: Rui-Jie Zhu dkk.
Semua model dari makalah tersebut tersedia di HuggingFace—Anda bisa mencobanya secara daring atau lokal menggunakan pustaka HuggingFace. Selain itu, para peneliti telah menyediakan kode mereka di GitHub, sehingga orang lain dapat melatih model mereka.
Jika Anda ingin lebih memahami kompleksitas waktu kubik dari perkalian matriks, saya merekomendasikan pengantar tentang Notasi Big-O dan Kompleksitas Waktu, yang memiliki bagian khusus tentang kompleksitas waktu LLM MatMul.
Saya juga melakukan perbandingan antara LLM bebas MatMul dan LLM berbasis MatMul—Anda dapat menemukannya di artikel ini: Matmul-Free vs MatMul LLMs: Kecepatan dan Konsumsi Memori.
Bottleneck MatMul pada Model Bahasa Besar
LLM modern berbasis transformer sangat bergantung pada operasi perkalian matriks, yang menjadi inti dari komponen utama seperti mekanisme attention dan lapisan feedforward. Biaya komputasi dan memori yang terkait dengan operasi MatMul sangat besar, memengaruhi fase pelatihan maupun inferensi. Seiring bertambahnya ukuran LLM, jumlah parameter dan kompleksitas komputasi meningkat, menjadikan MatMul sebagai bottleneck utama.
Contoh umum masalah ini adalah ketika VRAM GPU tidak cukup untuk menangani ukuran model, sehingga pengguna terpaksa melatih atau menjalankan inferensi di CPU. CPU tidak dioptimalkan untuk operasi MatMul terparalel seperti GPU, yang menyebabkan komputasi jauh lebih lambat. Ini menciptakan lingkaran yang membuat frustrasi, di mana perangkat keras yang tersedia tidak dapat dimanfaatkan sepenuhnya karena keterbatasan memori, meskipun daya komputasinya memadai.
Selama bertahun-tahun, para peneliti mengeksplorasi berbagai strategi untuk mengurangi beban komputasi MatMul. Kuantisasi, yaitu mengurangi presisi bobot dan aktivasi, menjadi pendekatan populer. Dengan merepresentasikan angka menggunakan lebih sedikit bit, kuantisasi dapat menurunkan biaya komputasi dan jejak memori operasi MatMul.
Namun, metode ini sering mengorbankan akurasi model dan tidak sepenuhnya menghilangkan MatMul. Upaya penting seperti BitNet dari Microsoft menunjukkan bahwa LLM dapat diskalakan dengan kuantisasi biner atau ternary, tetapi model-model ini masih bergantung pada operasi MatMul untuk bagian tertentu, seperti mekanisme self-attention.
Arsitektur alternatif juga telah diusulkan untuk mengatasi ketidakefisienan MatMul. Pendekatan seperti AdderNet mengganti perkalian dengan penjumlahan pada komponen jaringan tertentu, dan jaringan saraf biner/ternary memanfaatkan operasi aritmetika yang disederhanakan
Meskipun metode-metode ini menawarkan beberapa peningkatan, biasanya tidak berhasil menghapus MatMul sepenuhnya dan hanya menargetkan bagian tertentu dari model. Akibatnya, biaya komputasi secara keseluruhan tetap tinggi, membatasi skalabilitas dan efisiensi LLM.
Cara Kerja Model Bahasa Bebas MatMul
Untuk memahami cara kerja LM bebas MatMul, mari kita telusuri arsitektur dasar dan komponen kuncinya.
Mengganti MatMul dengan operasi ternary
Dalam jaringan saraf tradisional, lapisan padat (yang menghubungkan semua neuron antara dua lapisan berurutan) mengandalkan MatMul untuk mentransformasikan data masukan. Para penulis menggantinya dengan lapisan BitLinear, yang menggunakan bobot ternary. Alih-alih bobot yang bisa berupa bilangan real apa pun, bobot dibatasi hanya pada tiga nilai: -1, 0, atau 1.
Bobot awalnya dilatih sebagai nilai presisi penuh, lalu selama pelatihan, dikuantisasi menjadi nilai ternary menggunakan proses yang disebut "absmean quantization." Proses ini menskalakan matriks bobot dengan nilai absolut rata-ratanya, kemudian membulatkan setiap elemen ke bilangan bulat ternary terdekat (-1, 0, atau 1).
Penyederhanaan ini memungkinkan mereka mengganti perkalian dalam MatMul dengan penjumlahan dan pengurangan. Misalnya, mengalikan suatu angka dengan -1 sama dengan menegasikannya, mengalikan dengan 0 menghasilkan 0, dan mengalikan dengan 1 membuat angka tetap sama.
Komponen inti: MLGRU DAN GLU
Gambar di bawah ini memberikan gambaran umum tentang komponen kunci Model Bahasa Bebas MatMul, termasuk MatMul-Free Linear Gated Recurrent Unit (MLGRU) dan MatMul-Free Gated Linear Unit (GLU):
Sumber: Rui-Jie Zhu dkk.
Gambar tersebut dibagi menjadi beberapa bagian (dari kiri atas ke kanan bawah):
MLGRU beroperasi dengan memproses urutan masukan satu token pada satu waktu. Pada setiap langkah, ia mengambil embedding token saat ini dan state tersembunyi sebelumnya sebagai masukan. State tersembunyi bertindak sebagai memori, menyimpan informasi dari token sebelumnya. MLGRU kemudian memperbarui state tersembunyi ini menggunakan serangkaian operasi per-elemen dan mekanisme penggembok. Gerbang-gerbang ini, pada dasarnya vektor angka antara 0 dan 1, mengontrol aliran informasi dengan menentukan bagian mana dari state tersembunyi sebelumnya dan embedding token saat ini yang paling relevan untuk langkah berikutnya. Proses ini berlanjut hingga seluruh urutan selesai diproses.
Gated linear unit (GLU) bebas MatMul adalah komponen kunci lain dari model bahasa bebas MatMul. Ia mencampurkan informasi di berbagai dimensi representasi internal kata (embedding) model. Sederhananya, ini membantu model memahami berbagai aspek atau fitur dari setiap kata.
GLU mencapai hal ini dengan menggunakan mekanisme penggembok untuk mengontrol aliran informasi antar kanal embedding. Mekanisme penggembok ini mirip dengan gerbang pada MLGRU, tetapi beroperasi pada dimensi kanal, bukan dimensi token.
GLU bebas MatMul adalah versi modifikasi dari GLU standar, diadaptasi untuk menghilangkan perkalian matriks dengan menggunakan lapisan BitLinear, yaitu lapisan padat yang memakai bobot ternary (bobot yang hanya dapat bernilai -1, 0, atau 1). Dalam GLU bebas MatMul, masukan terlebih dahulu ditransformasikan menggunakan dua lapisan BitLinear terpisah. Keluaran salah satu lapisan dilewatkan melalui fungsi aktivasi SiLU lalu dikalikan per-elemen dengan keluaran lapisan lainnya. Keluaran bertingkat (gated) ini kemudian dilewatkan melalui lapisan BitLinear lain untuk menghasilkan keluaran akhir.
Ini hanyalah penjelasan tingkat tinggi tentang komponen MLGRU dan GLU. Saya mendorong Anda untuk merujuk pada makalah penelitian asli untuk pemahaman lebih rinci tentang cara kerja internal dan formulasi matematisnya.
MatMul-free vs. Transformer
Riset ini menyelidiki hukum penskalaan model bebas MatMul, membandingkan kinerjanya dengan arsitektur Transformer tradisional saat ukuran model meningkat.
Kinerja dan skalabilitas
Secara mengejutkan, temuan menunjukkan bahwa kesenjangan kinerja antara kedua pendekatan ini menyempit seiring pertumbuhan ukuran model. Ini merupakan pengamatan penting karena menyiratkan bahwa model bebas MatMul semakin kompetitif dengan Transformer tradisional saat diskalakan, dan berpotensi melampauinya pada skala yang sangat besar.
Sumber: Rui-Jie Zhu dkk.
Grafik perbandingan hukum penskalaan ini menunjukkan bahwa kurva loss LM bebas MatMul dan transformer tradisional konvergen seiring meningkatnya jumlah operasi floating-point (FLOP).
Awalnya, LM bebas MatMul menunjukkan loss yang lebih tinggi karena kendala bobot ternary. Namun, kesenjangan ini menyusut saat ukuran model meningkat, dan pada titik tertentu (bintang), kurva loss berpotongan, menandakan kinerja yang sebanding. Ini menyiratkan hukum penskalaan yang lebih curam untuk model bebas MatMul, artinya kinerjanya meningkat lebih cepat seiring bertambahnya ukuran dibanding Transformer tradisional.
Hasil benchmark
Kinerja kompetitif LM bebas MatMul semakin ditegaskan oleh hasil yang kuat pada berbagai benchmark pembelajaran zero-shot. Dalam tugas seperti ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA, dan OpenbookQA, model-model ini sering tampil sebanding atau bahkan melampaui Transformer tradisional, meskipun kompleksitas komputasinya jauh lebih rendah. Ini menjadi bukti efektivitas operasi alternatif dan pilihan arsitektural yang digunakan dalam LM bebas MatMul.
Sumber: Rui-Jie Zhu dkk.
Tabel akurasi zero-shot menunjukkan bahwa LM bebas MatMul tampil kompetitif di berbagai tugas. Misalnya, pada ARC-Challenge, benchmark yang sangat sulit, LM bebas MatMul dengan 2,7 miliar parameter mencapai akurasi yang lebih tinggi daripada model transformer tradisional.
Demikian pula, pada tugas Winogrande dan OpenbookQA, LM bebas MatMul menunjukkan performa yang tangguh, mengindikasikan bahwa penghapusan MatMul tidak mengompromikan kemampuan model untuk memahami dan menghasilkan bahasa.
Efisiensi memori
Salah satu keunggulan paling mencolok dari LM bebas MatMul adalah efisiensi memorinya yang luar biasa. Dengan mengganti operasi yang sarat perkalian dengan penjumlahan dan pengurangan yang dimungkinkan oleh bobot ternary, model-model ini mencapai pengurangan penggunaan memori yang substansial.
Selama pelatihan, implementasi GPU yang dioptimalkan dapat mengurangi konsumsi memori hingga 61% dibandingkan model yang tidak dioptimalkan. Pada inferensi, penghematan memori bahkan lebih dramatis, dengan pengurangan lebih dari sepuluh kali lipat. Ini membuat LM bebas MatMul sangat menarik untuk diterapkan pada perangkat dengan sumber daya terbatas seperti ponsel pintar, di mana memori sering menjadi faktor pembatas.
Sumber: Rui-Jie Zhu dkk.
Grafik perbandingan memori GPU dan latensi ini menggambarkan peningkatan efisiensi LM bebas MatMul. Konsumsi memori inferensi LM bebas MatMul dengan 2,7 miliar parameter jauh lebih rendah dibanding Transformer tradisional yang sebanding. Jejak memori yang berkurang ini tidak hanya memungkinkan penerapan model yang lebih besar pada perangkat keras terbatas, tetapi juga berujung pada latensi yang lebih rendah, menjadikan model-model ini lebih cocok untuk aplikasi waktu nyata yang menuntut respons cepat.
Dari GPU Teroptimasi hingga Desain FPGA Kustom
Salah satu kemajuan kunci yang disajikan dalam makalah ini adalah implementasi GPU yang dioptimalkan untuk LM bebas MatMul. Para penulis mencapai peningkatan kecepatan pelatihan sebesar 25,6% dan pengurangan penggunaan memori hingga 61,0% dengan menggunakan kernel terfusi dalam implementasi GPU mereka. Kernel ini menggabungkan beberapa operasi menjadi satu proses yang lebih efisien, mengurangi overhead yang terkait dengan akses memori dan pergerakan data.
Untuk lebih memanfaatkan operasi ringan dari LM bebas MatMul, para penulis mengembangkan akselerator FPGA kustom dalam SystemVerilog. FPGA (Field-Programmable Gate Array) menawarkan platform perangkat keras yang fleksibel dan efisien untuk mengimplementasikan tugas komputasi khusus.
Akselerator kustom tersebut dirancang untuk memanfaatkan kesederhanaan operasi ternary dan produk per-elemen, sehingga meraih peningkatan efisiensi yang substansial. Implementasi RTL (Register Transfer Level) adalah hal kritis dalam proses desain FPGA. Ini melibatkan penentuan perilaku perangkat keras pada tingkat tinggi, yang kemudian disintesis menjadi konfigurasi FPGA aktual. Desain RTL kustom untuk LM bebas MatMul memastikan FPGA dapat menangani operasi ringan secara efisien, mengurangi konsumsi daya dan meningkatkan throughput.
Sumber: Rui-Jie Zhu dkk.
Gambar tersebut mengilustrasikan implementasi RTL dari akselerator FPGA kustom. Anda dapat melihat fungsi yang diimplementasikannya di sebelah kanan Register Router. Para penulis juga mengembangkan assembler mereka sendiri untuk mengonversi berkas assembly dengan instruksi kustom menjadi instruction ROM, yang dapat Anda lihat di sisi kanan gambar. Instruksi diberikan ke Register Router yang mengelola memori (Register File) dan mengeksekusi instruksi.
Selain itu, para penulis menyebutkan dalam komentar pada isu GitHub bahwa spesifikasi lengkap dari implementasi FPGA mereka masih dioptimalkan, dan kode SystemVerilog akan dipublikasikan nanti.
Tabel di bawah ini menunjukkan pemanfaatan sumber daya dan metrik kinerja untuk implementasi FPGA dari generasi token bebas MatMul.
Sumber: Rui-Jie Zhu dkk.
Data menunjukkan bahwa seiring bertambahnya jumlah inti (unit pemrosesan) dalam FPGA, latensi keseluruhan pada awalnya tetap relatif stabil. Namun, latensi meningkat signifikan dari 16 ke 26 inti, yang menunjukkan bahwa antarmuka DDR4, yang bertanggung jawab atas transfer data, menjadi bottleneck ketika permintaan transfer data tumbuh seiring jumlah inti.
Sementara operasi perkalian matriks ternary saat ini mendominasi latensi keseluruhan, para penulis memperkirakan bahwa pengoptimalan unit ini pada implementasi mendatang akan menggeser bottleneck ke antarmuka DDR4.
Salah satu klaim paling menarik dari makalah ini adalah bahwa pendekatan bebas MatMul membawa LLM lebih dekat ke efisiensi mirip otak dalam hal komputasi dan konsumsi energi. Para penulis berargumen bahwa model mereka meniru efisiensi jaringan saraf biologis dan mencapai kecepatan membaca yang mirip manusia.
Namun, secara langsung membandingkan efisiensi model-model ini dengan cara kerja kompleks jaringan saraf biologis adalah isu rumit yang memerlukan penyelidikan lebih lanjut. Mekanisme komputasi otak sangat berbeda dan jauh lebih kompleks daripada operasi yang disederhanakan yang digunakan dalam LM bebas MatMul.
Bebas MatMul: Implikasi dan Arah Masa Depan
Makalah "Scalable MatMul-free Language Modeling" menantang asumsi mendasar dalam pemrosesan bahasa alami: bahwa perkalian matriks (MatMul) itu esensial untuk membangun LLM berkinerja tinggi.
Dengan menunjukkan kelayakan arsitektur bebas MatMul, riset ini membuka frontier baru dalam desain LLM, mendorong eksplorasi operasi alternatif dan paradigma komputasi. Ini bisa memicu gelombang inovasi, dengan peneliti mengembangkan arsitektur model yang baru.
Akselerasi perangkat keras untuk model ringan
Peralihan menuju model bebas MatMul bukan hanya soal perangkat lunak—ini juga menyangkut perangkat keras. Chip tradisional seperti GPU unggul dalam perkalian matriks tetapi belum tentu paling cocok untuk model-model ringan yang baru ini.
Akselerator FPGA kustom yang dibangun para peneliti memberikan gambaran tentang masa depan perangkat keras AI—chip khusus yang dirancang untuk memeras setiap ons kinerja dari model-model efisien ini. Ini dapat melahirkan generasi baru perangkat bertenaga AI yang lebih cepat, lebih hemat energi, dan dapat diakses oleh khalayak yang lebih luas.
Dampak lingkungan dan keberlanjutan
Sebagai seseorang yang peduli pada lingkungan, saya sangat antusias dengan potensi model bebas MatMul untuk mengurangi jejak karbon AI. Konsumsi energi masif dari model bahasa besar saat ini adalah kekhawatiran nyata. Dengan secara signifikan mengurangi tuntutan komputasi, riset ini dapat membuka jalan bagi teknologi AI yang lebih hemat energi dengan jejak lingkungan yang lebih kecil.
Pertanyaan riset terbuka dan arah selanjutnya
Walaupun makalah "Scalable MatMul-free Language Modeling" menghadirkan lompatan besar, ia juga membuka sejumlah jalur riset lanjutan—mengeksplorasi beragam arsitektur bebas MatMul, mengevaluasi kinerjanya pada rentang tugas yang lebih luas, dan memahami secara matematis batas teoretis pendekatan ini hanyalah beberapa arah riset yang menarik.
Selain itu, pengembangan benchmark dan metrik evaluasi standar khusus untuk model bebas MatMul akan memfasilitasi perbandingan yang adil dan mempercepat kemajuan di bidang ini. Perjalanan menuju AI yang benar-benar efisien dan mudah diakses baru saja dimulai, dan kemungkinannya tak terbatas. Saya pribadi juga sangat antusias untuk mencoba chatbot asisten bebas MatMul di masa depan!
Kesimpulan
Makalah "Scalable MatMul-free Language Modeling" memberikan kontribusi signifikan pada bidang LLM dengan memperkenalkan pendekatan baru yang menghilangkan operasi perkalian matriks (MatMul).
Terobosan ini mengatasi bottleneck komputasi dan memori yang terkait dengan LLM tradisional, membuka jalan bagi model yang lebih efisien dan dapat diskalakan. Dengan memanfaatkan operasi aditif dan bobot ternary, para penulis menunjukkan bahwa mungkin untuk mempertahankan kinerja kompetitif sambil secara signifikan mengurangi kebutuhan sumber daya.
Dampak potensial dari riset ini terhadap masa depan pengembangan dan penerapan LLM sangat besar. Model bebas MatMul menawarkan alternatif yang layak bagi arsitektur konvensional, memungkinkan pembuatan model ringan dan efisien yang sangat cocok untuk lingkungan dengan sumber daya terbatas seperti perangkat edge dan platform seluler.
Jika Anda ingin mempelajari lebih lanjut tentang kecerdasan buatan, lihat kursus AI ini.