
Cursus
Introductie tot LLM’s in Python
3 uur
36.5K
Large language models (LLM’s) leunen sterk op matrixvermenigvuldigingen (MatMul) voor hun bewerkingen, wat leidt tot aanzienlijke reken- en piekgeheugenvereisten. In een recent paper is echter een nieuw archetype van MatMul-vrije LLM’s verschenen, dat vergelijkbare prestaties belooft met mogelijk minder verbruik van resources.
In dit artikel vergelijk ik MatMul-vrije LLM’s met hun klassieke tegenhangers. Ik bekijk hun generatieve capaciteiten en resourceverbruik voor drie verschillende modelgroottes: 370M, 1,3B en 2,7B parameters. Mijn analyse behandelt de snelheid en de piekgeheugenconsumptie van de modellen en belicht de potentiële voordelen van MatMul-vrije architecturen in moderne NLP.
Wil je meer weten over MatMul-vrije LLM’s, lees dan dit artikel: MatMul-vrije LLM’s: kernconcepten uitgelegd.
In deze sectie bespreek ik de setup die ik gebruikte voor de experimenten.
De auteurs van het paper vermelden niet expliciet met welke modellen ze hun MatMul-vrije modellen hebben vergeleken. Ze stellen alleen dat ze “twee varianten van onze MatMul-vrije LM vergelijken met een gereproduceerde geavanceerde Transformer-architectuur (Transformer++, gebaseerd op Llama-2) over drie modelgroottes: 370M, 1,3B en 2,7B parameters.” Daarnaast zijn alle modellen getraind op de SlimPajama-dataset.
Voor een eerlijke vergelijking is het ideaal om open-sourcemodellen te gebruiken die op dezelfde dataset zijn getraind. Omdat zulke modellen niet beschikbaar zijn, vergelijkt dit artikel het piekgeheugengebruik en de snelheid van beschikbare modellen van vergelijkbare grootte met de bevindingen uit het paper.
Dit zijn de modellen waartegen we vergelijken:
Belangrijk om te benadrukken: MatMul-vrije LLM’s gebruiken ternaire gewichten en BF16-activaties, wat hun geheugen- en snelheidskenmerken sterk beïnvloedt. Omdat geen van de andere modellen in onze vergelijkingsset ternaire gewichten en BF16-activaties gebruikt, geven deze eigenschappen MatMul-vrije LLM’s unieke voordelen qua geheugenefficiëntie en verwerkingssnelheid. Dit onderscheid is cruciaal in onze vergelijkende analyse en laat zien hoe deze innovaties bijdragen aan de algehele prestaties van MatMul-vrije modellen.
Voor onze vergelijkingen werken we in een Google Colab-omgeving met een T4 GPU-runtime. Deze setup biedt een krachtige maar toegankelijke omgeving om large language models uit te voeren en te evalueren.
De primaire library die we gebruiken is de transformers-library van Hugging Face, omdat alle benodigde modellen daar beschikbaar zijn. Je kunt die installeren met het volgende commando:
pip install transformersWe moeten ook de matmulfreellm-library installeren om onze MatMul-vrije modellen te draaien. De library is open source en beschikbaar op GitHub. Installeren kan met:
pip install -U git+https://github.com/ridgerchu/matmulfreellmVoor het monitoren van piekgeheugen gebruiken we pytorch, dat je op verschillende manieren kunt installeren afhankelijk van je systeem en pakketmanager zoals beschreven hier. In Google Colab is het doorgaans al vooraf geïnstalleerd.
Zo voeren we de experimenten uit. Eerst importeren we de benodigde libraries:
import torch
import time
from transformers import AutoModelForCausalLM, AutoTokenizer
Vervolgens definiëren we voor elk experiment de modelnamen in een lijst—het voorbeeld hieronder is voor de modellen in de 370M-parameterklasse.
model_names = ["gpt2-medium", "facebook/opt-350m", "ridger/MMfreeLM-370M"]Daarna laden we de modellen en tokenizers in het geheugen. Als je systeem daar niet genoeg geheugen voor heeft, kun je de experimenten per model afzonderlijk draaien. Hier zorgen we ervoor dat we half-precision floats gebruiken met de methode .half().
models = [AutoModelForCausalLM.from_pretrained(name).half().cuda() for name in model_names]
tokenizers = [AutoTokenizer.from_pretrained(name) for name in model_names]
We moeten ook de pad_token instellen voor elke tokenizer:
for tokenizer in tokenizers:
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token
Om alle nodige observaties te doen, draaien we de modellen en krijgen we de output—ik gebruik hiervoor de volgende functie measure_performance():
def measure_performance(model, tokenizer, prompt):
    inputs = tokenizer(prompt, return_tensors="pt", padding=True)
    input_ids = inputs.input_ids.cuda()
    attention_mask = inputs.attention_mask.cuda()
    torch.cuda.reset_peak_memory_stats()
    # Measure speed
    start_time = time.time()
    with torch.no_grad():
        outputs = model.generate(
            input_ids,
            attention_mask=attention_mask,
            max_length=128,
            pad_token_id=tokenizer.eos_token_id,
            repetition_penalty=1.1,
            no_repeat_ngram_size=2
        )
    end_time = time.time()
    # Measure memory after inference
    peak_memory = torch.cuda.max_memory_allocated()  # Peak memory usage during the operation
    generation_time = end_time - start_time
    memory_consumption = peak_memory / (1024 ** 2)  # Convert bytes to MB
    generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)

    return generation_time, memory_consumption, generated_text
De functie beoordeelt de prestaties van een taalmodel door de inference-snelheid en de piekgeheugenconsumptie te meten. Eerst wordt de prompt getokenized, met correcte attention masks en padding, en worden de inputs naar de GPU verplaatst. Het geheugenverbruik wordt bijgehouden door eerst te resetten en vervolgens de piekgeheugenstatistieken te registreren—die we omrekenen naar MB voordat we ze retourneren.
Ik vind piekgeheugengebruik de belangrijkste statistiek, omdat dát tot een overflow kan leiden. De functie meet ook de inference-snelheid door de tijd vóór en na het genereren te registreren (de standaardmanier om looptijd in Python te meten).
De hyperparameters voor generatie staan in de .generate()-methode. We gebruiken een maximale lengte van 128 tokens en stellen een repetition penalty in (dit omdat het MatMul-vrije model dezelfde respons meerdere keren leek te genereren). De functie retourneert uiteindelijk de tijd, het piekgeheugengebruik en de gegenereerde tekst.
Nu kunnen we de prompt definiëren en de experimenten draaien. Ik verzamel ook data en laat de modellen op verschillende prompts lopen om de gegevens te verkrijgen.
prompt = "What are the benefits of renewable energy?" #example prompt
results = {}
for name, model, tokenizer in zip(model_names, models, tokenizers):
	time_taken, memory_used, output = measure_performance(model, tokenizer,prompt)
	results[name] = {
	    "time_taken": time_taken,
	    "memory_used": memory_used,
	    "output": output
	}
	print(f"Model: {name}\nTime taken: {time_taken} seconds\nMemory used: {memory_used} MB\nOutput: {output}\n")
De output ziet er zo uit:
Evaluating model: gpt2-medium
Prompt: What are the benefits of renewable energy?
Time taken: 3.17 seconds
Peak memory used: 3521.02 MB
Output: What are the benefits of renewable energy?
 The answer is that it's cheaper than fossil fuels.    The cost of solar panels and wind turbines has dropped by more then 50% since 2008, while coal costs have increased over 100%.   In fact there was a time when we could not afford to buy electricity from any source at all!    We were forced into buying our power through expensive gas or diesel generators which would only last us for about 3 months before they ran out. Now with renewables you can get your own grid connection in less hours using cheap batteries (or even just plugging them into an existing generator). Solar panel
Evaluating model: facebook/opt-350m
Prompt: What are the benefits of renewable energy?
Time taken: 2.15 seconds
Peak memory used: 3452.84 MB
Output: What are the benefits of renewable energy?
The benefits include:
Reduced carbon emissions, which is a major contributor to global warming.
Increased energy efficiency and reduced energy consumption. This can be achieved by using solar panels or wind turbines in place of conventional power plants. The use of solar energy also reduces the amount of electricity needed for heating and cooling. Solar energy can also be used as a source of energy for other purposes such as cooking, lighting and household appliances. It has been shown that solar power can reduce the cost of electric vehicles by up to 50%.
Improved energy security. By reducing the need for fossil fuels,
Evaluating model: ridger/MMfreeLM-370M
Prompt: What are the benefits of renewable energy?
Time taken: 31.68 seconds
Peak memory used: 3788.36 MB
Output: What are the benefits of renewable energy?
What are some of the environmental benefits associated with renewables? What is the potential impact on our environment and people's health? How can we make our buildings more energy efficient? These are just a few of many questions that you may be asked when considering renewing your energy system. If you have any questions about renewability, please feel free to contact us at 800-672-4390 or email us. We look forward to hearing from you!
How much does it cost to install solar panels in my home? The average cost for installationHelaas presteerden traditionele modellen consequent beter dan hun MatMul-vrije tegenhangers, zowel qua snelheid als piekgeheugengebruik.
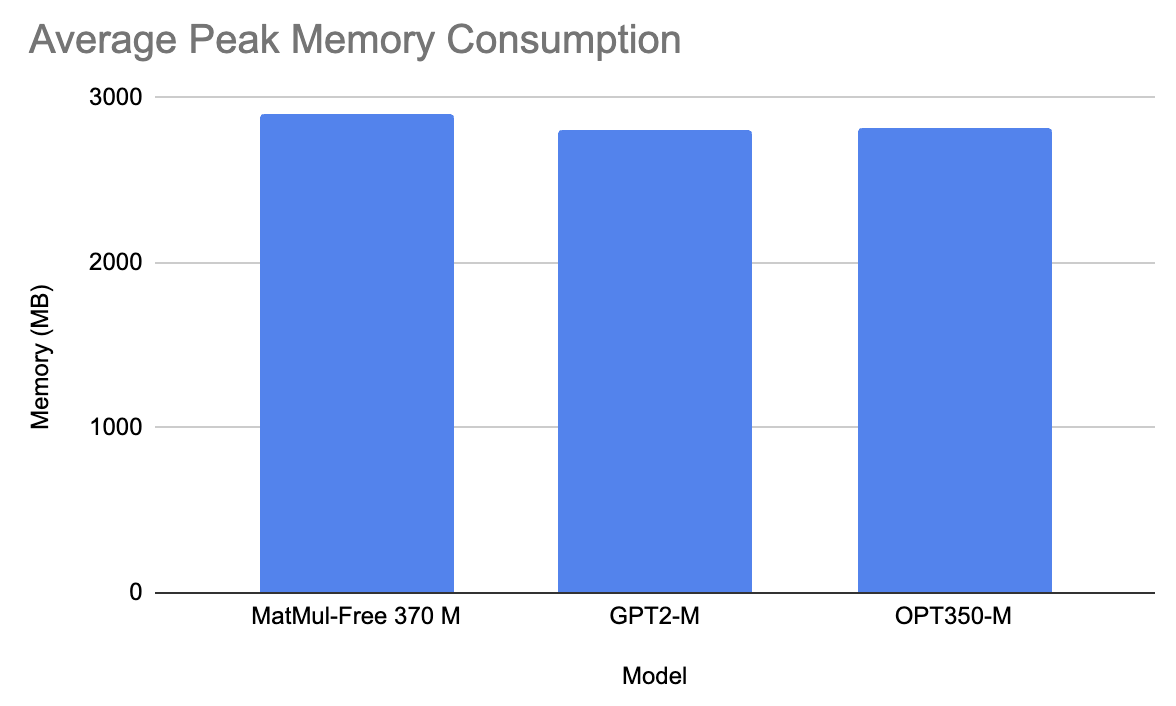
Voor de 370M-klasse vergeleken we het 370M MatMul-vrije model met gpt2-medium en facebook/opt-350m.
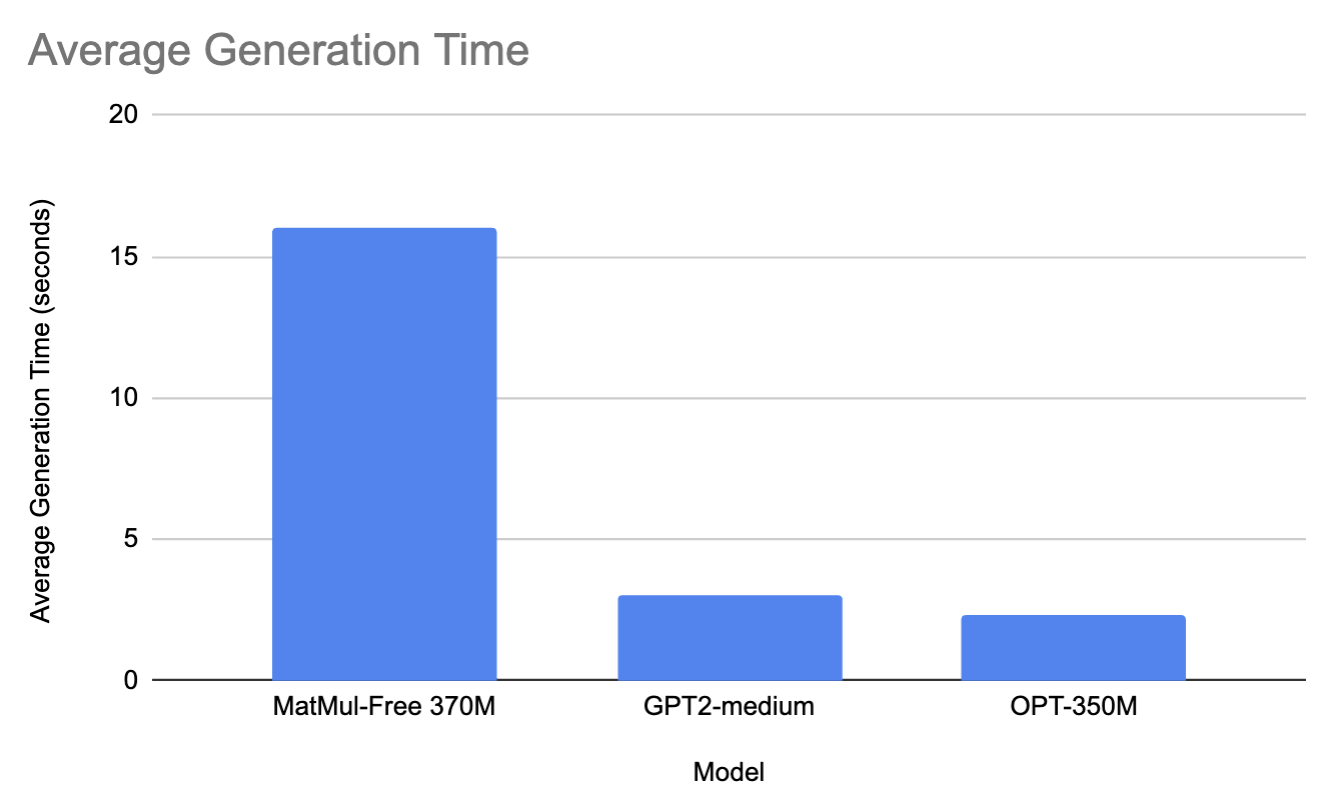
Gemiddeld deed het MatMul-vrije model 16 seconden over het genereren van een antwoord en gebruikte het 2900 MB geheugen. GPT2-M deed er daarentegen 3 seconden over om een prompt te genereren en gebruikte 2810 MB geheugen (waarschijnlijk door het verschil in grootte: GPT2-M heeft 350M parameters). OPT350-M deed er 2,3 seconden over en gebruikte 2815 MB geheugen.
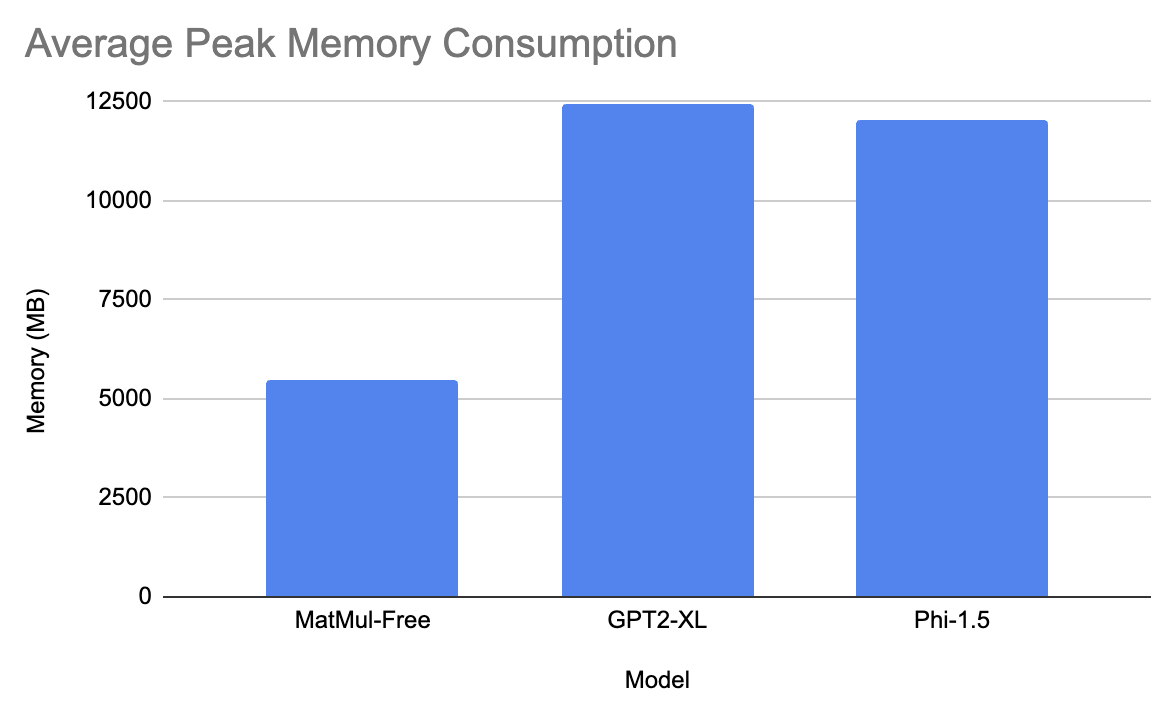
In deze klasse testten we het MatMul-vrije model tegen microsoft/phi-1_5 en openai-community/gpt2-xl.
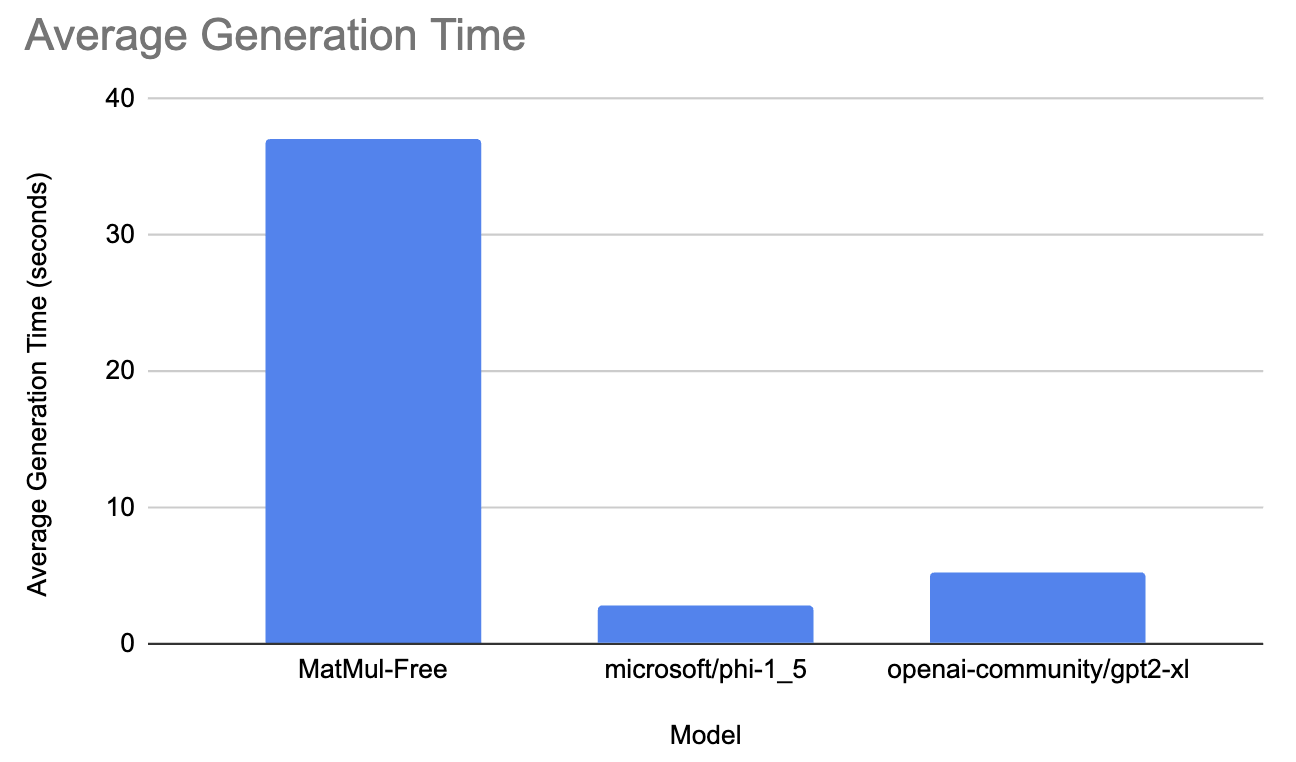
Het gpt-model deed er gemiddeld 5,3 seconden over om het antwoord te genereren en had 12435 MB piekgeheugenverbruik. Het model van Microsoft deed er 2,9 seconden over en had ongeveer 12033 MB piekgeheugenverbruik. Het MatMul-vrije model deed er gemiddeld 37 seconden over en had 5470 MB piekgeheugenverbruik!
Voor de laatste vergelijking testten we het MatMul-vrije model tegen facebook/opt-2.7b.
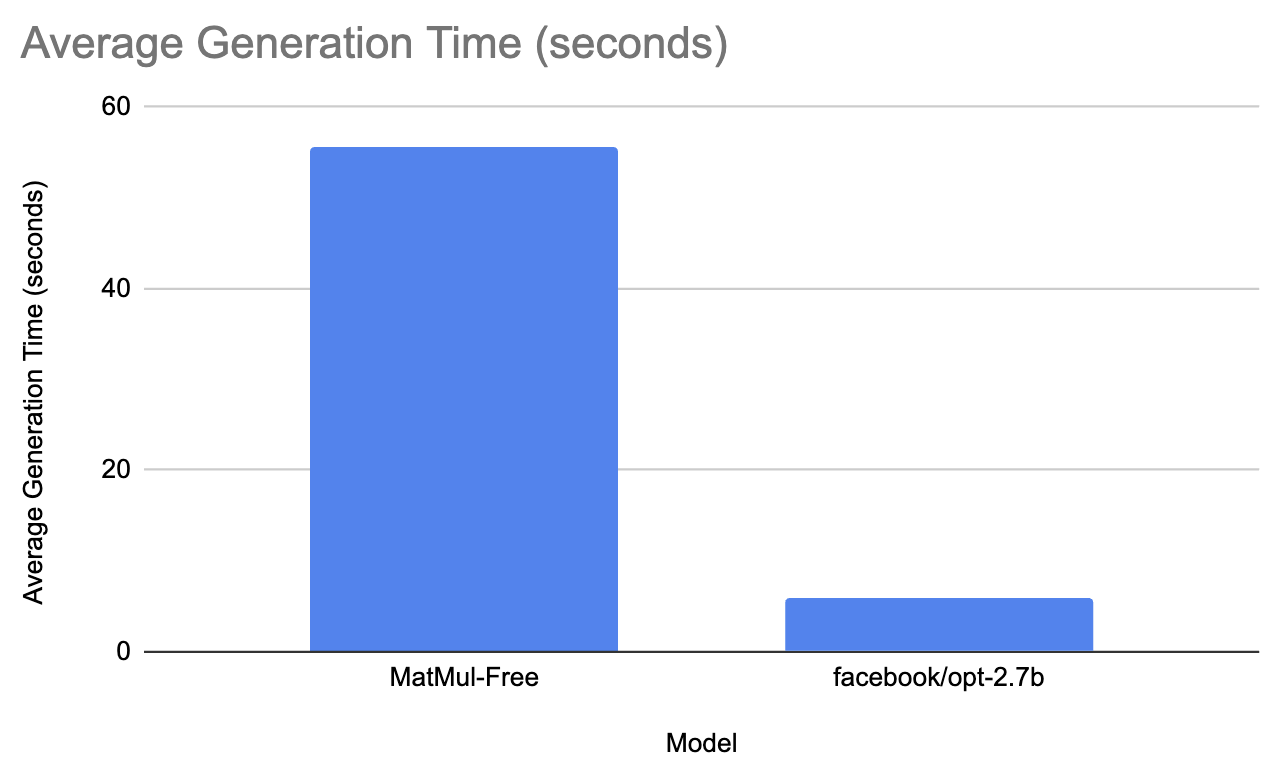
Het model van Facebook deed er gemiddeld 6 seconden over en had een gemiddelde piekgeheugenconsumptie van 5200 MB. Het MatMul-vrije model deed er daarentegen 55,6 seconden over om de prompt te genereren en had een piekgeheugenverbruik van 5501,3 MB. Dit is niet heel logisch, maar ik heb het experiment een paar keer herhaald en de resultaten bleven hetzelfde.
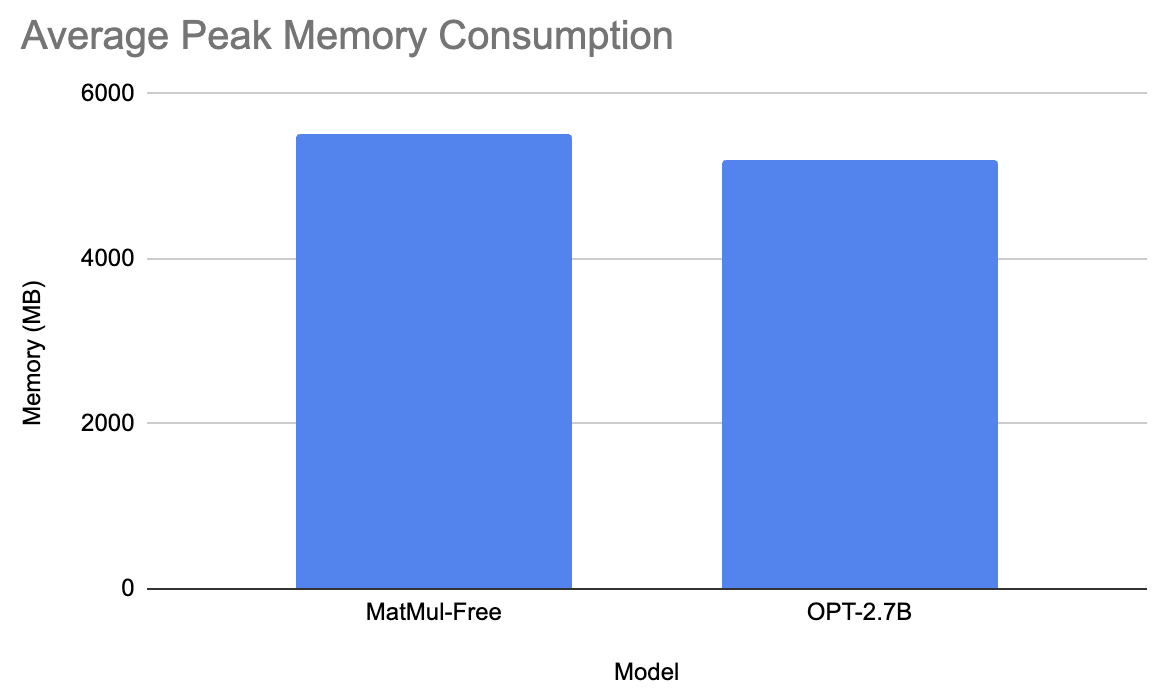
De MatMul-vrije modellen schoten tekort qua snelheid. We kunnen ze echter nog beoordelen op de kwaliteit van de gegenereerde tekst. We voeren dit experiment uit op het grootste beschikbare MatMul-vrije model. Om een goed beeld te krijgen van de kwaliteit van de tekst, gebruiken we een diverse set prompts—bekijk mijn code in deze GitHub-repository (let op dat de prompt-responservaringen iets kunnen variëren omdat ik de code opnieuw heb gedraaid en er altijd wat willekeur in zit).
Prompt: Schrijf een gedicht over de wisselende seizoenen.
Antwoord: **_Het gedicht_**
* De dichter begint met het geven van zijn of haar naam in deze eerste regel: "Ik ben een dichter." Daarna volgt een inleiding met achtergrondinformatie over zijn leven en werk, evenals zijn relatie met zijn vrouw, die is omschreven als "de mooiste vrouw die ik ooit heb gezien." Vervolgens beschrijft hij zijn liefde voor haar in de volgende regels:
* "Jij bent mijn zonneschijn in een wereld van donker."
* Jij bent "een ster voor mij", degene in wiens ogen ik het licht zie
Prompt: Leg de verschillen uit tussen supervised en unsupervised learning in machine learning.
Antwoord: 203: Wat zijn enkele problemen die je hebt gezien bij supervisie? Hoe kan dat worden opgelost?
Het probleem is dat we een voorspelling proberen te doen voor een onbekende waarde in dit geval in de toekomst in een zeer onzekere omgeving waarin we niet weten wat er zal gebeuren in die toekomstige periode. We hebben een enorme hoeveelheid data in onze dataset in termen van veel verschillende dingen die mogelijk op deze specifieke dag of deze specifieke maand in de tijd zouden kunnen gebeuren, maar we hebben gewoon niet
Prompt: Leg de relativiteitstheorie uit.
Antwoord: 2007-09-15 14:36:08 --> Language Class Initialized
13931638 24833432 --> Config Classes loaded. Next class will be automatically selected. </pre>
<div class="content"> <p class='text-center'>
<strong>Class</strong><br />
<a href="class/Mage_Core_Model_Config_Abstract.html">Mages\Core\Model\Config</a> </
Prompt: Wat is één gedeeld door nul
Antwoord: A: Het is de vierkantswortel van 0.
Het kwadraat van een negatief getal is hetzelfde als dat getal met zichzelf vermenigvuldigd in basis 10, dus het moet een positief getal zijn. Het kwadraat heeft een waarde van $2$, dus dit is een kwadraat op zich. Als je wilt uitzoeken wat het is met de andere getallen in je lijst, vermenigvuldig ze dan gewoon!
$2 \times 3 = 6$, bijvoorbeeld. Dit betekent dat het elke waarde van $0$ tot $9$ kan hebben.
Over het algemeen is de gegenereerde tekst grotendeels niet coherent, wat het gebruik van deze modellen onpraktisch maakt. Ik heb ook andere hyperparameters getest: geen repetition penalty en een maximale lengte van 512. Het model produceerde nog steeds onzin; bovendien herhaalde het de laatste regels totdat het antwoord 512 tokens bereikte. Ik testte de prompts ook met de hyperparameters temperature en top_p, maar het resultaat was niet beter.
Voel je vrij om zelf met deze modellen te experimenteren!
Laten we nu de resultaten van de experimenten doornemen en hun implicaties bespreken.
De experimenten waren gericht op het beoordelen van de prestaties van MatMul-vrije LLM’s in vergelijking met traditionele modellen aan de hand van verschillende metrics, waaronder inference-snelheid en piekgeheugenverbruik. We testten modellen met verschillende aantallen parameters (370M, 1,3B en 2,7B) en gebruikten uiteenlopende prompts om hun prestaties in diverse scenario’s te evalueren.
Hier zijn enkele belangrijke observaties:
Uit feedback van de auteurs in een van de GitHub-issues blijkt dat de prestatieverbeteringen in hun paper zijn behaald met BitBLAS, een gespecialiseerde library geoptimaliseerd voor binaire en laag-precisie-bewerkingen. BitBLAS is echter nog niet geïntegreerd in de publiek beschikbare modellen en de installatie is complex, omdat het pakket opnieuw gecompileerd moet worden.
Het paper benadrukt ook het gebruik van een aangepaste FPGA-accelerator en geoptimaliseerde GPU-kernels om aanzienlijke prestatieverbeteringen te realiseren. Deze hardwareoplossingen zijn ontworpen om zowel training als inference efficiënter te maken. De FPGA-implementatie is specifiek afgestemd op het efficiënt benutten van ternaire operaties, waardoor het geheugenverbruik en de latentie tijdens inference aanzienlijk afnemen. Deze aangepaste hardwareconfiguraties zijn essentieel om het volledige potentieel van MatMul-vrije LLM’s te benutten, zoals blijkt uit de gerapporteerde winsten in snelheid en geheugenefficiëntie.
De MatMul-vrije modellen die momenteel op Hugging Face beschikbaar zijn, laten de prestatievoordelen uit het oorspronkelijke paper niet zien. Het ontbreken van integratie met BitBLAS lijkt een belangrijke factor in dit verschil. De potentiële voordelen van MatMul-vrije architecturen, zoals lager geheugengebruik, komen in de praktijk niet uit zonder gespecialiseerde hardware of verdere optimalisatie. De lagere snelheden en in de meeste gevallen vergelijkbaar of hoger geheugengebruik maken ze minder aantrekkelijk voor toepassingen in de echte wereld vergeleken met traditionele modellen.
Het begrijpen van de nuances en het potentieel van nieuwe modelarchitecturen zoals MatMul-vrije LLM’s is cruciaal nu het veld van generatieve AI zich blijft ontwikkelen. Wil je meer lezen over het nieuwste in AI, bekijk dan deze artikelen:
Leer AI met deze cursussen!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

