
Kursus
Konsep Large Language Models (LLM)
2 jam
113.4K
Saat OpenAI merilis ChatGPT pada 2022, banyak yang bertanya-tanya apakah perusahaan lain bisa menyaingi produk sebagus itu yang didukung oleh raksasa seperti Microsoft. Ketika perhatian semua orang tertuju pada raksasa teknologi lain seperti Google dan Meta untuk menghadirkan tandingan, muncullah Mistral AI dengan model 7B pada 2023, yang melampaui semua LLM sumber terbuka dengan ukuran hampir dua kali lipat.
Sejak itu, Mistral AI menjadi pemain besar dalam persaingan LLM. Pada April 2024, mereka merilis Mixtral 8X22B, model yang dengan mudah mengungguli LLM sumber terbuka terbaik saat itu, Llama 2, pada banyak tolok ukur.
Dalam tutorial ini, kita akan membahas model Mixtral 8X22B secara mendalam, mulai dari arsitekturnya hingga menyiapkan pipeline RAG dengannya.
Mixtral 8X22B adalah model terbaru yang dirilis oleh Mistral AI. Model ini mengusung arsitektur sparse mixture of experts (SMoE) dengan 141 miliar parameter. Arsitektur SMoE inilah yang memberikan banyak keunggulannya. SMoE adalah jenis jaringan saraf yang menggunakan beragam model kecil (expert) untuk tugas berbeda, hanya mengaktifkan yang dibutuhkan guna menghemat waktu dan daya komputasi.
Pertama-tama, model ini menawarkan efisiensi biaya yang tak tertandingi untuk ukurannya, memberikan rasio kinerja terhadap biaya terbaik di komunitas sumber terbuka:
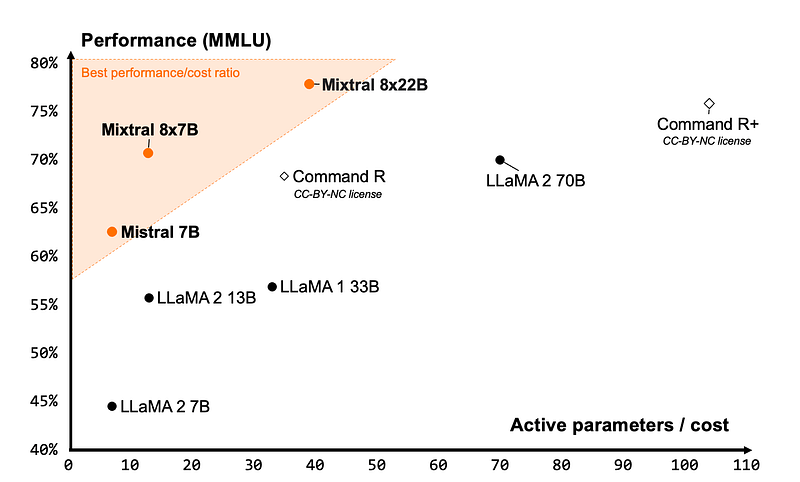
Gambar di atas menampilkan beberapa LLM sumber terbuka terkemuka dan jumlah parameter aktif yang mereka perlukan untuk mencapai ambang kinerja tertentu. Mixtral berada tepat di kiri atas, yang berarti ia menggunakan parameter jauh lebih sedikit untuk mencapai kinerja +75% dibandingkan model lain di kisaran yang sama — Command R+.
Meskipun Mixtral 8X22B memiliki 141 miliar parameter, pola aktivasi sparsenya hanya menggunakan 39 miliar parameter saat inferensi. Ini membuatnya berkinerja tinggi dan lebih cepat daripada model padat 70 miliar parameter seperti Llama 2 70B. Model ini juga memiliki jendela konteks 64k token, yang sangat jarang untuk LLM sumber terbuka saat ini.
Model ini juga hadir dengan lisensi sumber terbuka paling permisif — Apache 2.0. Dikombinasikan dengan biaya rendah untuk menjalankannya, Mixtral 8X22B adalah pilihan yang sangat baik untuk skenario fine-tuning.
Mixtral 8x22B lolos tolok ukur industri standar dengan sangat baik. Pada sebagian besar tolok ukur, penekanan diberikan pada seberapa baik model ini dibandingkan alternatif serupa utamanya:
Sebagai contoh, Mixtral 8X22B fasih dalam lima bahasa: Inggris, Jerman, Prancis, Spanyol, dan Italia. Buktinya dapat dilihat pada tabel berikut:
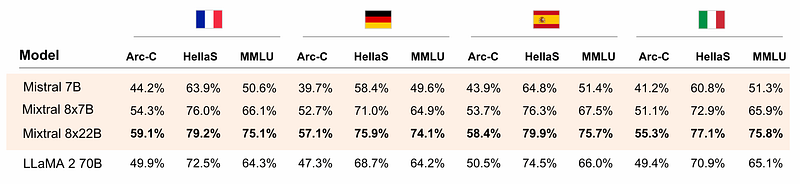
Model ini mengungguli Llama 2 70B pada tugas bahasa di tiga tolok ukur:
Untuk penalaran akal sehat murni dan pertanyaan pengetahuan dalam bahasa Inggris, Mixtral kembali tampil sangat baik:
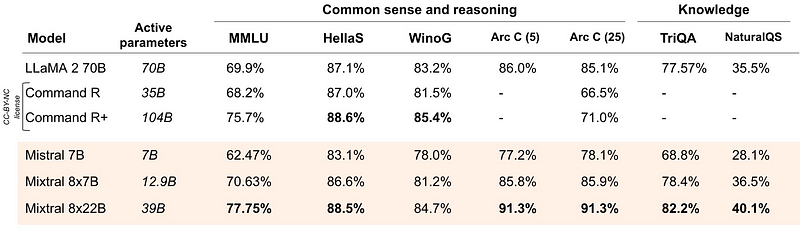
Model ini sedikit lebih buruk daripada Command R+ pada dua tolok ukur, tetapi pada yang lain, jauh lebih baik.
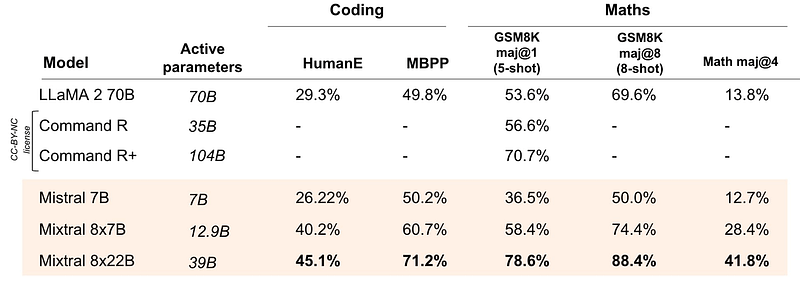
Dan poin paling menentukan—Mixtral 8X22B unggul telak atas semua alternatifnya dalam tugas matematika dan pengodean:
Sekarang, mari kita lihat bagaimana model ini meraih kinerja terdepan.
Untuk memahami arsitektur sparse mixture of experts (SMoE) dengan lebih baik, kita akan menggunakan analogi sederhana. Misalkan ada 100 orang yang mengerjakan sebuah proyek.
Model SMoE memiliki komponen kunci berikut:
Struktur model seperti ini memiliki banyak manfaat:
Namun, karena masih baru, model SMoE menghadirkan tantangan unik yang belum tertangani secara efektif:
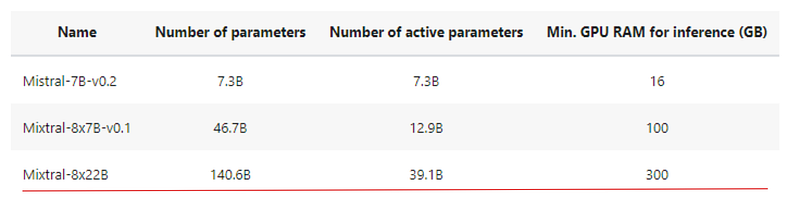
Singkatnya, karena skala model adalah salah satu faktor terpenting untuk kualitas model yang lebih baik, mengurangi jumlah parameter aktif membuat model jauh lebih murah dan lebih cepat untuk dilatih. Melatih model yang lebih besar dengan langkah lebih sedikit lebih baik daripada melatih model kecil dengan langkah lebih banyak ketika anggaran komputasi terbatas.
Arsitektur mixture of experts memungkinkan model dilatih dengan komputasi jauh lebih sedikit, yang memungkinkan Anda meningkatkan ukuran model secara drastis dengan anggaran yang sama seperti model padat. Model SMoE apa pun seharusnya mencapai kualitas yang sama dengan padanannya yang padat jauh lebih cepat selama pra-pelatihan.
Di bagian ini, kita akan mempelajari cara mulai menggunakan model Mixtral 8X22B dengan Mistral API. Karena model ini berukuran sekitar 80 gigabita dan memerlukan GPU 300 gigabita, akan cukup sulit dan mahal untuk menjalankannya di penyedia cloud mana pun, apalagi di perangkat konsumen.
Mistral AI mengharuskan Anda membuat akun dan memasukkan informasi penagihan untuk mendapatkan kunci API. Jadi, silakan kunjungi mistral.ai untuk membuat akun Anda. Setelah masuk dengan kredensial Anda, Anda akan diarahkan ke konsol Mistral di console.mistral.ai.
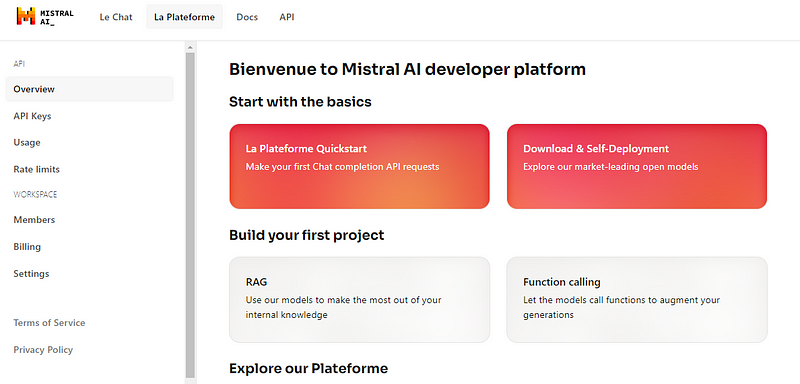
Selanjutnya, masuk ke "Billing" dan tambahkan informasi pembayaran Anda:
Lalu, tambahkan sejumlah kredit:
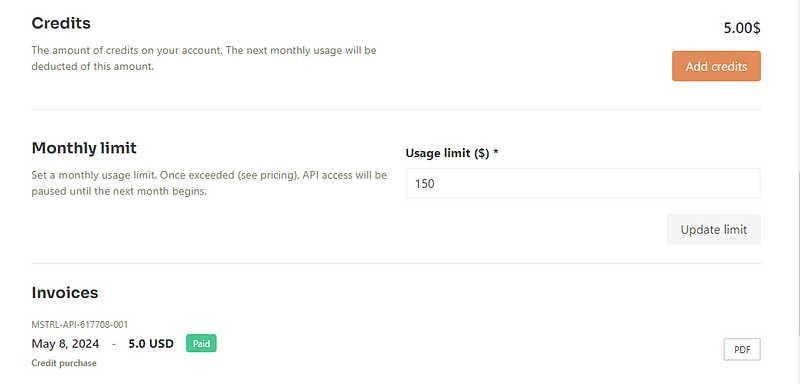
Ini akan memungkinkan Anda membuat kunci API dari bagian "API KEYS":
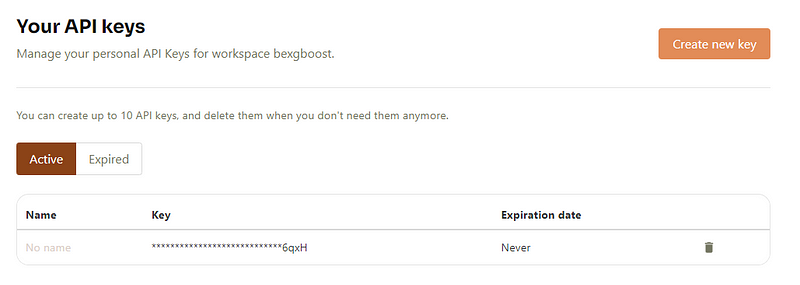
Saat Anda membuat kunci, kunci tersebut hanya akan ditampilkan sekali, jadi simpanlah di tempat yang aman. Kita akan menggunakannya di bagian berikutnya.
Sekarang, mari kita menyiapkan lingkungan virtual untuk menjalankan Mistral API. Kita akan menggunakan Conda:
$ conda init  # Run if your Conda executable is new
$ conda env create -n mistral python==3.8 -y
$ conda activate mistral
Kemudian, kita dapat memasang paket Python mistralai beserta beberapa kebutuhan lain:
$ pip install mistralai
$ pip install python-dotenv ipykernel
$ ipython kernel install --user --name=mistral
Perintah terakhir menambahkan lingkungan Conda yang baru dipasang sebagai kernel Jupyter.
Kita akan menggunakan paket python-dotenv untuk membaca kunci API Mistral kita secara aman dari notebook. Untuk melakukannya, buat berkas .env di direktori kerja Anda:
$ touch .envLalu, sunting berkas tersebut agar memuat kunci Anda dengan sintaks berikut:
MISTRAL_API_KEY=YOUR_KEY_HEREPastikan juga menambahkan berkas .env ke .gitignore agar tidak bocor secara tidak sengaja ke GitHub:
$ echo ".env" >> .gitignore
Sekarang, untuk membaca kunci yang baru saja kita simpan, kita dapat menggunakan fungsi load_dotenv bersama pustaka os:
import os
from dotenv import load_dotenv

load_dotenv()

api_key = os.getenv("MISTRAL_API_KEY")
Akhirnya, untuk berinteraksi dengan model Mistral mana pun, kita akan menggunakan objek MistralClient:
from mistralai.client import MistralClient

client = MistralClient(api_key=api_key)
Klien memerlukan kunci API kita untuk terhubung ke server Mistral. Lalu, kita akan mengimpor kelas ChatMessage untuk menampung dialog dengan model Mistral:
from mistralai.models.chat_completion import ChatMessage

model = "open-mixtral-8x22b"

message = "Who is the best French football player of all time?"

chat_response = client.chat(
   model=model,
   messages=[ChatMessage(role="user", content=message)],
)

print(chat_response.choices[0].message.content[:300])
Determining the "best" French football player of all time can be subjective and depends on personal opinion. However, one player who is often mentioned in this context is Zinedine Zidane. He had an impressive career both for the French national team and at club level. He was a key player in France'sKita mendapat respons — jadi, semuanya sudah tersetel dengan benar.
Objek ChatResponse biasanya memuat lebih dari satu jawaban, jadi kita memilih yang pertama dan mencetak sebagian teksnya.
Di luar pembuatan teks biasa, Anda dapat melakukan lebih banyak hal dengan Mixtral:
dan seterusnya. Kita akan melihat masing-masing skenario ini satu per satu.
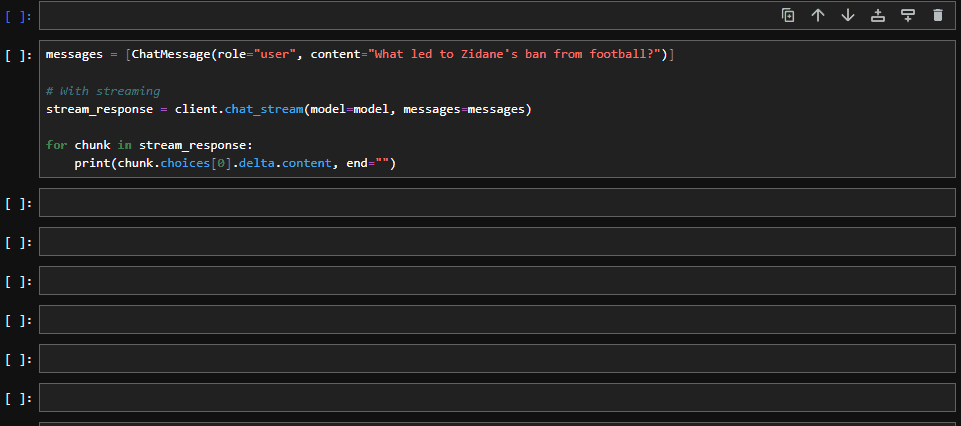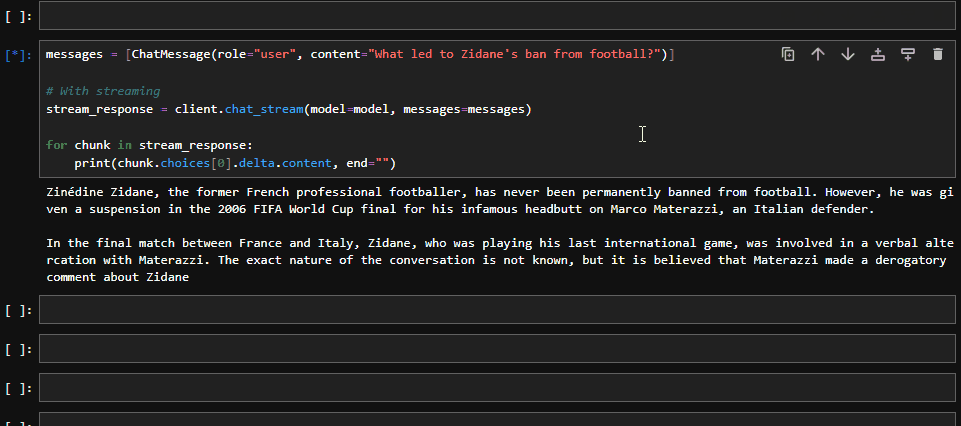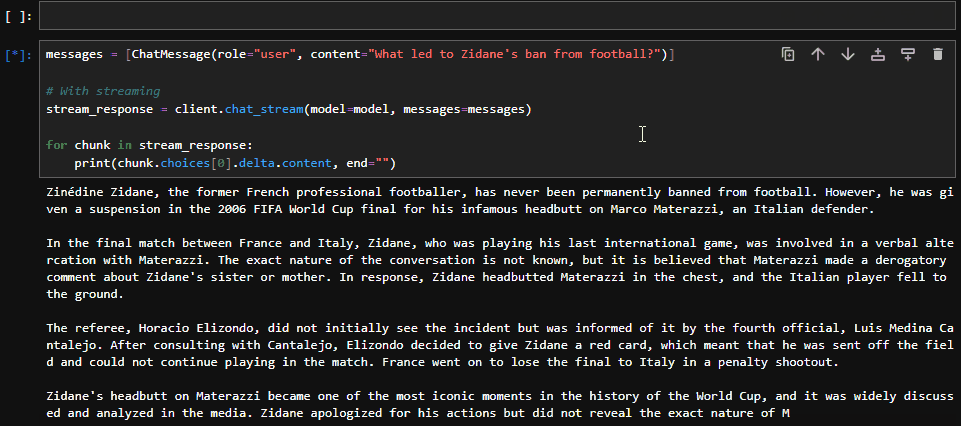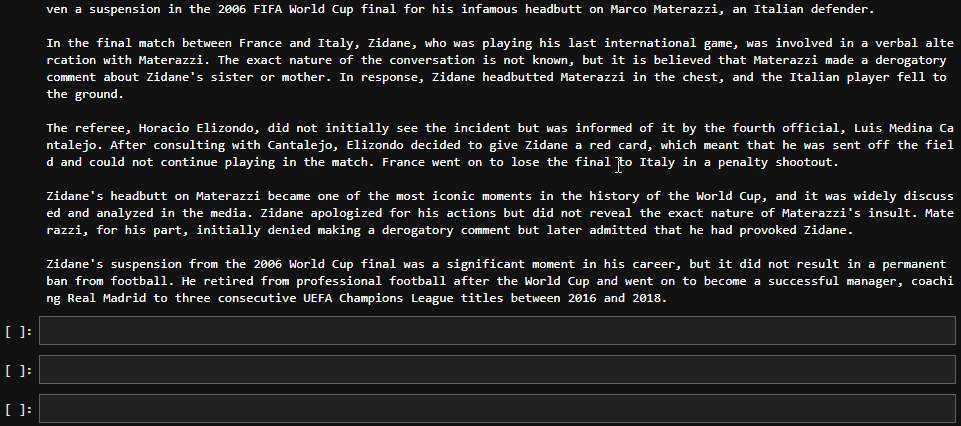
Pada bagian sebelumnya, kita dapat menghasilkan teks dalam jumlah besar dari klien chat. Dalam beberapa kasus, ketika kita menduga jawabannya mungkin lebih panjang, masuk akal untuk melakukan streaming keluaran seperti di ChatGPT. Kita juga bisa melakukannya dengan Mixtral
messages = [ChatMessage(role="user", content="What led to Zidane's ban from football?")]

# With streaming
stream_response = client.chat_stream(model=model, messages=messages)

for chunk in stream_response:
   print(chunk.choices[0].delta.content, end="")
Alih-alih metode chat, kita dapat menggunakan chat_stream yang memberikan jawaban sesuai permintaan, dalam potongan:
Embedding adalah komponen kunci dari aplikasi LLM. Embedding adalah representasi vektor dari teks yang menangkap makna semantiknya melalui posisi dalam ruang vektor berdimensi tinggi. Jika jarak antara dua embedding dekat, itu berarti keduanya mirip secara makna. Misalnya, kata apple akan lebih dekat ke orange daripada ke keyboard di ruang embedding.
Mistral API menawarkan model embedding teks terbaik di kelasnya. Mari kita lihat sekilas cara kerjanya:
to_embed = ["Is Messi better than Zidane?", "How about Ronaldo?"]

embeddings_batch_response = client.embeddings(
   model="mistral-embed",
   input=to_embed,
)

type(embeddings_batch_response)
mistralai.models.embeddings.EmbeddingResponse
Pertama, kita membuat daftar kalimat yang akan di-embed dalam to_embed. Lalu, kita oper ke metode embeddings bersama nama model embedding - mistral-embed. Hasilnya adalah objek EmbeddingResponse. Saat kita mencetak panjang atribut data-nya, kita akan melihat ada dua vektor untuk dua kalimat yang di-embed:
len(embeddings_batch_response.data)2Kita juga dapat mengetahui dimensi vektornya:
first_sentence = embeddings_batch_response.data[0]

len(first_sentence.embedding)  # Embedding dimension
1024Kita mendapat hasil 1024, yang berarti Mistral memetakan teks apa pun, terlepas dari panjangnya, ke vektor berdimensi 1024.
Perlu dicatat bahwa embedding berdimensi lebih tinggi mungkin lebih baik menangkap informasi teks dan meningkatkan kinerja, tetapi memerlukan komputasi lebih untuk hosting dan inferensi.
Walaupun kita tidak menggunakan model Mixtral 8X22B pada bagian ini, memahami embedding akan penting saat kita membuat pipeline RAG sederhana.
Seperti yang kita nyatakan sebelumnya, jika jarak antara dua embedding dekat, maka kemungkinan maknanya dekat. Memperluas gagasan ini, kita dapat membangun detektor parafrasa sederhana karena jika jarak antara dua kalimat pendek, ada kemungkinan keduanya adalah parafrasa.
Pertama, kita akan membuat fungsi yang mengembalikan vektor embedding untuk input tertentu:
def get_text_embedding(input, client):
   embeddings_batch_response = client.embeddings(
model="mistral-embed", input=input
)

   return embeddings_batch_response.data[0].embedding
Lalu, kita akan mendefinisikan daftar kalimat yang ingin kita cek satu sama lain untuk parafrasa dan mendapatkan embedding-nya:
sentences = [
   "What led to Zidane's ban from football?",
   "This is a totally different sentence.",
   "What caused Zidane to get banned from football?",
]

sentence_embeddings = [get_text_embedding(t, client) for t in sentences]
Kemudian, kita akan membuat semua kombinasi pasangan dua kalimat yang mungkin menggunakan itertools:
import itertools

sentence_embeddings_pairs = list(itertools.combinations(sentence_embeddings, 2))
sentence_pairs = list(itertools.combinations(sentences, 2))

print(sentence_pairs[0])
("What led to Zidane's ban from football?", 'This is a totally different sentence.')Lalu, kita akan mencetak jarak Euclidean antara setiap pasangan embedding kalimat dan mencetak hasilnya:
from sklearn.metrics.pairwise import euclidean_distances

for s, e in zip(sentence_pairs, sentence_embeddings_pairs):
   distance = euclidean_distances([e[0]], [e[1]])

   print(s, distance)
("What led to Zidane's ban from football?", 'This is a totally different sentence.') [[0.84503319]]
("What led to Zidane's ban from football?", 'What caused Zidane to get banned from football?') [[0.28662641]]
('This is a totally different sentence.', 'What caused Zidane to get banned from football?') [[0.83794058]]
Jarak antara pasangan kedua dekat, yang mengindikasikan bahwa keduanya mungkin parafrasa satu sama lain.
LLM dilatih pada tumpukan data yang sangat besar, tetapi tidak selalu terbaru dan tidak memiliki akses ke dataset privat Anda. Melakukan fine-tuning terlalu mahal jika Anda hanya ingin model menjawab pertanyaan pada dataset lain yang sudah ada.
Itulah mengapa pipeline Retrieval Augmented Generation (RAG) meningkat popularitasnya. Tanpa fine-tuning yang mahal, Anda dapat mengajarkan LLM untuk memproses informasi kustom yang tidak menjadi bagian dari pelatihannya dan menjawab pertanyaan tentang informasi tersebut.
Di bagian ini, kita akan membangun pipeline RAG dasar yang mempelajari informasi dari berita kemarin dalam artikel 1440 ini. Saya telah menyimpan sebagian beritanya ke berkas teks ini, yang dapat Anda unduh dari GitHub saya atau cukup salin/tempel dan simpan ke berkas bernama news_piece.txt.
Untuk membaca isi berkas, kita dapat menggunakan pustaka pathlib:
from pathlib import Path

file = Path("news_piece.txt")
text = file.read_text()
Lalu, kita akan membagi dokumen menjadi potongan karena sistem RAG bekerja lebih baik saat teks dipotong-potong. Dalam contoh ini, kita akan membagi teks menjadi potongan berisi masing-masing 512 karakter:
chunk_size = 512
chunks = [text[i : i + chunk_size] for i in range(0, len(text), chunk_size)]

len(chunks)
4
Kemudian, kita akan mendapatkan embedding setiap potongan menggunakan fungsi get_text_embedding dari bagian terakhir:
text_embeddings = np.array([get_text_embedding(chunk, client) for chunk in chunks])Berikutnya, praktik umum adalah menyimpan embedding dalam basis data vektor untuk pemrosesan dan pengambilan yang efisien. Ada banyak opsi basis data vektor. Kita akan menggunakan faiss—basis data sumber terbuka untuk pencarian kemiripan.
import faiss  # pip install faiss

d = text_embeddings.shape[1]
index = faiss.IndexFlatL2(d)

index.add(text_embeddings)
index adalah instance kelas Index, yang mendefinisikan struktur basis data kita. d adalah dimensi ruang embedding.
Menjalankan metode add menambahkan informasi dari dokumen kita ke basis data vektor, yang berarti kita dapat mengajukan pertanyaan tentangnya. Namun sebelum itu, pertanyaan apa pun harus diubah menjadi embedding juga:
import numpy as np

questions = [
   "How much is Microsoft going to spend for its new data center?",
   "When did FTX collapse?",
]

question_embeddings = np.array([get_text_embedding(q, client) for q in questions])
Kemudian, kita dapat memberikan array question_embeddings ke metode search dari objek Index:
D, I = index.search(question_embeddings, k=4)  # distance, index

retrieved_chunk = [chunks[i] for i in I.tolist()[0]]
Metode search mengembalikan vektor yang paling mungkin memuat jawaban untuk pertanyaan kita (menggunakan pencarian kemiripan):
len(retrieved_chunk)
4
print(retrieved_chunk[2])
ay defrauded investors in full and provide the vast majority with interest. The failed cryptocurrency exchange platform filed its proposal late Tuesday to a federal bankruptcy court for approval.

Since FTX collapsed in 2022, CEO John Ray III (see previous write-up) has worked to track down more than $8B in missing assets to repay an estimated $11.2B owed to creditors. This week, Ray said the company has recovered between $14.5B and $16.3B, with much of the funds tied to government-seized FTX properties or
Sekarang, kita dapat memberikan teks ini sebagai konteks untuk model Mixtral 8X22B dan mengajukan pertanyaan kita tentangnya. Mari membangun prompt:
prompt = f"""
Context information is below.
---------------------
{retrieved_chunk}
---------------------
Given the context information and not prior knowledge, answer the query.
Query: {questions}
Answer:
"""
Sekarang, kita dapat memberikannya ke model menggunakan client:
chat_response = client.chat(
   model=model,  # Mixtral 8x22B
   messages=[ChatMessage(role="user", content=prompt)],
)

print(chat_response.choices[0].message.content)
Microsoft will spend $3 billion for its new data center in Racine, Wisconsin. FTX collapsed in 2022.
Jawabannya benar!
Kita telah membangun pipeline RAG yang sangat dasar. Dalam praktiknya, pipeline RAG sangat kuat — mereka dapat menangani beragam input (teks, gambar, audio, video) dan dapat bekerja dalam skala masif dibandingkan versi kita yang hanya menangani satu berkas teks.
Jika Anda ingin mempelajari cara membangun pipeline RAG yang andal, lihat Tutorial Cara Membangun Aplikasi LLM dengan LangChain kami.
Salah satu kapabilitas bawaan model Mixtral 8X22B adalah pemanggilan fungsi. Dalam konteks LLM, pemanggilan fungsi adalah teknik yang memungkinkan LLM memahami dan merespons prompt dengan cara yang memicu eksekusi fungsi tertentu. Berikut rincian maknanya:
Mendemonstrasikan cara kerja pemanggilan fungsi berada di luar cakupan artikel ini. Namun, Anda dapat melihat halaman dokumentasi Mistral AI ini untuk melihatnya beraksi.
Dalam artikel ini, kita telah mempelajari model Mixtral 8X22B yang dirilis oleh Mistral AI pada April 2024. Berkat keunggulan arsitekturnya, kini ia menjadi salah satu LLM sumber terbuka terdepan, mengalahkan model populer seperti Llama 2 dan Command R+ pada banyak tolok ukur.
Selain detail arsitekturnya, kita telah mempelajari cara menggunakannya dalam beberapa skenario praktis, seperti pembuatan teks, deteksi parafrasa, dan membuat pipeline RAG. Jika Anda ingin membuka potensi penuh model Mixtral 8X22B, lihat sumber terkait berikut:
Lanjutkan Perjalanan Belajar AI Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



