
Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.3K
Khi OpenAI phát hành ChatGPT vào năm 2022, nhiều người tự hỏi liệu các công ty khác có thể cạnh tranh với một sản phẩm tốt như vậy được hậu thuẫn bởi một gã khổng lồ như Microsoft hay không. Khi mọi sự chú ý đổ dồn vào các ông lớn công nghệ khác như Google và Meta, thì Mistral AI với mô hình 7B đã ra mắt năm 2023, vượt mặt tất cả LLM nguồn mở có kích thước gần gấp đôi.
Kể từ đó, Mistral AI đã trở thành một tay chơi lớn trong cuộc đua LLM. Tháng 4/2024, họ phát hành Mixtral 8X22B, một mô hình dễ dàng vượt qua LLM nguồn mở tốt nhất khi đó, Llama 2, trên nhiều bộ đánh giá.
Trong hướng dẫn này, chúng ta sẽ bàn chi tiết về mô hình Mixtral 8X22B, từ kiến trúc đến cách thiết lập một pipeline RAG với nó.
Mixtral 8X22B là mô hình mới nhất do Mistral AI phát hành. Nó sử dụng kiến trúc mixture of experts thưa (SMoE) với 141 tỷ tham số. Chính kiến trúc SMoE này mang lại cho mô hình nhiều ưu thế. SMoE là một loại mạng nơ-ron dùng các mô hình nhỏ hơn (các chuyên gia) cho từng nhiệm vụ khác nhau, chỉ kích hoạt những mô hình cần thiết để tiết kiệm thời gian và tài nguyên tính toán.
Trước hết, mô hình mang lại hiệu quả chi phí vượt trội so với kích thước của nó, cung cấp tỷ lệ hiệu năng trên chi phí tốt nhất trong cộng đồng nguồn mở:
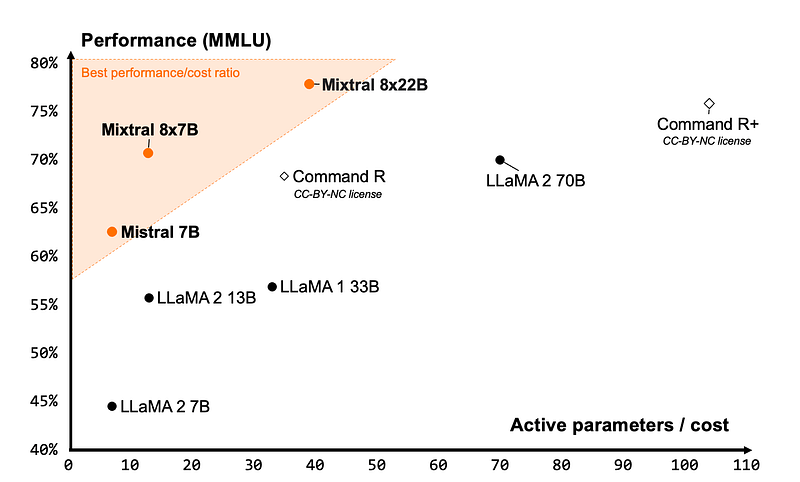
Hình trên thể hiện một số LLM nguồn mở hàng đầu và số lượng tham số đang hoạt động mà chúng cần để đạt một ngưỡng hiệu năng nhất định. Mixtral nằm ở góc trên bên trái, nghĩa là nó dùng ít tham số hơn đáng kể để đạt hiệu năng trên 75% so với một mô hình cùng hạng — Command R+.
Mặc dù Mixtral 8X22B có 141 tỷ tham số, mẫu kích hoạt thưa của nó chỉ sử dụng 39 tỷ tham số trong suy luận. Điều này khiến nó có hiệu năng cao và nhanh hơn bất kỳ mô hình đặc dày 70 tỷ tham số nào như Llama 2 70B. Nó cũng hỗ trợ cửa sổ ngữ cảnh 64k token, điều rất hiếm với các LLM nguồn mở hiện nay.
Mô hình cũng đi kèm giấy phép nguồn mở thoáng nhất — Apache 2.0. Kết hợp với chi phí vận hành thấp, Mixtral 8X22B là lựa chọn tuyệt vời cho các kịch bản fine-tuning.
Mixtral 8x22B vượt qua các bộ đánh giá chuẩn của ngành một cách xuất sắc. Ở hầu hết benchmark, trọng tâm là so sánh hiệu năng của mô hình với những đối thủ tương tự chính:
Ví dụ, Mixtral 8X22B thành thạo năm ngôn ngữ: tiếng Anh, Đức, Pháp, Tây Ban Nha và Ý. Bằng chứng có thể thấy trong bảng sau:
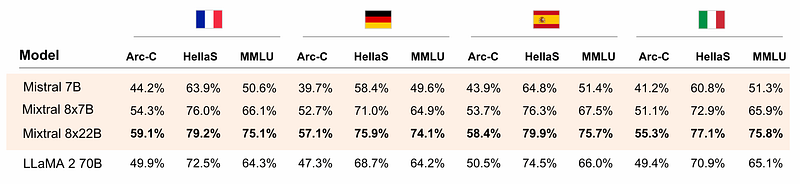
Nó vượt Llama 2 70B ở các tác vụ ngôn ngữ trên ba bộ đánh giá:
Về các câu hỏi suy luận thường thức thuần tuý và kiến thức bằng tiếng Anh, Mixtral lại thể hiện rất tốt:
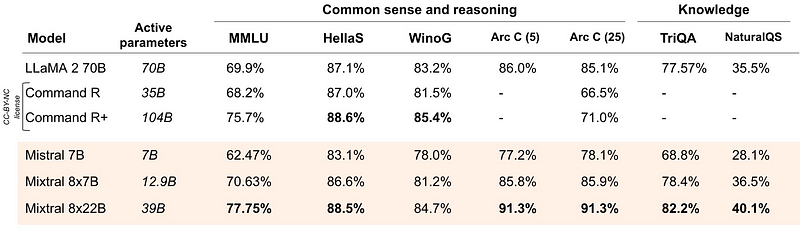
Nó kém Command R+ đôi chút ở hai benchmark nhưng ở các mục khác lại vượt trội đáng kể.
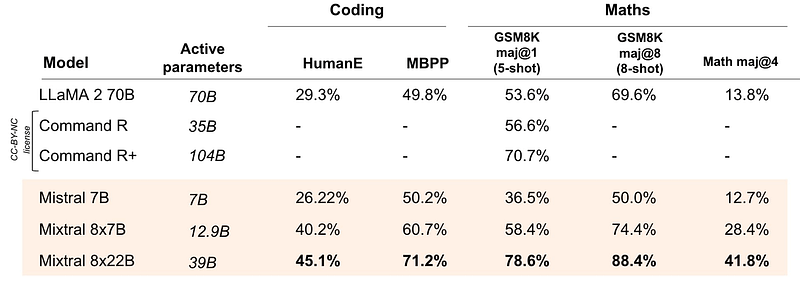
Và điểm nổi bật nhất - Mixtral 8X22B áp đảo mọi đối thủ ở các tác vụ toán học và lập trình:
Giờ hãy xem mô hình đạt hiệu năng tối tân như thế nào.
Để hiểu rõ hơn về kiến trúc sparse mixture of experts (SMoE), ta dùng một phép so sánh đơn giản. Giả sử có 100 người đang làm chung một dự án.
Các mô hình SMoE có những thành phần chính sau:
Cấu trúc kiểu này có nhiều lợi ích:
Tuy nhiên, vì còn mới, các mô hình SMoE cũng mang đến những thách thức riêng chưa được giải quyết triệt để:
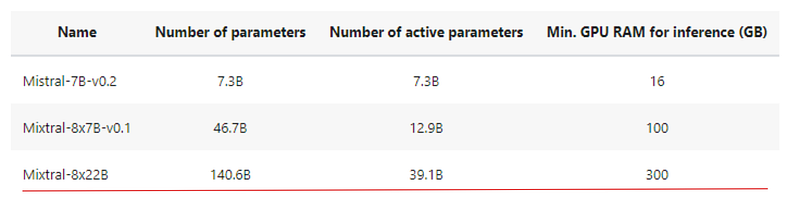
Tóm lại, vì quy mô mô hình là một trong những yếu tố quan trọng nhất để nâng cao chất lượng, việc giảm số tham số đang hoạt động khiến mô hình rẻ hơn và nhanh hơn đáng kể để huấn luyện. Khi ngân sách tính toán bị giới hạn, huấn luyện một mô hình lớn trong ít bước tốt hơn huấn luyện một mô hình nhỏ trong nhiều bước.
Kiến trúc mixture of experts cho phép huấn luyện mô hình với lượng tính toán ít hơn nhiều, nhờ đó bạn có thể tăng quy mô mô hình lên đáng kể trong cùng ngân sách so với mô hình đặc dày. Bất kỳ mô hình SMoE nào cũng nên đạt chất lượng tương đương bản đặc dày nhanh hơn nhiều trong giai đoạn tiền huấn luyện.
Phần này, chúng ta sẽ học cách bắt đầu dùng mô hình Mixtral 8X22B qua Mistral API. Vì mô hình khoảng 80GB và cần GPU 300GB, sẽ khá khó và tốn kém để chạy trên bất kỳ nhà cung cấp đám mây nào, chưa nói đến phần cứng người dùng.
Mistral AI yêu cầu bạn tạo tài khoản và nhập thông tin thanh toán để lấy khóa API. Vui lòng truy cập mistral.ai để tạo tài khoản. Sau khi đăng nhập, bạn sẽ được chuyển tới bảng điều khiển Mistral tại console.mistral.ai.
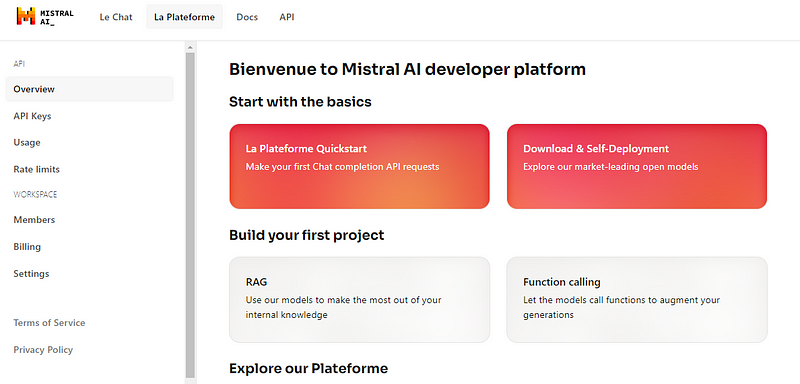
Tiếp theo, vào mục “Billing” và thêm thông tin thanh toán của bạn:
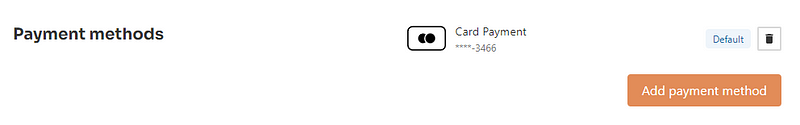
Sau đó, nạp một ít tín dụng:
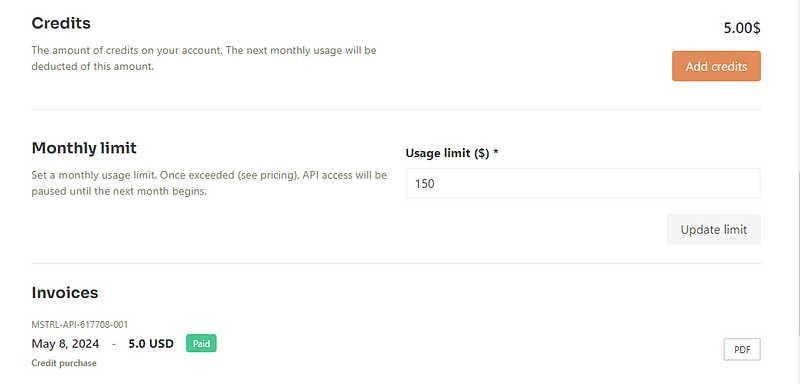
Việc này sẽ cho phép bạn tạo khóa API từ mục “API KEYS”:
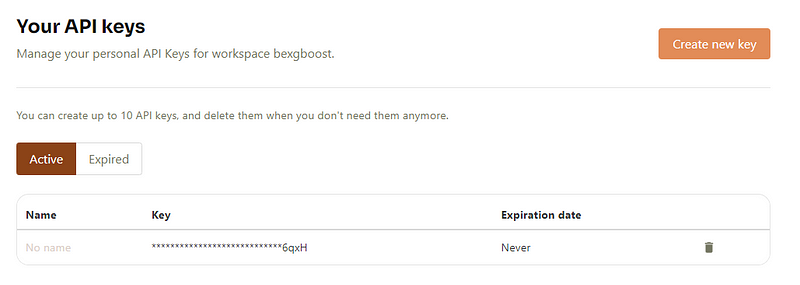
Khi bạn tạo khóa, nó chỉ hiển thị một lần, nên hãy lưu ở nơi an toàn. Chúng ta sẽ dùng ở phần tiếp theo.
Giờ, hãy thiết lập môi trường ảo để chạy Mistral API. Chúng ta sẽ dùng Conda:
$ conda init  # Run if your Conda executable is new
$ conda env create -n mistral python==3.8 -y
$ conda activate mistral
Sau đó, cài đặt gói Python mistralai cùng một vài thành phần thiết yếu khác:
$ pip install mistralai
$ pip install python-dotenv ipykernel
$ ipython kernel install --user --name=mistral
Lệnh cuối thêm môi trường Conda vừa tạo làm một kernel Jupyter.
Chúng ta sẽ dùng gói python-dotenv để đọc an toàn khóa API Mistral từ notebook. Để làm vậy, tạo tệp .env trong thư mục làm việc của bạn:
$ touch .envSau đó, chỉnh tệp theo cú pháp sau để liệt kê khóa của bạn:
MISTRAL_API_KEY=YOUR_KEY_HERENgoài ra, hãy chắc chắn thêm tệp .env vào .gitignore để tránh vô tình đẩy lên GitHub:
$ echo ".env" >> .gitignore
Giờ, để đọc khóa vừa lưu, ta có thể dùng hàm load_dotenv cùng thư viện os:
import os
from dotenv import load_dotenv

load_dotenv()

api_key = os.getenv("MISTRAL_API_KEY")
Cuối cùng, để tương tác với bất kỳ mô hình Mistral nào, chúng ta sẽ dùng đối tượng MistralClient:
from mistralai.client import MistralClient

client = MistralClient(api_key=api_key)
Client cần khóa API để kết nối tới máy chủ Mistral. Sau đó, chúng ta sẽ import lớp ChatMessage để lưu các đoạn hội thoại với mô hình Mistral:
from mistralai.models.chat_completion import ChatMessage

model = "open-mixtral-8x22b"

message = "Who is the best French football player of all time?"

chat_response = client.chat(
   model=model,
   messages=[ChatMessage(role="user", content=message)],
)

print(chat_response.choices[0].message.content[:300])
Determining the "best" French football player of all time can be subjective and depends on personal opinion. However, one player who is often mentioned in this context is Zinedine Zidane. He had an impressive career both for the French national team and at club level. He was a key player in France'sChúng ta đã nhận được phản hồi — vậy là mọi thứ đã thiết lập đúng.
Một đối tượng ChatResponse thường chứa nhiều hơn một câu trả lời, nên chúng ta chọn câu đầu tiên và in một phần nội dung.
Vượt ra ngoài việc sinh văn bản thuần tuý, bạn có thể làm nhiều hơn với Mixtral:
v.v. Chúng ta sẽ xem từng kịch bản một.
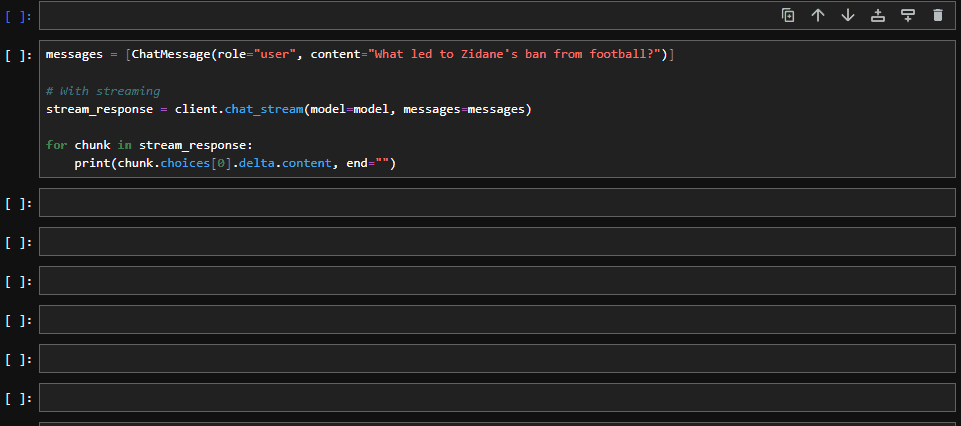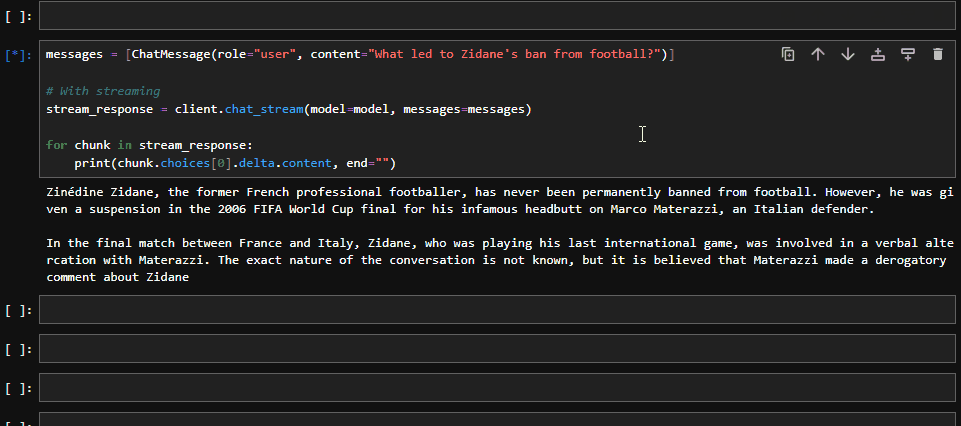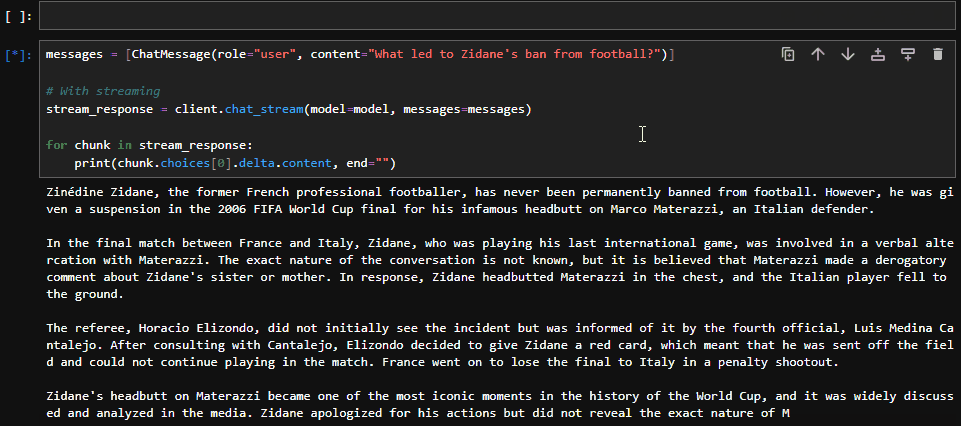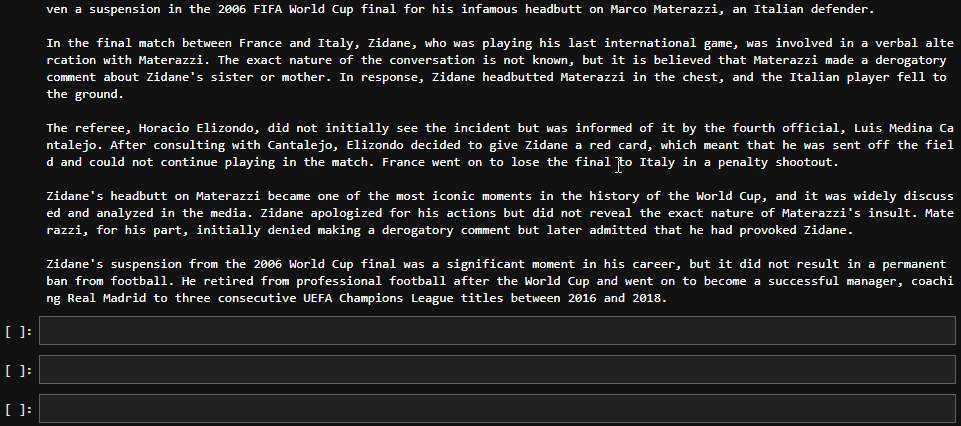
Ở phần trước, chúng ta đã có thể sinh một lượng văn bản lớn từ chat client. Trong một số trường hợp, khi dự đoán câu trả lời có thể dài, sẽ hợp lý nếu stream đầu ra giống như trong ChatGPT. Với Mixtral, ta cũng có thể làm vậy
messages = [ChatMessage(role="user", content="What led to Zidane's ban from football?")]

# With streaming
stream_response = client.chat_stream(model=model, messages=messages)

for chunk in stream_response:
   print(chunk.choices[0].delta.content, end="")
Thay vì phương thức chat, ta có thể dùng chat_stream để nhận câu trả lời theo yêu cầu, từng phần:
Embeddings là thành phần chủ chốt của các ứng dụng LLM. Một embedding là biểu diễn vector của văn bản, nắm bắt ý nghĩa ngữ nghĩa thông qua vị trí của nó trong không gian vector nhiều chiều. Nếu khoảng cách giữa hai embedding gần nhau, điều đó nghĩa là chúng tương đồng về ngữ nghĩa. Ví dụ, từ apple sẽ gần orange hơn là keyboard trong không gian embedding.
Mistral API cung cấp các mô hình embedding tối tân cho văn bản. Hãy lướt nhanh cách chúng hoạt động:
to_embed = ["Is Messi better than Zidane?", "How about Ronaldo?"]

embeddings_batch_response = client.embeddings(
   model="mistral-embed",
   input=to_embed,
)

type(embeddings_batch_response)
mistralai.models.embeddings.EmbeddingResponse
Đầu tiên, ta tạo một danh sách câu để embedding trong to_embed. Sau đó truyền chúng vào phương thức embeddings cùng tên mô hình embedding - mistral-embed. Kết quả là một đối tượng EmbeddingResponse. Khi in độ dài thuộc tính data, ta sẽ thấy có hai vector cho hai câu đã embedding:
len(embeddings_batch_response.data)2Ta cũng có thể lấy số chiều của các vector:
first_sentence = embeddings_batch_response.data[0]

len(first_sentence.embedding)  # Embedding dimension
1024Kết quả là 1024, nghĩa là Mistral nhúng bất kỳ văn bản nào, bất kể độ dài, vào một vector 1024 chiều.
Lưu ý rằng embedding có số chiều cao hơn có thể nắm bắt thông tin văn bản tốt hơn và cải thiện hiệu năng, nhưng đòi hỏi nhiều tài nguyên tính toán hơn để lưu trữ và suy luận.
Dù chúng ta không dùng mô hình Mixtral 8X22B ở phần này, hiểu về embeddings sẽ quan trọng khi chúng ta tạo một pipeline RAG đơn giản.
Như đã nói, nếu khoảng cách giữa hai embedding gần, thì chúng có thể gần nhau về ý nghĩa. Mở rộng ý tưởng này, ta có thể xây dựng một bộ dò paraphrase sơ khai vì nếu khoảng cách giữa hai câu ngắn, có khả năng chúng là các diễn đạt lại của nhau.
Trước tiên, ta sẽ tạo một hàm trả về vector embedding cho một đầu vào cho trước:
def get_text_embedding(input, client):
   embeddings_batch_response = client.embeddings(
model="mistral-embed", input=input
)

   return embeddings_batch_response.data[0].embedding
Tiếp theo, ta sẽ định nghĩa danh sách các câu muốn kiểm tra lẫn nhau về khả năng diễn đạt lại và lấy embedding của chúng:
sentences = [
   "What led to Zidane's ban from football?",
   "This is a totally different sentence.",
   "What caused Zidane to get banned from football?",
]

sentence_embeddings = [get_text_embedding(t, client) for t in sentences]
Sau đó, ta sẽ tạo tất cả các tổ hợp cặp hai câu có thể bằng itertools:
import itertools

sentence_embeddings_pairs = list(itertools.combinations(sentence_embeddings, 2))
sentence_pairs = list(itertools.combinations(sentences, 2))

print(sentence_pairs[0])
("What led to Zidane's ban from football?", 'This is a totally different sentence.')Tiếp theo, chúng ta sẽ in khoảng cách Euclid giữa từng cặp embedding câu và in kết quả:
from sklearn.metrics.pairwise import euclidean_distances

for s, e in zip(sentence_pairs, sentence_embeddings_pairs):
   distance = euclidean_distances([e[0]], [e[1]])

   print(s, distance)
("What led to Zidane's ban from football?", 'This is a totally different sentence.') [[0.84503319]]
("What led to Zidane's ban from football?", 'What caused Zidane to get banned from football?') [[0.28662641]]
('This is a totally different sentence.', 'What caused Zidane to get banned from football?') [[0.83794058]]
Khoảng cách giữa cặp thứ hai khá gần, cho thấy chúng có thể là các diễn đạt lại của nhau.
LLM được huấn luyện trên vô vàn dữ liệu, nhưng không phải lúc nào cũng cập nhật và cũng không có quyền truy cập dữ liệu riêng của bạn. Việc fine-tuning quá tốn kém nếu bạn chỉ muốn mô hình trả lời câu hỏi trên các tập dữ liệu hiện có khác.
Đó là lý do các pipeline Retrieval Augmented Generation (RAG) ngày càng phổ biến. Không cần fine-tuning tốn kém, bạn có thể dạy một LLM xử lý thông tin tuỳ chỉnh không có trong quá trình huấn luyện và trả lời câu hỏi về thông tin đó.
Trong phần này, chúng ta sẽ xây dựng một pipeline RAG cơ bản học thông tin từ tin tức ngày hôm qua trong bài viết 1440 này. Tôi đã lưu một phần tin tức vào tệp văn bản này, bạn có thể tải về từ GitHub của tôi hoặc chỉ cần copy/paste và lưu vào một tệp tên news_piece.txt.
Để đọc nội dung tệp, chúng ta có thể dùng thư viện pathlib:
from pathlib import Path

file = Path("news_piece.txt")
text = file.read_text()
Sau đó, ta sẽ chia tài liệu thành các đoạn vì hệ thống RAG hoạt động tốt hơn khi văn bản được chia nhỏ. Trong ví dụ này, ta chia thành các đoạn 512 ký tự:
chunk_size = 512
chunks = [text[i : i + chunk_size] for i in range(0, len(text), chunk_size)]

len(chunks)
4
Tiếp theo, ta sẽ lấy embedding của từng đoạn bằng hàm get_text_embedding từ phần trước:
text_embeddings = np.array([get_text_embedding(chunk, client) for chunk in chunks])Thông thường, người ta lưu embeddings vào cơ sở dữ liệu vector để xử lý và truy xuất hiệu quả. Có nhiều lựa chọn cho cơ sở dữ liệu vector. Chúng ta sẽ dùng faiss - một cơ sở dữ liệu nguồn mở cho tìm kiếm tương đồng.
import faiss  # pip install faiss

d = text_embeddings.shape[1]
index = faiss.IndexFlatL2(d)

index.add(text_embeddings)
index là một thể hiện của lớp Index, xác định cấu trúc cơ sở dữ liệu của chúng ta. d là số chiều của không gian embedding.
Chạy phương thức add sẽ thêm thông tin từ tài liệu vào cơ sở dữ liệu vector, nghĩa là chúng ta có thể đặt câu hỏi về nó. Nhưng trước khi làm vậy, mọi câu hỏi phải được chuyển thành embedding:
import numpy as np

questions = [
   "How much is Microsoft going to spend for its new data center?",
   "When did FTX collapse?",
]

question_embeddings = np.array([get_text_embedding(q, client) for q in questions])
Tiếp đến, ta đưa mảng question_embeddings vào phương thức search của đối tượng Index:
D, I = index.search(question_embeddings, k=4)  # distance, index

retrieved_chunk = [chunks[i] for i in I.tolist()[0]]
Phương thức search trả về các vector có khả năng chứa câu trả lời cho câu hỏi của chúng ta (bằng tìm kiếm tương đồng):
len(retrieved_chunk)
4
print(retrieved_chunk[2])
ay defrauded investors in full and provide the vast majority with interest. The failed cryptocurrency exchange platform filed its proposal late Tuesday to a federal bankruptcy court for approval.

Since FTX collapsed in 2022, CEO John Ray III (see previous write-up) has worked to track down more than $8B in missing assets to repay an estimated $11.2B owed to creditors. This week, Ray said the company has recovered between $14.5B and $16.3B, with much of the funds tied to government-seized FTX properties or
Giờ, chúng ta có thể truyền văn bản này làm ngữ cảnh cho mô hình Mixtral 8X22B và đặt câu hỏi về nó. Hãy xây dựng prompt:
prompt = f"""
Context information is below.
---------------------
{retrieved_chunk}
---------------------
Given the context information and not prior knowledge, answer the query.
Query: {questions}
Answer:
"""
Giờ, ta có thể truyền cho mô hình bằng client:
chat_response = client.chat(
   model=model,  # Mixtral 8x22B
   messages=[ChatMessage(role="user", content=prompt)],
)

print(chat_response.choices[0].message.content)
Microsoft will spend $3 billion for its new data center in Racine, Wisconsin. FTX collapsed in 2022.
Câu trả lời là chính xác!
Chúng ta đã xây dựng một pipeline RAG rất cơ bản. Trên thực tế, pipeline RAG rất mạnh — chúng có thể xử lý nhiều loại đầu vào (văn bản, hình ảnh, âm thanh, video) và hoạt động ở quy mô lớn, so với phiên bản của chúng ta chỉ xử lý một tệp văn bản.
Nếu bạn muốn học cách xây dựng các pipeline RAG mạnh mẽ, hãy xem Hướng dẫn Xây dựng Ứng dụng LLM với LangChain của chúng tôi.
Một trong các khả năng gốc của mô hình Mixtral 8X22B là function calling. Trong ngữ cảnh LLM, function calling là kỹ thuật cho phép LLM hiểu và phản hồi prompt theo cách kích hoạt thực thi các hàm cụ thể. Dưới đây là tóm lược ý nghĩa:
Việc minh hoạ function calling vượt ngoài phạm vi bài viết này. Tuy nhiên, bạn có thể xem trang này trong tài liệu Mistral AI để thấy nó hoạt động.
Trong bài viết này, chúng ta đã tìm hiểu về mô hình Mixtral 8X22B do Mistral AI phát hành vào tháng 4/2024. Nhờ các ưu thế kiến trúc, hiện nó là một trong những LLM nguồn mở hàng đầu, vượt qua các mô hình phổ biến như Llama 2 và Command R+ trên nhiều benchmark.
Ngoài chi tiết kiến trúc, chúng ta đã học cách sử dụng nó trong một số tình huống thực tế, như sinh văn bản, phát hiện diễn đạt lại và tạo pipeline RAG. Nếu bạn muốn khai mở toàn bộ tiềm năng của mô hình Mixtral 8X22B, hãy xem các tài nguyên liên quan sau:
Tiếp tục Hành trình Học AI của bạn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
