
Cours
Concepts des grands modèles de langage (LLM)
2 h
109.8K
Quand OpenAI a lancé ChatGPT en 2022, beaucoup se sont demandé si d’autres entreprises pourraient rivaliser avec un produit aussi performant, soutenu par un géant comme Microsoft. Alors que tous les regards étaient tournés vers Google et Meta, Mistral AI a dévoilé son modèle 7B en 2023, surpassant tous les LLM open source de taille comparable.
Depuis, Mistral AI s’est imposé comme un acteur majeur dans la course aux LLM. En avril 2024, ils ont sorti Mixtral 8X22B, un modèle qui a nettement dépassé le meilleur LLM open source de l’époque, Llama 2, sur de nombreux benchmarks.
Dans ce tutoriel, nous allons détailler le modèle Mixtral 8X22B, de son architecture à la mise en place d’un pipeline RAG.
Mixtral 8X22B est le dernier modèle publié par Mistral AI. Il s’appuie sur une architecture à mélange parcimonieux d’experts (SMoE) avec 141 milliards de paramètres. C’est cette architecture SMoE qui lui confère de nombreux atouts. Le SMoE est un type de réseau de neurones qui fait appel à différents petits modèles (experts) selon les tâches, en n’activant que ceux nécessaires pour gagner en temps et en puissance de calcul.
D’abord, le modèle offre une efficacité-coût inégalée pour sa taille, avec le meilleur rapport performance/coût dans l’écosystème open source :
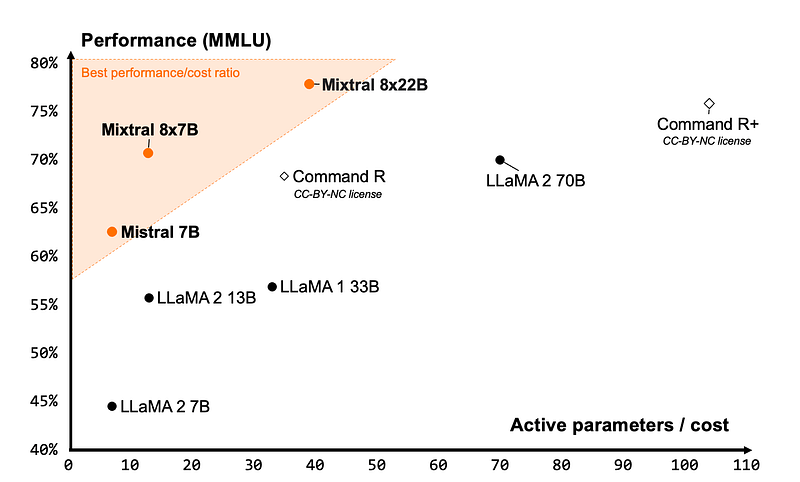
L’image ci-dessus présente quelques-uns des LLM open source de référence et le nombre de paramètres actifs requis pour atteindre un certain niveau de performance. Mixtral se situe en haut à gauche, ce qui signifie qu’il utilise nettement moins de paramètres pour dépasser 75 % de performance qu’un modèle comparable — Command R+.
Même si Mixtral 8X22B compte 141 milliards de paramètres, son schéma d’activation parcimonieuse n’en utilise que 39 milliards à l’inférence. Il est ainsi plus performant et plus rapide que tout modèle dense de 70 milliards de paramètres comme Llama 2 70B. Il propose également une fenêtre de contexte de 64 k tokens, très rare pour les LLM open source actuels.
Le modèle est en outre distribué sous la licence open source la plus permissive — Apache 2.0. Associé à un coût d’exécution réduit, Mixtral 8X22B est un excellent choix pour les scénarios de fine-tuning.
Mixtral 8x22B réussit brillamment les benchmarks standards du secteur. La plupart mettent en avant sa comparaison avec ses principales alternatives proches :
Par exemple, Mixtral 8X22B est fluent en cinq langues : anglais, allemand, français, espagnol et italien. La preuve figure dans le tableau suivant :
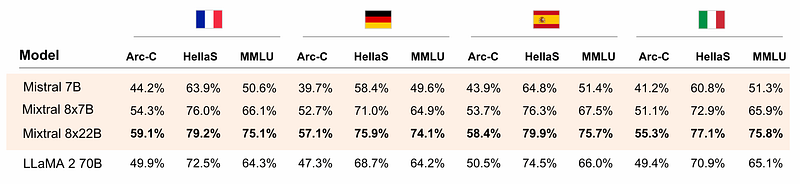
Il surpasse Llama 2 70B sur des tâches de langue à travers trois benchmarks :
Pour le pur raisonnement de sens commun et les questions de connaissance en anglais, Mixtral s’en sort à nouveau remarquablement bien :
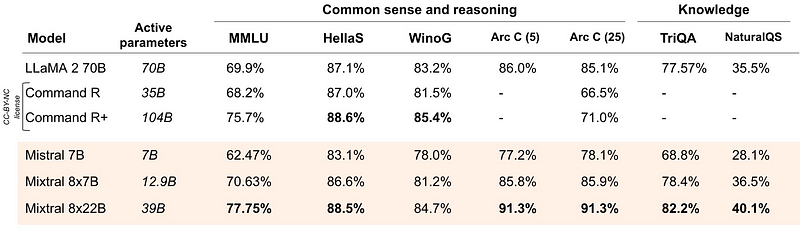
Il fait légèrement moins bien que Command R+ sur deux benchmarks, mais se montre nettement supérieur sur d’autres.
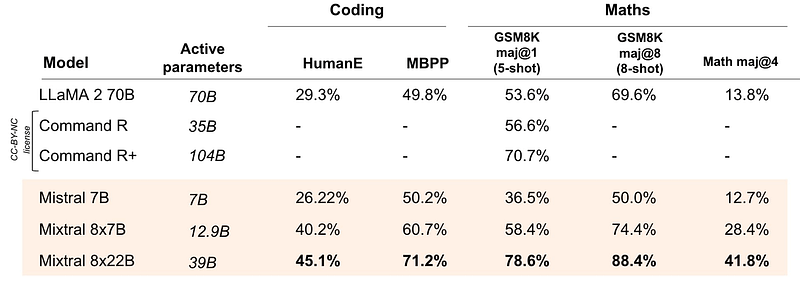
Et son point le plus marquant : Mixtral 8X22B surclasse toutes ses alternatives en mathématiques et en codage :
Voyons maintenant comment le modèle atteint ce niveau de performance.
Pour mieux comprendre l’architecture à mélange parcimonieux d’experts (SMoE), utilisons une analogie simple. Imaginons 100 personnes travaillant sur un projet.
Les modèles SMoE comportent les éléments clés suivants :
Cette structure offre de nombreux bénéfices :
Néanmoins, comme ils sont récents, les modèles SMoE posent des défis spécifiques encore peu résolus :
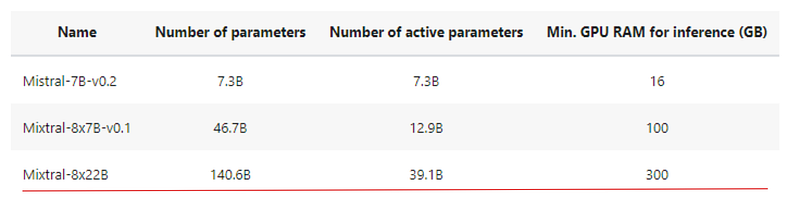
En résumé, puisque l’échelle du modèle est l’un des facteurs déterminants de la qualité, réduire le nombre de paramètres actifs rend l’entraînement nettement moins coûteux et plus rapide. À budget de calcul contraint, il vaut mieux entraîner un modèle plus grand moins longtemps qu’un petit modèle plus longtemps.
Les architectures à mélange d’experts permettent d’entraîner des modèles avec beaucoup moins de calcul, ce qui autorise une montée en taille spectaculaire à budget équivalent à un modèle dense. Tout modèle SMoE devrait atteindre la qualité de son équivalent dense bien plus vite durant le pré-entraînement.
Dans cette section, nous allons apprendre à utiliser Mixtral 8X22B via l’API Mistral. Comme le modèle pèse environ 80 Go et requiert un GPU de 300 Go, son exécution sera difficile et coûteuse chez la plupart des fournisseurs cloud, sans parler du matériel grand public.
Mistral AI vous demande de créer un compte et de renseigner vos informations de facturation pour obtenir votre clé d’API. Rendez-vous sur mistral.ai pour créer votre compte. Une fois connecté, vous serez redirigé vers la console Mistral à l’adresse console.mistral.ai.
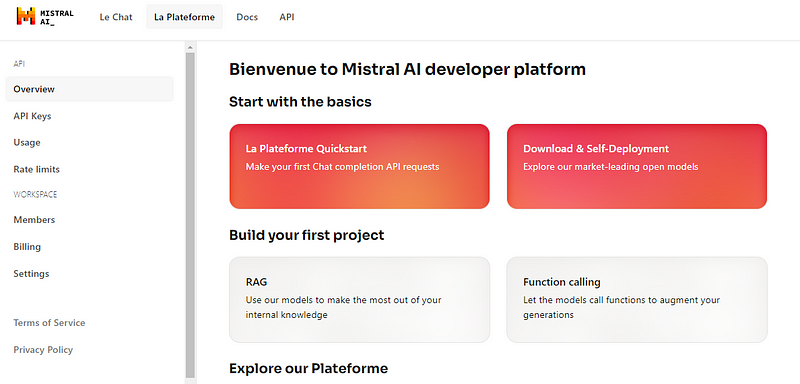
Ensuite, allez dans « Billing » et ajoutez votre moyen de paiement :
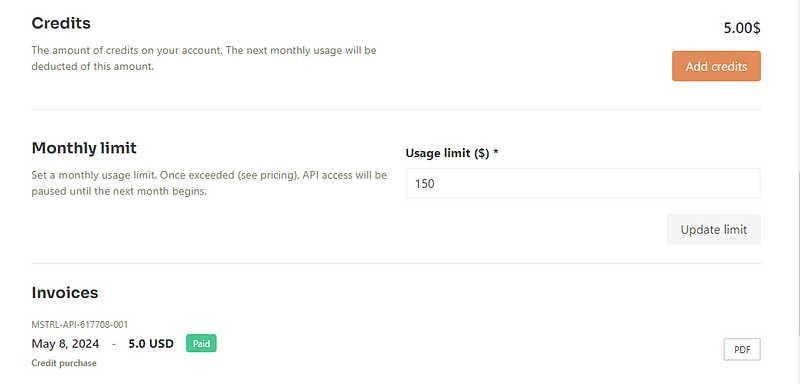
Puis, créditez votre compte :
Vous pourrez alors générer une clé d’API dans la section « API KEYS » :
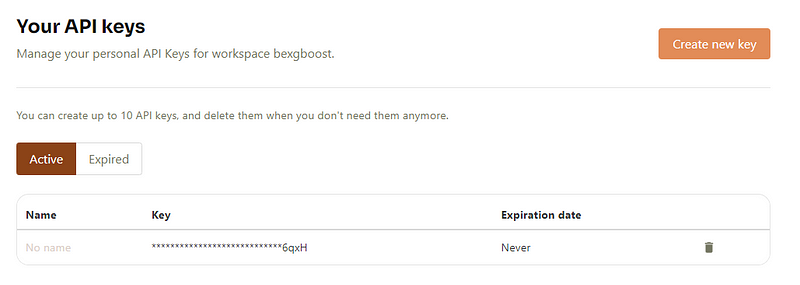
Lors de la création, la clé n’est affichée qu’une seule fois : enregistrez-la précieusement. Nous l’utiliserons à l’étape suivante.
Mettons maintenant en place un environnement virtuel pour utiliser l’API Mistral. Nous allons utiliser Conda :
$ conda init  # Run if your Conda executable is new
$ conda env create -n mistral python==3.8 -y
$ conda activate mistral
Ensuite, installons le package Python mistralai ainsi que quelques indispensables :
$ pip install mistralai
$ pip install python-dotenv ipykernel
$ ipython kernel install --user --name=mistral
La dernière commande ajoute le nouvel environnement Conda comme noyau Jupyter.
Nous utiliserons le package python-dotenv pour lire en toute sécurité notre clé d’API Mistral depuis un notebook. Pour cela, créez un fichier .env dans votre répertoire de travail :
$ touch .envPuis, éditez le fichier pour y renseigner votre clé avec la syntaxe suivante :
MISTRAL_API_KEY=YOUR_KEY_HEREPensez aussi à ajouter le fichier .env à votre .gitignore pour éviter toute fuite accidentelle sur GitHub :
$ echo ".env" >> .gitignore
Pour lire la clé que nous venons d’enregistrer, utilisons la fonction load_dotenv avec la bibliothèque os :
import os
from dotenv import load_dotenv

load_dotenv()

api_key = os.getenv("MISTRAL_API_KEY")
Enfin, pour interagir avec un modèle Mistral, nous allons utiliser l’objet MistralClient :
from mistralai.client import MistralClient

client = MistralClient(api_key=api_key)
Le client a besoin de notre clé d’API pour se connecter aux serveurs de Mistral. Ensuite, importons la classe ChatMessage pour gérer les dialogues avec les modèles Mistral :
from mistralai.models.chat_completion import ChatMessage

model = "open-mixtral-8x22b"

message = "Who is the best French football player of all time?"

chat_response = client.chat(
   model=model,
   messages=[ChatMessage(role="user", content=message)],
)

print(chat_response.choices[0].message.content[:300])
Determining the "best" French football player of all time can be subjective and depends on personal opinion. However, one player who is often mentioned in this context is Zinedine Zidane. He had an impressive career both for the French national team and at club level. He was a key player in France'sNous avons obtenu une réponse — tout est correctement configuré.
Un objet ChatResponse contient souvent plusieurs réponses : nous sélectionnons la première et en affichons un extrait.
Au-delà de la simple génération de texte, vous pouvez faire bien plus avec Mixtral :
et bien plus encore. Nous allons examiner ces scénarios un par un.
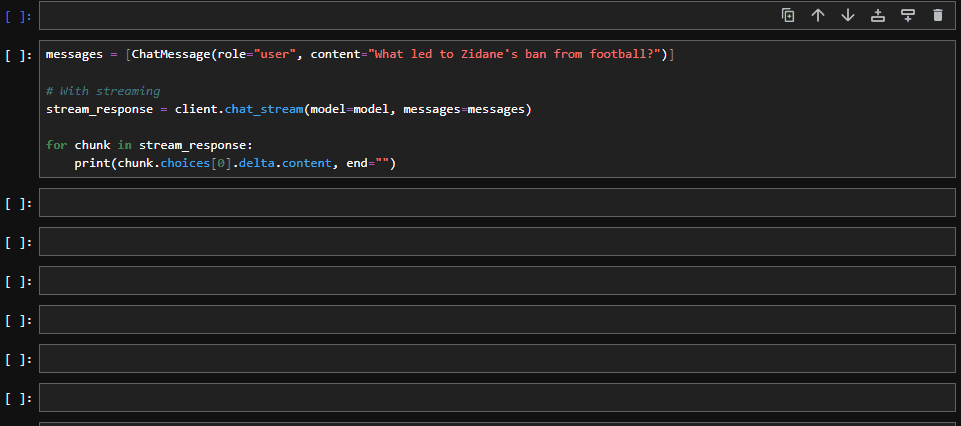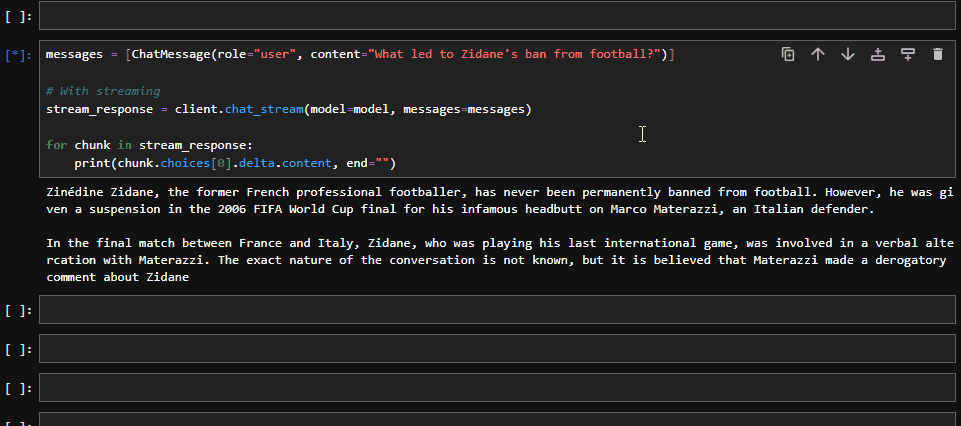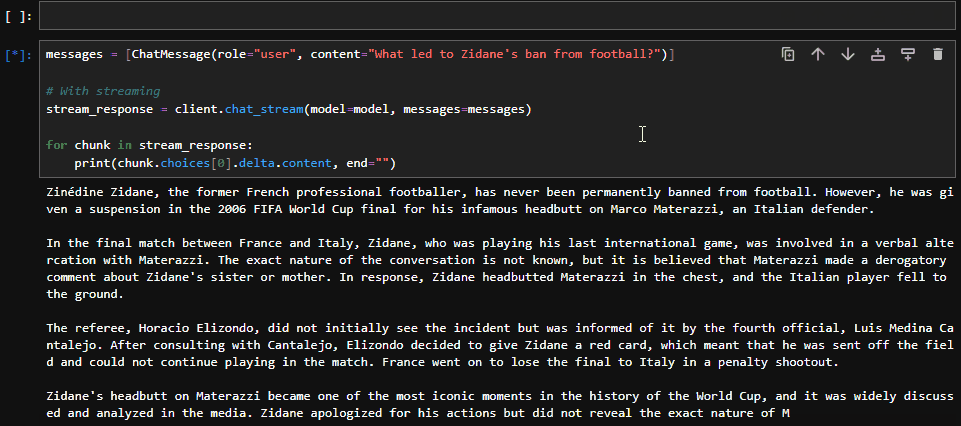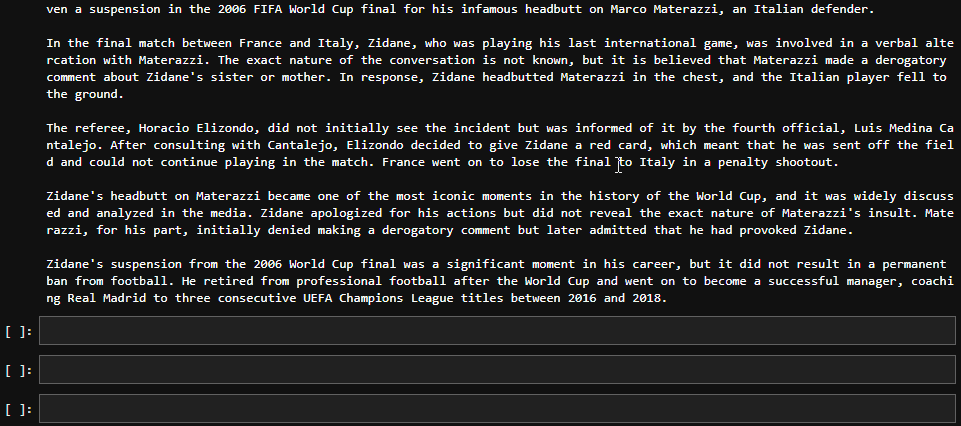
Dans la section précédente, nous avons généré un long texte via le client de chat. Dans certains cas, lorsque l’on s’attend à une réponse volumineuse, il est pertinent de diffuser la sortie en continu, comme dans ChatGPT. C’est aussi possible avec Mixtral
messages = [ChatMessage(role="user", content="What led to Zidane's ban from football?")]

# With streaming
stream_response = client.chat_stream(model=model, messages=messages)

for chunk in stream_response:
   print(chunk.choices[0].delta.content, end="")
Au lieu de la méthode chat, nous pouvons utiliser chat_stream, qui renvoie la réponse à la volée, par fragments :
Les embeddings sont des composants clés des applications LLM. Un embedding est une représentation vectorielle d’un texte, qui capture son sens sémantique par sa position dans un espace vectoriel de grande dimension. Si la distance entre deux embeddings est faible, ils sont proches en signification. Par exemple, le mot pomme sera plus proche de orange que de clavier dans l’espace d’embedding.
L’API Mistral propose des modèles d’embedding de pointe pour le texte. Voyons rapidement comment ils fonctionnent :
to_embed = ["Is Messi better than Zidane?", "How about Ronaldo?"]

embeddings_batch_response = client.embeddings(
   model="mistral-embed",
   input=to_embed,
)

type(embeddings_batch_response)
mistralai.models.embeddings.EmbeddingResponse
Nous créons d’abord une liste de phrases à transformer en vecteurs dans to_embed. Puis nous les passons à la méthode embeddings avec le nom du modèle — mistral-embed. Le résultat est un objet EmbeddingResponse. Si nous affichons la longueur de son attribut data, nous verrons deux vecteurs pour les deux phrases :
len(embeddings_batch_response.data)2Nous pouvons aussi obtenir la dimension des vecteurs :
first_sentence = embeddings_batch_response.data[0]

len(first_sentence.embedding)  # Embedding dimension
1024Nous obtenons 1024, ce qui signifie que Mistral projette tout texte, quelle que soit sa longueur, dans un vecteur de dimension 1024.
Notez que des embeddings de plus grande dimension capturent potentiellement mieux l’information textuelle et améliorent les performances, mais exigent plus de calcul pour l’hébergement et l’inférence.
Même si nous n’avons pas utilisé le modèle Mixtral 8X22B dans cette section, comprendre les embeddings sera important pour créer un pipeline RAG simple.
Comme indiqué plus haut, si la distance entre deux embeddings est faible, ils peuvent être proches en sens. En prolongeant cette idée, on peut construire un détecteur de paraphrases rudimentaire : si la distance entre deux phrases est courte, il y a des chances qu’elles soient des paraphrases.
Commençons par créer une fonction qui renvoie l’embedding pour une entrée donnée :
def get_text_embedding(input, client):
   embeddings_batch_response = client.embeddings(
model="mistral-embed", input=input
)

   return embeddings_batch_response.data[0].embedding
Définissons ensuite la liste des phrases à comparer et récupérons leurs embeddings :
sentences = [
   "What led to Zidane's ban from football?",
   "This is a totally different sentence.",
   "What caused Zidane to get banned from football?",
]

sentence_embeddings = [get_text_embedding(t, client) for t in sentences]
Créons ensuite toutes les combinaisons possibles de paires de phrases avec itertools :
import itertools

sentence_embeddings_pairs = list(itertools.combinations(sentence_embeddings, 2))
sentence_pairs = list(itertools.combinations(sentences, 2))

print(sentence_pairs[0])
("What led to Zidane's ban from football?", 'This is a totally different sentence.')Calculons ensuite la distance euclidienne entre chaque paire d’embeddings et affichons les résultats :
from sklearn.metrics.pairwise import euclidean_distances

for s, e in zip(sentence_pairs, sentence_embeddings_pairs):
   distance = euclidean_distances([e[0]], [e[1]])

   print(s, distance)
("What led to Zidane's ban from football?", 'This is a totally different sentence.') [[0.84503319]]
("What led to Zidane's ban from football?", 'What caused Zidane to get banned from football?') [[0.28662641]]
('This is a totally different sentence.', 'What caused Zidane to get banned from football?') [[0.83794058]]
La distance de la deuxième paire est faible, ce qui indique qu’il peut s’agir de paraphrases.
Les LLM sont entraînés sur d’immenses volumes de données, mais ils ne sont pas toujours à jour et n’ont pas accès à vos données privées. Le fine-tuning coûte cher si vous souhaitez simplement répondre à des questions sur d’autres jeux de données existants.
C’est pourquoi les pipelines de Retrieval Augmented Generation (RAG) ont gagné en popularité. Sans fine-tuning onéreux, vous pouvez apprendre à un LLM à traiter des informations personnalisées hors de son entraînement et à répondre à leur sujet.
Dans cette section, nous allons construire un pipeline RAG basique qui apprend des informations issues de l’actualité d’hier dans cet article 1440. J’ai enregistré une partie de la news dans ce fichier texte, que vous pouvez télécharger depuis mon GitHub ou copier/coller dans un fichier nommé news_piece.txt.
Pour lire le contenu du fichier, utilisons la bibliothèque pathlib :
from pathlib import Path

file = Path("news_piece.txt")
text = file.read_text()
Puis, découpons le document en segments, car les systèmes RAG fonctionnent mieux avec des textes morcelés. Ici, nous allons créer des segments de 512 caractères :
chunk_size = 512
chunks = [text[i : i + chunk_size] for i in range(0, len(text), chunk_size)]

len(chunks)
4
Récupérons ensuite les embeddings de chaque segment avec la fonction get_text_embedding de la section précédente :
text_embeddings = np.array([get_text_embedding(chunk, client) for chunk in chunks])Ensuite, on stocke généralement les embeddings dans une base vectorielle pour un traitement et une recherche efficaces. Il existe de nombreuses options. Nous allons utiliser faiss : une base open source de recherche par similarité.
import faiss  # pip install faiss

d = text_embeddings.shape[1]
index = faiss.IndexFlatL2(d)

index.add(text_embeddings)
index est une instance de la classe Index, qui définit la structure de notre base. d correspond à la dimension de l’espace d’embedding.
Exécuter la méthode add ajoute les informations de notre document à la base vectorielle, ce qui nous permet de poser des questions dessus. Mais avant cela, toute question doit elle aussi être convertie en embedding :
import numpy as np

questions = [
   "How much is Microsoft going to spend for its new data center?",
   "When did FTX collapse?",
]

question_embeddings = np.array([get_text_embedding(q, client) for q in questions])
Nous pouvons ensuite transmettre le tableau question_embeddings à la méthode search de l’objet Index :
D, I = index.search(question_embeddings, k=4)  # distance, index

retrieved_chunk = [chunks[i] for i in I.tolist()[0]]
La méthode search renvoie les vecteurs les plus susceptibles de contenir la réponse à nos questions (via la recherche de similarité) :
len(retrieved_chunk)
4
print(retrieved_chunk[2])
ay defrauded investors in full and provide the vast majority with interest. The failed cryptocurrency exchange platform filed its proposal late Tuesday to a federal bankruptcy court for approval.

Since FTX collapsed in 2022, CEO John Ray III (see previous write-up) has worked to track down more than $8B in missing assets to repay an estimated $11.2B owed to creditors. This week, Ray said the company has recovered between $14.5B and $16.3B, with much of the funds tied to government-seized FTX properties or
Nous pouvons maintenant fournir ce texte comme contexte au modèle Mixtral 8X22B et lui poser nos questions. Construisons le prompt :
prompt = f"""
Context information is below.
---------------------
{retrieved_chunk}
---------------------
Given the context information and not prior knowledge, answer the query.
Query: {questions}
Answer:
"""
Transmettons-le ensuite au modèle via le client :
chat_response = client.chat(
   model=model,  # Mixtral 8x22B
   messages=[ChatMessage(role="user", content=prompt)],
)

print(chat_response.choices[0].message.content)
Microsoft will spend $3 billion for its new data center in Racine, Wisconsin. FTX collapsed in 2022.
Les réponses sont correctes !
Nous avons mis en place un pipeline RAG très basique. En pratique, les pipelines RAG sont très puissants : ils peuvent gérer une grande variété d’entrées (texte, image, audio, vidéo) et passer à l’échelle bien au-delà de notre exemple sur un seul fichier.
Pour apprendre à construire des pipelines RAG robustes, consultez notre tutoriel How to Build LLM Applications with LangChain.
L’une des capacités natives de Mixtral 8X22B est le function calling. Dans le contexte des LLM, le function calling permet aux modèles de comprendre un prompt et d’y répondre en déclenchant l’exécution de fonctions prédéfinies. Concrètement :
La démonstration détaillée du function calling dépasse le cadre de cet article. Cependant, vous pouvez consulter cette page de la documentation Mistral AI pour le voir en action.
Dans cet article, nous avons découvert le modèle Mixtral 8X22B publié par Mistral AI en avril 2024. Grâce à ses atouts architecturaux, il fait partie des meilleurs LLM open source, dépassant des modèles populaires comme Llama 2 et Command R+ sur de nombreux benchmarks.
Au-delà de l’architecture, nous avons vu comment l’utiliser dans des scénarios pratiques : génération de texte, détection de paraphrases et création d’un pipeline RAG. Pour libérer tout le potentiel de Mixtral 8X22B, explorez ces ressources complémentaires :
Poursuivez votre apprentissage de l’IA dès aujourd’hui !
Cours
Cours
Cours