
Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
109.8K
Als OpenAI 2022 ChatGPT veröffentlichte, fragten sich viele, ob andere Unternehmen mit einem so starken Produkt mithalten könnten – zumal es von einem Giganten wie Microsoft gestützt wird. Während alle auf Tech-Schwergewichte wie Google und Meta blickten, erschien 2023 Mistral AI mit seinem 7B-Modell und übertraf damit alle Open-Source-LLMs ähnlicher Größe.
Seitdem ist Mistral AI zu einem großen Player im LLM-Rennen geworden. Im April 2024 veröffentlichten sie Mixtral 8X22B – ein Modell, das das damals führende Open-Source-LLM, Llama 2, in vielen Benchmarks klar hinter sich ließ.
In diesem Tutorial sehen wir uns Mixtral 8X22B im Detail an – von der Architektur bis zur Einrichtung einer RAG-Pipeline.
Mixtral 8X22B ist das neueste Modell von Mistral AI. Es setzt auf eine Sparse Mixture of Experts (SMoE)-Architektur mit 141 Milliarden Parametern. Genau diese SMoE-Architektur sorgt für viele seiner Vorteile. SMoE ist ein Typ neuronales Netz, das verschiedene kleinere Modelle (Experten) für unterschiedliche Aufgaben nutzt und jeweils nur die benötigten Expertinnen und Experten aktiviert – das spart Zeit und Rechenleistung.
Zum einen bietet das Modell eine unerreichte Kosteneffizienz für seine Größe – das beste Verhältnis von Leistung zu Kosten in der Open-Source-Community:
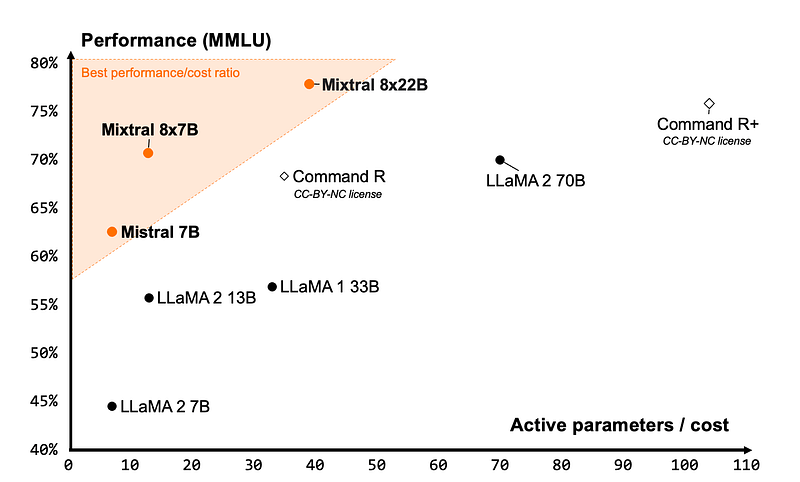
Die Grafik zeigt einige führende Open-Source-LLMs und die Zahl aktiver Parameter, die sie benötigen, um einen bestimmten Performance-Schwellenwert zu erreichen. Mixtral liegt oben links – es braucht also deutlich weniger aktive Parameter, um +75% Performance zu erzielen, als ein Modell in derselben Liga — Command R+.
Obwohl Mixtral 8X22B 141 Milliarden Parameter hat, nutzt sein sparsames Aktivierungsmuster während der Inferenz nur 39 Milliarden. Dadurch ist es leistungsstärker und schneller als dichte 70-Milliarden-Modelle wie Llama 2 70B. Außerdem unterstützt es ein Kontextfenster von 64.000 Tokens – für heutige Open-Source-LLMs eine Seltenheit.
Das Modell wird zudem unter der freizügigen Open-Source-Lizenz Apache 2.0 bereitgestellt. In Kombination mit den niedrigen Betriebskosten ist Mixtral 8X22B eine hervorragende Wahl für Fine-Tuning-Szenarien.
Mixtral 8x22B besteht gängige Branchenbenchmarks mit Bravour. In den meisten Benchmarks lag der Fokus auf dem Vergleich mit ähnlichen Alternativen:
Beispielsweise ist Mixtral 8X22B fließend in fünf Sprachen: Englisch, Deutsch, Französisch, Spanisch und Italienisch. Der Beleg dazu in folgender Tabelle:
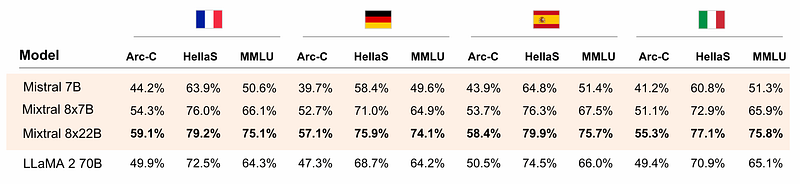
Es schlägt Llama 2 70B bei Sprachaufgaben über drei Benchmarks hinweg:
Auch bei reiner Alltagslogik und Wissensfragen auf Englisch liefert Mixtral sehr starke Ergebnisse:
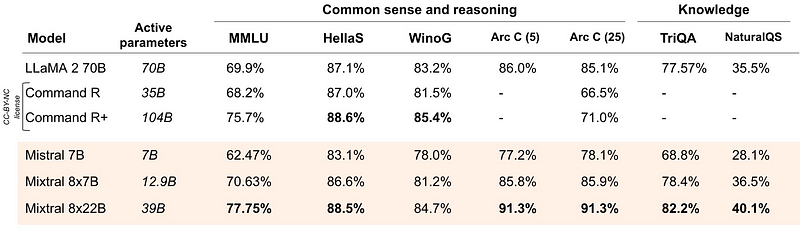
Es liegt in zwei Benchmarks leicht hinter Command R+, ist in anderen jedoch deutlich besser.
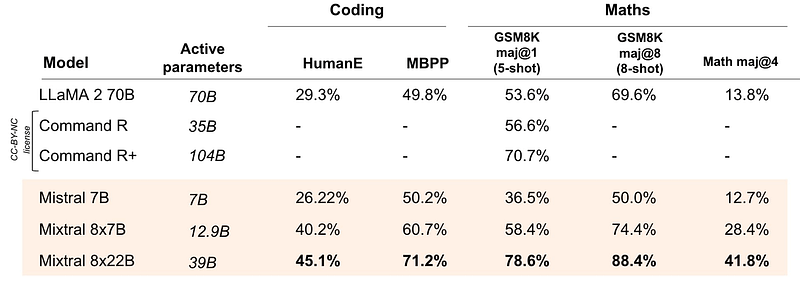
Und das vielleicht deutlichste Merkmal: Mixtral 8X22B dominiert die Alternativen bei Mathematik- und Coding-Aufgaben:
Schauen wir uns nun an, wie das Modell diese Spitzenleistung erreicht.
Um die Sparse Mixture of Experts (SMoE)-Architektur besser zu verstehen, hilft eine einfache Analogie. Stell dir vor, 100 Personen arbeiten an einem Projekt.
SMoE-Modelle bestehen aus folgenden Kernkomponenten:
Diese Struktur bringt viele Vorteile:
Da sie neu sind, bringen SMoE-Modelle jedoch auch Herausforderungen mit sich, die noch nicht vollständig gelöst sind:
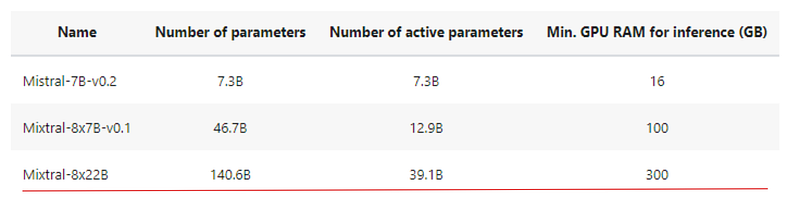
Kurz gesagt: Da die Modellgröße einer der wichtigsten Hebel für Qualität ist, macht die Reduktion aktiver Parameter Modelle deutlich günstiger und schneller im Training. Ein größeres Modell mit weniger Schritten zu trainieren, ist bei begrenztem Compute-Budget oft besser als ein kleines Modell mit vielen Schritten.
Mixture-of-Experts-Architekturen ermöglichen Training mit deutlich weniger Compute und damit eine drastische Vergrößerung der Modellkapazität im selben Budget wie ein dichtes Modell. Jedes SMoE-Modell sollte die Qualität seines dichten Gegenstücks in der Vortrainingsphase deutlich schneller erreichen.
In diesem Abschnitt lernst du, wie du Mixtral 8X22B über die Mistral API nutzt. Da das Modell rund 80 GB groß ist und eine 300-GB-GPU benötigt, ist der Betrieb sowohl auf Consumer-Hardware als auch bei vielen Cloud-Anbietern aufwändig und teuer.
Für einen API-Schlüssel benötigst du bei Mistral AI ein Konto und hinterlegte Zahlungsdaten. Erstelle dein Konto auf mistral.ai. Nach dem Login gelangst du in die Mistral-Konsole unter console.mistral.ai.
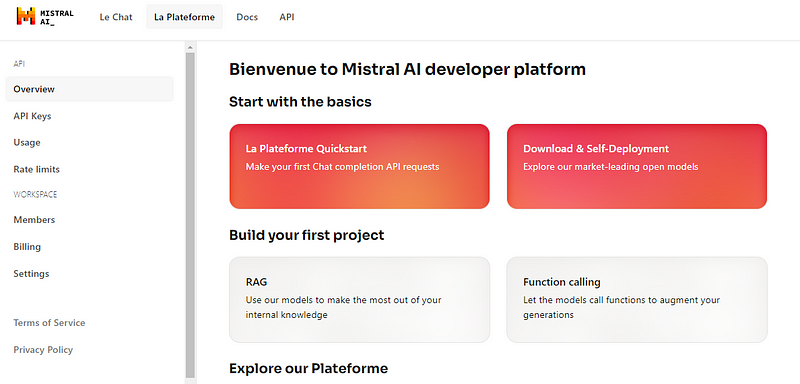
Gehe anschließend zu „Billing“ und hinterlege deine Zahlungsdaten:
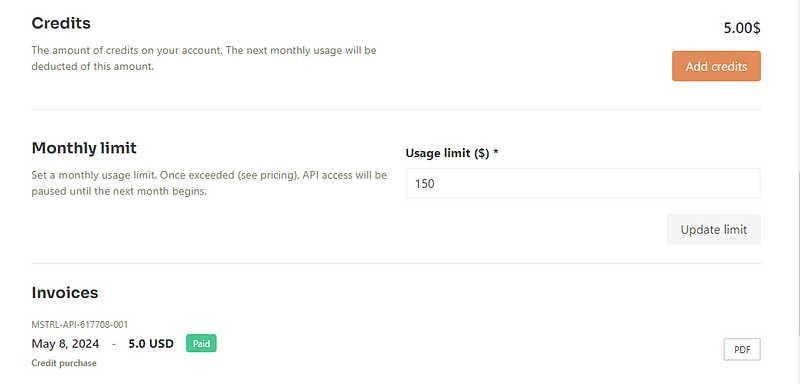
Lade dann Guthaben auf:
Damit kannst du im Bereich „API KEYS“ einen Schlüssel erzeugen:
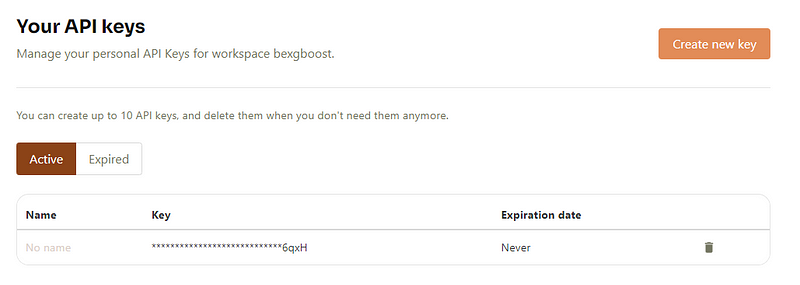
Der Schlüssel wird nur einmal angezeigt. Speichere ihn sicher ab – wir brauchen ihn gleich.
Jetzt richten wir eine virtuelle Umgebung für die Mistral API ein – mit Conda:
$ conda init  # Run if your Conda executable is new
$ conda env create -n mistral python==3.8 -y
$ conda activate mistral
Anschließend installieren wir das Python-Paket mistralai sowie einige Essentials:
$ pip install mistralai
$ pip install python-dotenv ipykernel
$ ipython kernel install --user --name=mistral
Der letzte Befehl fügt die neue Conda-Umgebung als Jupyter-Kernel hinzu.
Wir nutzen python-dotenv, um den Mistral API-Schlüssel sicher aus einem Notebook zu lesen. Lege dazu eine .env-Datei im Arbeitsverzeichnis an:
$ touch .envTrage den Schlüssel dann in folgendem Format ein:
MISTRAL_API_KEY=YOUR_KEY_HEREAchte darauf, die .env-Datei in die .gitignore aufzunehmen, damit sie nicht versehentlich auf GitHub landet:
$ echo ".env" >> .gitignore
Zum Einlesen des Schlüssels nutzen wir load_dotenv zusammen mit os:
import os
from dotenv import load_dotenv

load_dotenv()

api_key = os.getenv("MISTRAL_API_KEY")
Zum Interagieren mit Mistral-Modellen nutzen wir das Objekt MistralClient:
from mistralai.client import MistralClient

client = MistralClient(api_key=api_key)
Der Client benötigt unseren API-Schlüssel, um sich mit den Mistral-Servern zu verbinden. Danach importieren wir die Klasse ChatMessage, um Dialoge mit den Modellen zu führen:
from mistralai.models.chat_completion import ChatMessage

model = "open-mixtral-8x22b"

message = "Who is the best French football player of all time?"

chat_response = client.chat(
   model=model,
   messages=[ChatMessage(role="user", content=message)],
)

print(chat_response.choices[0].message.content[:300])
Determining the "best" French football player of all time can be subjective and depends on personal opinion. However, one player who is often mentioned in this context is Zinedine Zidane. He had an impressive career both for the French national team and at club level. He was a key player in France'sWir haben eine Antwort erhalten — die Einrichtung passt.
Ein ChatResponse-Objekt enthält oft mehrere Antworten. Wir wählen hier die erste und geben einen Ausschnitt aus.
Über die reine Textgenerierung hinaus kannst du mit Mixtral noch viel mehr umsetzen:
und mehr. Wir gehen die Szenarien nacheinander durch.
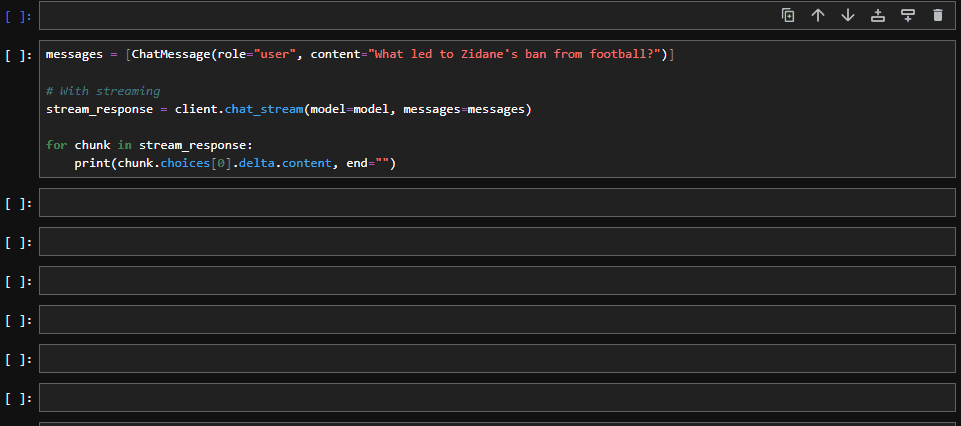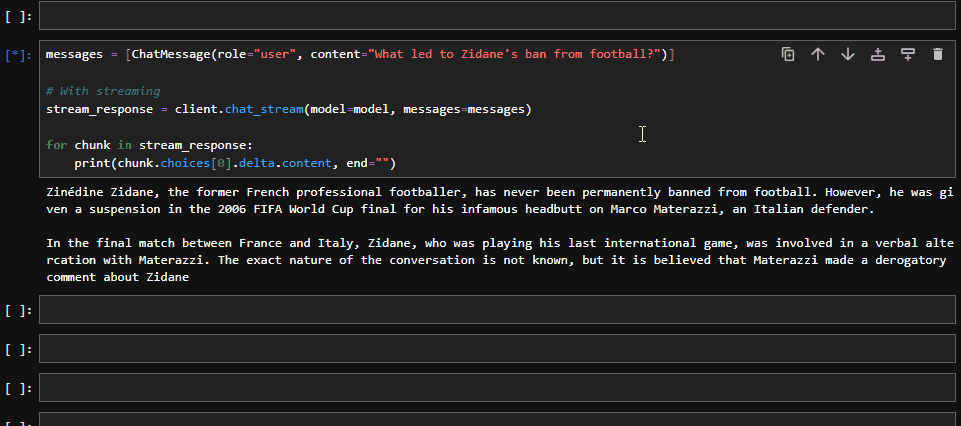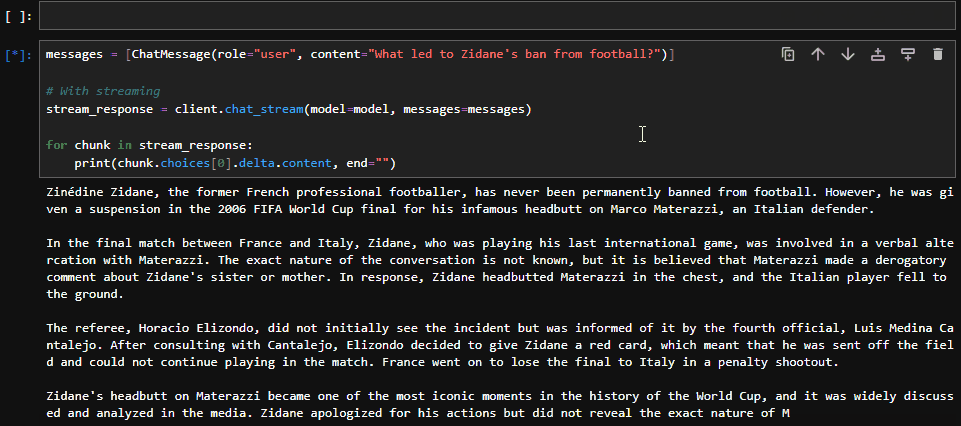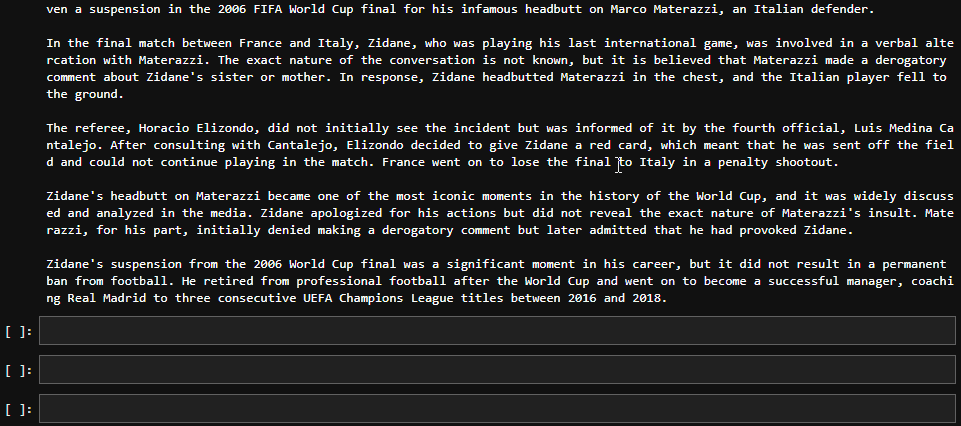
Im vorherigen Abschnitt haben wir bereits Text über den Chat-Client generiert. Wenn die Antwort länger ausfallen könnte, lohnt sich oft Streaming – wie bei ChatGPT. Das geht mit Mixtral ebenfalls:
messages = [ChatMessage(role="user", content="What led to Zidane's ban from football?")]

# With streaming
stream_response = client.chat_stream(model=model, messages=messages)

for chunk in stream_response:
   print(chunk.choices[0].delta.content, end="")
Statt chat nutzen wir chat_stream – die Antwort kommt dann auf Abruf in Teilstücken:
Embeddings sind zentrale Bausteine von LLM-Anwendungen. Ein Embedding ist eine Vektor-Repräsentation von Text, die dessen semantische Bedeutung über die Position in einem hochdimensionalen Raum einfängt. Liegen zwei Embeddings nahe beieinander, sind ihre Bedeutungen ähnlich. So ist apple im Embedding-Raum näher an orange als an keyboard.
Die Mistral API bietet State-of-the-Art-Embedding-Modelle für Text. So nutzt du sie:
to_embed = ["Is Messi better than Zidane?", "How about Ronaldo?"]

embeddings_batch_response = client.embeddings(
   model="mistral-embed",
   input=to_embed,
)

type(embeddings_batch_response)
mistralai.models.embeddings.EmbeddingResponse
Zuerst erstellen wir eine Liste von Sätzen in to_embed. Dann übergeben wir sie an die Methode embeddings und wählen als Modell mistral-embed. Das Ergebnis ist ein EmbeddingResponse-Objekt. Die Länge seines data-Attributs zeigt, dass wir zwei Vektoren für die zwei Sätze erhalten:
len(embeddings_batch_response.data)2Wir können uns auch die Dimension der Vektoren holen:
first_sentence = embeddings_batch_response.data[0]

len(first_sentence.embedding)  # Embedding dimension
1024Das Ergebnis 1024 bedeutet: Mistral bettet beliebigen Text in einen 1024-dimensionalen Vektor ein.
Beachte: Höherdimensionale Embeddings können Inhalte besser erfassen und die Performance steigern, benötigen aber mehr Rechenressourcen für Hosting und Inferenz.
Auch wenn wir hier nicht direkt Mixtral 8X22B verwendet haben, ist das Verständnis von Embeddings wichtig für die nachfolgende RAG-Pipeline.
Wie erwähnt: Wenn der Abstand zwischen zwei Embeddings klein ist, sind die Texte vermutlich bedeutungsähnlich. Daraus lässt sich ein einfacher Paraphrasen-Detektor bauen – sind zwei Sätze nah beieinander, könnten sie Paraphrasen sein.
Zuerst schreiben wir eine Funktion, die den Embedding-Vektor für einen Text zurückgibt:
def get_text_embedding(input, client):
   embeddings_batch_response = client.embeddings(
model="mistral-embed", input=input
)

   return embeddings_batch_response.data[0].embedding
Dann definieren wir die zu vergleichenden Sätze und holen ihre Embeddings:
sentences = [
   "What led to Zidane's ban from football?",
   "This is a totally different sentence.",
   "What caused Zidane to get banned from football?",
]

sentence_embeddings = [get_text_embedding(t, client) for t in sentences]
Anschließend erzeugen wir mit itertools alle möglichen Zweierkombinationen der Sätze:
import itertools

sentence_embeddings_pairs = list(itertools.combinations(sentence_embeddings, 2))
sentence_pairs = list(itertools.combinations(sentences, 2))

print(sentence_pairs[0])
("What led to Zidane's ban from football?", 'This is a totally different sentence.')Jetzt berechnen wir die euklidische Distanz zwischen den Satzpaaren und geben die Ergebnisse aus:
from sklearn.metrics.pairwise import euclidean_distances

for s, e in zip(sentence_pairs, sentence_embeddings_pairs):
   distance = euclidean_distances([e[0]], [e[1]])

   print(s, distance)
("What led to Zidane's ban from football?", 'This is a totally different sentence.') [[0.84503319]]
("What led to Zidane's ban from football?", 'What caused Zidane to get banned from football?') [[0.28662641]]
('This is a totally different sentence.', 'What caused Zidane to get banned from football?') [[0.83794058]]
Der zweite Paarabstand ist klein – ein Hinweis darauf, dass es sich um Paraphrasen handeln könnte.
LLMs werden auf riesigen Datenmengen trainiert, sind aber nicht immer aktuell und haben keinen Zugriff auf deine privaten Daten. Feintuning lohnt sich oft nicht, wenn das Modell nur Fragen zu vorhandenen Datensätzen beantworten soll.
Darum sind Retrieval Augmented Generation (RAG)-Pipelines so beliebt. Ohne teures Feintuning bringst du einem LLM bei, mit Inhalten umzugehen, die nicht Teil des Trainings waren, und Fragen dazu zu beantworten.
In diesem Abschnitt bauen wir eine einfache RAG-Pipeline, die Informationen aus den gestrigen Nachrichten in diesem 1440-Artikel nutzt. Einen Auszug habe ich in dieser Textdatei gespeichert. Du kannst sie von meinem GitHub herunterladen oder den Text kopieren und als news_piece.txt speichern.
Zum Einlesen der Datei verwenden wir pathlib:
from pathlib import Path

file = Path("news_piece.txt")
text = file.read_text()
Dann teilen wir das Dokument in Chunks, da RAG-Systeme mit segmentiertem Text besser arbeiten. Hier schneiden wir auf 512 Zeichen:
chunk_size = 512
chunks = [text[i : i + chunk_size] for i in range(0, len(text), chunk_size)]

len(chunks)
4
Als Nächstes holen wir die Embeddings für jeden Chunk mit der Funktion get_text_embedding aus dem letzten Abschnitt:
text_embeddings = np.array([get_text_embedding(chunk, client) for chunk in chunks])Häufig werden Embeddings in einer Vektordatenbank für effiziente Suche und Retrieval gespeichert. Es gibt viele Optionen – wir nutzen faiss, eine Open-Source-Datenbank für Ähnlichkeitssuche.
import faiss  # pip install faiss

d = text_embeddings.shape[1]
index = faiss.IndexFlatL2(d)

index.add(text_embeddings)
index ist eine Instanz der Klasse Index und definiert die Struktur unserer Datenbank. d ist die Dimensionalität des Embedding-Raums.
Mit add fügen wir die Dokument-Informationen in die Vektordatenbank ein. Um Fragen zu stellen, müssen auch diese zunächst eingebettet werden:
import numpy as np

questions = [
   "How much is Microsoft going to spend for its new data center?",
   "When did FTX collapse?",
]

question_embeddings = np.array([get_text_embedding(q, client) for q in questions])
Dann übergeben wir question_embeddings an die search-Methode des Index:
D, I = index.search(question_embeddings, k=4)  # distance, index

retrieved_chunk = [chunks[i] for i in I.tolist()[0]]
Die search-Methode liefert die Vektoren, die mit hoher Wahrscheinlichkeit die Antwort enthalten (per Ähnlichkeitssuche):
len(retrieved_chunk)
4
print(retrieved_chunk[2])
ay defrauded investors in full and provide the vast majority with interest. The failed cryptocurrency exchange platform filed its proposal late Tuesday to a federal bankruptcy court for approval.

Since FTX collapsed in 2022, CEO John Ray III (see previous write-up) has worked to track down more than $8B in missing assets to repay an estimated $11.2B owed to creditors. This week, Ray said the company has recovered between $14.5B and $16.3B, with much of the funds tied to government-seized FTX properties or
Jetzt nutzen wir diesen Text als Kontext für das Mixtral 8X22B-Modell und stellen unsere Fragen dazu. Erstellen wir den Prompt:
prompt = f"""
Context information is below.
---------------------
{retrieved_chunk}
---------------------
Given the context information and not prior knowledge, answer the query.
Query: {questions}
Answer:
"""
Nun geben wir ihn an das Modell über den client weiter:
chat_response = client.chat(
   model=model,  # Mixtral 8x22B
   messages=[ChatMessage(role="user", content=prompt)],
)

print(chat_response.choices[0].message.content)
Microsoft will spend $3 billion for its new data center in Racine, Wisconsin. FTX collapsed in 2022.
Die Antworten sind korrekt!
Wir haben eine sehr einfache RAG-Pipeline gebaut. In der Praxis sind RAG-Pipelines äußerst leistungsfähig — sie können vielfältige Eingaben (Text, Bild, Audio, Video) verarbeiten und in großem Maßstab arbeiten – im Gegensatz zu unserem Beispiel mit einer einzelnen Textdatei.
Wenn du lernen willst, wie man starke RAG-Pipelines baut, schau dir unser How to Build LLM Applications with LangChain Tutorial an.
Eine der nativen Fähigkeiten von Mixtral 8X22B ist Function Calling. Im Kontext von LLMs ist das eine Technik, mit der LLMs Aufforderungen so interpretieren, dass gezielt vordefinierte Funktionen ausgeführt werden. Kurz zusammengefasst:
Eine vollständige Demo sprengt hier den Rahmen. In der Mistral AI-Dokumentation findest du Beispiele.
In diesem Artikel haben wir das im April 2024 veröffentlichte Mixtral 8X22B von Mistral AI kennengelernt. Dank seiner Architektur zählt es heute zu den führenden Open-Source-LLMs und übertrifft beliebte Modelle wie Llama 2 und Command R+ in vielen Benchmarks.
Neben den architektonischen Details hast du gesehen, wie du es praktisch einsetzen kannst – für Textgenerierung, Paraphrasenerkennung und den Aufbau einer RAG-Pipeline. Wenn du das volle Potenzial von Mixtral 8X22B ausschöpfen willst, sieh dir diese Ressourcen an:
Starte heute mit deiner KI-Lernreise!
Kurs
Kurs
Kurs