
Corso
Concetti sui Large Language Models (LLM)
2 ore
113.4K
Quando OpenAI ha rilasciato ChatGPT nel 2022, molti si sono chiesti se altre aziende potessero competere con un prodotto così valido, sostenuto da un colosso come Microsoft. Mentre tutti aspettavano che altri giganti tecnologici come Google e Meta si muovessero, nel 2023 è arrivata Mistral AI con il suo modello 7B, che ha superato tutti gli LLM open-source pur avendo quasi il doppio delle dimensioni.
Da allora, Mistral AI è diventata un grande protagonista nella corsa agli LLM. Nell'aprile 2024 ha rilasciato Mixtral 8X22B, un modello che ha superato con facilità il miglior LLM open-source dell'epoca, Llama 2, in molti benchmark.
In questo tutorial parleremo nel dettaglio del modello Mixtral 8X22B, dalla sua architettura alla configurazione di una pipeline RAG.
Mixtral 8X22B è l'ultimo modello rilasciato da Mistral AI. Vanta un'architettura a mixture of experts sparsa (SMoE) con 141 miliardi di parametri. È proprio questa architettura SMoE a conferire molti dei suoi vantaggi. SMoE è un tipo di rete neurale che utilizza diversi modelli più piccoli (expert) per compiti differenti, attivando solo quelli necessari per risparmiare tempo e potenza di calcolo.
Innanzitutto, il modello offre un'efficienza sui costi senza pari per le sue dimensioni, garantendo il miglior rapporto prestazioni/costo nella comunità open-source:
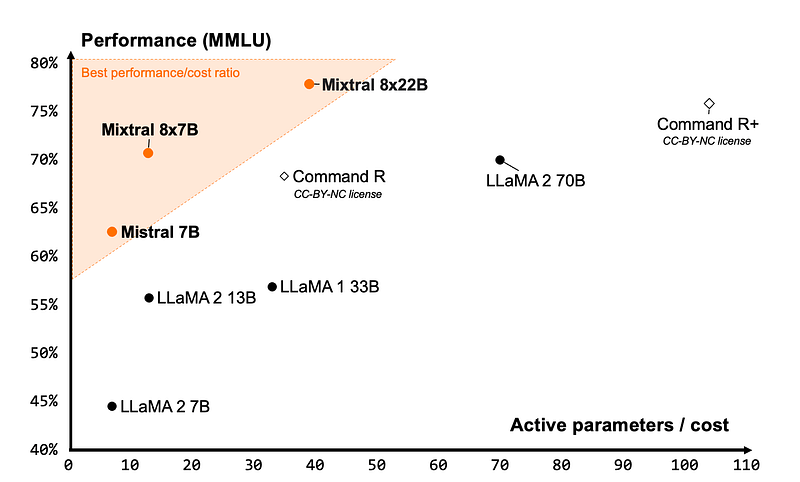
L'immagine sopra mostra alcuni dei principali LLM open-source e il numero di parametri attivi richiesti per raggiungere una certa soglia di performance. Mixtral è proprio nell'angolo in alto a sinistra, il che significa che utilizza significativamente meno parametri per raggiungere oltre il 75% di performance rispetto a un modello della stessa categoria — Command R+.
Anche se Mixtral 8X22B ha 141 miliardi di parametri, il suo schema di attivazione sparsa ne utilizza solo 39 miliardi durante l'inferenza. Questo lo rende molto performante e più veloce di qualsiasi modello denso da 70 miliardi di parametri come Llama 2 70B. Inoltre, offre una finestra di contesto da 64k token, caratteristica molto rara negli LLM open-source di oggi.
Il modello è inoltre distribuito con la licenza open-source più permissiva — Apache 2.0. Unita al basso costo di esecuzione, Mixtral 8X22B è un'ottima scelta per scenari di fine-tuning.
Mixtral 8x22B supera a pieni voti i benchmark standard del settore. In molti benchmark, l'enfasi è stata posta su quanto bene il modello abbia performato rispetto alle principali alternative simili:
Per esempio, Mixtral 8X22B è fluente in cinque lingue: inglese, tedesco, francese, spagnolo e italiano. La prova è visibile nella tabella seguente:
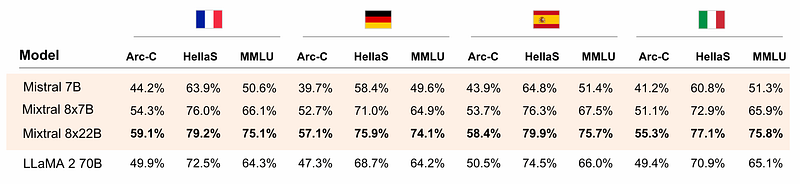
Supera Llama 2 70B nei compiti linguistici in tre benchmark:
Per quanto riguarda il ragionamento di buon senso puro e le domande di conoscenza in inglese, Mixtral si comporta di nuovo egregiamente:
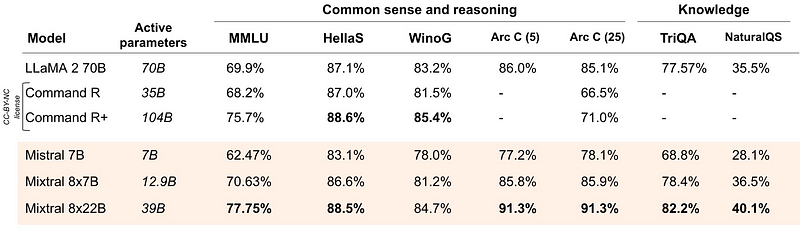
È leggermente peggiore di Command R+ in due benchmark, ma in altri è significativamente migliore.
E il suo punto più distintivo: Mixtral 8X22B surclassa tutte le alternative nei compiti di matematica e programmazione:
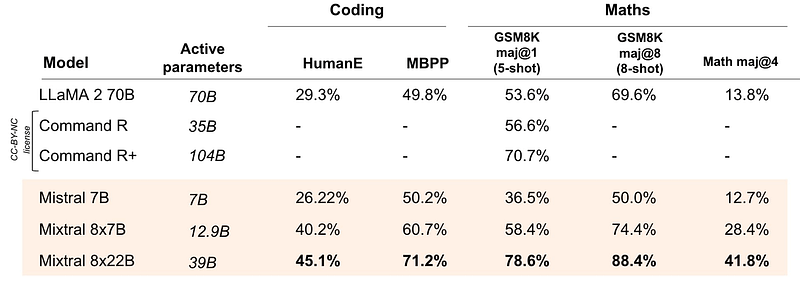
Ora vediamo come il modello raggiunge le sue prestazioni allo stato dell'arte.
Per capire meglio l'architettura a sparse mixture of experts (SMoE), useremo una semplice analogia. Diciamo che 100 persone lavorano a un progetto.
I modelli SMoE hanno i seguenti componenti chiave:
Questo tipo di struttura del modello ha molti benefici:
Tuttavia, essendo nuovi, i modelli SMoE presentano sfide uniche che non sono ancora affrontate in modo efficace:
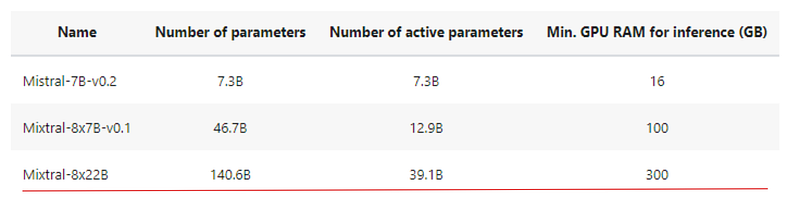
In sintesi, poiché la scala del modello è uno dei fattori più importanti per una qualità migliore, ridurre il numero di parametri attivi rende i modelli significativamente più economici e rapidi da addestrare. Addestrare un modello più grande per meno step è meglio che addestrare un modello piccolo per più step quando il budget di calcolo è limitato.
Le architetture a mixture of experts consentono di addestrare i modelli con molta meno potenza di calcolo, permettendoti di aumentare notevolmente le dimensioni del modello con lo stesso budget di un modello denso. Qualsiasi modello SMoE dovrebbe raggiungere la stessa qualità del suo equivalente denso molto più velocemente durante il pre-training.
In questa sezione, vedremo come iniziare a usare il modello Mixtral 8X22B tramite le API di Mistral. Poiché il modello pesa circa 80 gigabyte e richiede una GPU da 300 gigabyte, sarà un po' difficile e costoso eseguirlo su qualsiasi provider cloud, per non parlare dell'hardware consumer.
Mistral AI richiede di creare un account e inserire i dati di fatturazione per ottenere la tua chiave API. Vai su mistral.ai per creare il tuo account. Una volta effettuato l'accesso con le tue credenziali, verrai indirizzato alla console Mistral su console.mistral.ai.
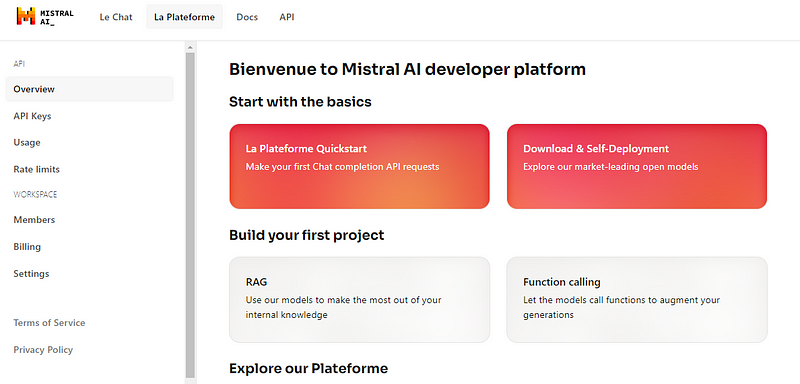
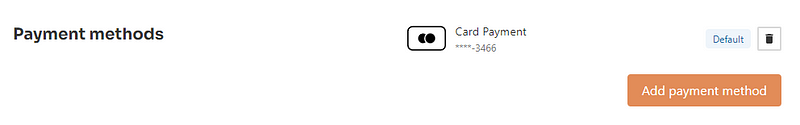
Poi vai su “Billing” e aggiungi le informazioni di pagamento:
Quindi, aggiungi dei crediti:
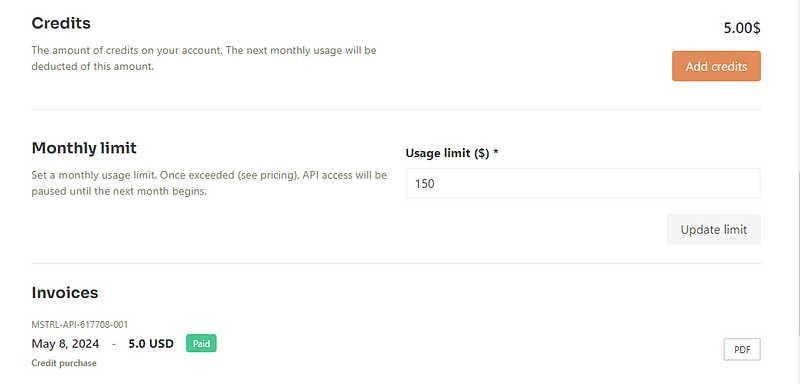
Questo ti permetterà di generare una chiave API dalla sezione “API KEYS”:
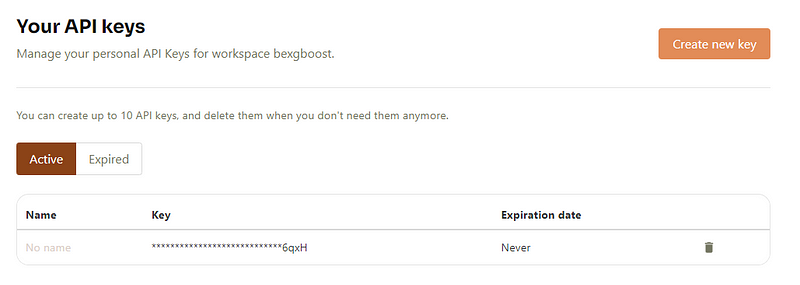
Quando crei una chiave, verrà mostrata una sola volta, quindi salvala in un posto sicuro. La useremo nella prossima sezione.
Ora configuriamo un ambiente virtuale per eseguire le API di Mistral. Useremo Conda:
$ conda init  # Run if your Conda executable is new
$ conda env create -n mistral python==3.8 -y
$ conda activate mistral
Poi possiamo installare il pacchetto Python mistralai insieme ad alcune altre dipendenze essenziali:
$ pip install mistralai
$ pip install python-dotenv ipykernel
$ ipython kernel install --user --name=mistral
L'ultimo comando aggiunge il nuovo ambiente Conda come kernel di Jupyter.
Useremo il pacchetto python-dotenv per leggere in sicurezza la nostra chiave API Mistral da un notebook. Per farlo, crea un file .env nella directory di lavoro:
$ touch .envPoi modifica il file in modo che elenchi la tua chiave con la seguente sintassi:
MISTRAL_API_KEY=YOUR_KEY_HEREAssicurati anche di aggiungere il file .env a .gitignore così da non pubblicarlo per errore su GitHub:
$ echo ".env" >> .gitignore
Ora, per leggere la chiave appena salvata, possiamo usare la funzione load_dotenv insieme alla libreria os:
import os
from dotenv import load_dotenv

load_dotenv()

api_key = os.getenv("MISTRAL_API_KEY")
Infine, per interagire con qualsiasi modello Mistral useremo l'oggetto MistralClient:
from mistralai.client import MistralClient

client = MistralClient(api_key=api_key)
Il client richiede la nostra chiave API per connettersi ai server Mistral. Quindi importeremo la classe ChatMessage per gestire i dialoghi con i modelli Mistral:
from mistralai.models.chat_completion import ChatMessage

model = "open-mixtral-8x22b"

message = "Who is the best French football player of all time?"

chat_response = client.chat(
   model=model,
   messages=[ChatMessage(role="user", content=message)],
)

print(chat_response.choices[0].message.content[:300])
Determining the "best" French football player of all time can be subjective and depends on personal opinion. However, one player who is often mentioned in this context is Zinedine Zidane. He had an impressive career both for the French national team and at club level. He was a key player in France'sAbbiamo ottenuto una risposta — quindi tutto è configurato correttamente.
Un oggetto ChatResponse di solito contiene più di una risposta, quindi stiamo selezionando la prima e stampando un sottoinsieme del testo.
Oltre alla semplice generazione di testo, con Mixtral puoi fare molto di più:
e così via. Vedremo ciascuno di questi scenari uno per uno.
Nella sezione precedente siamo riusciti a generare un ampio blocco di testo dal client chat. In alcuni casi, quando prevediamo che la risposta possa essere lunga, ha senso effettuare lo streaming dell'output proprio come in ChatGPT. Possiamo farlo anche con Mixtral
messages = [ChatMessage(role="user", content="What led to Zidane's ban from football?")]

# With streaming
stream_response = client.chat_stream(model=model, messages=messages)

for chunk in stream_response:
   print(chunk.choices[0].delta.content, end="")
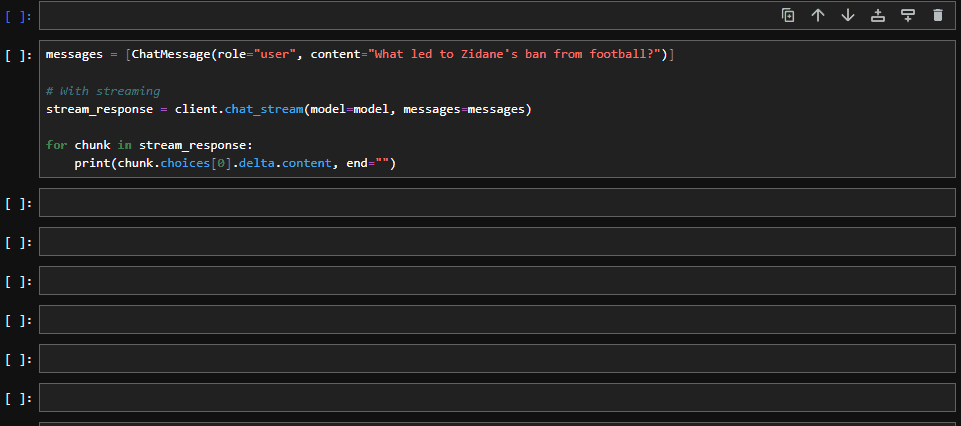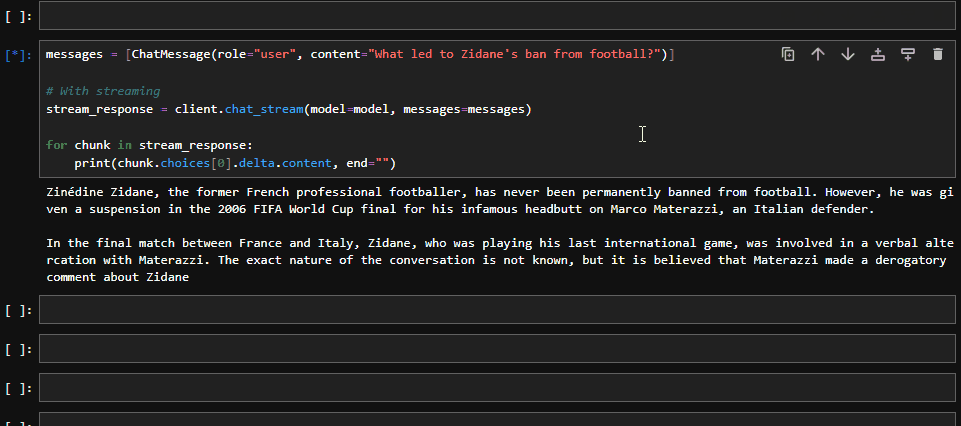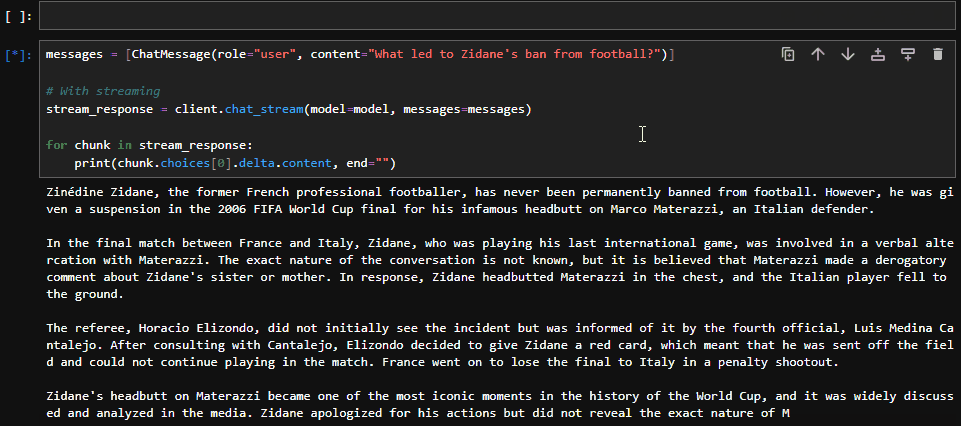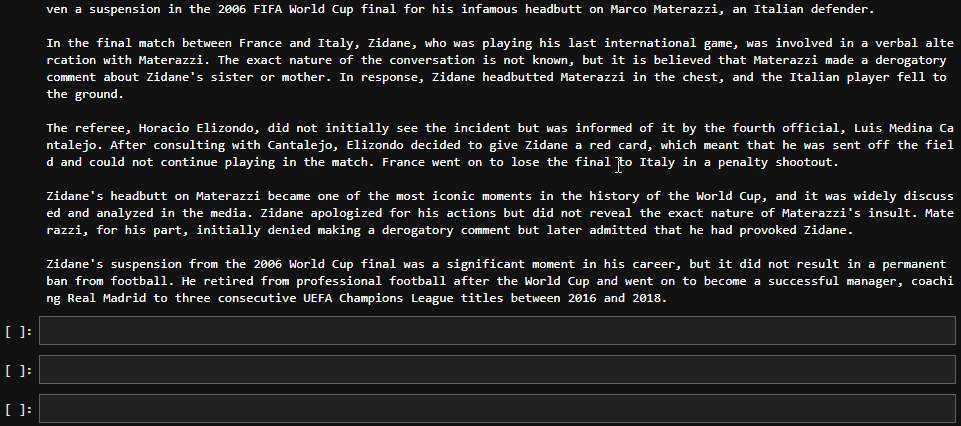
Invece del metodo chat, possiamo usare chat_stream che fornisce la risposta su richiesta, a blocchi:
Gli embedding sono componenti chiave delle applicazioni basate su LLM. Un embedding è una rappresentazione vettoriale del testo che cattura il suo significato semantico attraverso la posizione in uno spazio vettoriale ad alta dimensione. Se la distanza tra due embedding è ridotta, significa che sono simili nel significato. Ad esempio, la parola apple sarà più vicina a orange che a keyboard nello spazio degli embedding.
Le API di Mistral offrono modelli di embedding all'avanguardia per il testo. Vediamo brevemente come funzionano:
to_embed = ["Is Messi better than Zidane?", "How about Ronaldo?"]

embeddings_batch_response = client.embeddings(
   model="mistral-embed",
   input=to_embed,
)

type(embeddings_batch_response)
mistralai.models.embeddings.EmbeddingResponse
Per prima cosa, creiamo un elenco di frasi da trasformare in embedding in to_embed. Poi le passiamo al metodo embeddings insieme al nome del modello di embedding - mistral-embed. Il risultato è un oggetto EmbeddingResponse. Se stampiamo la lunghezza dell'attributo data, vedremo che contiene due vettori per le due frasi elaborate:
len(embeddings_batch_response.data)2Possiamo anche ottenere le dimensioni dei vettori:
first_sentence = embeddings_batch_response.data[0]

len(first_sentence.embedding)  # Embedding dimension
1024Abbiamo ottenuto 1024, il che significa che Mistral proietta qualsiasi testo, indipendentemente dalla lunghezza, in un vettore a 1024 dimensioni.
Nota che embedding a dimensionalità più alta possono catturare meglio le informazioni del testo e migliorare le prestazioni, ma richiedono più calcolo per l'hosting e l'inferenza.
Anche se in questa sezione non abbiamo usato il modello Mixtral 8X22B, capire gli embedding sarà importante quando creeremo una semplice pipeline RAG.
Come detto prima, se la distanza tra due embedding è ridotta, potrebbero essere vicini nel significato. Estendendo questa idea, possiamo costruire un rilevatore di parafrasi primitivo perché, se la distanza tra due frasi è breve, è probabile che siano parafrasi.
Per prima cosa, creeremo una funzione che restituisce il vettore di embedding per un input dato:
def get_text_embedding(input, client):
   embeddings_batch_response = client.embeddings(
model="mistral-embed", input=input
)

   return embeddings_batch_response.data[0].embedding
Poi definiremo l'elenco di frasi che vogliamo confrontare tra loro per la parafrasi e ne otterremo gli embedding:
sentences = [
   "What led to Zidane's ban from football?",
   "This is a totally different sentence.",
   "What caused Zidane to get banned from football?",
]

sentence_embeddings = [get_text_embedding(t, client) for t in sentences]
Quindi creeremo tutte le combinazioni possibili di coppie di frasi usando itertools:
import itertools

sentence_embeddings_pairs = list(itertools.combinations(sentence_embeddings, 2))
sentence_pairs = list(itertools.combinations(sentences, 2))

print(sentence_pairs[0])
("What led to Zidane's ban from football?", 'This is a totally different sentence.')Poi stamperemo la distanza euclidea tra ogni coppia di embedding di frasi e i risultati:
from sklearn.metrics.pairwise import euclidean_distances

for s, e in zip(sentence_pairs, sentence_embeddings_pairs):
   distance = euclidean_distances([e[0]], [e[1]])

   print(s, distance)
("What led to Zidane's ban from football?", 'This is a totally different sentence.') [[0.84503319]]
("What led to Zidane's ban from football?", 'What caused Zidane to get banned from football?') [[0.28662641]]
('This is a totally different sentence.', 'What caused Zidane to get banned from football?') [[0.83794058]]
La distanza tra la seconda coppia è ridotta, il che indica che potrebbero essere parafrasi l'una dell'altra.
Gli LLM sono addestrati su quantità enormi di dati, ma non sono sempre aggiornati e non hanno accesso ai tuoi dataset privati. Fare fine-tuning è troppo costoso se vuoi solo che il modello risponda a domande su altri dataset esistenti.
Ecco perché le pipeline di Retrieval Augmented Generation (RAG) sono esplose in popolarità. Senza un costoso fine-tuning, puoi insegnare a un LLM a processare informazioni personalizzate che non facevano parte del suo training e a rispondere a domande su di esse.
In questa sezione costruiremo una pipeline RAG di base che apprende le informazioni dalle notizie di ieri in questo articolo di 1440. Ho salvato parte della notizia in questo file di testo, che puoi scaricare dal mio GitHub o semplicemente copiare/incollare e salvare in un file chiamato news_piece.txt.
Per leggere il contenuto del file, possiamo usare la libreria pathlib:
from pathlib import Path

file = Path("news_piece.txt")
text = file.read_text()
Poi divideremo il documento in chunk perché i sistemi RAG funzionano meglio quando il testo è suddiviso. In questo esempio, divideremo il testo in chunk da 512 caratteri ciascuno:
chunk_size = 512
chunks = [text[i : i + chunk_size] for i in range(0, len(text), chunk_size)]

len(chunks)
4
Quindi otterremo gli embedding di ciascun chunk usando la funzione get_text_embedding della sezione precedente:
text_embeddings = np.array([get_text_embedding(chunk, client) for chunk in chunks])Successivamente, è pratica comune memorizzare gli embedding in un database vettoriale per un'elaborazione e un recupero efficienti. Esistono molte opzioni per i database vettoriali. Useremo faiss - un database open-source per la ricerca di similarità.
import faiss  # pip install faiss

d = text_embeddings.shape[1]
index = faiss.IndexFlatL2(d)

index.add(text_embeddings)
index è un'istanza della classe Index, che definisce la struttura del nostro database. d è la dimensione dello spazio degli embedding.
Eseguire il metodo add aggiunge al database vettoriale le informazioni del nostro documento, il che significa che possiamo porre domande al riguardo. Ma prima di farlo, anche le domande devono essere convertite in embedding:
import numpy as np

questions = [
   "How much is Microsoft going to spend for its new data center?",
   "When did FTX collapse?",
]

question_embeddings = np.array([get_text_embedding(q, client) for q in questions])
Quindi possiamo passare l'array question_embeddings al metodo search dell'oggetto Index:
D, I = index.search(question_embeddings, k=4)  # distance, index

retrieved_chunk = [chunks[i] for i in I.tolist()[0]]
Il metodo search restituisce i vettori che con maggior probabilità contengono la risposta alle nostre domande (usando la ricerca di similarità):
len(retrieved_chunk)
4
print(retrieved_chunk[2])
ay defrauded investors in full and provide the vast majority with interest. The failed cryptocurrency exchange platform filed its proposal late Tuesday to a federal bankruptcy court for approval.

Since FTX collapsed in 2022, CEO John Ray III (see previous write-up) has worked to track down more than $8B in missing assets to repay an estimated $11.2B owed to creditors. This week, Ray said the company has recovered between $14.5B and $16.3B, with much of the funds tied to government-seized FTX properties or
Ora possiamo passare questo testo come contesto al modello Mixtral 8X22B e porre le nostre domande. Costruiamo il prompt:
prompt = f"""
Context information is below.
---------------------
{retrieved_chunk}
---------------------
Given the context information and not prior knowledge, answer the query.
Query: {questions}
Answer:
"""
Ora possiamo passarlo al modello usando il client:
chat_response = client.chat(
   model=model,  # Mixtral 8x22B
   messages=[ChatMessage(role="user", content=prompt)],
)

print(chat_response.choices[0].message.content)
Microsoft will spend $3 billion for its new data center in Racine, Wisconsin. FTX collapsed in 2022.
Le risposte sono corrette!
Abbiamo costruito una pipeline RAG molto basilare. Nella pratica, le pipeline RAG sono molto potenti — possono gestire una varietà di input (testo, immagini, audio, video) e funzionare su scala massiva rispetto alla nostra versione che ha gestito un singolo file di testo.
Se vuoi imparare a costruire pipeline RAG potenti, dai un'occhiata al nostro tutorial Come costruire applicazioni LLM con LangChain.
Una delle funzionalità native del modello Mixtral 8X22B è il function calling. Nel contesto degli LLM, il function calling è una tecnica che permette agli LLM di comprendere e rispondere ai prompt in modo da attivare l'esecuzione di funzioni specifiche. Ecco cosa significa in pratica:
Mostrare nel dettaglio come funziona il function calling esula dallo scopo di questo articolo. Tuttavia, puoi consultare questa pagina della documentazione di Mistral AI per vederlo in azione.
In questo articolo abbiamo conosciuto il modello Mixtral 8X22B rilasciato da Mistral AI nell'aprile 2024. Grazie ai suoi vantaggi architetturali, è oggi uno dei principali LLM open-source, capace di battere modelli popolari come Llama 2 e Command R+ in molti benchmark.
Oltre ai dettagli architetturali, abbiamo visto come usarlo in alcuni scenari pratici, come la generazione di testo, il rilevamento di parafrasi e la creazione di una pipeline RAG. Se vuoi sbloccare tutto il potenziale del modello Mixtral 8X22B, dai un'occhiata a queste risorse correlate:
Continua oggi il tuo percorso di apprendimento sull'IA!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



