Kursus
Prapemrosesan untuk Machine Learning di Python
4 jam
68.7K
Pertama, mari impor pustaka dasar yang diperlukan untuk mengolah dataset.
import pandas as pd
Sekarang mari baca dataset dan lihat isinya.
bfriday = pd.read_csv("BlackFriday.csv")
bfriday.head(10)
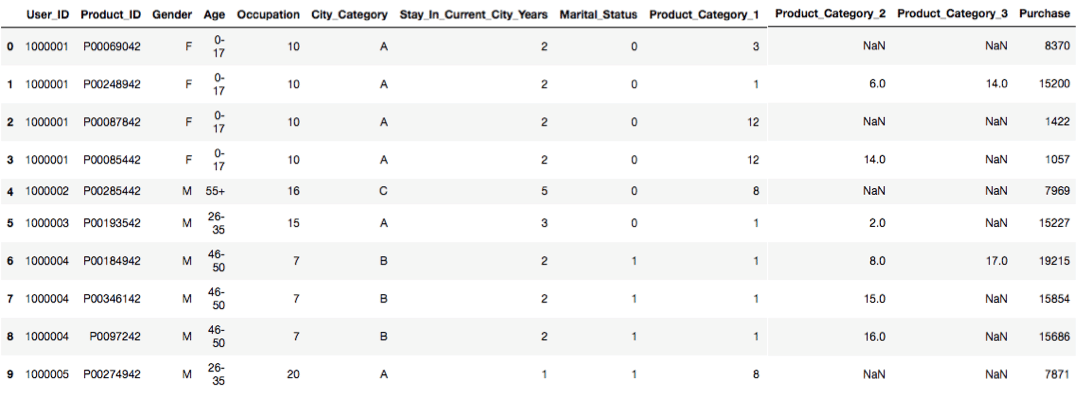
Baris di atas menampilkan sebagian dataset yang terdiri dari 10 baris dan semua kolom. Jika Anda mencoba memberikan bfriday.head(x,y) akan terjadi error karena komputer sudah menganggap jumlah total kolom wajib. bfriday.head() juga akan memberi output tanpa error dan komputer mengambil jumlah baris dan kolom sesuai defaultnya.
bfriday.shape #ini memberi dimensi dataset (baris, kolom)
(550068, 12)
bfriday['Stay_In_Current_City_Years'].value_counts()# menghitung jumlah nilai per setiap rentang, bfriday['City_Category'].value_counts()
1    193821
2    101838
3     95285
5     84726
0     74398
Name: Stay_In_Current_City_Years, dtype: int64
bfriday.isnull().sum() #menghitung jumlah nilai null untuk tiap kategori dalam dataset
User_ID                            0
Product_ID                         0
Gender                             0
Age                                0
Occupation                         0
City_Category                      0
Stay_In_Current_City_Years         0
Marital_Status                     0
Product_Category_1                 0
Product_Category_2            173638
Product_Category_3            383247
Purchase                           0
dtype: int64
b = ['Product_Category_2','Product_Category_3'] #di sini kita membuat array berisi 2 kolom yaitu Product_Category_2, Product_Category_3
for i in b:
    exec("bfriday.%s.fillna(bfriday.%s.value_counts().idxmax(), inplace=True)" %(i,i))
Sekarang kita akan mengisi nilai kosong dengan nilai maksimum. Kita juga bisa membersihkan atau mengisi nilai kosong dengan bfriday.Product_Category_2.fillna(bfriday.Product_Category_2.value_counts().idxmax(),inplace=True); serupa untuk kolom bernama Product_category_3.
X = bfriday.drop(["Purchase"], axis=1)
Kita sekarang menghapus kolom bernama purchase dari dataset dan membentuk array bernama X yang terdiri dari semua kolom kecuali kolom purchase.
from sklearn.preprocessing import LabelEncoder#Sekarang mari impor encoder dari pustaka sklearn
LE = LabelEncoder()
#Sekarang kita akan mengodekan data menjadi label menggunakan label encoder agar komputasi lebih mudah
X = X.apply(LE.fit_transform)#Di sini kita menerapkan encoder pada data
Sekarang kita akan mengonversi data ke bentuk numerik menggunakan pandas karena menangani data numerik lebih mudah daripada data kategorikal.
X.Gender = pd.to_numeric(X.Gender)
X.Age = pd.to_numeric(X.Age)
X.Occupation = pd.to_numeric(X.Occupation)
X.City_Category = pd.to_numeric(X.City_Category)
X.Stay_In_Current_City_Years = pd.to_numeric(X.Stay_In_Current_City_Years)
X.Marital_Status = pd.to_numeric(X.Marital_Status)
X.Product_Category_1 = pd.to_numeric(X.Product_Category_1)
X.Product_Category_2 = pd.to_numeric(X.Product_Category_2)
X.Product_Category_3 = pd.to_numeric(X.Product_Category_3)
Y = bfriday["Purchase"]#Di sini kita membuat array bernama Y yang berisi data dari kolom purchase
from sklearn.preprocessing import StandardScaler
SS = StandardScaler()
Menstandarkan fitur dengan menghilangkan mean dan menskalakan ke varians satuan. Proses centering dan scaling dilakukan secara independen pada setiap fitur dengan menghitung statistik yang relevan pada sampel di set pelatihan. Mean dan standar deviasi kemudian disimpan untuk digunakan pada data berikutnya menggunakan metode transform.
Xs = SS.fit_transform(X)
#Anda harus mengubah X ke representasi numerik (tidak harus biner). Karena semua metode machine learning beroperasi pada matriks angka
from sklearn.decomposition import PCA
pc = PCA(4)#di sini 4 menunjukkan jumlah komponen yang Anda inginkan
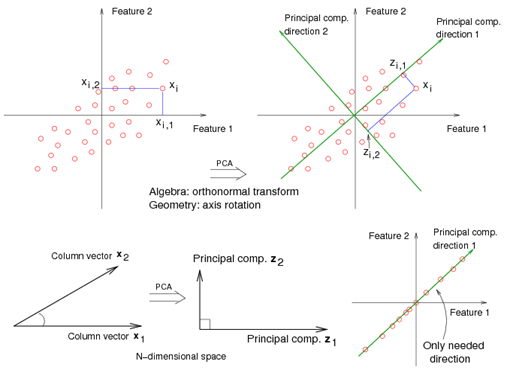
Reduksi dimensi linear menggunakan Singular Value Decomposition dari data untuk memproyeksikannya ke ruang berdimensi lebih rendah. PCA adalah salah satu metode reduksi dimensi yang paling sering digunakan dan terkenal. Untuk mempercepat algoritma machine learning, Anda memasang PCA hanya pada set pelatihan. Principal component analysis (PCA)
PCA menggantikan variabel asli dengan variabel baru, yang disebut komponen utama, yang memiliki kovariansi nol dan memiliki varians dalam urutan menurun. Jadi, matriks kovariansi antara komponen utama diekstraksi dari data.
Catatan: Jangan pernah menggunakan RandomizedPCA untuk data sparse. Penggunaan RandomizedPCA pada data sparse tidak tepat karena kita tidak bisa melakukan centering pada data tanpa merusak sifat sparsity, yang dapat membengkakkan penggunaan memori pada data sparse berukuran realistis. Namun, centering diperlukan untuk PCA.
principalComponents = pc.fit_transform(X)#Di sini kita menerapkan PCA ke data/memasangkan data ke PCA
pc.explained_variance_ratio_
array([7.35041374e-01, 2.64935995e-01, 1.10061180e-05, 6.21704987e-06])
principalDf = pd.DataFrame(data = principalComponents, columns = ["component 1", "component 2", "component 3", "component 4"])
from sklearn.model_selection import KFold
kf = KFold(20)
#Menyediakan indeks train/test untuk membagi data menjadi set train/test. Membagi dataset menjadi k lipatan berurutan (tanpa pengacakan secara default).
#Setiap lipatan kemudian digunakan sekali sebagai validasi sementara k - 1 lipatan lainnya menjadi set pelatihan.
for a,b in kf.split(principalDf):
    X_train, X_test = Xs[a],Xs[b]
    y_train, y_test = Y[a],Y[b]
from sklearn.linear_model import LinearRegression
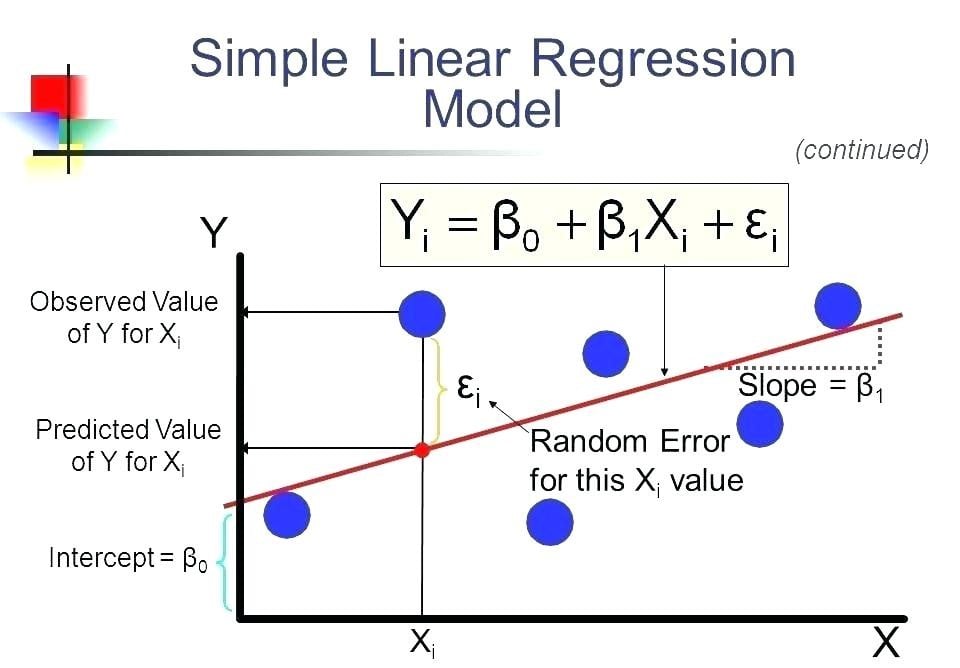
Regresi digunakan untuk menelaah dua hal: (1) apakah sekumpulan variabel prediktor dapat memprediksi variabel keluaran (dependen) dengan baik? (2) Variabel mana yang menjadi prediktor signifikan terhadap variabel keluaran, dan bagaimana pengaruhnya—ditunjukkan oleh besar dan tanda koefisien beta? Estimasi regresi ini digunakan untuk menjelaskan hubungan antara satu variabel dependen dan satu atau lebih variabel independen. Bentuk paling sederhana dari persamaan regresi dengan satu variabel dependen dan satu variabel independen didefinisikan oleh rumus y = c + b*x, di mana y = nilai taksiran variabel dependen, c = konstanta, b = koefisien regresi, dan x = skor pada variabel independen.
from sklearn.tree import DecisionTreeRegressor
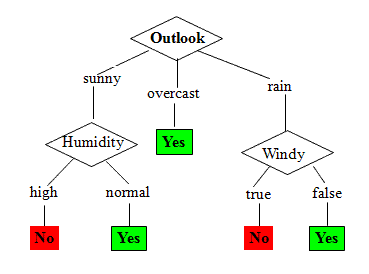
Sebuah decision tree dibangun dari atas ke bawah dari sebuah root node dan melibatkan pemartisian data menjadi subset yang berisi instance dengan nilai serupa. Decision tree membangun model dalam bentuk struktur pohon. Ia memecah dataset menjadi subset yang semakin kecil sembari sebuah decision tree dibangun secara bertahap. Hasil akhirnya adalah pohon dengan node keputusan dan node daun. Node keputusan (misalnya, Outlook) memiliki dua atau lebih cabang (misalnya, Sunny, Overcast, dan Rainy), masing-masing mewakili nilai untuk atribut yang diuji. Node daun (misalnya, Hours Played) mewakili keputusan pada target numerik. Node keputusan teratas pada pohon yang berkorelasi dengan prediktor terbaik disebut root node. Decision tree dapat menangani data kategorikal maupun numerik. Decision tree di mana variabel target dapat bernilai kontinu (biasanya bilangan riil) disebut regression tree. Jika kedalaman maksimum pohon ditetapkan terlalu tinggi, decision tree akan mempelajari detail yang terlalu halus dari data pelatihan dan mempelajari noise, yaitu overfit.
from sklearn.ensemble import RandomForestRegressor
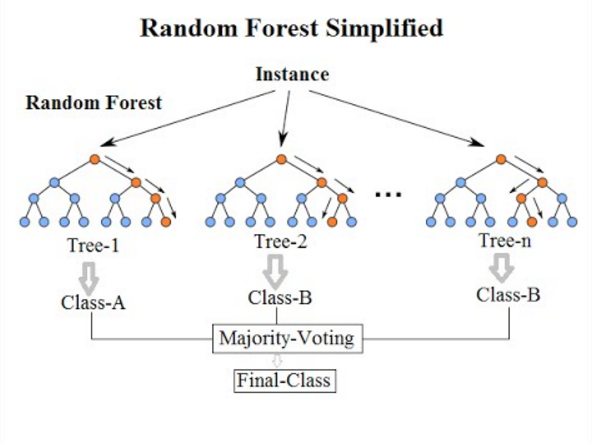
Random forest adalah estimator yang melatih sejumlah pohon keputusan pengklasifikasi pada berbagai sub-sampel dari dataset dan menggunakan perataan untuk meningkatkan akurasi prediksi serta mengendalikan overfitting. Ukuran sub-sampel selalu sama dengan ukuran sampel masukan asli tetapi sampel diambil dengan penggantian jika bootstrap=True. Gagasan di balik teknik ini adalah mendekorelasi beberapa pohon. Ia menghasilkan sampel bootstrap yang berbeda (yakni sampel yang dibangkitkan sendiri) dari Data pelatihan. Lalu kita mengurangi varians pada pohon dengan meratakannya. Dengan demikian, pendekatan ini membuat sejumlah besar decision tree di Python atau R. Model random forest sangat baik dalam menangani data tabular dengan fitur numerik, atau fitur kategorikal dengan kurang dari ratusan kategori. Random forest mampu menangkap interaksi nonlinier antara fitur dan target.
Catatan: Model berbasis pohon tidak dirancang untuk bekerja dengan fitur yang sangat sparse. Saat menangani data masukan sparse, kita bisa melakukan prapemrosesan fitur sparse untuk menghasilkan statistik numerik atau beralih ke model linear yang lebih cocok untuk skenario semacam itu.
from sklearn.ensemble import GradientBoostingRegressor
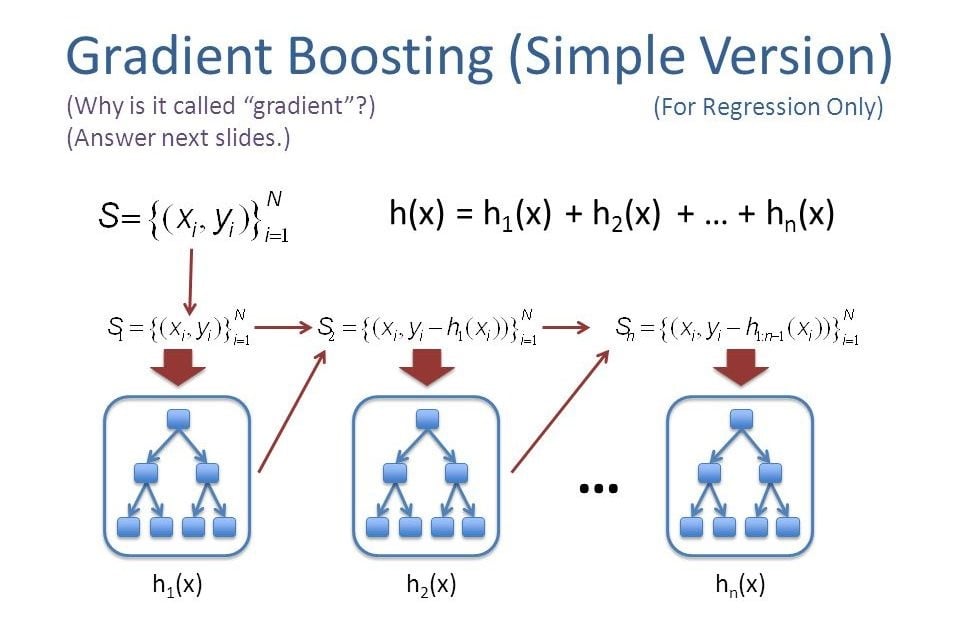
Gradient boosting adalah teknik machine learning untuk masalah regresi dan klasifikasi, yang menghasilkan model prediksi dalam bentuk ansambel model prediksi lemah, biasanya decision tree. Ia membangun model secara bertahap seperti metode boosting lainnya, dan menggeneralisasikannya dengan memungkinkan optimasi fungsi loss yang terdiferensiasi sewenang-wenang. Boosting dapat ditafsirkan sebagai algoritma optimasi pada fungsi biaya yang sesuai. Dua makalah terakhir memperkenalkan pandangan algoritma boosting sebagai algoritma gradient descent fungsional iteratif. Artinya, algoritma yang mengoptimalkan fungsi biaya pada ruang fungsi dengan berulang kali memilih sebuah fungsi (hipotesis lemah) yang mengarah ke arah gradien negatif. Pandangan gradien fungsional ini terhadap boosting telah mendorong pengembangan algoritma boosting di banyak area machine learning dan statistik di luar regresi dan klasifikasi. Gradient boosting menggabungkan "pembelajar" lemah menjadi satu pembelajar kuat secara iteratif. Paling mudah dijelaskan dalam pengaturan regresi least-squares, di mana tujuannya adalah "mengajari" model F untuk memprediksi nilai berbentuk y ^ = F ( x ) dengan meminimalkan mean squared error.
lr = LinearRegression()
dtr = DecisionTreeRegressor()
rfr = RandomForestRegressor()
gbr = GradientBoostingRegressor()
fit1 = lr.fit(X_train,y_train)#Di sini kita memasangkan data pelatihan ke linear regressor
fit2 = dtr.fit(X_train,y_train)#Di sini kita memasangkan data pelatihan ke Decision Tree Regressor
fit3 = rfr.fit(X_train,y_train)#Di sini kita memasangkan data pelatihan ke Random Forest Regressor
fit4 = gbr.fit(X_train,y_train)#Di sini kita memasangkan data pelatihan ke Gradient Boosting Regressor
fit(): Digunakan untuk menghasilkan parameter model pembelajaran dari data pelatihan.
transform(): Parameter yang dihasilkan dari metode fit() diterapkan pada model untuk menghasilkan dataset yang telah ditransformasi.
fit_transform(): Kombinasi API fit() dan transform() pada dataset yang sama.
print("Accuracy Score of Linear regression on train set",fit1.score(X_train,y_train)*100)
print("Accuracy Score of Decision Tree on train set",fit2.score(X_train,y_train)*100)
print("Accuracy Score of Random Forests on train set",fit3.score(X_train,y_train)*100)
print("Accuracy Score of Gradient Boosting on train set",fit4.score(X_train,y_train)*100)
Accuracy Score of Linear regression on train set 11.829233894211866
Accuracy Score of Decision Tree on train set 100.0
Accuracy Score of Random Forests on train set 94.207451077798
Accuracy Score of Gradient Boosting on train set 65.49517152859553
print("Accuracy Score of Linear regression on test set",fit1.score(X_test,y_test)*100)
print("Accuracy Score of Decision Tree on test set",fit2.score(X_test,y_test)*100)
print("Accuracy Score of Random Forests on test set",fit3.score(X_test,y_test)*100)
print("Accuracy Score of Gradient Boosting on testset",fit4.score(X_test,y_test)*100)
Accuracy Score of Linear regression on test set 36.8210287243639
Accuracy Score of Decision Tree on test set 57.61911563230391
Accuracy Score of Random Forests on test set 74.71675935214292
Accuracy Score of Gradient Boosting on testset 72.43849411693184
Tutorial ini memberikan gambaran cepat tentang cara mengisi nilai null. Saya menulisnya karena kebanyakan data nyata jauh lebih berantakan: ada nilai null, nilai yang salah, dan banyak sisa yang harus dibersihkan. Hore! Anda telah menyelesaikan tutorial ini. Jika Anda punya pertanyaan atau pemikiran tentang tutorial ini, jangan ragu untuk menyampaikannya di kolom komentar di bawah.
Jika Anda ingin mempelajari lebih lanjut tentang Machine Learning di Python, lihat tutorial Introduction to Machine Learning in Python dan kursus Preprocessing for Machine Learning in Python dari DataCamp.
Pelajari lebih lanjut tentang Python dan Machine Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



