Kurs
Vorverarbeitung für Machine Learning in Python
4 Std.
68.4K
Zuerst importieren wir die benötigte Basisbibliothek, um mit dem Datensatz zu arbeiten.
import pandas as pd
Als Nächstes lesen wir den Datensatz ein und schauen ihn uns an.
bfriday = pd.read_csv("BlackFriday.csv")
bfriday.head(10)
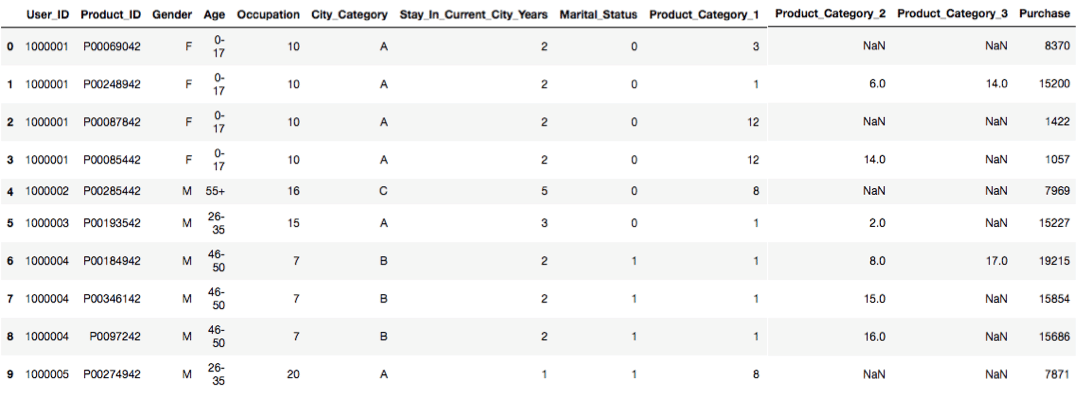
Die Ausgabe zeigt einen Ausschnitt des Datensatzes mit 10 Zeilen und allen Spalten. Wenn du bfriday.head(x,y) versuchst, erhältst du einen Fehler, weil die Gesamtzahl der Spalten bereits fest ist. bfriday.head() gibt ebenfalls eine Ausgabe zurück, ohne Fehler, und wählt Zeilen und Spalten standardmäßig.
bfriday.shape #gibt die Dimensionen des Datensatzes (Zeilen, Spalten) aus
(550068, 12)
bfriday['Stay_In_Current_City_Years'].value_counts()# zählt die Anzahl der Werte pro Bereich, bfriday['City_Category'].value_counts()
1    193821
2    101838
3     95285
5     84726
0     74398
Name: Stay_In_Current_City_Years, dtype: int64
bfriday.isnull().sum() #berechnet die Anzahl der Nullwerte je Spalte im Datensatz
User_ID                            0
Product_ID                         0
Gender                             0
Age                                0
Occupation                         0
City_Category                      0
Stay_In_Current_City_Years         0
Marital_Status                     0
Product_Category_1                 0
Product_Category_2            173638
Product_Category_3            383247
Purchase                           0
dtype: int64
b = ['Product_Category_2','Product_Category_3'] #wir erstellen hier eine Liste mit den Spalten Product_Category_2 und Product_Category_3
for i in b:
    exec("bfriday.%s.fillna(bfriday.%s.value_counts().idxmax(), inplace=True)" %(i,i))
Jetzt haben wir fehlende Werte mit dem häufigsten Wert aufgefüllt. Alternativ kannst du das auch explizit schreiben: bfriday.Product_Category_2.fillna(bfriday.Product_Category_2.value_counts().idxmax(), inplace=True). Genauso lässt sich die Spalte Product_Category_3 bereinigen.
X = bfriday.drop(["Purchase"], axis=1)
Wir haben die Spalte Purchase aus dem Datensatz entfernt und ein Array X erstellt, das alle Spalten außer Purchase enthält.
from sklearn.preprocessing import LabelEncoder#Jetzt importieren wir den Encoder aus sklearn
LE = LabelEncoder()
#Wir encodieren die Daten per LabelEncoder, um die Verarbeitung zu erleichtern
X = X.apply(LE.fit_transform)#Hier wenden wir den Encoder auf die Daten an
Nun wandeln wir die Daten mit pandas in numerische Formen um, da der Umgang mit numerischen Daten einfacher ist als mit kategorialen Daten.
X.Gender = pd.to_numeric(X.Gender)
X.Age = pd.to_numeric(X.Age)
X.Occupation = pd.to_numeric(X.Occupation)
X.City_Category = pd.to_numeric(X.City_Category)
X.Stay_In_Current_City_Years = pd.to_numeric(X.Stay_In_Current_City_Years)
X.Marital_Status = pd.to_numeric(X.Marital_Status)
X.Product_Category_1 = pd.to_numeric(X.Product_Category_1)
X.Product_Category_2 = pd.to_numeric(X.Product_Category_2)
X.Product_Category_3 = pd.to_numeric(X.Product_Category_3)
Y = bfriday["Purchase"]#Wir erstellen ein Array Y aus der Spalte Purchase
from sklearn.preprocessing import StandardScaler
SS = StandardScaler()
Standardisiere Features, indem der Mittelwert entfernt und auf Einheitsvarianz skaliert wird. Zentrierung und Skalierung passieren für jedes Feature unabhängig, basierend auf den Statistiken des Trainingsdatensatzes. Mittelwert und Standardabweichung werden gespeichert und mit der transform-Methode auf spätere Daten angewendet.
Xs = SS.fit_transform(X)
#Du musst X in eine numerische Darstellung transformieren (nicht zwingend binär), da alle ML-Methoden mit Zahlenmatrizen arbeiten.
from sklearn.decomposition import PCA
pc = PCA(4)#4 gibt die gewünschte Anzahl der Komponenten an
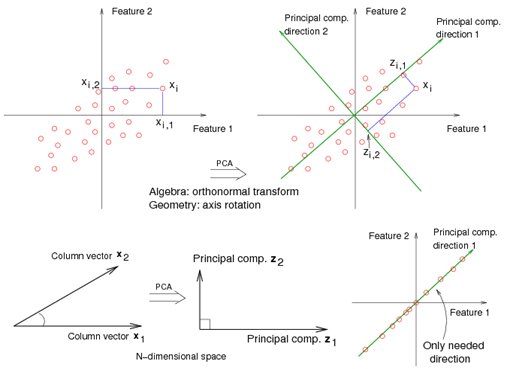
Lineare Dimensionsreduktion mittels Singular Value Decomposition projiziert die Daten in einen Raum geringerer Dimension. PCA ist eine der bekanntesten Methoden zur Dimensionsreduktion und hilft, ML-Algorithmen zu beschleunigen. Du solltest PCA nur auf den Trainingsdaten fitten. Die Hauptkomponentenanalyse (PCA)
PCA ersetzt die ursprünglichen Variablen durch neue Variablen, die Hauptkomponenten, die paarweise unkorreliert sind und abnehmende Varianzen aufweisen. Entsprechend ist die Kovarianzmatrix zwischen den aus den Daten extrahierten Hauptkomponenten diagonal.
Hinweis: Verwende RandomizedPCA niemals für Sparse-Daten. RandomizedPCA auf Sparse-Daten ist falsch, weil wir die Daten zum Zentrieren nicht ohne Verlust der Sparsity verschieben können, was bei realistisch großen Sparse-Daten den Speicher sprengen kann. Zentrierung ist für PCA jedoch erforderlich.
principalComponents = pc.fit_transform(X)#Wir wenden PCA auf die Daten an/fitten die Daten auf PCA
pc.explained_variance_ratio_
array([7.35041374e-01, 2.64935995e-01, 1.10061180e-05, 6.21704987e-06])
principalDf = pd.DataFrame(data = principalComponents, columns = ["component 1", "component 2", "component 3", "component 4"])
from sklearn.model_selection import KFold
kf = KFold(20)
#Erstellt Train/Test-Indizes zum Splitten in Trainings- und Test-Sets. Teilt den Datensatz in k aufeinanderfolgende Folds (standardmäßig ohne Shuffling).
#Jeder Fold dient einmal als Validierung, während die übrigen k - 1 Folds das Trainingsset bilden.
for a,b in kf.split(principalDf):
    X_train, X_test = Xs[a],Xs[b]
    y_train, y_test = Y[a],Y[b]
from sklearn.linear_model import LinearRegression
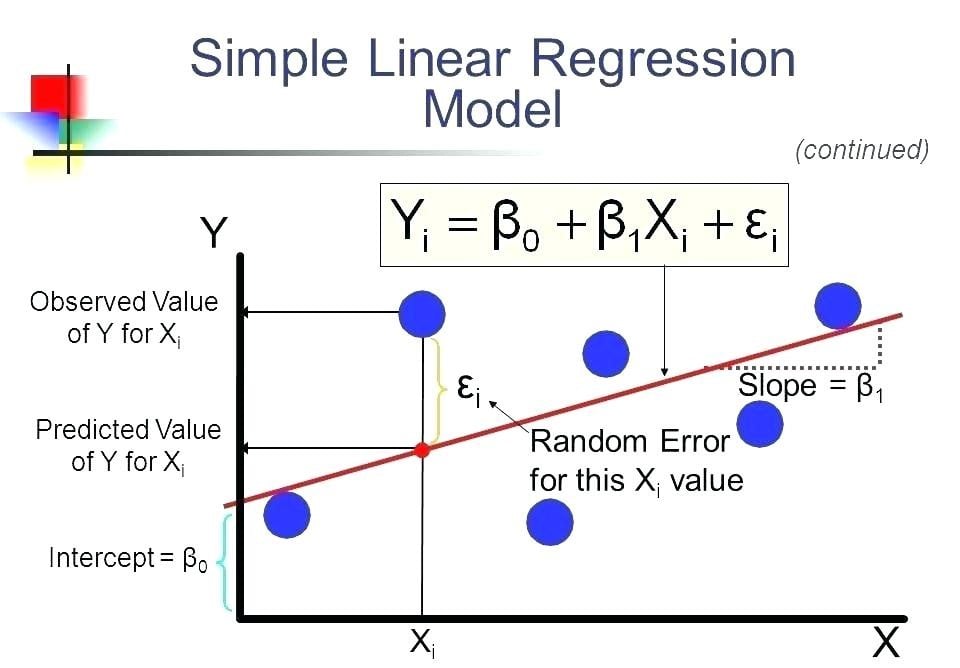
Mit Regression prüfst du zwei Dinge: (1) Sagt ein Set an Prädiktorvariablen die Zielvariable gut vorher? (2) Welche Variablen sind signifikante Prädiktoren und wie beeinflussen sie das Ergebnis — erkennbar an Betrag und Vorzeichen der Koeffizienten? Diese Schätzungen erklären die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen. Die einfachste Regressionsformel mit einer abhängigen und einer unabhängigen Variable lautet y = c + b*x, wobei y die geschätzte Zielgröße ist, c die Konstante, b der Regressionskoeffizient und x der Wert der unabhängigen Variable.
from sklearn.tree import DecisionTreeRegressor
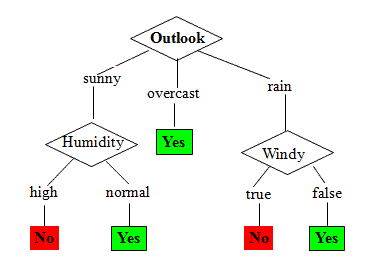
Ein Entscheidungsbaum wird top-down aus einem Wurzelknoten aufgebaut und partitioniert die Daten in Teilmengen mit ähnlichen Werten. Entscheidungsbäume modellieren als Baumstruktur, zerlegen den Datensatz iterativ in kleinere Teilmengen und entwickeln dabei schrittweise den Baum mit Entscheidungs- und Blattknoten. Ein Entscheidungsknoten (z. B. Outlook) hat zwei oder mehr Äste (z. B. Sunny, Overcast, Rainy), die Werte des getesteten Attributs repräsentieren. Ein Blattknoten (z. B. Hours Played) repräsentiert eine Entscheidung über das numerische Ziel. Der oberste Knoten, der beste Prädiktor, heißt Wurzelknoten. Entscheidungsbäume können kategoriale und numerische Daten verarbeiten. Wenn die Zielvariable stetige Werte annimmt, spricht man von Regressionsbäumen. Ist die maximale Tiefe zu hoch, lernen Bäume zu viele Details und auch Rauschen — Overfitting.
from sklearn.ensemble import RandomForestRegressor
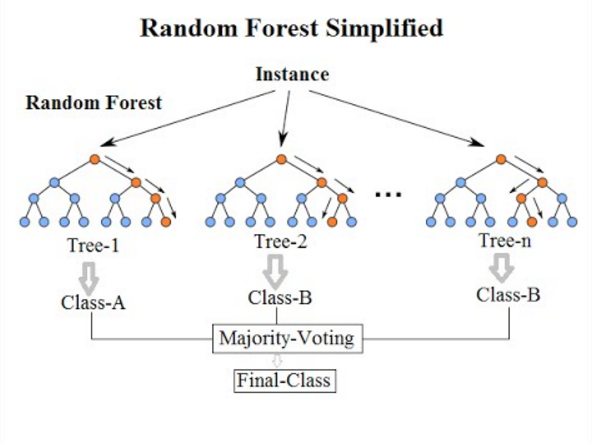
Ein Random Forest ist ein Schätzer, der viele Entscheidungsbäume auf unterschiedlichen Teilstichproben des Datensatzes fitted und ihre Vorhersagen mittelt, um Genauigkeit zu verbessern und Overfitting zu kontrollieren. Die Teilstichprobe hat standardmäßig die gleiche Größe wie die Eingangsstichprobe, die Ziehung erfolgt mit Zurücklegen, wenn bootstrap=True. Die Idee ist, die Bäume zu dekorrelieren. Es werden verschiedene Bootstrapping-Stichproben aus den Trainingsdaten erzeugt und die Varianz durch Mittelung reduziert. Random-Forest-Modelle sind sehr gut für tabellarische Daten mit numerischen Features oder kategorialen Features mit weniger als einigen Hundert Kategorien geeignet. Sie können nichtlineare Wechselwirkungen zwischen Features und Ziel erfassen.
Hinweis: Baumbasierte Modelle sind nicht für sehr spärliche Features ausgelegt. Bei Sparse-Inputdaten sollten wir entweder numerische Statistiken aus den sparsamen Features extrahieren oder auf ein lineares Modell wechseln, das sich dafür besser eignet.
from sklearn.ensemble import GradientBoostingRegressor
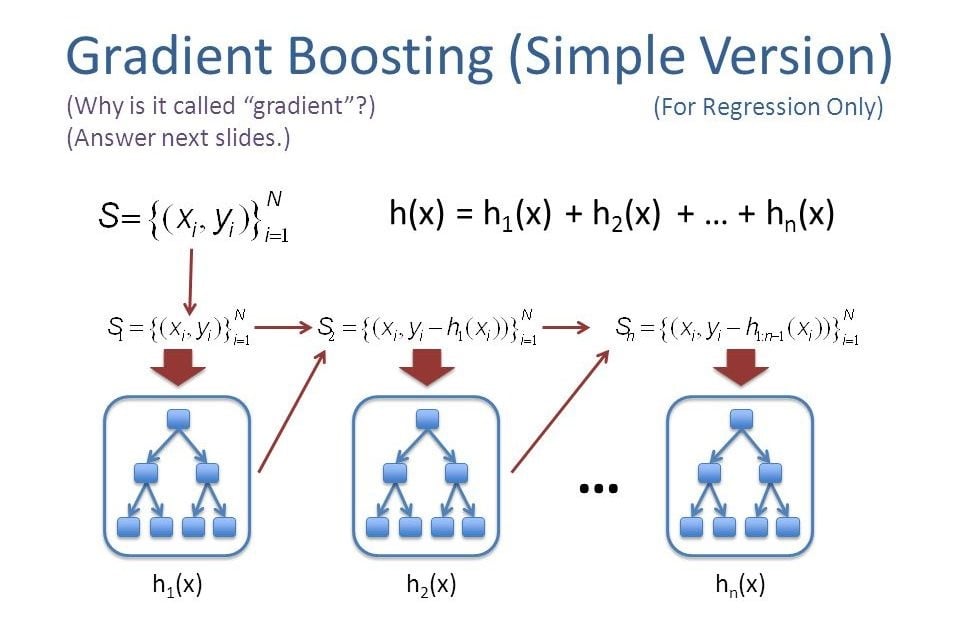
Gradient Boosting ist eine ML-Technik für Regressions- und Klassifikationsprobleme und erzeugt ein Vorhersagemodell als Ensemble schwacher Lerner, meist Entscheidungsbäume. Das Modell wird stufenweise aufgebaut, ähnlich wie andere Boosting-Methoden, und verallgemeinert diese, indem eine beliebige differenzierbare Verlustfunktion optimiert wird. Boosting lässt sich als Optimierungsalgorithmus auf einer geeigneten Kostenfunktion interpretieren: Iteratives funktionales Gradientenabstieg, bei dem in jedem Schritt ein schwacher Lerner in Richtung des negativen Gradienten gewählt wird. In der Least-Squares-Regression lässt sich das besonders einfach erklären: Ein Modell F wird so „trainiert“, dass es Werte der Form ŷ = F(x) vorhersagt, indem der mittlere quadratische Fehler minimiert wird.
lr = LinearRegression()
dtr = DecisionTreeRegressor()
rfr = RandomForestRegressor()
gbr = GradientBoostingRegressor()
fit1 = lr.fit(X_train,y_train)#Training des Linearen Regressors
fit2 = dtr.fit(X_train,y_train)#Training des DecisionTreeRegressors
fit3 = rfr.fit(X_train,y_train)#Training des RandomForestRegressors
fit4 = gbr.fit(X_train,y_train)#Training des GradientBoostingRegressors
fit(): Ermittelt die Modellparameter aus den Trainingsdaten.
transform(): Wendet die durch fit() gewonnenen Parameter an, um den Datensatz zu transformieren.
fit_transform(): Kombination aus fit() und transform() auf demselben Datensatz.
print("Accuracy Score of Linear regression on train set",fit1.score(X_train,y_train)*100)
print("Accuracy Score of Decision Tree on train set",fit2.score(X_train,y_train)*100)
print("Accuracy Score of Random Forests on train set",fit3.score(X_train,y_train)*100)
print("Accuracy Score of Gradient Boosting on train set",fit4.score(X_train,y_train)*100)
Accuracy Score of Linear regression on train set 11.829233894211866
Accuracy Score of Decision Tree on train set 100.0
Accuracy Score of Random Forests on train set 94.207451077798
Accuracy Score of Gradient Boosting on train set 65.49517152859553
print("Accuracy Score of Linear regression on test set",fit1.score(X_test,y_test)*100)
print("Accuracy Score of Decision Tree on test set",fit2.score(X_test,y_test)*100)
print("Accuracy Score of Random Forests on test set",fit3.score(X_test,y_test)*100)
print("Accuracy Score of Gradient Boosting on testset",fit4.score(X_test,y_test)*100)
Accuracy Score of Linear regression on test set 36.8210287243639
Accuracy Score of Decision Tree on test set 57.61911563230391
Accuracy Score of Random Forests on test set 74.71675935214292
Accuracy Score of Gradient Boosting on testset 72.43849411693184
Dieses Tutorial zeigt dir kurz und bündig, wie du Nullwerte füllst. Ich habe darüber geschrieben, weil echte Daten meist unordentlicher sind: Nullwerte, falsche Einträge und jede Menge Reste, die bereinigt werden müssen. Glückwunsch! Du hast das Tutorial abgeschlossen. Wenn du Fragen oder Anmerkungen hast, schreib sie gern unten in die Kommentare.
Wenn du mehr über Machine Learning in Python lernen möchtest, schau dir DataCamps Tutorial Introduction to Machine Learning in Python und den Kurs Preprocessing for Machine Learning in Python an.
Lerne mehr über Python und Machine Learning
Kurs
Kurs
Kurs
Blog
Nathaniel Taylor-Leach
4 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Aditya Sharma
5 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
Adel Nehme
5 Min.
Tutorial
Matt Crabtree
5 Min.




