Curso
Preprocesamiento para machine learning en Python
4 h
68.3K
Primero, vamos a importar la librería básica necesaria para trabajar con el conjunto de datos.
import pandas as pd
Ahora leemos el conjunto de datos y lo visualizamos.
bfriday = pd.read_csv("BlackFriday.csv")
bfriday.head(10)
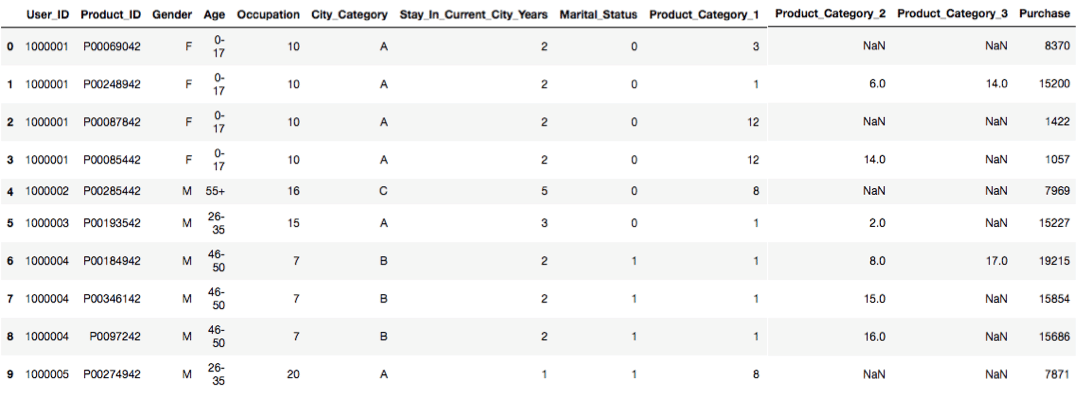
La instrucción anterior nos muestra una parte del conjunto de datos con 10 filas y todas las columnas. Si intentas usar bfriday.head(x,y) dará error porque el número de columnas no se puede especificar; bfriday.head() también te devolverá un resultado sin error y el sistema elegirá por defecto el número de filas a mostrar.
bfriday.shape # esto nos da las dimensiones del conjunto (filas, columnas)
(550068, 12)
bfriday['Stay_In_Current_City_Years'].value_counts()# cuenta el número de valores por cada rango, bfriday['City_Category'].value_counts()
1    193821
2    101838
3     95285
5     84726
0     74398
Name: Stay_In_Current_City_Years, dtype: int64
bfriday.isnull().sum() # calcula el número de valores nulos por columna en el conjunto de datos
User_ID                            0
Product_ID                         0
Gender                             0
Age                                0
Occupation                         0
City_Category                      0
Stay_In_Current_City_Years         0
Marital_Status                     0
Product_Category_1                 0
Product_Category_2            173638
Product_Category_3            383247
Purchase                           0
dtype: int64
b = ['Product_Category_2','Product_Category_3'] # aquí creamos una lista con las columnas Product_Category_2 y Product_Category_3
for i in b:
    exec("bfriday.%s.fillna(bfriday.%s.value_counts().idxmax(), inplace=True)" %(i,i))
Ahora hemos rellenado los huecos con el valor más frecuente. También puedes limpiar o rellenar así: bfriday.Product_Category_2.fillna(bfriday.Product_Category_2.value_counts().idxmax(), inplace=True); de forma análoga, para la columna Product_Category_3.
X = bfriday.drop(["Purchase"], axis=1)
Hemos eliminado la columna "Purchase" del conjunto de datos y creado un array llamado X que contiene todas las columnas excepto la de compras.
from sklearn.preprocessing import LabelEncoder # ahora importamos el codificador de sklearn
LE = LabelEncoder()
# ahora codificaremos los datos en etiquetas con LabelEncoder para facilitar el cómputo
X = X.apply(LE.fit_transform) # aplicamos el codificador a los datos
Ahora convertimos los datos a formato numérico con pandas, porque trabajar con datos numéricos es más sencillo que con categóricos.
X.Gender = pd.to_numeric(X.Gender)
X.Age = pd.to_numeric(X.Age)
X.Occupation = pd.to_numeric(X.Occupation)
X.City_Category = pd.to_numeric(X.City_Category)
X.Stay_In_Current_City_Years = pd.to_numeric(X.Stay_In_Current_City_Years)
X.Marital_Status = pd.to_numeric(X.Marital_Status)
X.Product_Category_1 = pd.to_numeric(X.Product_Category_1)
X.Product_Category_2 = pd.to_numeric(X.Product_Category_2)
X.Product_Category_3 = pd.to_numeric(X.Product_Category_3)
Y = bfriday["Purchase"] # aquí creamos un array Y con la columna de compras
from sklearn.preprocessing import StandardScaler
SS = StandardScaler()
Estandariza las variables eliminando la media y escalando a varianza unitaria. El centrado y el escalado se aplican de forma independiente a cada variable calculando las estadísticas relevantes sobre las muestras del conjunto de entrenamiento. La media y la desviación estándar quedan guardadas para aplicar después la transformación con el método transform.
Xs = SS.fit_transform(X)
# Debes transformar X a una representación numérica (no necesariamente binaria), porque todos los métodos de machine learning operan con matrices numéricas.
from sklearn.decomposition import PCA
pc = PCA(4) # 4 indica el número de componentes que quieres obtener
La reducción lineal de la dimensionalidad mediante descomposición en valores singulares proyecta los datos a un espacio de menor dimensión. PCA es uno de los métodos de reducción de dimensionalidad más utilizados. Para acelerar los algoritmos de machine learning, se ajusta PCA solo sobre el conjunto de entrenamiento. Análisis de componentes principales (PCA).
PCA sustituye las variables originales por nuevas variables, llamadas componentes principales, que no covarían entre sí y cuyas varianzas están en orden decreciente. Es decir, la matriz de covarianzas entre los componentes principales extraídos de los datos es diagonal.
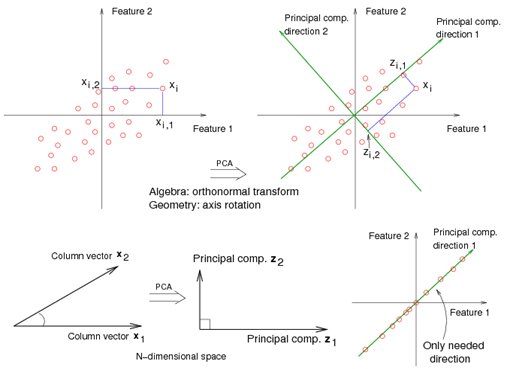
Nota: nunca uses RandomizedPCA con datos dispersos (sparse). No se puede centrar la matriz sin romper la dispersidad, lo que dispararía el consumo de memoria en datos dispersos de tamaño realista. Sin embargo, el centrado es necesario para PCA.
principalComponents = pc.fit_transform(X) # aplicamos PCA a los datos/ajustamos los datos a PCA
pc.explained_variance_ratio_
array([7.35041374e-01, 2.64935995e-01, 1.10061180e-05, 6.21704987e-06])
principalDf = pd.DataFrame(data = principalComponents, columns = ["component 1", "component 2", "component 3", "component 4"])
from sklearn.model_selection import KFold
kf = KFold(20)
# Proporciona índices de train/test para dividir los datos en conjuntos de entrenamiento y validación. Divide el conjunto en k pliegues consecutivos (sin barajar por defecto).
# Cada pliegue se usa una vez como validación y los k - 1 restantes forman el conjunto de entrenamiento.
for a,b in kf.split(principalDf):
    X_train, X_test = Xs[a], Xs[b]
    y_train, y_test = Y[a], Y[b]
from sklearn.linear_model import LinearRegression
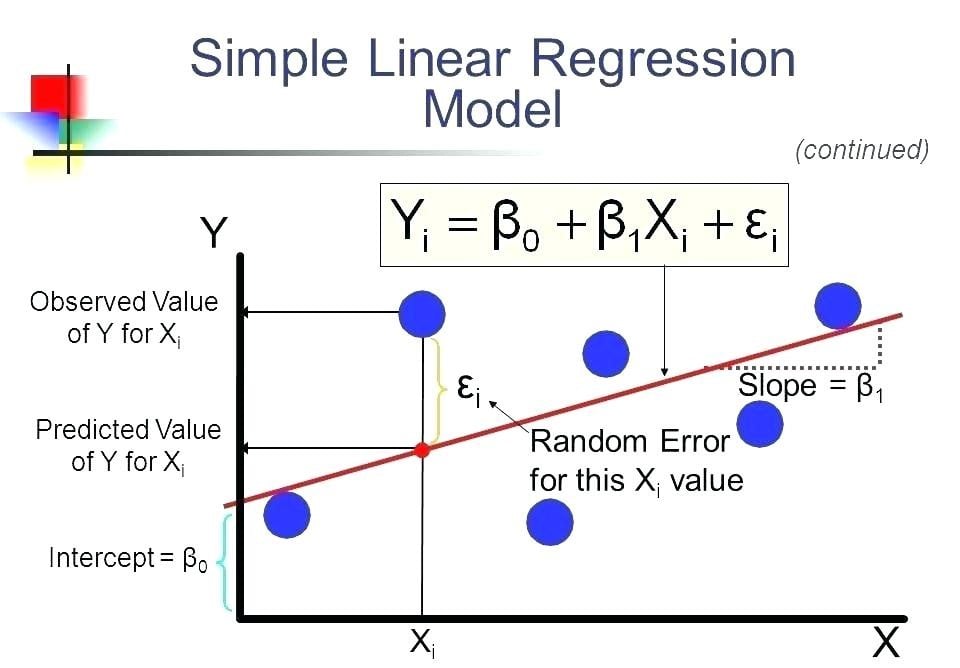
La regresión sirve para analizar dos cuestiones: (1) si un conjunto de variables predictoras hace un buen trabajo prediciendo una variable de salida (dependiente) y (2) cuáles de esas variables son predictores significativos y cómo influyen en la variable de salida según el signo y la magnitud de sus coeficientes beta. Estas estimaciones se usan para explicar la relación entre una variable dependiente y una o más independientes. La forma más simple, con una dependiente y una independiente, se define como y = c + b*x, donde y es la estimación de la dependiente, c la constante, b el coeficiente de regresión y x la puntuación de la independiente.
from sklearn.tree import DecisionTreeRegressor
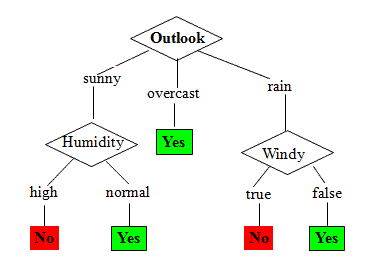
Un árbol de decisión se construye de arriba abajo desde un nodo raíz y consiste en particionar los datos en subconjuntos con valores similares. El modelo tiene forma de árbol: el conjunto de datos se divide en subconjuntos cada vez más pequeños a la vez que se va desarrollando el árbol. El resultado final es un árbol con nodos de decisión y nodos hoja. Un nodo de decisión (p. ej., Outlook) tiene dos o más ramas (p. ej., Sunny, Overcast y Rainy), cada una representa valores para el atributo evaluado. Un nodo hoja (p. ej., Hours Played) representa una decisión sobre el objetivo numérico. El nodo superior, correspondiente al mejor predictor, se denomina nodo raíz. Los árboles pueden manejar datos categóricos y numéricos. Cuando la variable objetivo toma valores continuos, hablamos de árboles de regresión. Si la profundidad máxima es demasiado alta, el árbol puede ajustarse en exceso (overfitting) aprendiendo ruido del entrenamiento.
from sklearn.ensemble import RandomForestRegressor
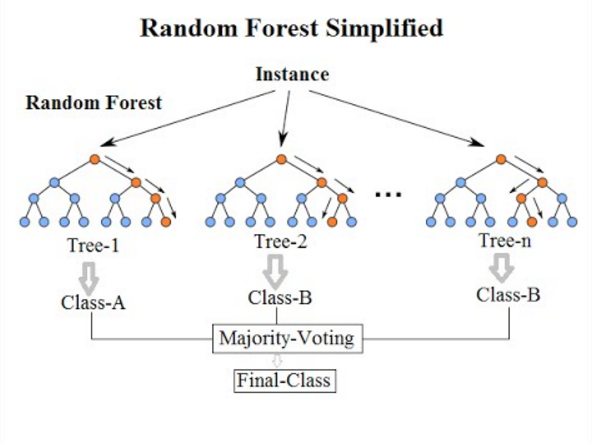
Un random forest es un estimador que ajusta varios árboles de decisión sobre distintas submuestras del conjunto de datos y promedia para mejorar la precisión predictiva y controlar el sobreajuste. El tamaño de la submuestra suele coincidir con el del conjunto original y, si bootstrap=True, las muestras se toman con reemplazo. La idea es descorrelacionar los árboles. Se generan diferentes muestras bootstrapped (autogeneradas) del entrenamiento y luego reducimos la varianza promediando. Así, se crean muchos árboles de decisión. El modelo de random forest funciona muy bien con datos tabulares con variables numéricas o categóricas con menos de cientos de categorías. Es capaz de capturar interacciones no lineales entre variables y objetivo.
Nota: los modelos basados en árboles no están pensados para funcionar con variables extremadamente dispersas. Con entradas sparse, podemos preprocesarlas para obtener estadísticas numéricas o cambiar a un modelo lineal, más adecuado en estos casos.
from sklearn.ensemble import GradientBoostingRegressor
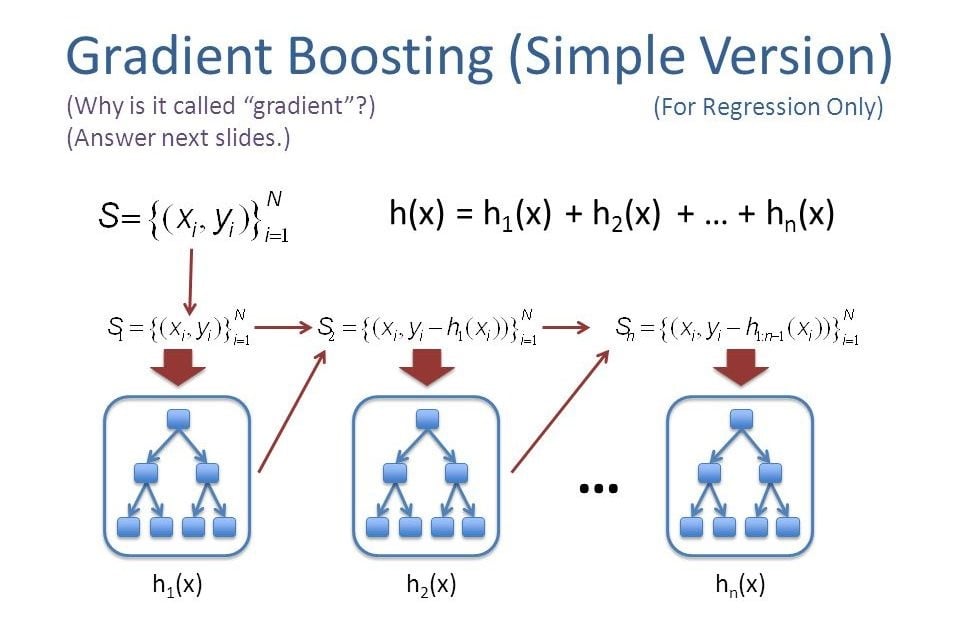
Gradient boosting es una técnica de machine learning para regresión y clasificación que produce un modelo de predicción en forma de conjunto (ensemble) de modelos débiles, normalmente árboles de decisión. Construye el modelo de forma iterativa, como otros métodos de boosting, y generaliza permitiendo optimizar una función de pérdida diferenciable. El boosting puede interpretarse como un algoritmo de optimización sobre una función de coste adecuada: en cada iteración elige una función (hipótesis débil) que apunta en la dirección del gradiente negativo. Esta visión funcional ha impulsado algoritmos de boosting más allá de la regresión y la clasificación. En regresión de mínimos cuadrados, el objetivo es entrenar un modelo F para predecir y^ = F(x) minimizando el error cuadrático medio.
lr = LinearRegression()
dtr = DecisionTreeRegressor()
rfr = RandomForestRegressor()
gbr = GradientBoostingRegressor()
fit1 = lr.fit(X_train, y_train) # ajustamos los datos de entrenamiento al regresor lineal
fit2 = dtr.fit(X_train, y_train) # ajustamos los datos de entrenamiento al árbol de decisión
fit3 = rfr.fit(X_train, y_train) # ajustamos los datos de entrenamiento al random forest
fit4 = gbr.fit(X_train, y_train) # ajustamos los datos de entrenamiento al gradient boosting
fit(): se usa para aprender los parámetros del modelo a partir de los datos de entrenamiento.
transform(): aplica a los datos la transformación definida por los parámetros aprendidos con fit().
fit_transform(): combina fit() y transform() sobre el mismo conjunto de datos.
print("Accuracy Score of Linear regression on train set", fit1.score(X_train, y_train)*100)
print("Accuracy Score of Decision Tree on train set", fit2.score(X_train, y_train)*100)
print("Accuracy Score of Random Forests on train set", fit3.score(X_train, y_train)*100)
print("Accuracy Score of Gradient Boosting on train set", fit4.score(X_train, y_train)*100)
Accuracy Score of Linear regression on train set 11.829233894211866
Accuracy Score of Decision Tree on train set 100.0
Accuracy Score of Random Forests on train set 94.207451077798
Accuracy Score of Gradient Boosting on train set 65.49517152859553
print("Accuracy Score of Linear regression on test set", fit1.score(X_test, y_test)*100)
print("Accuracy Score of Decision Tree on test set", fit2.score(X_test, y_test)*100)
print("Accuracy Score of Random Forests on test set", fit3.score(X_test, y_test)*100)
print("Accuracy Score of Gradient Boosting on testset", fit4.score(X_test, y_test)*100)
Accuracy Score of Linear regression on test set 36.8210287243639
Accuracy Score of Decision Tree on test set 57.61911563230391
Accuracy Score of Random Forests on test set 74.71675935214292
Accuracy Score of Gradient Boosting on testset 72.43849411693184
Este tutorial te da una idea rápida de cómo rellenar valores nulos. Lo he tratado porque, la mayoría de las veces, los datos reales están más desordenados: hay nulos, valores incorrectos y mucho "ruido" que hay que limpiar. ¡Bien! Has completado este tutorial. Si tienes preguntas o comentarios sobre el contenido, cuéntanoslo abajo.
Si quieres seguir aprendiendo machine learning en Python, echa un ojo al tutorial Introduction to Machine Learning in Python de DataCamp y al curso Preprocessing for Machine Learning in Python.
Aprende más sobre Python y machine learning
Curso
Curso
Curso
blog
Abid Ali Awan
7 min
Tutorial
Moez Ali
14 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Kevin Babitz
8 min
Tutorial
Kurtis Pykes
8 min
Tutorial
Avinash Navlani
15 min