कोर्स
Python में Machine Learning के लिए Preprocessing
4 घंटा
68.6K
सबसे पहले डेटासेट पर काम करने के लिए आवश्यक बेसिक लाइब्रेरी इम्पोर्ट करते हैं।
import pandas as pd
अब डेटासेट पढ़ते हैं और देखते हैं।
bfriday = pd.read_csv("BlackFriday.csv")
bfriday.head(10)
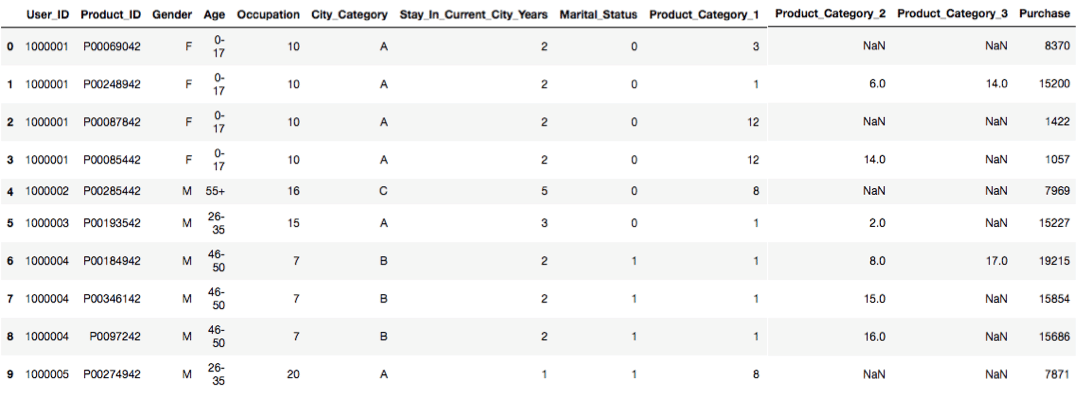
ऊपर की पंक्ति हमें 10 पंक्तियों और सभी कॉलम के साथ डेटासेट का एक हिस्सा देती है। यदि आप bfriday.head(x,y) देंगे तो यह एक त्रुटि होगी क्योंकि कंप्यूटर पहले से कुल कॉलम संख्या को अनिवार्य मानता है। bfriday.head() यह भी आपको आउटपुट देगा और कोई त्रुटि नहीं होगी, और कंप्यूटर अपनी पसंद से पंक्तियाँ और कॉलम लेता है।
bfriday.shape #यह हमें डेटासेट के आयाम (rows,columns) देता है
(550068, 12)
bfriday['Stay_In_Current_City_Years'].value_counts()# प्रत्येक रेंज के प्रति मानों की गिनती करता है, bfriday['City_Category'].value_counts()
1    193821
2    101838
3     95285
5     84726
0     74398
Name: Stay_In_Current_City_Years, dtype: int64
bfriday.isnull().sum() #डेटासेट में हर श्रेणी के लिए null मानों की संख्या निकालता है
User_ID                            0
Product_ID                         0
Gender                             0
Age                                0
Occupation                         0
City_Category                      0
Stay_In_Current_City_Years         0
Marital_Status                     0
Product_Category_1                 0
Product_Category_2            173638
Product_Category_3            383247
Purchase                           0
dtype: int64
b = ['Product_Category_2','Product_Category_3'] #यहाँ हम 2 कॉलम्स: Product_Category_2, Product_Category_3 से युक्त एक एरे बना रहे हैं
for i in b:
    exec("bfriday.%s.fillna(bfriday.%s.value_counts().idxmax(), inplace=True)" %(i,i))
अब हम खाली स्थानों को अधिकतम मान से भर देंगे। हम bfriday.Product_Category_2.fillna(bfriday.Product_Category_2.value_counts().idxmax(),inplace=True) से भी खाली स्थानों को साफ़/भर सकते हैं; इसी तरह आप Product_category_3 नामक कॉलम को भी साफ़ कर सकते हैं।
X = bfriday.drop(["Purchase"], axis=1)
अब हमने डेटासेट से purchase नाम का कॉलम हटा दिया है और X नाम का एक एरे बनाया है जिसमें purchase कॉलम को छोड़कर सभी कॉलम शामिल हैं।
from sklearn.preprocessing import LabelEncoder#अब sklearn लाइब्रेरी से encoder इम्पोर्ट करते हैं
LE = LabelEncoder()
#अब हम आसान कम्प्यूटिंग के लिए डेटा को लेबल्स में एन्कोड करेंगे
X = X.apply(LE.fit_transform)#यहाँ हमने एन्कोडर को डेटा पर लागू किया
अब हम pandas का उपयोग करके डेटा को संख्यात्मक रूप में बदलेंगे, क्योंकि संख्यात्मक डेटा के साथ काम करना श्रेणीबद्ध डेटा की तुलना में आसान होता है।
X.Gender = pd.to_numeric(X.Gender)
X.Age = pd.to_numeric(X.Age)
X.Occupation = pd.to_numeric(X.Occupation)
X.City_Category = pd.to_numeric(X.City_Category)
X.Stay_In_Current_City_Years = pd.to_numeric(X.Stay_In_Current_City_Years)
X.Marital_Status = pd.to_numeric(X.Marital_Status)
X.Product_Category_1 = pd.to_numeric(X.Product_Category_1)
X.Product_Category_2 = pd.to_numeric(X.Product_Category_2)
X.Product_Category_3 = pd.to_numeric(X.Product_Category_3)
Y = bfriday["Purchase"]#यहाँ हमने Y नामक एरे बनाया जो purchase कॉलम के डेटा से बना है
from sklearn.preprocessing import StandardScaler
SS = StandardScaler()
फीचर्स को मानक बनाना, औसत हटाकर और यूनिट वैरिएंस तक स्केल करके किया जाता है। सेंट्रिंग और स्केलिंग प्रत्येक फीचर पर स्वतंत्र रूप से लागू होती है, जिसके लिए प्रशिक्षण सेट के सैम्पल्स पर प्रासंगिक सांख्यिकी की गणना की जाती है। इसके बाद mean और standard deviation को स्टोर कर लिया जाता है ताकि बाद के डेटा पर transform मेथड का उपयोग करते समय काम आए।
Xs = SS.fit_transform(X)
#आपको X को संख्यात्मक अभिव्यक्ति (ज़रूरी नहीं कि बाइनरी) में बदलना चाहिए। क्योंकि सभी मशीन लर्निंग विधियाँ संख्याओं की मैट्रिसेज़ पर काम करती हैं
from sklearn.decomposition import PCA
pc = PCA(4)#यहाँ 4 उस संख्या को दिखाता है जितने घटकों में आप इसे बदलना चाहते हैं।
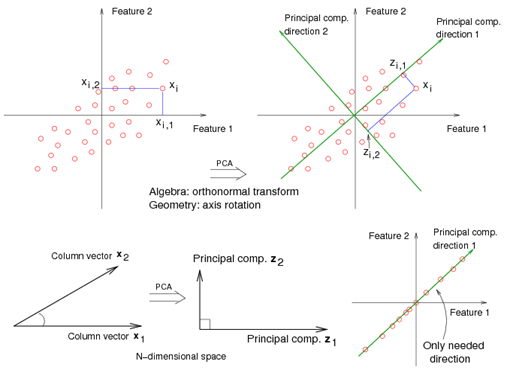
डेटा के Singular Value Decomposition का उपयोग करते हुए रैखिक आयामीयता में कमी का उद्देश्य इसे निम्न-आयामी स्पेस में प्रोजेक्ट करना है। PCA सबसे अधिक उपयोग की जाने वाली और प्रसिद्ध आयामीयता घटाने की विधियों में से एक है। मशीन लर्निंग एल्गोरिद्म को तेज करने के लिए PCA का उपयोग होता है; आप केवल प्रशिक्षण सेट पर ही PCA फिट करते हैं। Principal component analysis (PCA)
PCA मूल चर को नए चरों, जिन्हें प्रिंसिपल कंपोनेंट्स कहा जाता है, से प्रतिस्थापित करता है, जिनकी सह-परिवर्तन शून्य होती है और जिनका वैरिएंस घटते क्रम में होता है। इस प्रकार, डेटा से निकाले गए प्रिंसिपल कंपोनेंट्स के बीच सह-परिवर्तन मैट्रिक्स।
नोट:—Sparse डेटा के लिए कभी भी RandomizedPCA का उपयोग न करें। Sparse डेटा पर RandomizedPCA का उपयोग गलत है क्योंकि हम स्पार्सिटी को तोड़े बिना डेटा को सेंट्र नहीं कर सकते, जो वास्तविक आकार के स्पार्स डेटा पर मेमोरी को बुरी तरह बढ़ा सकता है। हालांकि PCA के लिए सेंट्रिंग आवश्यक है।
principalComponents = pc.fit_transform(X)#यहाँ हम डेटा पर PCA लागू कर रहे हैं/डेटा को PCA पर फिट कर रहे हैं
pc.explained_variance_ratio_
array([7.35041374e-01, 2.64935995e-01, 1.10061180e-05, 6.21704987e-06])
principalDf = pd.DataFrame(data = principalComponents, columns = ["component 1", "component 2", "component 3", "component 4"])
from sklearn.model_selection import KFold
kf = KFold(20)
#ट्रेन/टेस्ट सेट्स में डेटा विभाजित करने के लिए ट्रेन/टेस्ट इंडेक्स प्रदान करता है। डिफ़ॉल्ट रूप से बिना शफल किए डेटासेट को k क्रमिक फोल्ड्स में विभाजित करता है।
#इसके बाद प्रत्येक फोल्ड को एक बार वैलिडेशन के रूप में उपयोग किया जाता है जबकि शेष k - 1 फोल्ड्स ट्रेनिंग सेट बनाते हैं।
for a,b in kf.split(principalDf):
    X_train, X_test = Xs[a],Xs[b]
    y_train, y_test = Y[a],Y[b]
from sklearn.linear_model import LinearRegression
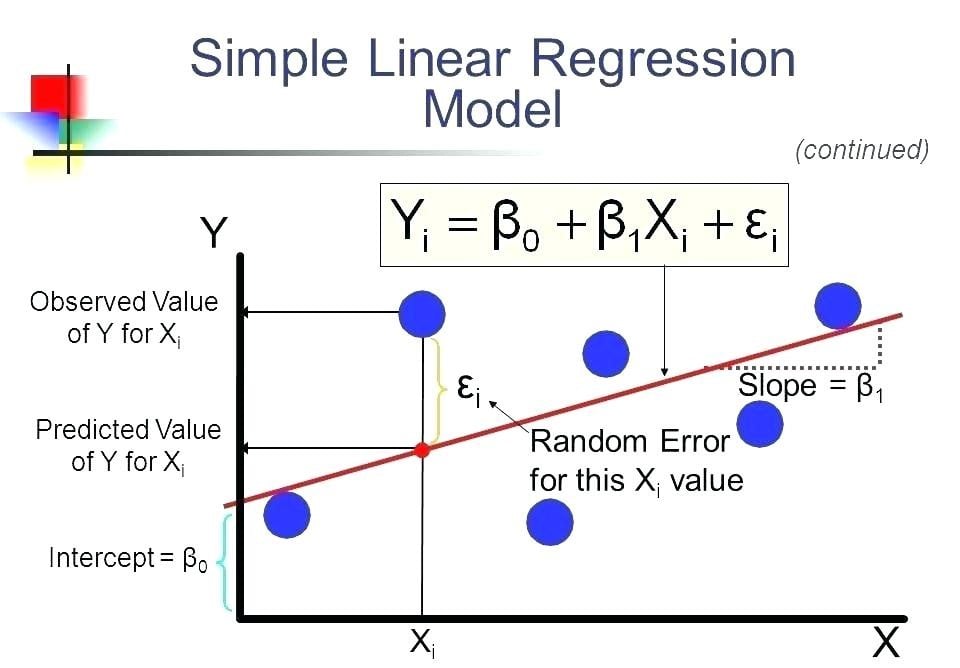
रिग्रेशन दो बातों की जाँच करने के लिए होता है: (1) क्या प्रेडिक्टर वेरिएबल्स का एक सेट आउटपुट (निर्भर) वेरिएबल की अच्छी भविष्यवाणी करता है? (2) कौन से वेरिएबल्स विशेष रूप से आउटपुट वेरिएबल के महत्वपूर्ण प्रेडिक्टर्स हैं, और किस तरह—जिसे बीटा अनुमानों की परिमाण और संकेत से दर्शाया जाता है—वे आउटपुट वेरिएबल को प्रभावित करते हैं? इन रिग्रेशन अनुमानों का उपयोग एक निर्भर वेरिएबल और एक या अधिक स्वतंत्र वेरिएबल्स के बीच संबंध समझाने के लिए किया जाता है। एक निर्भर और एक स्वतंत्र वेरिएबल के साथ रिग्रेशन समीकरण का सबसे सरल रूप y = c + b*x से परिभाषित होता है, जहाँ y = अनुमानित निर्भर वेरिएबल स्कोर, c = स्थिरांक, b = रिग्रेशन गुणांक, और x = स्वतंत्र वेरिएबल पर स्कोर।
from sklearn.tree import DecisionTreeRegressor
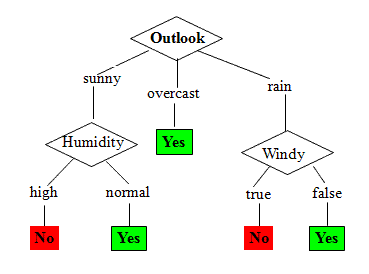
एक निर्णय वृक्ष शीर्ष-से-नीचे, रूट नोड से बनाया जाता है और इसमें डेटा को ऐसे सबसेट्स में विभाजित करना शामिल होता है जिनमें समान मानों वाली प्रविष्टियाँ होती हैं। निर्णय वृक्ष ट्री-संरचना के रूप में मॉडल बनाते हैं। यह डेटासेट को छोटे-छोटे सबसेट्स में तोड़ता है और साथ ही एक संबद्ध निर्णय वृक्ष क्रमशः विकसित होता है। अंतिम परिणाम एक ऐसा वृक्ष होता है जिसमें निर्णय नोड्स और पत्ती नोड्स होते हैं। एक निर्णय नोड (उदा., Outlook) के दो या अधिक ब्रांच (उदा., Sunny, Overcast और Rainy) होते हैं, जिनमें से प्रत्येक परीक्षण किए गए एट्रिब्यूट के मानों का प्रतिनिधित्व करता है। पत्ती नोड (उदा., Hours Played) संख्यात्मक लक्ष्य पर एक निर्णय दर्शाता है। वृक्ष का सबसे ऊपर का निर्णय नोड, जो सर्वश्रेष्ठ प्रेडिक्टर से मेल खाता है, रूट नोड कहलाता है। निर्णय वृक्ष श्रेणीबद्ध और संख्यात्मक दोनों प्रकार के डेटा को संभाल सकते हैं। वे निर्णय वृक्ष जिनमें लक्ष्य वेरिएबल सतत मान (आमतौर पर वास्तविक संख्याएँ) ले सकता है, रिग्रेशन ट्री कहलाते हैं। यदि वृक्ष की अधिकतम गहराई बहुत अधिक सेट की जाती है, तो निर्णय वृक्ष प्रशिक्षण डेटा के बहुत सूक्ष्म विवरण सीख लेते हैं और शोर से भी सीखते हैं, यानी वे ओवरफिट हो जाते हैं।
from sklearn.ensemble import RandomForestRegressor
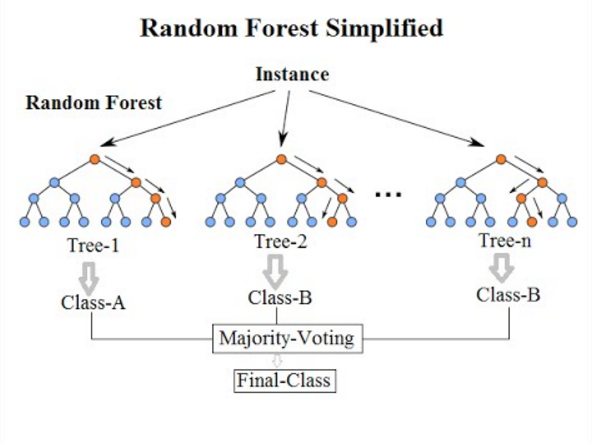
रैंडम फॉरेस्ट एक ऐसा एस्टिमेटर है जो डेटासेट के विभिन्न सब-सैंपल्स पर कई वर्गीकरण निर्णय वृक्ष फिट करता है और औसत लेकर प्रेडिक्टिव सटीकता में सुधार और ओवर-फिटिंग पर नियंत्रण करता है। यदि bootstrap=True हो तो सब-सैंपल का आकार हमेशा मूल इनपुट सैंपल आकार के बराबर होता है लेकिन सैंपल्स रिप्लेसमेंट के साथ चुने जाते हैं। इस तकनीक के पीछे विचार कई वृक्षों को डीकॉरिलेट करना है। यह प्रशिक्षण डेटा से अलग-अलग बूटस्ट्रैप्ड सैंपल्स (यानी स्वयं निर्मित सैंपल्स) पर जेनरेट करता है। फिर हम वृक्षों में वैरिएंस को उनका औसत लेकर कम करते हैं। इसलिए, इस दृष्टिकोण में, यह Python या R में बड़ी संख्या में निर्णय वृक्ष बनाता है। रैंडम फॉरेस्ट मॉडल टैब्युलर डेटा के साथ बहुत अच्छा काम करता है जिसमें संख्यात्मक फीचर्स होते हैं, या ऐसे श्रेणीबद्ध फीचर्स होते हैं जिनमें सैकड़ों से कम श्रेणियाँ हों। रैंडम फॉरेस्ट फीचर्स और टारगेट के बीच गैर-रैखिक अंत:क्रियाओं को पकड़ने की क्षमता रखते हैं।
नोट:—ट्री-आधारित मॉडल बहुत स्पार्स फीचर्स के साथ काम करने के लिए डिज़ाइन नहीं किए गए हैं। स्पार्स इनपुट डेटा से निपटते समय, हम या तो स्पार्स फीचर्स का पूर्व-प्रोसेसिंग कर संख्यात्मक सांख्यिकी निकाल सकते हैं या ऐसे परिदृश्यों के लिए बेहतर उपयुक्त रैखिक मॉडल पर स्विच कर सकते हैं।
from sklearn.ensemble import GradientBoostingRegressor
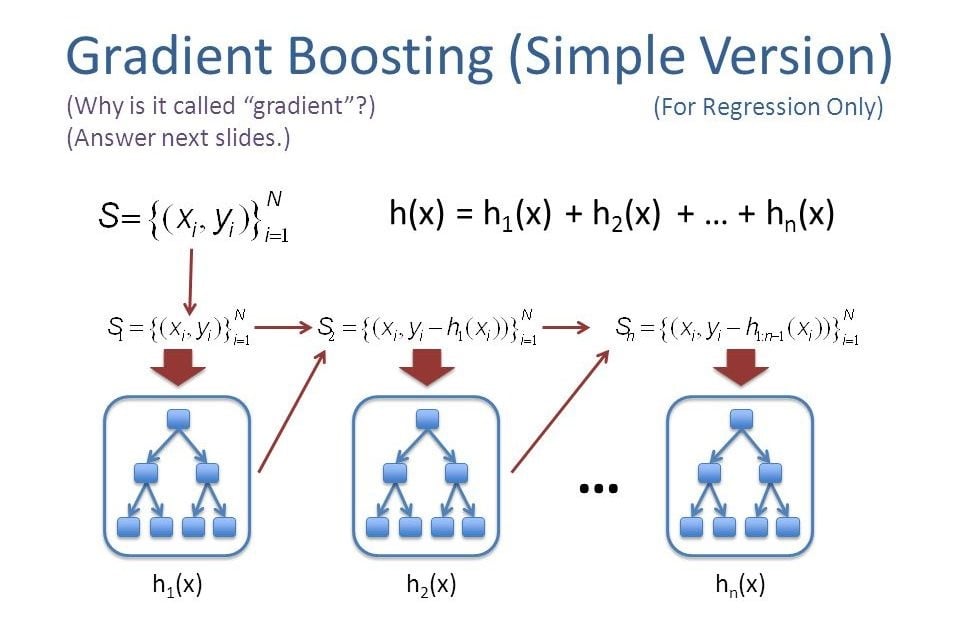
ग्रेडिएंट बूस्टिंग रिग्रेशन और क्लासिफिकेशन समस्याओं के लिए एक मशीन लर्निंग तकनीक है, जो कमजोर प्रेडिक्शन मॉडलों (आमतौर पर निर्णय वृक्ष) के एन्सेंबल के रूप में प्रेडिक्शन मॉडल बनाती है। यह अन्य बूस्टिंग विधियों की तरह चरण-दर-चरण मॉडल बनाती है, और उन्हें किसी भी अवकलनीय लॉस फ़ंक्शन के अनुकूलन की अनुमति देकर सामान्यीकृत करती है। बूस्टिंग को उपयुक्त कॉस्ट फंक्शन पर एक अनुकूलन एल्गोरिद्म के रूप में समझा जा सकता है। बाद के दो पेपर्स ने बूस्टिंग एल्गोरिद्म्स को इटरेटिव फंक्शनल ग्रेडिएंट डिसेंट एल्गोरिद्म्स के रूप में देखने का दृष्टिकोण पेश किया। अर्थात, ऐसे एल्गोरिद्म जो फंक्शन स्पेस में कॉस्ट फंक्शन को ऑप्टिमाइज़ करते हैं, बार-बार एक ऐसे फंक्शन (कमज़ोर हाइपोथेसिस) का चयन करके जो नकारात्मक ग्रेडिएंट दिशा में इंगित करता हो। बूस्टिंग का यह फंक्शनल ग्रेडिएंट दृष्टिकोण रिग्रेशन और क्लासिफिकेशन से आगे मशीन लर्निंग और सांख्यिकी के कई क्षेत्रों में बूस्टिंग एल्गोरिद्म्स के विकास का कारण बना है। ग्रेडिएंट बूस्टिंग कमजोर "learners" को क्रमिक तरीके से एक एकल मजबूत लर्नर में संयोजित करता है। इसे सबसे आसानी से लीस्ट-स्क्वेयर्स रिग्रेशन सेटिंग में समझाया जा सकता है, जहाँ लक्ष्य y ^ = F ( x ) के रूप में मानों की भविष्यवाणी करने के लिए मॉडल F को सिखाना है, और इसके लिए mean squared error को कम करना होता है।
lr = LinearRegression()
dtr = DecisionTreeRegressor()
rfr = RandomForestRegressor()
gbr = GradientBoostingRegressor()
fit1 = lr.fit(X_train,y_train)#यहाँ हमने ट्रेनिंग डेटा को linear regressor पर फिट किया
fit2 = dtr.fit(X_train,y_train)#यहाँ हमने ट्रेनिंग डेटा को Decision Tree Regressor पर फिट किया
fit3 = rfr.fit(X_train,y_train)#यहाँ हमने ट्रेनिंग डेटा को Random Forest Regressor पर फिट किया
fit4 = gbr.fit(X_train,y_train)#यहाँ हमने ट्रेनिंग डेटा को Gradient Boosting Regressor पर फिट किया
fit(): इसका उपयोग ट्रेनिंग डेटा से लर्निंग मॉडल पैरामीटर्स जनरेट करने के लिए किया जाता है।
transform(): fit() मेथड से जनरेट हुए पैरामीटर्स को मॉडल पर लागू कर ट्रांसफॉर्म्ड डेटा सेट बनाया जाता है।
fit_transform(): यह एक ही डेटा सेट पर fit() और transform() API का संयोजन है।
print("Accuracy Score of Linear regression on train set",fit1.score(X_train,y_train)*100)
print("Accuracy Score of Decision Tree on train set",fit2.score(X_train,y_train)*100)
print("Accuracy Score of Random Forests on train set",fit3.score(X_train,y_train)*100)
print("Accuracy Score of Gradient Boosting on train set",fit4.score(X_train,y_train)*100)
Accuracy Score of Linear regression on train set 11.829233894211866
Accuracy Score of Decision Tree on train set 100.0
Accuracy Score of Random Forests on train set 94.207451077798
Accuracy Score of Gradient Boosting on train set 65.49517152859553
print("Accuracy Score of Linear regression on test set",fit1.score(X_test,y_test)*100)
print("Accuracy Score of Decision Tree on test set",fit2.score(X_test,y_test)*100)
print("Accuracy Score of Random Forests on test set",fit3.score(X_test,y_test)*100)
print("Accuracy Score of Gradient Boosting on testset",fit4.score(X_test,y_test)*100)
Accuracy Score of Linear regression on test set 36.8210287243639
Accuracy Score of Decision Tree on test set 57.61911563230391
Accuracy Score of Random Forests on test set 74.71675935214292
Accuracy Score of Gradient Boosting on testset 72.43849411693184
यह ट्यूटोरियल null मानों को कैसे भरें, इस पर एक त्वरित समझ देता है। मैंने इसके बारे में इसलिए लिखा क्योंकि अक्सर वास्तविक डेटा ज्यादा बिखरा हुआ होता है—जहाँ nulls, गलत मान और बहुत सारा स्क्रैप होता है जिसे साफ़ करना पड़ता है। बधाई! आपने यह ट्यूटोरियल पूरा कर लिया। यदि इस ट्यूटोरियल पर आपके कोई प्रश्न या विचार हैं, तो नीचे टिप्पणियों में बेझिझक साझा करें।
यदि आप Python में मशीन लर्निंग के बारे में और सीखना चाहते हैं, तो DataCamp का Introduction to Machine Learning in Python ट्यूटोरियल और Preprocessing for Machine Learning in Python कोर्स देखें।
Python और मशीन लर्निंग के बारे में और जानें
कोर्स
कोर्स
कोर्स