Cours
Prétraitement pour le Machine Learning en Python
4 h
68.4K
Commençons par importer la bibliothèque de base nécessaire pour manipuler le jeu de données.
import pandas as pd
Lisons maintenant le jeu de données et affichons‑le.
bfriday = pd.read_csv("BlackFriday.csv")
bfriday.head(10)
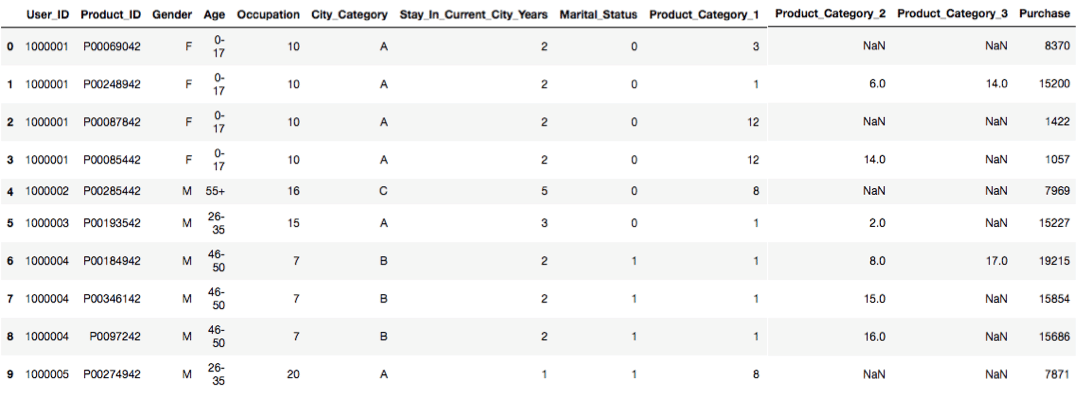
La ligne ci‑dessus renvoie un extrait de 10 lignes avec toutes les colonnes. Si vous essayez d’appeler bfriday.head(x,y), vous obtiendrez une erreur, car le nombre total de colonnes est implicite. bfriday.head() renvoie aussi un résultat sans erreur ; l’ordinateur choisit alors par défaut le nombre de lignes et de colonnes à afficher.
bfriday.shape # renvoie les dimensions du jeu de données (lignes, colonnes)
(550068, 12)
bfriday['Stay_In_Current_City_Years'].value_counts()# compte le nombre de valeurs par intervalle, bfriday['City_Category'].value_counts()
1    193821
2    101838
3     95285
5     84726
0     74398
Name: Stay_In_Current_City_Years, dtype: int64
bfriday.isnull().sum() # calcule le nombre de valeurs nulles pour chaque colonne du jeu de données
User_ID                            0
Product_ID                         0
Gender                             0
Age                                0
Occupation                         0
City_Category                      0
Stay_In_Current_City_Years         0
Marital_Status                     0
Product_Category_1                 0
Product_Category_2            173638
Product_Category_3            383247
Purchase                           0
dtype: int64
b = ['Product_Category_2','Product_Category_3'] # on crée une liste de 2 colonnes : Product_Category_2 et Product_Category_3
for i in b:
    exec("bfriday.%s.fillna(bfriday.%s.value_counts().idxmax(), inplace=True)" %(i,i))
Nous remplissons à présent les valeurs manquantes avec la modalité la plus fréquente. Vous pouvez aussi le faire explicitement : bfriday.Product_Category_2.fillna(bfriday.Product_Category_2.value_counts().idxmax(), inplace=True). Procédez de même pour la colonne Product_Category_3.
X = bfriday.drop(["Purchase"], axis=1)
Nous avons retiré la colonne Purchase du jeu de données et construit un tableau X qui contient toutes les colonnes sauf Purchase.
from sklearn.preprocessing import LabelEncoder # importons l’encodeur depuis sklearn
LE = LabelEncoder()
# Nous allons encoder les variables avec un label encoder pour faciliter le calcul
X = X.apply(LE.fit_transform) # on applique l’encodeur aux données
Nous convertissons maintenant les données en format numérique avec pandas, car il est plus simple de travailler avec des données numériques qu’avec des données catégorielles.
X.Gender = pd.to_numeric(X.Gender)
X.Age = pd.to_numeric(X.Age)
X.Occupation = pd.to_numeric(X.Occupation)
X.City_Category = pd.to_numeric(X.City_Category)
X.Stay_In_Current_City_Years = pd.to_numeric(X.Stay_In_Current_City_Years)
X.Marital_Status = pd.to_numeric(X.Marital_Status)
X.Product_Category_1 = pd.to_numeric(X.Product_Category_1)
X.Product_Category_2 = pd.to_numeric(X.Product_Category_2)
X.Product_Category_3 = pd.to_numeric(X.Product_Category_3)
Y = bfriday["Purchase"] # nous créons Y à partir de la colonne Purchase
from sklearn.preprocessing import StandardScaler
SS = StandardScaler()
Standardisez les variables en retirant la moyenne et en les ramenant à une variance unitaire. Le centrage et l’échelle sont calculés indépendamment pour chaque caractéristique à partir des échantillons de l’ensemble d’entraînement. La moyenne et l’écart type sont ensuite conservés pour transformer de nouvelles données avec la méthode transform.
Xs = SS.fit_transform(X)
# Vous devez transformer X en représentation numérique (pas nécessairement binaire), car tous les algorithmes de machine learning opèrent sur des matrices de nombres
from sklearn.decomposition import PCA
pc = PCA(4) # 4 indique le nombre de composantes souhaité
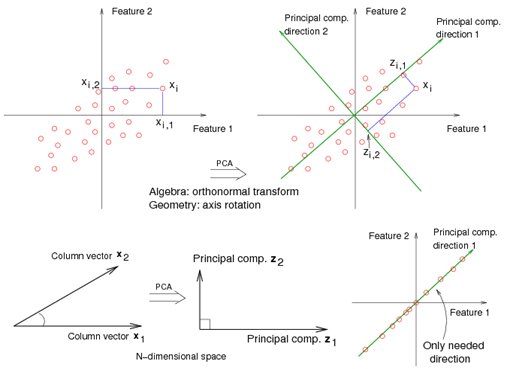
Réduction linéaire de dimension par décomposition en valeurs singulières, projetant les données dans un espace de plus faible dimension. L’ACP est l’une des méthodes de réduction de dimension les plus utilisées pour accélérer les algorithmes de machine learning. Il faut ajuster l’ACP uniquement sur l’ensemble d’entraînement.
L’ACP remplace les variables d’origine par de nouvelles variables appelées composantes principales, non corrélées entre elles et de variance décroissante. La matrice de covariance entre ces composantes est donc diagonale.
Remarque : n’utilisez jamais RandomizedPCA avec des données creuses (sparse). On ne peut pas centrer des données clairsemées sans casser la parcimonie, ce qui ferait exploser l’usage mémoire sur des jeux réalistes. Or le centrage est requis pour l’ACP.
principalComponents = pc.fit_transform(X) # on applique l’ACP aux données
pc.explained_variance_ratio_
array([7.35041374e-01, 2.64935995e-01, 1.10061180e-05, 6.21704987e-06])
principalDf = pd.DataFrame(data = principalComponents, columns = ["component 1", "component 2", "component 3", "component 4"])
from sklearn.model_selection import KFold
kf = KFold(20)
# Fournit des indices d’entraînement/test pour découper les données en ensembles d’entraînement et de test. Divise le jeu en k plis consécutifs (sans mélange par défaut).
# Chaque pli sert une fois de validation tandis que les k − 1 plis restants forment l’entraînement.
for a,b in kf.split(principalDf):
    X_train, X_test = Xs[a],Xs[b]
    y_train, y_test = Y[a],Y[b]
from sklearn.linear_model import LinearRegression
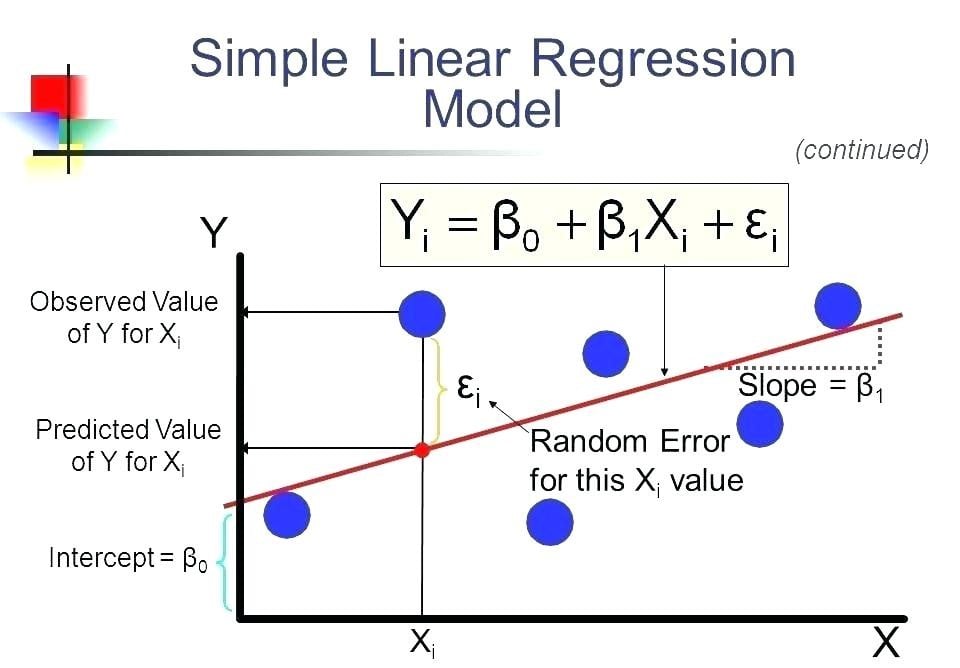
La régression examine deux choses : (1) dans quelle mesure un ensemble de variables explicatives permet de prédire correctement une variable cible ; (2) quelles variables sont des prédicteurs significatifs et comment elles influencent la cible (signe et amplitude des coefficients bêta). Ces estimations servent à expliquer la relation entre une variable dépendante et une ou plusieurs variables indépendantes. La forme la plus simple, avec une variable dépendante et une indépendante, suit la formule y = c + b×x, où y est la valeur estimée, c la constante, b le coefficient de régression et x la valeur de la variable explicative.
from sklearn.tree import DecisionTreeRegressor
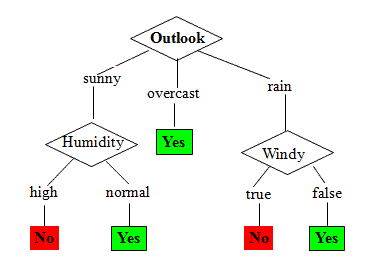
Un arbre de décision est construit de haut en bas à partir d’une racine, en partitionnant les données en sous‑ensembles contenant des instances aux valeurs similaires. Le modèle prend la forme d’un arbre : les données sont découpées en sous‑ensembles de plus en plus fins tandis que l’arbre se construit. Le résultat final est un arbre avec des nœuds de décision et des feuilles. Un nœud de décision (p. ex., Outlook) a plusieurs branches (Ensoleillé, Couvert, Pluvieux), chacune représentant une valeur de l’attribut testé. Une feuille (p. ex., Heures jouées) représente une décision sur la cible numérique. Le nœud racine correspond au meilleur prédicteur. Les arbres gèrent données catégorielles et numériques. Lorsque la cible est continue, on parle d’arbres de régression. Si la profondeur maximale est trop élevée, l’arbre apprend des détails trop fins et le bruit : c’est le surapprentissage.
from sklearn.ensemble import RandomForestRegressor
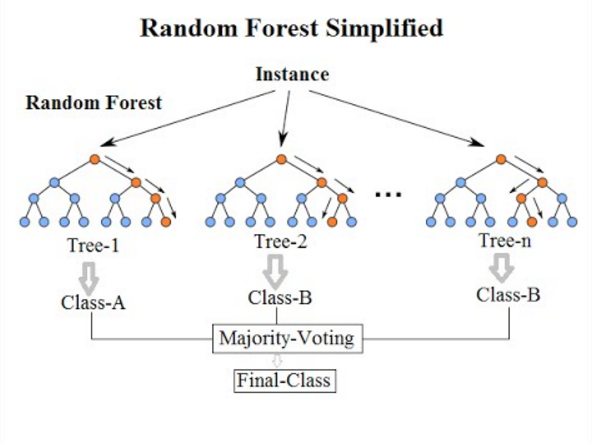
Une forêt aléatoire entraîne un grand nombre d’arbres de décision sur différents sous‑échantillons du jeu de données et moyenne leurs prédictions pour améliorer la précision et limiter le surapprentissage. La taille du sous‑échantillon est identique à celle de l’échantillon d’entrée, avec tirage avec remise si bootstrap=True. L’idée est de décorréler les arbres en les entraînant sur des échantillons bootstrap. On réduit ensuite la variance en moyennant. Les forêts aléatoires excellent sur des données tabulaires avec variables numériques ou catégorielles comportant moins de quelques centaines de catégories, et capturent bien les interactions non linéaires entre variables et cible.
Remarque : les modèles à base d’arbres ne sont pas conçus pour des variables très creuses. Avec des entrées sparse, on peut soit prétraiter pour générer des statistiques numériques, soit basculer vers un modèle linéaire, mieux adapté.
from sklearn.ensemble import GradientBoostingRegressor
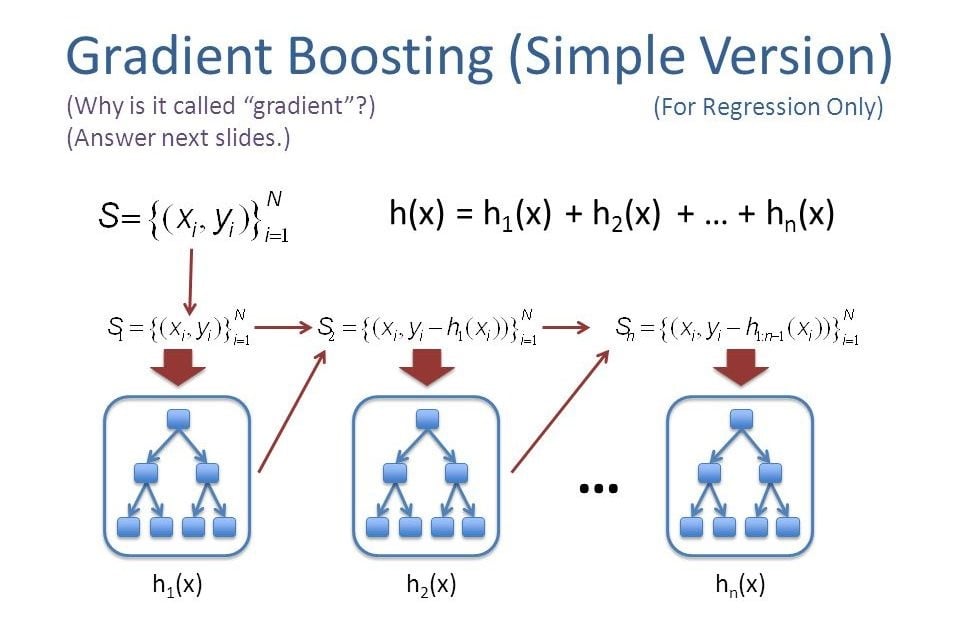
Le gradient boosting est une technique de machine learning pour la régression et la classification qui produit un modèle de prédiction sous forme d’ensemble de modèles faibles, généralement des arbres de décision. Il construit le modèle de manière itérative, comme les autres méthodes de boosting, et généralise en optimisant une fonction de perte différentiable. On peut l’interpréter comme une descente de gradient fonctionnelle : à chaque itération, on choisit une fonction (hypothèse faible) pointant dans la direction du gradient négatif. En régression aux moindres carrés, l’objectif est d’apprendre un modèle F qui prédit y^ = F(x) en minimisant l’erreur quadratique moyenne, en combinant des « apprenants » faibles en un apprenant fort.
lr = LinearRegression()
dtr = DecisionTreeRegressor()
rfr = RandomForestRegressor()
gbr = GradientBoostingRegressor()
fit1 = lr.fit(X_train,y_train) # ajustement du modèle linéaire
fit2 = dtr.fit(X_train,y_train) # ajustement de l’arbre de décision
fit3 = rfr.fit(X_train,y_train) # ajustement de la forêt aléatoire
fit4 = gbr.fit(X_train,y_train) # ajustement du gradient boosting
fit() : calcule les paramètres du modèle à partir des données d’entraînement.
transform() : applique aux données la transformation définie par fit().
fit_transform() : enchaîne fit() puis transform() sur le même jeu de données.
print("Accuracy Score of Linear regression on train set",fit1.score(X_train,y_train)*100)
print("Accuracy Score of Decision Tree on train set",fit2.score(X_train,y_train)*100)
print("Accuracy Score of Random Forests on train set",fit3.score(X_train,y_train)*100)
print("Accuracy Score of Gradient Boosting on train set",fit4.score(X_train,y_train)*100)
Accuracy Score of Linear regression on train set 11.829233894211866
Accuracy Score of Decision Tree on train set 100.0
Accuracy Score of Random Forests on train set 94.207451077798
Accuracy Score of Gradient Boosting on train set 65.49517152859553
print("Accuracy Score of Linear regression on test set",fit1.score(X_test,y_test)*100)
print("Accuracy Score of Decision Tree on test set",fit2.score(X_test,y_test)*100)
print("Accuracy Score of Random Forests on test set",fit3.score(X_test,y_test)*100)
print("Accuracy Score of Gradient Boosting on testset",fit4.score(X_test,y_test)*100)
Accuracy Score of Linear regression on test set 36.8210287243639
Accuracy Score of Decision Tree on test set 57.61911563230391
Accuracy Score of Random Forests on test set 74.71675935214292
Accuracy Score of Gradient Boosting on testset 72.43849411693184
Ce tutoriel vous donne une méthode rapide pour renseigner les valeurs manquantes. Je l’ai écrit car, la plupart du temps, les données réelles sont plus « sales » : nulls, valeurs erronées, éléments parasites à nettoyer. Bravo ! Vous avez terminé ce tutoriel. Si vous avez des questions ou des remarques, écrivez‑les dans les commentaires ci‑dessous.
Pour aller plus loin sur le machine learning en Python, découvrez le tutoriel Introduction to Machine Learning in Python et le cours Preprocessing for Machine Learning in Python de DataCamp.
Approfondissez Python et le machine learning
Cours
Cours
Cours