Curso
Pré-processamento para Machine Learning em Python
4 h
68.4K
Primeiro, vamos importar a biblioteca básica necessária para trabalhar com o conjunto de dados.
import pandas as pd
Agora vamos ler o dataset e visualizá-lo.
bfriday = pd.read_csv("BlackFriday.csv")
bfriday.head(10)
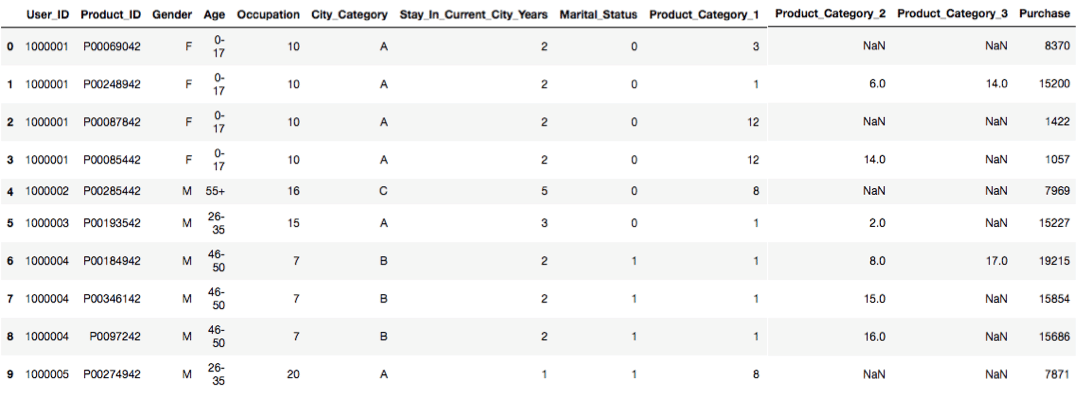
A linha acima mostra uma parte do dataset com 10 linhas e todas as colunas. Se você tentar usar bfriday.head(x,y), vai dar erro porque o método já considera o total de colunas como padrão. bfriday.head() também funciona e não gera erro — o método escolhe automaticamente quantas linhas e colunas mostrar.
bfriday.shape # retorna as dimensões do dataset (linhas, colunas)
(550068, 12)
bfriday['Stay_In_Current_City_Years'].value_counts()# conta a quantidade de valores por faixa, bfriday['City_Category'].value_counts()
1    193821
2    101838
3     95285
5     84726
0     74398
Name: Stay_In_Current_City_Years, dtype: int64
bfriday.isnull().sum() # calcula o número de valores nulos em cada coluna do dataset
User_ID                            0
Product_ID                         0
Gender                             0
Age                                0
Occupation                         0
City_Category                      0
Stay_In_Current_City_Years         0
Marital_Status                     0
Product_Category_1                 0
Product_Category_2            173638
Product_Category_3            383247
Purchase                           0
dtype: int64
b = ['Product_Category_2','Product_Category_3'] # criamos uma lista com as colunas Product_Category_2 e Product_Category_3
for i in b:
    exec("bfriday.%s.fillna(bfriday.%s.value_counts().idxmax(), inplace=True)" %(i,i))
Agora preenchemos os espaços vazios com o valor mais frequente. Você também pode limpar/preencher assim: bfriday.Product_Category_2.fillna(bfriday.Product_Category_2.value_counts().idxmax(), inplace=True). Da mesma forma, dá para limpar a coluna Product_Category_3.
X = bfriday.drop(["Purchase"], axis=1)
Removemos a coluna Purchase do dataset e construímos um array chamado X que contém todas as colunas, exceto Purchase.
from sklearn.preprocessing import LabelEncoder# agora vamos importar o codificador da biblioteca sklearn
LE = LabelEncoder()
# vamos codificar os dados em rótulos com o label encoder para facilitar o processamento
X = X.apply(LE.fit_transform)# aqui aplicamos o encoder aos dados
Agora vamos converter os dados para formato numérico usando pandas, porque trabalhar com dados numéricos é mais fácil do que com dados categóricos.
X.Gender = pd.to_numeric(X.Gender)
X.Age = pd.to_numeric(X.Age)
X.Occupation = pd.to_numeric(X.Occupation)
X.City_Category = pd.to_numeric(X.City_Category)
X.Stay_In_Current_City_Years = pd.to_numeric(X.Stay_In_Current_City_Years)
X.Marital_Status = pd.to_numeric(X.Marital_Status)
X.Product_Category_1 = pd.to_numeric(X.Product_Category_1)
X.Product_Category_2 = pd.to_numeric(X.Product_Category_2)
X.Product_Category_3 = pd.to_numeric(X.Product_Category_3)
Y = bfriday["Purchase"]# criamos um array chamado Y com os dados da coluna Purchase
from sklearn.preprocessing import StandardScaler
SS = StandardScaler()
Padronize as features removendo a média e escalonando para variância unitária. Centralização e escalonamento acontecem de forma independente em cada feature, calculando as estatísticas relevantes nas amostras do conjunto de treino. Média e desvio padrão são então armazenados para serem usados em dados futuros com o método transform.
Xs = SS.fit_transform(X)
# Você precisa transformar X em representação numérica (não necessariamente binária), pois todos os métodos de machine learning operam sobre matrizes numéricas
from sklearn.decomposition import PCA
pc = PCA(4)# aqui 4 indica o número de componentes desejados
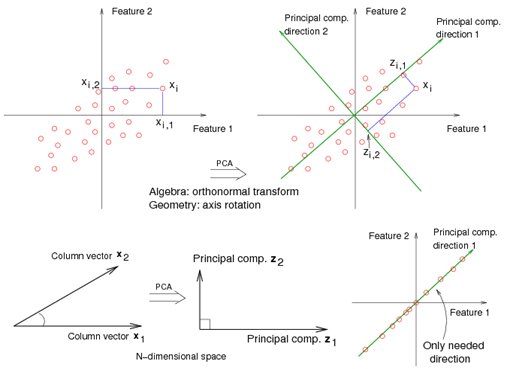
Redução linear de dimensionalidade usando Decomposição em Valores Singulares para projetar os dados em um espaço de menor dimensão. O PCA é um dos métodos de redução de dimensionalidade mais usados e famosos. Para acelerar algoritmos de machine learning, ajuste o PCA apenas no conjunto de treino. Análise de componentes principais (PCA).
O PCA substitui as variáveis originais por novas variáveis, chamadas componentes principais, que não têm covariância entre si e possuem variâncias em ordem decrescente. Ou seja, a matriz de covariância entre os componentes principais extraídos dos dados é diagonal.
Observação: nunca use RandomizedPCA com dados esparsos. O uso de RandomizedPCA em dados esparsos é incorreto, pois não é possível centralizar os dados sem quebrar a esparsidade, o que pode estourar a memória em dados esparsos de tamanho realista. Entretanto, a centralização é necessária para o PCA.
principalComponents = pc.fit_transform(X)# aqui aplicamos o PCA aos dados/ajustamos os dados ao PCA
pc.explained_variance_ratio_
array([7.35041374e-01, 2.64935995e-01, 1.10061180e-05, 6.21704987e-06])
principalDf = pd.DataFrame(data = principalComponents, columns = ["component 1", "component 2", "component 3", "component 4"])
from sklearn.model_selection import KFold
kf = KFold(20)
# Fornece índices de treino/teste para dividir os dados em conjuntos de treino e teste. Divide o dataset em k dobras consecutivas (por padrão, sem embaralhar).
# Cada dobra é usada uma vez como validação enquanto as k - 1 restantes formam o conjunto de treino.
for a,b in kf.split(principalDf):
    X_train, X_test = Xs[a],Xs[b]
    y_train, y_test = Y[a],Y[b]
from sklearn.linear_model import LinearRegression
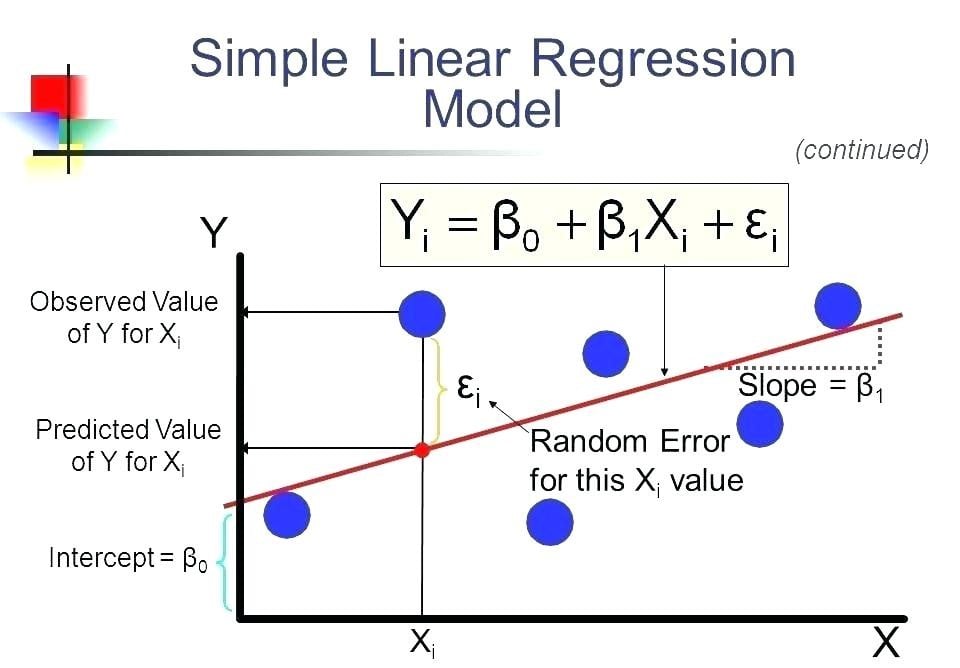
Regressão serve para examinar duas coisas: (1) se um conjunto de variáveis preditoras faz um bom trabalho ao prever uma variável de resultado (dependente); (2) quais variáveis, em particular, são preditores significativos do resultado e de que forma — indicada pela magnitude e pelo sinal dos coeficientes beta — impactam a variável de saída. As estimativas de regressão explicam a relação entre uma variável dependente e uma ou mais variáveis independentes. A forma mais simples da equação de regressão, com uma variável dependente e uma independente, é y = c + b*x, em que y é o valor estimado da variável dependente, c é a constante, b é o coeficiente de regressão e x é o valor da variável independente.
from sklearn.tree import DecisionTreeRegressor
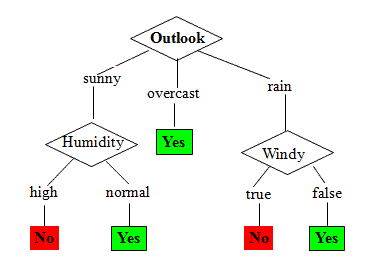
Uma árvore de decisão é construída de cima para baixo a partir de um nó raiz e envolve particionar os dados em subconjuntos que contêm instâncias com valores semelhantes. Árvores de decisão constroem modelos na forma de uma estrutura em árvore. Elas dividem um conjunto de dados em subconjuntos cada vez menores enquanto a árvore correspondente é desenvolvida incrementalmente. O resultado final é uma árvore com nós de decisão e nós folha. Um nó de decisão (por exemplo, Outlook) tem dois ou mais ramos (por exemplo, Sunny, Overcast e Rainy), cada um representando valores para o atributo testado. Um nó folha (por exemplo, Hours Played) representa uma decisão sobre o alvo numérico. O nó de decisão mais alto na árvore, que corresponde ao melhor preditor, é chamado de nó raiz. Árvores de decisão lidam com dados categóricos e numéricos. Árvores em que o alvo pode assumir valores contínuos (tipicamente números reais) são chamadas de árvores de regressão. Se a profundidade máxima da árvore for muito alta, ela aprende detalhes excessivos do conjunto de treino e aprende o ruído, ou seja, superajusta.
from sklearn.ensemble import RandomForestRegressor
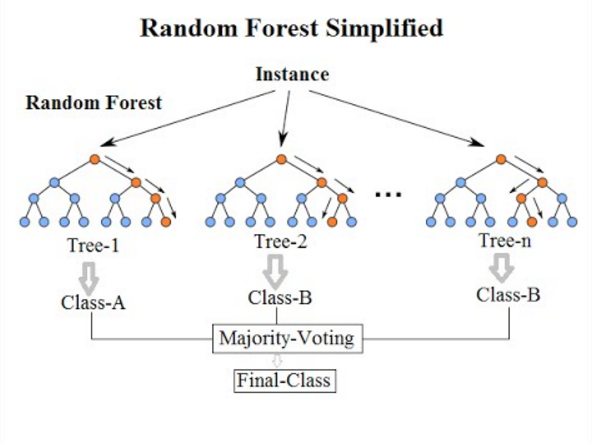
Uma random forest é um estimador que ajusta várias árvores de decisão em diferentes subamostras do dataset e usa a média para melhorar a precisão preditiva e controlar o overfitting. O tamanho da subamostra é sempre o mesmo do tamanho da amostra de entrada original, mas as amostras são retiradas com reposição se bootstrap=True. A ideia é descorrelacionar as várias árvores. Ela gera amostras bootstrap (autoamostras) a partir dos dados de treino. Em seguida, reduzimos a variância nas árvores fazendo a média. Assim, esse método cria um grande número de árvores de decisão em Python ou R. O modelo de random forest é muito bom para lidar com dados tabulares com features numéricas, ou categóricas com menos de centenas de categorias. Random forests têm capacidade de capturar interações não lineares entre as features e o alvo.
Observação: modelos baseados em árvores não foram projetados para funcionar com features muito esparsas. Ao lidar com entrada esparsa, podemos pré-processar as features para gerar estatísticas numéricas ou migrar para um modelo linear, que se encaixa melhor nesse cenário.
from sklearn.ensemble import GradientBoostingRegressor
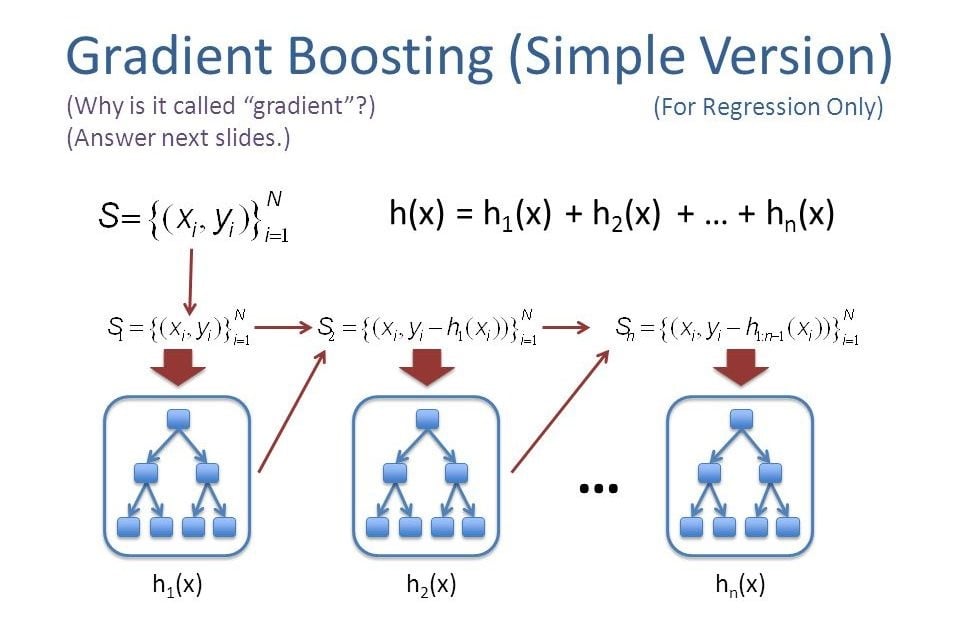
Gradient boosting é uma técnica de machine learning para problemas de regressão e classificação que produz um modelo preditivo na forma de um ensemble de modelos fracos, tipicamente árvores de decisão. Ele constrói o modelo de forma incremental, como outros métodos de boosting, e o generaliza permitindo a otimização de uma função de perda diferenciável arbitrária. O boosting pode ser interpretado como um algoritmo de otimização sobre uma função de custo apropriada. Trabalhos clássicos introduziram a visão de algoritmos de boosting como descida de gradiente funcional iterativa: algoritmos que otimizam uma função de custo no espaço de funções, escolhendo iterativamente uma função (hipótese fraca) que aponta na direção do gradiente negativo. Essa visão levou ao desenvolvimento de algoritmos de boosting em muitas áreas além de regressão e classificação. Em termos práticos, gradient boosting combina "aprendizes" fracos em um único aprendiz forte de forma iterativa. É mais fácil explicar no cenário de regressão de mínimos quadrados, em que o objetivo é "ensinar" um modelo F a prever valores do tipo ŷ = F(x) minimizando o erro quadrático médio.
lr = LinearRegression()
dtr = DecisionTreeRegressor()
rfr = RandomForestRegressor()
gbr = GradientBoostingRegressor()
fit1 = lr.fit(X_train,y_train)# aqui ajustamos os dados de treino ao regresssor linear
fit2 = dtr.fit(X_train,y_train)# aqui ajustamos os dados de treino ao Decision Tree Regressor
fit3 = rfr.fit(X_train,y_train)# aqui ajustamos os dados de treino ao Random Forest Regressor
fit4 = gbr.fit(X_train,y_train)# aqui ajustamos os dados de treino ao Gradient Boosting Regressor
fit(): usado para gerar os parâmetros do modelo a partir dos dados de treino.
transform(): aplica ao modelo os parâmetros gerados por fit() para produzir o conjunto de dados transformado.
fit_transform(): combinação das APIs fit() e transform() no mesmo conjunto de dados.
print("Accuracy Score of Linear regression on train set",fit1.score(X_train,y_train)*100)
print("Accuracy Score of Decision Tree on train set",fit2.score(X_train,y_train)*100)
print("Accuracy Score of Random Forests on train set",fit3.score(X_train,y_train)*100)
print("Accuracy Score of Gradient Boosting on train set",fit4.score(X_train,y_train)*100)
Accuracy Score of Linear regression on train set 11.829233894211866
Accuracy Score of Decision Tree on train set 100.0
Accuracy Score of Random Forests on train set 94.207451077798
Accuracy Score of Gradient Boosting on train set 65.49517152859553
print("Accuracy Score of Linear regression on test set",fit1.score(X_test,y_test)*100)
print("Accuracy Score of Decision Tree on test set",fit2.score(X_test,y_test)*100)
print("Accuracy Score of Random Forests on test set",fit3.score(X_test,y_test)*100)
print("Accuracy Score of Gradient Boosting on testset",fit4.score(X_test,y_test)*100)
Accuracy Score of Linear regression on test set 36.8210287243639
Accuracy Score of Decision Tree on test set 57.61911563230391
Accuracy Score of Random Forests on test set 74.71675935214292
Accuracy Score of Gradient Boosting on testset 72.43849411693184
Este tutorial dá uma visão rápida de como preencher valores nulos. Escrevi sobre isso porque, na prática, dados reais são mais bagunçados: há nulos, valores incorretos e muito “lixo” que precisa ser limpo. Uhul! Você concluiu este tutorial. Se tiver dúvidas ou comentários, fique à vontade para deixar sua mensagem abaixo.
Se você quiser aprender mais sobre machine learning em Python, confira o tutorial Introduction to Machine Learning in Python e o curso Preprocessing for Machine Learning in Python da DataCamp.
Aprenda mais sobre Python e machine learning
Curso
Curso
Curso
blog
Abid Ali Awan
7 min
Tutorial
Moez Ali
14 min
Tutorial
Kevin Babitz
8 min
Tutorial
DataCamp Team
10 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
15 min