Corso
Preprocessing per il Machine Learning in Python
4 ore
68.6K
Per prima cosa importiamo la libreria di base necessaria per lavorare con il dataset.
import pandas as pd
Ora leggiamo il dataset e diamo un’occhiata.
bfriday = pd.read_csv("BlackFriday.csv")
bfriday.head(10)
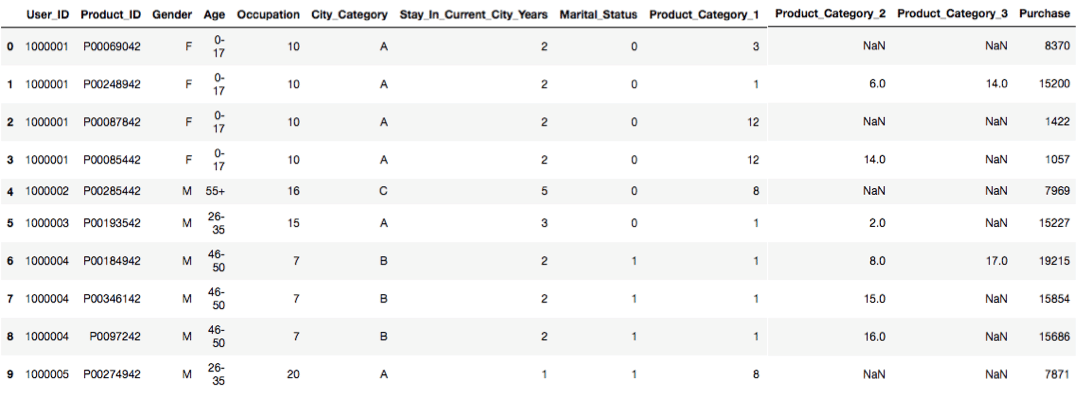
La riga sopra ci mostra una parte del dataset composta da 10 righe e tutte le colonne. Se provassi a usare bfriday.head(x,y) otterresti un errore perché il computer considera obbligatorio il numero totale di colonne. bfriday.head() ti darebbe comunque un output, senza errori, e il computer sceglie autonomamente righe e colonne da mostrare.
bfriday.shape #questo ci dà le dimensioni del dataset (righe, colonne)
(550068, 12)
bfriday['Stay_In_Current_City_Years'].value_counts()# conta il numero di valori per ogni intervallo, bfriday['City_Category'].value_counts()
1    193821
2    101838
3     95285
5     84726
0     74398
Name: Stay_In_Current_City_Years, dtype: int64
bfriday.isnull().sum() #calcola il numero di valori null per ogni categoria nel dataset
User_ID                            0
Product_ID                         0
Gender                             0
Age                                0
Occupation                         0
City_Category                      0
Stay_In_Current_City_Years         0
Marital_Status                     0
Product_Category_1                 0
Product_Category_2            173638
Product_Category_3            383247
Purchase                           0
dtype: int64
b = ['Product_Category_2','Product_Category_3'] #qui creiamo un array composto da 2 colonne: Product_Category_2 e Product_Category_3
for i in b:
    exec("bfriday.%s.fillna(bfriday.%s.value_counts().idxmax(), inplace=True)" %(i,i))
Ora abbiamo riempito gli spazi vuoti con il valore massimo. Possiamo anche pulire o riempire gli spazi vuoti con bfriday.Product_Category_2.fillna(bfriday.Product_Category_2.value_counts().idxmax(),inplace=True); in modo analogo puoi pulire la colonna chiamata Product_category_3
X = bfriday.drop(["Purchase"], axis=1)
Abbiamo ora rimosso la colonna chiamata purchase dal dataset e costruito un array chiamato X che contiene tutte le colonne tranne la colonna purchase.
from sklearn.preprocessing import LabelEncoder#Ora importiamo l'encoder dalla libreria sklearn
LE = LabelEncoder()
#Ora codificheremo i dati in etichette usando un label encoder per facilitare il calcolo
X = X.apply(LE.fit_transform)#Qui applichiamo l'encoder ai dati
Ora convertiremo i dati in forma numerica usando pandas, perché lavorare con dati numerici è più semplice che con dati categorici
X.Gender = pd.to_numeric(X.Gender)
X.Age = pd.to_numeric(X.Age)
X.Occupation = pd.to_numeric(X.Occupation)
X.City_Category = pd.to_numeric(X.City_Category)
X.Stay_In_Current_City_Years = pd.to_numeric(X.Stay_In_Current_City_Years)
X.Marital_Status = pd.to_numeric(X.Marital_Status)
X.Product_Category_1 = pd.to_numeric(X.Product_Category_1)
X.Product_Category_2 = pd.to_numeric(X.Product_Category_2)
X.Product_Category_3 = pd.to_numeric(X.Product_Category_3)
Y = bfriday["Purchase"]#Qui abbiamo creato un array chiamato Y che contiene i dati dalla colonna purchase
from sklearn.preprocessing import StandardScaler
SS = StandardScaler()
Standardizza le feature rimuovendo la media e scalando alla varianza unitaria. Centratura e scalatura avvengono in modo indipendente su ciascuna feature calcolando le statistiche rilevanti sui campioni nel training set. Media e deviazione standard vengono poi memorizzate per essere usate su dati successivi tramite il metodo transform.
Xs = SS.fit_transform(X)
#Devi trasformare X in una rappresentazione numerica (non necessariamente binaria), perché tutti i metodi di machine learning operano su matrici di numeri
from sklearn.decomposition import PCA
pc = PCA(4)#qui 4 indica il numero di componenti desiderate
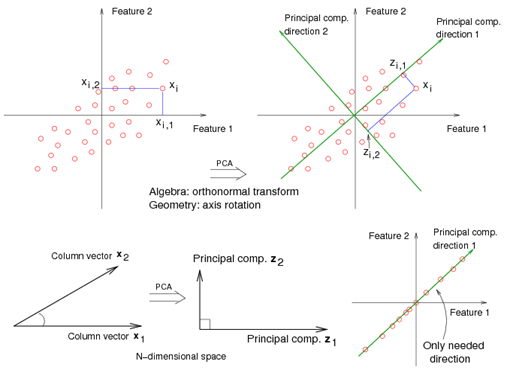
La riduzione lineare della dimensionalità tramite la Decomposizione ai Valori Singolari dei dati serve a proiettarli in uno spazio a dimensione inferiore. La PCA è uno dei metodi di riduzione della dimensionalità più usati e famosi. Per accelerare gli algoritmi di machine learning, si esegue il fitting della PCA solo sul training set. Principal component analysis (PCA)
La PCA sostituisce le variabili originali con nuove variabili, chiamate componenti principali, che hanno covarianza nulla e varianze in ordine decrescente. Quindi, la matrice di covarianza tra le componenti principali è estratta dai dati.
Nota: non usare mai RandomizedPCA per dati sparsi. Usare RandomizedPCA su dati sparsi è scorretto perché non possiamo centrare i dati senza rompere la sparsità, cosa che può saturare la memoria su dati sparsi di dimensioni realistiche. Tuttavia, la centratura è richiesta per la PCA.
principalComponents = pc.fit_transform(X)#Qui applichiamo la PCA ai dati/eseguiamo il fitting dei dati alla PCA
pc.explained_variance_ratio_
array([7.35041374e-01, 2.64935995e-01, 1.10061180e-05, 6.21704987e-06])
principalDf = pd.DataFrame(data = principalComponents, columns = ["component 1", "component 2", "component 3", "component 4"])
from sklearn.model_selection import KFold
kf = KFold(20)
#Fornisce indici di train/test per suddividere i dati in set di train/test. Divide il dataset in k fold consecutivi (senza mescolare per impostazione predefinita).
#Ogni fold viene usato una volta come validazione mentre i k - 1 fold rimanenti costituiscono il training set.
for a,b in kf.split(principalDf):
    X_train, X_test = Xs[a],Xs[b]
    y_train, y_test = Y[a],Y[b]
from sklearn.linear_model import LinearRegression
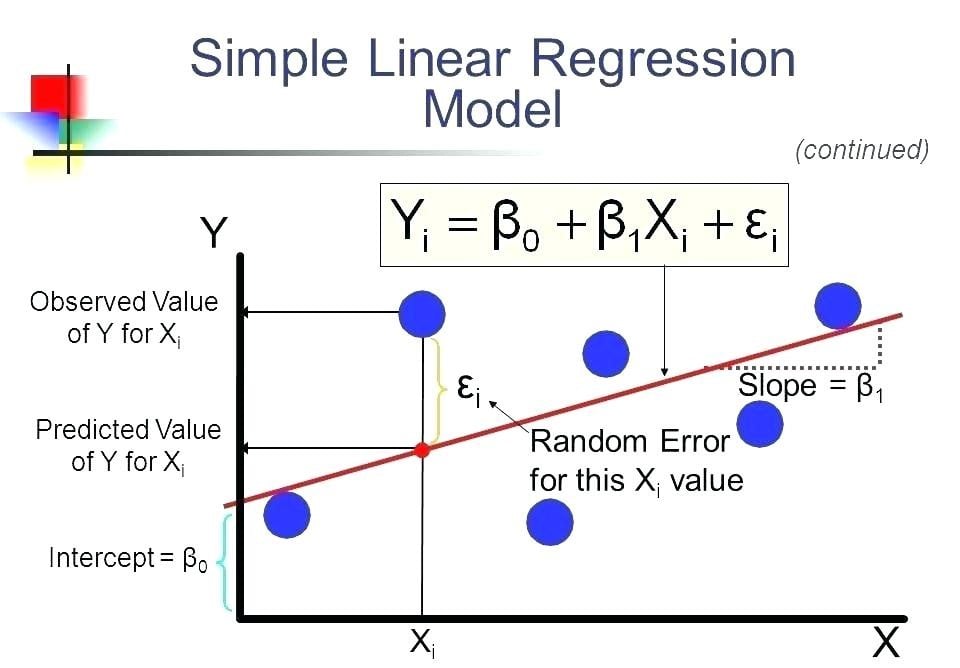
La regressione serve a esaminare due cose: (1) un insieme di variabili predittive riesce a prevedere bene una variabile di outcome (dipendente)? (2) Quali variabili, in particolare, sono predittori significativi della variabile di outcome e in che modo — indicato da magnitudine e segno dei coefficienti beta — influenzano la variabile di outcome? Queste stime di regressione sono usate per spiegare la relazione tra una variabile dipendente e una o più variabili indipendenti. La forma più semplice dell’equazione di regressione con una variabile dipendente e una indipendente è definita dalla formula y = c + b*x, dove y = valore stimato della variabile dipendente, c = costante, b = coefficiente di regressione e x = valore della variabile indipendente.
from sklearn.tree import DecisionTreeRegressor
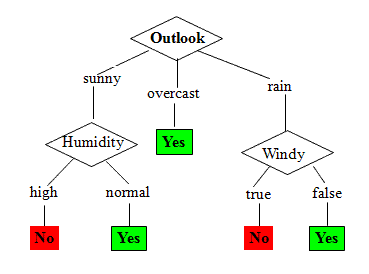
Un albero decisionale è costruito dall’alto verso il basso a partire da una radice e comporta la partizione dei dati in sottoinsiemi che contengono istanze con valori simili. Gli alberi decisionali costruiscono modelli nella forma di una struttura ad albero. Scompongono un dataset in sottoinsiemi sempre più piccoli mentre, allo stesso tempo, si sviluppa incrementamente l’albero associato. Il risultato finale è un albero con nodi decisionali e nodi foglia. Un nodo decisionale (ad es., Outlook) ha due o più rami (ad es., Sunny, Overcast e Rainy), ciascuno rappresentante valori per l’attributo testato. Un nodo foglia (ad es., Hours Played) rappresenta una decisione sul target numerico. Il nodo decisionale più alto in un albero, che corrisponde al miglior predittore, è chiamato nodo radice. Gli alberi decisionali possono gestire sia dati categorici sia numerici. Gli alberi decisionali in cui la variabile target può assumere valori continui (tipicamente numeri reali) sono chiamati alberi di regressione. Se la profondità massima dell’albero è impostata troppo in alto, gli alberi apprendono dettagli troppo fini dei dati di training e imparano dal rumore, cioè vanno in overfitting.
from sklearn.ensemble import RandomForestRegressor
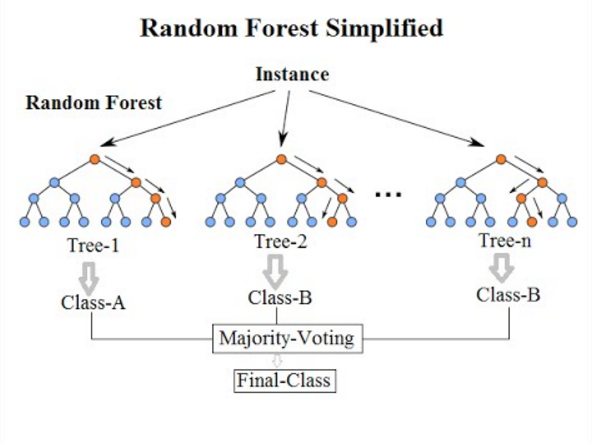
Una random forest è un estimatore che adatta un certo numero di alberi decisionali classificatori su vari sotto-campioni del dataset e usa la media per migliorare l’accuratezza predittiva e controllare l’overfitting. La dimensione del sotto-campione è sempre la stessa della dimensione del campione di input originale ma i campioni sono estratti con reinserimento se bootstrap=True. L’idea dietro questa tecnica è decorrelare i vari alberi. Genera diversi campioni bootstrap (cioè auto-generati) dai dati di training. Poi riduciamo la varianza degli alberi facendone la media. Di conseguenza, in questo approccio si crea un gran numero di alberi decisionali in Python o R. Il modello random forest è molto efficace nel gestire dati tabellari con feature numeriche o feature categoriche con meno di qualche centinaio di categorie. Le random forest sono in grado di catturare l’interazione non lineare tra le feature e il target.
Nota: i modelli basati su alberi non sono progettati per lavorare con feature molto sparse. Quando si lavora con input sparsi, possiamo o preprocessare le feature sparse per generare statistiche numeriche oppure passare a un modello lineare, più adatto a questi scenari.
from sklearn.ensemble import GradientBoostingRegressor
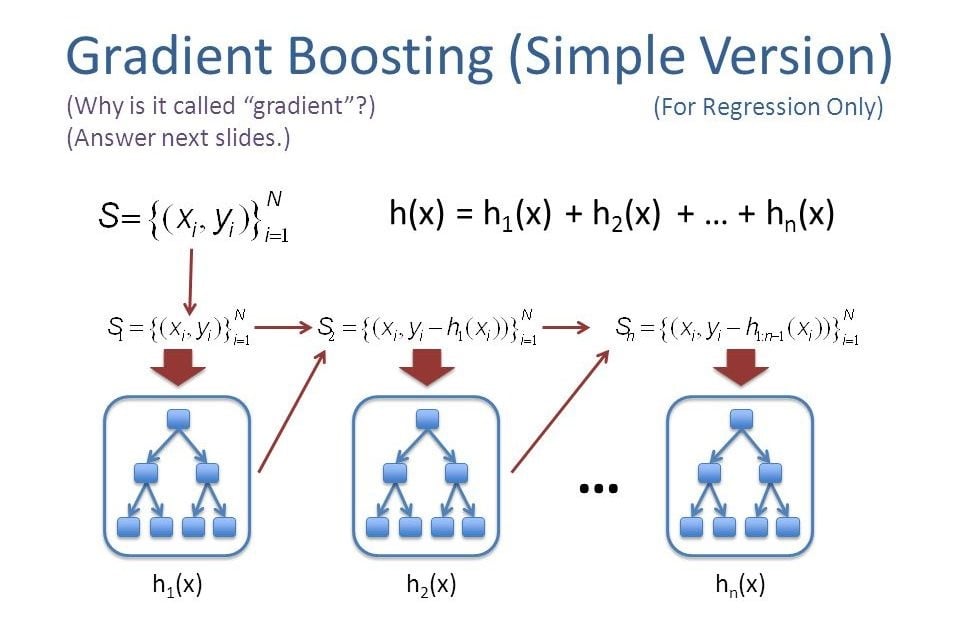
Il gradient boosting è una tecnica di machine learning per problemi di regressione e classificazione che produce un modello predittivo sotto forma di insieme di modelli deboli, tipicamente alberi decisionali. Costruisce il modello in modo incrementale, come fanno altri metodi di boosting, e li generalizza consentendo l’ottimizzazione di una funzione di perdita qualsiasi ma differenziabile. Il boosting può essere interpretato come un algoritmo di ottimizzazione su una funzione di costo adeguata. Gli ultimi due lavori hanno introdotto la visione degli algoritmi di boosting come algoritmi di discesa del gradiente funzionale iterativa. Cioè, algoritmi che ottimizzano una funzione di costo nello spazio delle funzioni scegliendo iterativamente una funzione (ipotesi debole) che punta nella direzione del gradiente negativo. Questa visione funzionale del boosting ha portato allo sviluppo di algoritmi di boosting in molte aree del machine learning e della statistica oltre la regressione e la classificazione. Il gradient boosting combina "learner" deboli in un unico learner forte in modo iterativo. È più facile spiegarlo nel contesto della regressione ai minimi quadrati, dove l’obiettivo è "insegnare" a un modello F a prevedere valori del tipo ŷ = F(x) minimizzando l’errore quadratico medio.
lr = LinearRegression()
dtr = DecisionTreeRegressor()
rfr = RandomForestRegressor()
gbr = GradientBoostingRegressor()
fit1 = lr.fit(X_train,y_train)#Qui adattiamo i dati di training al regressore lineare
fit2 = dtr.fit(X_train,y_train)#Qui adattiamo i dati di training al Decision Tree Regressor
fit3 = rfr.fit(X_train,y_train)#Qui adattiamo i dati di training al Random Forest Regressor
fit4 = gbr.fit(X_train,y_train)#Qui adattiamo i dati di training al Gradient Boosting Regressor
fit(): è usato per generare i parametri del modello a partire dai dati di training
transform(): i parametri generati dal metodo fit() vengono applicati al modello per generare il dataset trasformato.
fit_transform(): è una combinazione delle API fit() e transform() sullo stesso dataset
print("Accuracy Score of Linear regression on train set",fit1.score(X_train,y_train)*100)
print("Accuracy Score of Decision Tree on train set",fit2.score(X_train,y_train)*100)
print("Accuracy Score of Random Forests on train set",fit3.score(X_train,y_train)*100)
print("Accuracy Score of Gradient Boosting on train set",fit4.score(X_train,y_train)*100)
Accuracy Score of Linear regression on train set 11.829233894211866
Accuracy Score of Decision Tree on train set 100.0
Accuracy Score of Random Forests on train set 94.207451077798
Accuracy Score of Gradient Boosting on train set 65.49517152859553
print("Accuracy Score of Linear regression on test set",fit1.score(X_test,y_test)*100)
print("Accuracy Score of Decision Tree on test set",fit2.score(X_test,y_test)*100)
print("Accuracy Score of Random Forests on test set",fit3.score(X_test,y_test)*100)
print("Accuracy Score of Gradient Boosting on testset",fit4.score(X_test,y_test)*100)
Accuracy Score of Linear regression on test set 36.8210287243639
Accuracy Score of Decision Tree on test set 57.61911563230391
Accuracy Score of Random Forests on test set 74.71675935214292
Accuracy Score of Gradient Boosting on testset 72.43849411693184
Questo tutorial offre un’idea rapida su come riempire i valori null. Ne ho parlato perché nella maggior parte dei casi i dati reali sono più disordinati: ci sono null, valori errati e molte scorie da pulire. Evviva! Hai completato questo tutorial. Se hai domande o pensieri sul tutorial, scrivili pure nei commenti qui sotto.
Se vuoi saperne di più sul Machine Learning in Python, dai un’occhiata al tutorial Introduction to Machine Learning in Python di DataCamp e al corso Preprocessing for Machine Learning in Python.
Approfondisci Python e Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



