
Kursus
Memahami Machine Learning
2 jam
310.9K
Proyek machine learning adalah proses iteratif. Anda tidak berhenti pada model yang berhasil di dalam Jupyter notebook. Anda bahkan tidak berhenti setelah model online dan dapat diakses orang. Bahkan setelah deployment, Anda harus terus mengawasinya agar kinerjanya tetap sebaik saat fase pengembangan.
Skandal Zillow adalah contoh sempurna dari apa yang terjadi jika tidak demikian. Pada 2021, Zillow kehilangan 304 juta dolar karena model machine learning mereka yang mengestimasi harga rumah. Zillow membayar terlalu mahal untuk lebih dari 7000 rumah dan terpaksa menjualnya kembali dengan harga jauh lebih rendah. Perusahaan tersebut “dirugikan” oleh modelnya sendiri dan harus mengurangi tenaga kerja sebesar 25%.
Kegagalan model yang sunyi seperti ini umum terjadi pada model di dunia nyata, sehingga model perlu terus diperbarui sebelum kinerja produksinya turun. Gagal melakukannya akan merusak reputasi perusahaan, kepercayaan pemangku kepentingan, dan pada akhirnya, keuangan mereka.
Artikel ini akan mengajarkan Anda cara menerapkan alur kerja end-to-end untuk memantau model machine learning setelah deployment dengan NannyML.
NannyML adalah pustaka open-source yang berkembang dan berfokus pada machine learning pascadeployment. NannyML menawarkan berbagai fitur untuk menyelesaikan semua jenis masalah yang muncul di lingkungan ML produksi. Beberapa di antaranya:
Kita akan mempelajari aspek teknis dari fitur-fitur ini satu per satu.
Kita akan mempelajari konsep dasar pemantauan model melalui analogi robot yang menguasai olahraga panahan.
Dalam analogi ini:
Jadi, mari mulai.
Bayangkan kita telah menyiapkan busur, panah, dan sasaran dengan saksama (seperti persiapan data). Robot kita, yang dilengkapi banyak sensor dan kamera, menembak 10000 kali selama pelatihan. Seiring waktu, ia mulai mengenai titik pusat dengan frekuensi yang mengesankan. Kita senang dengan kinerjanya dan mulai menjual robot kita beserta salinannya kepada para penggemar panahan (mendeploy model).
Namun segera, kita menerima banyak keluhan. Beberapa pengguna melaporkan bahwa robot sama sekali meleset dari sasaran. Terkejut, kita mengumpulkan tim untuk membahas apa yang salah.
Yang kita temukan adalah kasus klasik data drift. Lingkungan tempat robot beroperasi telah berubah—pola angin berbeda, tingkat kelembapan bervariasi, bahkan perubahan karakteristik fisik panah (berat, keseimbangan) dan busur.
Perubahan nyata pada fitur input ini mengacaukan akurasi robot kita, mirip dengan bagaimana model machine learning bisa berkinerja buruk ketika data input, khususnya hubungan antarfitur, berubah seiring waktu.
Setelah mengatasi masalah tersebut, kita merilis batch robot baru. Namun, dalam beberapa minggu, keluhan serupa kembali bermunculan. Bingung, kita menyelidiki lebih dalam dan menemukan bahwa para pengguna sering mengganti sasaran.
Sasaran baru ini bervariasi ukurannya dan ditempatkan pada jarak yang berbeda-beda. Perubahan ini menuntut pendekatan berbeda untuk teknik menembak robot—contoh buku teks dari concept drift.
Dalam istilah machine learning, concept drift terjadi ketika hubungan antara variabel input dan keluaran target berubah. Bagi robot kita, jenis sasaran baru berarti mereka kini harus beradaptasi dengan teknik tembak yang berbeda, sama seperti model machine learning perlu menyesuaikan diri ketika dinamika data yang menjadi bahan pelatihannya berubah secara signifikan.
Untuk memperjelas, mari telusuri beberapa contoh nyata bagaimana data dan concept drift terjadi.
Sekarang, mari pertimbangkan alur kerja pemantauan ML end-to-end.
Pemantauan model melibatkan tiga langkah utama yang harus diikuti insinyur ML secara iteratif.
Langkah pertama tentu saja mengawasi kinerja model saat deployment. Namun ini lebih mudah diucapkan daripada dilakukan.
Ketika ground truth tersedia segera untuk model di produksi, mendeteksi perubahan perilaku model menjadi mudah. Misalnya, para pengguna dapat langsung mengetahui apa yang salah dalam analogi robot/panahan kita karena mereka dapat melihat sasaran dan memberi tahu bahwa robot meleset—ground truth langsung.
Sebaliknya, ambil contoh model yang memprediksi gagal bayar pinjaman. Model seperti ini memprediksi apakah seorang pengguna akan gagal bayar pada pembayaran berikutnya setiap bulan. Untuk memverifikasi prediksinya, model harus menunggu hingga tanggal pembayaran aktual. Ini adalah contoh ground truth tertunda, yang paling umum dalam sistem machine learning dunia nyata.
Dalam kasus seperti itu, menunggu ground truth tersedia untuk melihat apakah model berkinerja baik terlalu mahal. Jadi, insinyur ML memerlukan metode untuk mengestimasi kinerja model tanpa ground truth. Di sinilah algoritme seperti CBPE atau DLE berperan (lebih lanjut nanti).
Pemantauan model juga dapat dilakukan dengan mengukur dampak bisnis langsung, yaitu memantau KPI (key performance indicator). Dalam kasus Zillow, sistem pemantauan yang tepat secara hipotetis dapat mendeteksi kerugian dan memberi peringatan kepada para insinyur.
Jika sistem pemantauan mendeteksi penurunan kinerja, terlepas dari apakah sistem menganalisis kinerja yang terealisasi (dengan ground truth) atau kinerja yang diestimasi (tanpa ground truth), insinyur ML harus mengidentifikasi penyebab di balik penurunan tersebut.
Ini biasanya melibatkan pengecekan fitur secara individu atau gabungan untuk data (feature drift) dan memeriksa target untuk concept drift.
Berdasarkan temuan mereka, berbagai teknik penyelesaian masalah diterapkan.
Berikut adalah daftar teknik non-eksklusif untuk memitigasi kerusakan akibat degradasi kinerja pascadeployment:
Setiap metode memiliki konteks penerapannya, dan sering kali Anda mungkin berakhir menerapkan kombinasinya.
NannyML menangani dua langkah pertama dari proses iteratif ini. Jadi, mari kita mulai.
Selain set pelatihan dan validasi, NannyML memerlukan dua set tambahan yang disebut reference dan analysis dalam format khusus untuk memulai pemantauan. Bagian ini mengajarkan cara membuatnya dari data apa pun.
Pertama, kita memerlukan model yang sudah dilatih dan siap dideploy ke produksi agar dapat dipantau. Untuk tujuan ini, kita akan menggunakan dataset diamonds dan melatih XGBoost regressor.
import warnings

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
import xgboost as xgb
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

warnings.filterwarnings("ignore")
Langkah pertama setelah mengimpor modul adalah memuat dataset Diamonds dari Seaborn. Namun, kita akan menggunakan versi khusus dari dataset yang saya siapkan khusus untuk artikel ini guna menggambarkan seperti apa pemantauan. Anda dapat memuat dataset ke lingkungan Anda menggunakan cuplikan di bawah ini:
dataset_link = "https://raw.githubusercontent.com/BexTuychiev/medium_stories/master/2024/1_january/4_intro_to_nannyml/diamonds_special.csv"

diamonds_special = pd.read_csv(dataset_link)
diamonds_special.head()
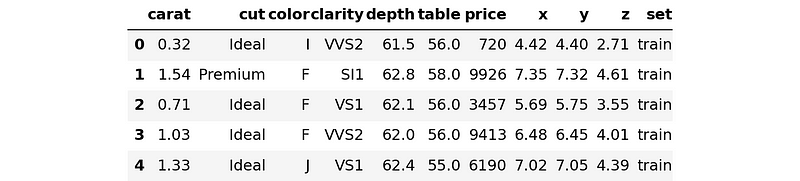
Versi khusus dataset ini memiliki kolom bernama “set”, yang akan kita bahas sebentar lagi.
Untuk saat ini, kita akan mengekstrak semua nama fitur, nama fitur kategorikal, dan nama target:
# Extract all feature names
all_feature_names = diamonds_special.drop(["price", "set"], axis=1).columns.tolist()

# Extract the columns and cast into category
cats = diamonds_special.select_dtypes(exclude=np.number).columns

# Define the target column
target = "price"
Tugas ini adalah regresi—kita akan memprediksi harga berlian berdasarkan atribut fisiknya.
Dataset diamonds cukup bersih. Jadi, satu-satunya prapemrosesan yang kita lakukan adalah mengubah fitur teks menjadi tipe data category Pandas. Ini adalah prasyarat untuk mengaktifkan prapemrosesan data kategorikal otomatis oleh XGBoost.
for col in cats:
   diamonds_special[col] = diamonds_special[col].astype("category")
Mari lanjut ke pemisahan data.
Ya, Anda tidak salah baca. Kita akan membagi data menjadi empat set. Secara tradisional, Anda mungkin hanya membaginya menjadi tiga:
Alur kerja pemantauan model memerlukan satu set lagi untuk meniru data produksi. Ini untuk memastikan sistem kita mendeteksi penurunan kinerja dengan benar menggunakan algoritme yang tepat dan melaporkan apa yang salah.
Untuk tujuan ini, saya telah memberi label baris-baris Diamonds Special dengan empat kategori pada kolom set:
diamonds_special.set.unique()
['train', 'val', 'test', 'prod']
Categories (4, object): ['prod', 'test', 'train', 'val']
Training set mewakili 70%, sementara sisanya masing-masing 10% dari total data. Mari kita bagi:
tr = diamonds_special[diamonds_special.set == "train"].drop("set", axis=1)
val = diamonds_special[diamonds_special.set == "validation"].drop("set", axis=1)
test = diamonds_special[diamonds_special.set == "test"].drop("set", axis=1)
prod = diamonds_special[diamonds_special.set == "prod"].drop("set", axis=1)

tr.shape
(37758, 10)
Namun, dataset dunia nyata tidak hadir dengan label set bawaan, sehingga Anda harus membagi data secara manual menjadi empat set sendiri. Berikut fungsi yang melakukan tugas tersebut menggunakan train_test_split dari sklearn:
def split_into_four(df, train_size=0.7):
   """
   A function to split a dataset into four sets:
   - Training
   - Validation
   - Testing
   - Production
   train_size is set by the user.
   The remaining data will be equally divided between the three sets.
   """
   # Do the splits
   training, the_rest = train_test_split(df, train_size=train_size)
   validation, the_rest = train_test_split(the_rest, train_size=1 / 3)
   testing, production = train_test_split(the_rest, train_size=0.5)

   # Reset the indices
   sets = (training, validation, testing, production)
   for set in sets:
       set.reset_index(inplace=True, drop=True)

   return sets


tr, val, test, prod = split_into_four(your_dataset)
Catatan: Gunakan tombol “Explain code” untuk mendapatkan penjelasan baris demi baris dari fungsi tersebut.
Sekarang, mari lanjut ke pelatihan model.
Sebelum melatih model XGBoost, kita perlu mengonversi dataset menjadi DMatrix. Berikut kodenya:
dtrain = xgb.DMatrix(tr[all_feature_names], label=tr[target], enable_categorical=True)
dval = xgb.DMatrix(val[all_feature_names], label=val[target], enable_categorical=True)

dtest = xgb.DMatrix(
   test[all_feature_names], label=test[target], enable_categorical=True
)
dprod = xgb.DMatrix(
   prod[all_feature_names], label=prod[target], enable_categorical=True
)
Sekarang, berikut kode untuk melatih sebuah regressor dengan hyperparameter yang sudah dituning:
# Define optimized parameters
params = {
   "n_estimators": 10000,
   "learning_rate": 0.1,
   "tree_method": "gpu_hist",
   "max_depth": 6,
   "min_child_weight": 1,
   "gamma": 0,
   "subsample": 0.8,
   "colsample_bytree": 0.8,
   "objective": "reg:squarederror",
   "reg_alpha": 0.01,
   "reg_lambda": 1,
}

# Training with early stopping
regressor = xgb.train(
   params,
   dtrain,
   num_boost_round=10000,
   evals=[(dtrain, "train"), (dval, "eval")],
   early_stopping_rounds=50,
   verbose_eval=500,
)
[0]	train-rmse:3638.77217	eval-rmse:0.00000
[49]	train-rmse:502.61376	eval-rmse:0.00000
Bagus—kita memiliki model yang mencapai RMSE sebesar 503$ pada set validasi. Mari evaluasi model sekali lagi pada set pengujian:
from sklearn.metrics import mean_squared_error

# Predict on the test set
y_test_pred = regressor.predict(dtest)

# Evaluate
mean_squared_error(test[target], y_test_pred, squared=False)
551.2763827068798
Kinerja pengujian adalah 551$. Itu sudah cukup baik.
Sampai titik ini, semuanya cukup lurus. Sekarang, kita sampai pada bagian utama—membuat set reference dan analysis.
Reference set adalah nama lain dari test set yang digunakan dalam konteks pemantauan model. NannyML menggunakan kinerja model pada test set sebagai tolok ukur untuk kinerja produksi. Reference set harus memiliki dua kolom selain fitur-fitur:
y_test_predSaat ini, set pengujian kita berisi fitur dan target tetapi tidak memiliki y_test_pred:
test.columns  # Ignore the `set` column
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z'],
     dtype='object')
Mari kita tambahkan:
test["y_pred"] = y_test_predSekarang, kita akan mengganti nama test set menjadi reference:
reference = test.copy(deep=True)

reference.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Pada titik ini, mari bayangkan bahwa regressor kita dideploy ke cloud. Membayangkan lebih sederhana daripada benar-benar mendeploy model, yang berlebihan untuk artikel ini.
Setelah kita mendeploy model penetapan harga berlian, kita menerima kabar bahwa akan datang kiriman berlian dalam jumlah besar. Sebelum kargo tiba, pengukuran fisik berlian telah dikirimkan kepada kita sebagai prod (kita masih berimajinasi) sehingga kita dapat menghasilkan harga untuknya dan mulai memasarkannya di situs web. Jadi, mari kita hasilkan.
# Generate prices for production data
y_prod_pred = regressor.predict(dprod)
Sebelum berlian sebenarnya tiba dan spesialis manusia memverifikasi harga yang dihasilkan model kita, kita harus memeriksa apakah model kita berkinerja baik. Kita tidak ingin menampilkan berlian dengan harga yang tidak akurat di situs web.
Untuk melakukan ini, kita perlu mengukur kinerja model dengan membandingkan y_prod_pred dengan harga sebenarnya dari berlian baru, yaitu ground truth. Namun kita tidak akan memiliki ground truth sebelum harga diverifikasi. Jadi, kita perlu mengestimasi kinerja model tanpa ground truth.
Untuk tugas ini, NannyML memerlukan analysis set—data yang berisi data produksi dengan prediksi yang dibuat oleh model.
Membuat analysis set mirip dengan membuat reference:
# Add the predictions of new diamonds to prod
prod["y_pred"] = y_prod_pred

analysis = prod.copy(deep=True)
analysis.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Sekarang, kita siap mengestimasi kinerja regressor.
NannyML menyediakan dua algoritme utama untuk mengestimasi kinerja model regresi dan klasifikasi:
Kita akan menggunakan algoritme DLE untuk tugas kita. DLE dapat mengukur kinerja model produksi tanpa ground truth dan melaporkan berbagai pseudo-metrik regresi seperti RMSE, RMSLE, MAE, dll.
Untuk menggunakan DLE, pertama kita perlu menyesuaikannya pada reference untuk menetapkan tolok ukur kinerja.
import nannyml  # pip install nannyml

estimator = nannyml.DLE(
   feature_column_names=all_feature_names,
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)
Inisialisasi DLE memerlukan tiga parameter—nama fitur input, nama kolom yang memuat ground truth untuk pengujian, dan nama kolom yang memuat prediksi pengujian.
Selain itu, kita juga meneruskan RMSE sebagai metrik dan ukuran chunk 250. Mari sesuaikan estimator ke reference dan estimasi kinerja pada analysis:
# Fit to the reference set
estimator.fit(reference)

# Estimate on the analysis set
estimated_results = estimator.estimate(analysis)
estimated_results
<nannyml.performance_estimation.direct_loss_estimation.result.Result at 0x7f3954af1c90>
Kita memiliki objek Result dari NannyML yang dapat dipetakan. Mari lihat hasilnya:
estimated_results.plot().show()
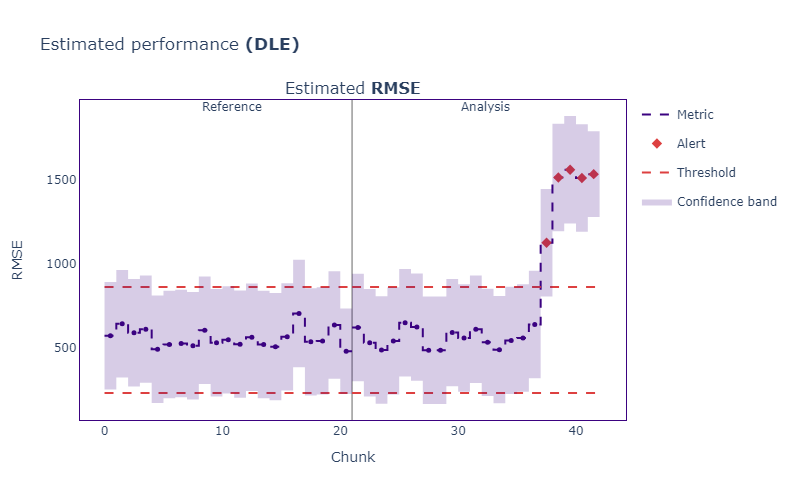
Mari interpretasikan plotnya—plot memiliki dua bagian yang menampilkan kinerja pada reference dan analysis set. Jika RMSE produksi yang diestimasi naik melampaui ambang, NannyML menandainya sebagai peringatan.
Seperti yang kita lihat, ada beberapa peringatan untuk data produksi, menunjukkan ada sesuatu yang tidak beres pada batch terakhir.
Sistem pemantauan kita memberi tahu bahwa kinerja model turun sekitar setengahnya di produksi. Namun itu hanya estimasi—kita tidak bisa memastikan.
Saat kita memvisualisasikan kinerja yang diestimasi, kiriman telah tiba, dan spesialis berlian kita menghitung harga aktualnya. Kita telah menyimpannya sebagai price ke dalam prod.
Sekarang, kita dapat membandingkan kinerja yang terealisasi (kinerja aktual) model dengan kinerja yang diestimasi untuk melihat apakah sistem pemantauan kita bekerja dengan baik.
NannyML menyediakan kelas PerformanceCalculator untuk melakukannya:
calculator = nannyml.PerformanceCalculator(
   problem_type="regression",
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)

calculator.fit(reference)
realized_results = calculator.calculate(analysis)
Kelas ini memerlukan empat parameter:
problem_type: Apa tugasnya?y_true: Apa labelnya?y_pred: Di mana saya dapat menemukan prediksi?metrics: Metrik mana yang digunakan untuk menghitung kinerja?Setelah meneruskan parameter-parameter tersebut dan menyesuaikan kalkulator ke reference, kita melakukan calculate pada analysis set.
Untuk membandingkan realized_results dengan estimated_results, kita kembali menggunakan visual:
estimated_results.compare(realized_results).plot().show()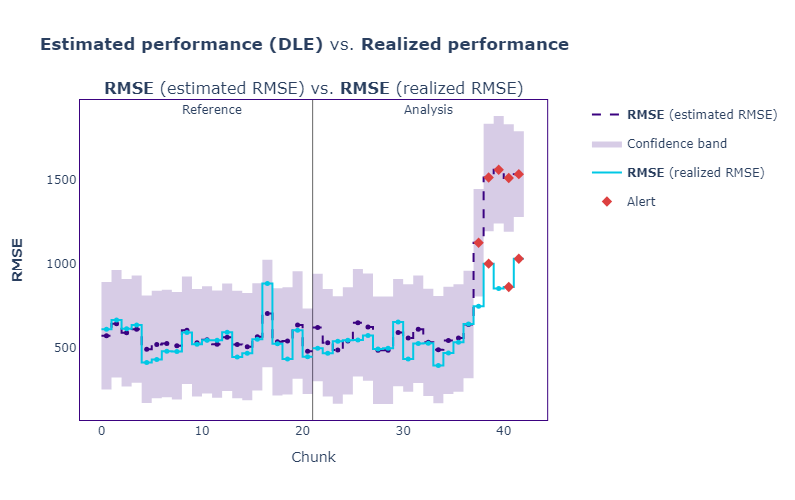
Ternyata RMSE yang diestimasi (ungu) cukup dekat dengan kinerja aktual (RMSE yang terealisasi, biru).
Ini memberi tahu satu hal—sistem pemantauan kita bekerja dengan baik, tetapi model kita tidak, sebagaimana ditunjukkan oleh loss yang meningkat. Jadi, apa penyebabnya?
Kita akan menyelaminya sekarang.
Seperti disebutkan di awal, salah satu alasan paling umum mengapa model gagal di produksi adalah drift. Pada bagian ini, kita akan fokus pada deteksi data (feature) drift.
Deteksi drift adalah bagian dari langkah analisis akar penyebab dalam alur kerja pemantauan model. Biasanya dimulai dengan deteksi drift multivariat.
Salah satu metode deteksi drift multivariat terbaik adalah menghitung kesalahan rekonstruksi data menggunakan PCA. Metode ini bekerja sangat baik dan dapat menangkap bahkan drift kecil pada distribusi fitur. Berikut gambaran tingkat tinggi metode ini:
1. PCA disesuaikan pada reference dan mengompresnya ke dimensi yang lebih rendah - reference_lower.
2. reference_lower kemudian didekompresi kembali ke dimensi aslinya - reference_reconstructed.
reference.3. Perbedaan antara reference dan reference_reconstructed ditemukan dan dinamai sebagai kesalahan rekonstruksi data - reconstruct_error.
reconstruct_error berfungsi sebagai tolok ukur untuk membandingkan kesalahan rekonstruksi data produksi4. Metode reduksi/rekonstruksi yang sama diterapkan pada batch data produksi.
Keempat langkah ini diimplementasikan sebagai kelas DataReconstructionDriftCalculator di NannyML. Berikut cara menggunakannya:
# Initialize
multivariate_calc = nannyml.DataReconstructionDriftCalculator(
   column_names=all_feature_names,
   chunk_size=250,
)

# Fit
multivariate_calc.fit(reference)
# Calculate error
multivariate_results = multivariate_calc.calculate(analysis)
Setelah kita memiliki kesalahan untuk setiap chunk data (masing-masing 250 baris), kita dapat memvisualisasikannya:
multivariate_results.plot().show()
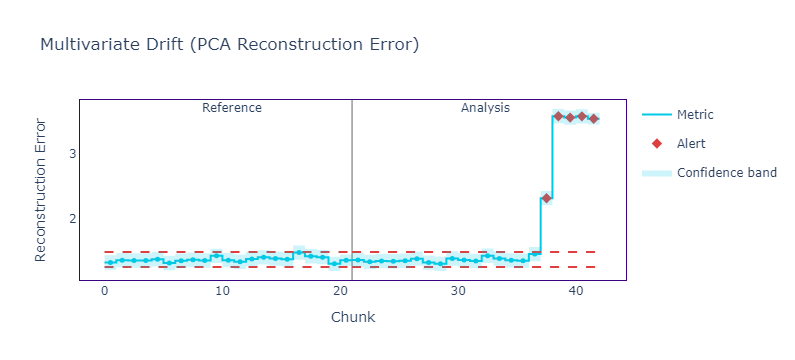
Seperti yang kita lihat, kesalahan rekonstruksi sangat tinggi, mengindikasikan adanya drift pada fitur. Kita dapat membandingkan kesalahan tersebut dengan kinerja yang terealisasi juga:
multivariate_results.compare(realized_results).plot().show(config={"staticPlot": True})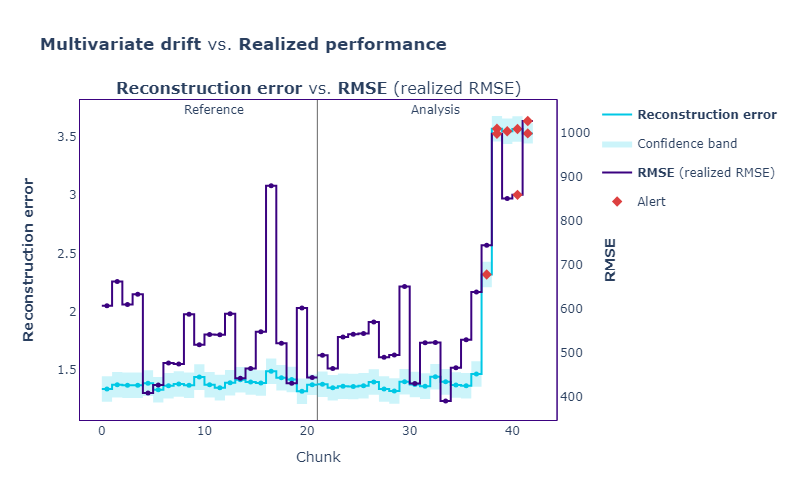
Seperti yang kita lihat, semua lonjakan loss berkorespondensi dengan peringatan pada kesalahan rekonstruksi.
Kesalahan rekonstruksi data adalah satu angka untuk mengukur drift seluruh fitur. Namun bagaimana dengan drift fitur individual? Jika dataset kita berisi ratusan fitur, bagaimana cara menemukan fitur yang paling mengalami drift dan mengambil tindakan yang sesuai?
Di situlah kita menggunakan metode deteksi drift univariat. NannyML menawarkan beberapa metode tergantung tipe fitur:
Semua metode ini membandingkan distribusi fitur individual pada reference dengan yang ada pada set analysis. Kita dapat menggunakan beberapa (atau bahkan semua) dalam kelas UnivariateDriftCalculator:
univariate_calc = nannyml.UnivariateDriftCalculator(
   column_names=all_feature_names,
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   chunk_size=250,
)

univariate_calc.fit(reference)
univariate_results = univariate_calc.calculate(analysis)
Satu-satunya parameter wajib adalah column_names, sisanya dapat menggunakan nilai default yang ditetapkan NannyML. Namun, untuk menjaga kesederhanaan, kita menggunakan wasserstein dan jensen_shannon untuk fitur kontinu dan kategorikal.
Saat ini, kita memiliki 11 fitur, jadi memanggil plot().show() mungkin tidak menghasilkan hasil paling optimal. Sebagai gantinya, kita dapat menggunakan alert count ranker untuk mengembalikan fitur-fitur yang menghasilkan jumlah peringatan terbanyak (ketika semua chunk dipertimbangkan). Berikut kodenya:
# Initialize the ranker
alert_count_ranker = nannyml.AlertCountRanker()

# Filter the univariate results for only columns containing the metrics
filtered_univariate = univariate_results.filter(
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   only_drifting=False,
)

# Rank the alerts
ranker_results = alert_count_ranker.rank(filtered_univariate)
Setelah kita memiliki hasil ranker, kita dapat mencetak head-nya karena hasil tersebut berupa DataFrame Pandas:
ranker_results.head(10)
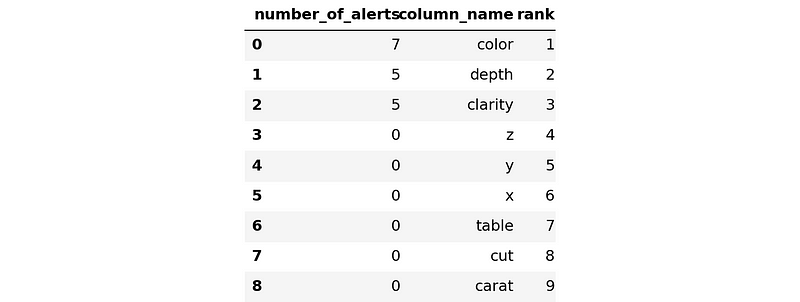
Kita dapat melihat bahwa fitur yang paling bermasalah adalah color dan depth. Ini tidak mengherankan bagi saya karena sayalah yang secara artifisial menyebabkan fitur-fitur itu mengalami drift sebelum menulis artikel ini.
Namun jika ini adalah skenario dunia nyata, Anda akan ingin meluangkan waktu untuk menyelesaikan masalah pada fitur-fitur tersebut.
Saya merasa pemantauan model itu menarik karena menghancurkan ilusi bahwa machine learning selesai begitu Anda memiliki model yang bagus. Seiring berputarnya bumi dan berubahnya pola pengguna, tidak ada model yang tetap relevan dalam waktu lama. Hal ini menjadikan pemantauan model sebagai bagian krusial dari keahlian setiap insinyur ML.
Hari ini, kita telah membahas alur kerja pemantauan model dasar. Kita mulai dengan membahas konsep pemantauan fundamental. Lalu, kita langsung terjun ke kode: kita membentuk data ke format yang kompatibel dengan NannyML; membuat plot pertama untuk kinerja model yang diestimasi, membuat plot lain untuk membandingkannya dengan kinerja yang terealisasi; menerima beberapa peringatan bahwa kinerja menurun; memeriksanya dengan deteksi drift multivariat; menemukan drift fitur yang berat; memeriksanya lagi dengan deteksi drift fitur individual; mengidentifikasi fitur yang mengalami drift.
Sayangnya, kita berhenti tepat pada penyelesaian masalah. Langkah terakhir dari alur kerja pemantauan berada di luar cakupan artikel ini. Namun, saya memiliki beberapa rekomendasi luar biasa yang membahas hal tersebut dan lebih banyak lagi tentang pemantauan model:
Kedua kursus ini dibuat oleh orang terbaik yang bisa Anda harapkan—CEO dan pendiri NannyML. Di dalam kursus, ada banyak wawasan penting yang sayang untuk dilewatkan.
Saya juga merekomendasikan membaca dokumen NannyML untuk beberapa tutorial praktis.
Mulai Perjalanan Machine Learning Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt




