
Curso
Entendendo Machine Learning
2 h
308.6K
Projetos de machine learning são processos iterativos. Você não para quando consegue um modelo bom dentro de um Jupyter Notebook. Nem quando o modelo entra no ar e as pessoas podem acessá-lo. Mesmo após o deploy, é preciso acompanhar de perto para garantir que ele continue funcionando tão bem quanto na fase de desenvolvimento.
O caso da Zillow é um exemplo perfeito do que acontece quando isso não é feito. Em 2021, a Zillow perdeu impressionantes 304 milhões de dólares por causa do modelo de machine learning que estimava preços de casas. A empresa pagou caro demais por mais de 7.000 imóveis e teve que revendê-los por um valor muito menor. A companhia foi “passada para trás” pelo próprio modelo e precisou reduzir o quadro em 25%.
Falhas silenciosas como essa são comuns em modelos no mundo real, por isso eles precisam ser atualizados constantemente antes que o desempenho em produção caia. Ignorar isso prejudica a reputação da empresa, a confiança das partes interessadas e, no fim, o resultado financeiro.
Neste artigo, você vai aprender a implementar um workflow de ponta a ponta para monitorar modelos de machine learning após o deploy com o NannyML.
NannyML é uma biblioteca open source em crescimento, focada no pós-deploy de machine learning. Ela oferece uma ampla gama de recursos para resolver diversos problemas que surgem em ambientes de ML em produção. Alguns exemplos:
Vamos conhecer, passo a passo, os detalhes técnicos desses recursos.
Vamos aprender os fundamentos do monitoramento de modelos usando a analogia de um robô dominando o tiro com arco.
Na nossa analogia:
Então, vamos lá.
Imagine que preparamos cuidadosamente o arco, as flechas e o alvo (como na preparação de dados). Nosso robô, equipado com sensores e câmeras, dispara 10.000 vezes durante o treino. Com o tempo, ele começa a acertar o centro com frequência impressionante. Animados com a performance, começamos a vender o robô e suas cópias para amantes do arco e flecha (deploy do modelo).
Logo começam as reclamações. Alguns usuários dizem que o robô está errando o alvo completamente. Surpresos, reunimos um time para entender o que deu errado.
O que encontramos é um caso clássico de data drift. O ambiente onde os robôs estão operando mudou — padrões de vento diferentes, níveis de umidade variando e até mudanças nas características físicas das flechas (peso, balanceamento) e do arco.
Essa mudança real nas features de entrada derrubou a precisão do nosso robô, assim como um modelo de machine learning pode ter queda de desempenho quando os dados de entrada — especialmente as relações entre as features — mudam com o tempo.
Depois de corrigir esses problemas, lançamos um novo lote de robôs. Ainda assim, algumas semanas depois, surgem reclamações parecidas. Intrigados, investigamos mais a fundo e descobrimos que os alvos foram trocados com frequência pelos usuários.
Esses novos alvos variam em tamanho e estão posicionados a diferentes distâncias. Essa mudança exige uma técnica de tiro diferente do robô — um exemplo clássico de concept drift.
Em termos de machine learning, concept drift acontece quando a relação entre as variáveis de entrada e o resultado-alvo muda. Para nossos robôs, os novos tipos de alvo significam que eles precisam se adaptar e atirar de outra forma, assim como um modelo de ML precisa se ajustar quando a dinâmica dos dados de treino muda significativamente.
Para reforçar, vamos ver alguns exemplos reais de como ocorrem data e concept drift.
Agora, vamos considerar um workflow de monitoramento de ML de ponta a ponta.
Monitorar modelos envolve três etapas principais que os engenheiros de ML devem seguir de forma iterativa.
O primeiro passo é, claro, acompanhar de perto o desempenho do modelo em produção. Mas isso é mais fácil falar do que fazer.
Quando o ground truth está disponível imediatamente para um modelo em produção, é fácil detectar mudanças de comportamento. Por exemplo, no nosso cenário do robô/tiro com arco, os usuários conseguem ver o alvo e dizer que o robô errou — ground truth imediato.
Já em um modelo que prevê inadimplência de empréstimos, as previsões são mensais (vai atrasar o próximo pagamento ou não). Para verificar a previsão, é preciso esperar a data real do pagamento. Esse é um caso de ground truth atrasado, muito comum em sistemas de ML no mundo real.
Nesses casos, esperar pelo ground truth para checar a performance pode sair caro. Então, engenheiros de ML precisam de métodos para estimar o desempenho sem ele. É aqui que entram algoritmos como CBPE ou DLE (falaremos deles adiante).
Também é possível monitorar modelos medindo impacto direto no negócio, ou seja, acompanhando KPIs (indicadores-chave de desempenho). No caso do Zillow, um bom sistema de monitoramento poderia ter detectado a perda de lucro e alertado os engenheiros (hipoteticamente).
Se o sistema de monitoramento detecta queda de performance — seja por análise com ground truth (realizada) ou por estimativa sem ground truth — os engenheiros de ML precisam identificar a causa da queda.
Geralmente isso envolve checar features individualmente ou em combinação para data drift (drift de features) e examinar o alvo para concept drift.
Com base nas descobertas, aplicam-se diferentes técnicas de resolução de problemas.
Aqui vai uma lista não exaustiva de técnicas para mitigar danos causados por degradação pós-deploy:
Cada método tem seu contexto de aplicação e, muitas vezes, você vai acabar combinando vários.
O NannyML atua nas duas primeiras etapas desse processo iterativo. Vamos colocar a mão na massa.
Além dos conjuntos de treino e validação, o NannyML precisa de dois conjuntos adicionais, chamados de reference e analysis, em formatos específicos para começar o monitoramento. Nesta seção, você aprende a criá-los a partir de qualquer dado.
Primeiro, precisamos de um modelo já treinado e pronto para ser colocado em produção, para que possamos monitorá-lo. Para isso, vamos usar o dataset diamonds e treinar um regressor XGBoost.
import warnings

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
import xgboost as xgb
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

warnings.filterwarnings("ignore")
O primeiro passo após importar os módulos é carregar o dataset Diamonds do Seaborn. No entanto, vamos usar uma versão especial do conjunto, preparada especificamente para este artigo, para ilustrar como é o monitoramento. Você pode carregar o dataset no seu ambiente com o snippet abaixo:
dataset_link = "https://raw.githubusercontent.com/BexTuychiev/medium_stories/master/2024/1_january/4_intro_to_nannyml/diamonds_special.csv"

diamonds_special = pd.read_csv(dataset_link)
diamonds_special.head()
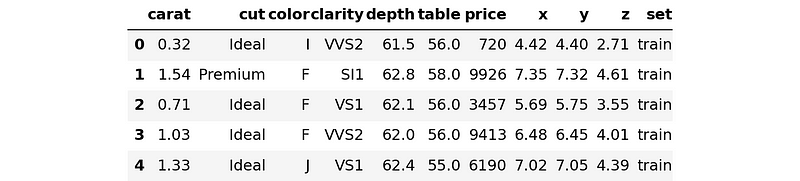
Essa versão especial do dataset tem uma coluna chamada “set”, sobre a qual falaremos a seguir.
Por enquanto, vamos extrair os nomes de todas as features, os nomes das features categóricas e o nome do target:
# Extract all feature names
all_feature_names = diamonds_special.drop(["price", "set"], axis=1).columns.tolist()

# Extract the columns and cast into category
cats = diamonds_special.select_dtypes(exclude=np.number).columns

# Define the target column
target = "price"
A tarefa é de regressão — vamos prever preços de diamantes a partir de seus atributos físicos.
O dataset diamonds é bem limpo. Então, o único pré-processamento é converter as colunas de texto para o tipo category do Pandas. Isso é necessário para habilitar o pré-processamento automático de dados categóricos pelo XGBoost.
for col in cats:
   diamonds_special[col] = diamonds_special[col].astype("category")
Vamos para a divisão dos dados.
Sim, isso mesmo: vamos dividir em quatro conjuntos. Tradicionalmente, você talvez dividisse em três:
Workflows de monitoramento exigem outro conjunto para simular os dados de produção. Isso garante que o sistema detecte corretamente as quedas de performance usando os algoritmos certos e reporte o que deu errado.
Para isso, eu rotulei as linhas do Diamonds Special com quatro categorias na coluna set:
diamonds_special.set.unique()
['train', 'val', 'test', 'prod']
Categories (4, object): ['prod', 'test', 'train', 'val']
O conjunto de treino representa 70%, enquanto os demais têm 10% cada do total de dados. Vamos separar:
tr = diamonds_special[diamonds_special.set == "train"].drop("set", axis=1)
val = diamonds_special[diamonds_special.set == "validation"].drop("set", axis=1)
test = diamonds_special[diamonds_special.set == "test"].drop("set", axis=1)
prod = diamonds_special[diamonds_special.set == "prod"].drop("set", axis=1)

tr.shape
(37758, 10)
Mas datasets do mundo real não vêm com rótulos de conjunto prontos, então você precisa dividir manualmente em quatro partes. Aqui vai uma função que faz isso usando train_test_split do sklearn:
def split_into_four(df, train_size=0.7):
   """
   A function to split a dataset into four sets:
   - Training
   - Validation
   - Testing
   - Production
   train_size is set by the user.
   The remaining data will be equally divided between the three sets.
   """
   # Do the splits
   training, the_rest = train_test_split(df, train_size=train_size)
   validation, the_rest = train_test_split(the_rest, train_size=1 / 3)
   testing, production = train_test_split(the_rest, train_size=0.5)

   # Reset the indices
   sets = (training, validation, testing, production)
   for set in sets:
       set.reset_index(inplace=True, drop=True)

   return sets


tr, val, test, prod = split_into_four(your_dataset)
Observação: use o botão “Explain code” para ver uma explicação linha a linha da função.
Agora, vamos treinar o modelo.
Antes de treinar um modelo XGBoost, precisamos converter os conjuntos em DMatrices. Aqui está o código:
dtrain = xgb.DMatrix(tr[all_feature_names], label=tr[target], enable_categorical=True)
dval = xgb.DMatrix(val[all_feature_names], label=val[target], enable_categorical=True)

dtest = xgb.DMatrix(
   test[all_feature_names], label=test[target], enable_categorical=True
)
dprod = xgb.DMatrix(
   prod[all_feature_names], label=prod[target], enable_categorical=True
)
Agora, o código para treinar um regressor com hiperparâmetros já ajustados:
# Define optimized parameters
params = {
   "n_estimators": 10000,
   "learning_rate": 0.1,
   "tree_method": "gpu_hist",
   "max_depth": 6,
   "min_child_weight": 1,
   "gamma": 0,
   "subsample": 0.8,
   "colsample_bytree": 0.8,
   "objective": "reg:squarederror",
   "reg_alpha": 0.01,
   "reg_lambda": 1,
}

# Training with early stopping
regressor = xgb.train(
   params,
   dtrain,
   num_boost_round=10000,
   evals=[(dtrain, "train"), (dval, "eval")],
   early_stopping_rounds=50,
   verbose_eval=500,
)
[0]	train-rmse:3638.77217	eval-rmse:0.00000
[49]	train-rmse:502.61376	eval-rmse:0.00000
Perfeito — temos um modelo que atinge US$ 503 de RMSE no conjunto de validação. Vamos avaliar mais uma vez no teste:
from sklearn.metrics import mean_squared_error

# Predict on the test set
y_test_pred = regressor.predict(dtest)

# Evaluate
mean_squared_error(test[target], y_test_pred, squared=False)
551.2763827068798
A performance em teste é US$ 551. Está bom o suficiente.
Até aqui, tudo bem direto. Agora chegamos à parte principal — criar os conjuntos de referência e de análise.
Um conjunto de referência é outro nome para o conjunto de teste no contexto de monitoramento. O NannyML usa a performance do modelo no teste como baseline para a produção. O reference precisa ter duas colunas além das features:
y_test_predAgora, nosso conjunto de teste contém as features e o target, mas falta o y_test_pred:
test.columns  # Ignore the `set` column
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z'],
     dtype='object')
Vamos adicionar:
test["y_pred"] = y_test_predAgora, vamos renomear o conjunto de teste para reference:
reference = test.copy(deep=True)

reference.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Neste ponto, vamos imaginar que nosso regressor foi colocado na nuvem. Imaginar é mais simples do que fazer o deploy de fato, o que seria demais para este artigo.
Depois do deploy do nosso modelo de preços de diamantes, recebemos a notícia de que um grande lote de diamantes está chegando. Antes da carga, as medidas físicas foram enviadas como prod (continuamos imaginando) para que possamos gerar os preços e começar a divulgá-los no site. Então, vamos gerar.
# Generate prices for production data
y_prod_pred = regressor.predict(dprod)
Antes de os diamantes chegarem de fato e um especialista humano validar os preços gerados, precisamos checar se o modelo está indo bem. Não queremos exibir no site preços incorretos.
Para isso, teríamos que medir a performance do modelo comparando y_prod_pred com os preços reais dos novos diamantes, o ground truth. Mas não teremos o ground truth antes da validação. Então, precisamos estimar a performance sem ground truth.
Para essa tarefa, o NannyML precisa de um conjunto de análise — os dados de produção com as predições feitas pelo modelo.
Criar um conjunto de análise é parecido com criar o reference:
# Add the predictions of new diamonds to prod
prod["y_pred"] = y_prod_pred

analysis = prod.copy(deep=True)
analysis.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Agora estamos prontos para estimar a performance do regressor.
O NannyML oferece dois algoritmos principais para estimar a performance de modelos de regressão e classificação:
Vamos usar o DLE na nossa tarefa. O DLE consegue medir a performance do modelo em produção sem ground truth e reportar várias pseudo-métricas de regressão, como RMSE, RMSLE, MAE etc.
Para usar o DLE, primeiro precisamos ajustá-lo ao reference para estabelecer um baseline.
import nannyml  # pip install nannyml

estimator = nannyml.DLE(
   feature_column_names=all_feature_names,
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)
Inicializar o DLE requer três parâmetros — os nomes das features de entrada, o nome da coluna com o ground truth de teste e o nome da coluna com as predições de teste.
Além disso, passamos RMSE como métrica e chunk size de 250. Vamos ajustar o estimador ao reference e estimar a performance no analysis:
# Fit to the reference set
estimator.fit(reference)

# Estimate on the analysis set
estimated_results = estimator.estimate(analysis)
estimated_results
<nannyml.performance_estimation.direct_loss_estimation.result.Result at 0x7f3954af1c90>
Temos um objeto Result do NannyML que pode ser plotado. Vamos ver:
estimated_results.plot().show()
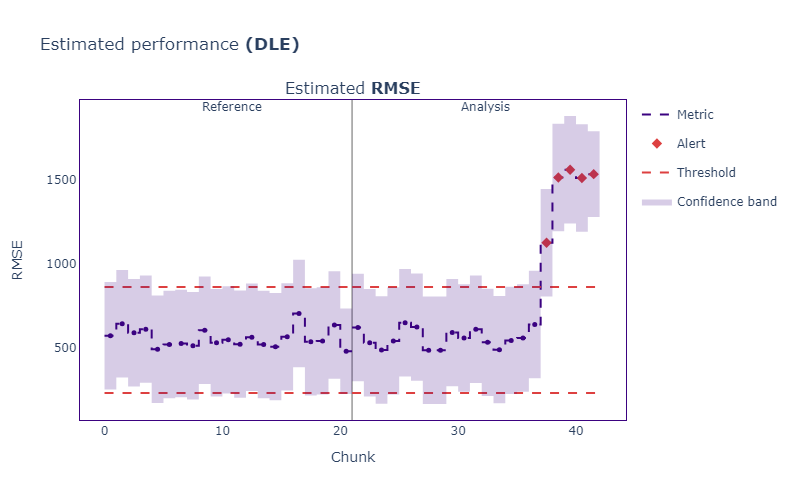
Vamos interpretar o gráfico — ele tem duas seções que mostram a performance nos conjuntos de referência e de análise. Se o RMSE estimado em produção ultrapassar os limites, o NannyML sinaliza alertas.
Como dá para ver, temos alguns alertas nos dados de produção, sugerindo que algo estranho está acontecendo nos últimos lotes.
Nosso sistema de monitoramento indica que o desempenho do modelo caiu pela metade em produção. Mas isso é apenas uma estimativa — não dá para cravar.
Enquanto plotamos a performance estimada, a remessa chegou e nosso especialista em diamantes calculou o preço real. Guardamos esses valores como price em prod.
Agora podemos comparar a performance realizada (real) do modelo com a performance estimada para ver se nosso sistema de monitoramento está funcionando bem.
O NannyML oferece a classe PerformanceCalculator para isso:
calculator = nannyml.PerformanceCalculator(
   problem_type="regression",
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)

calculator.fit(reference)
realized_results = calculator.calculate(analysis)
A classe requer quatro parâmetros:
problem_type: qual é a tarefa?y_true: quais são os rótulos?y_pred: onde estão as predições?metrics: quais métricas usar para calcular a performance?Depois de passá-los e ajustar o calculator ao reference, executamos calculate no conjunto de análise.
Para comparar realized_results com estimated_results, usamos novamente uma visualização:
estimated_results.compare(realized_results).plot().show()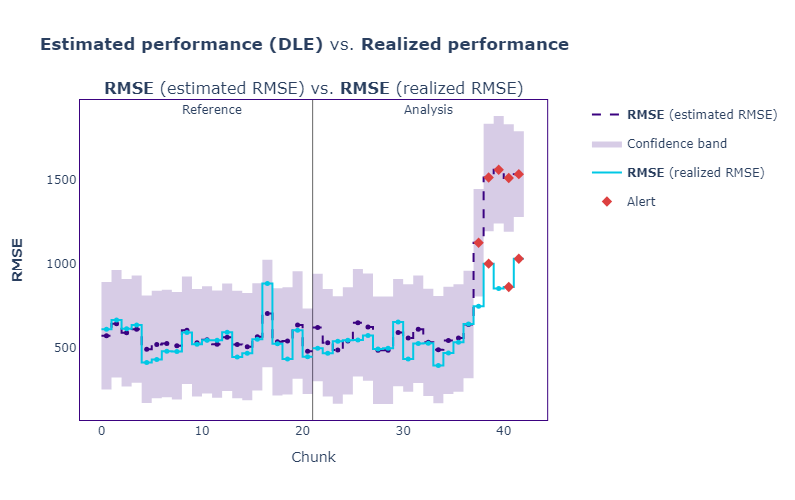
Pelo visto, o RMSE estimado (roxo) ficou bem próximo da performance real (RMSE realizado, azul).
Isso nos diz uma coisa — nosso sistema de monitoramento está indo bem, mas o modelo não, como indica a perda crescente. Então, qual(is) o(s) motivo(s)?
Vamos investigar agora.
Como dito na introdução, um dos motivos mais comuns para modelos falharem em produção é o drift. Nesta seção, vamos focar na detecção de data (feature) drift.
A detecção de drift faz parte da etapa de análise de causa raiz do workflow de monitoramento. Normalmente começa com a detecção multivariada de drift.
Um dos melhores métodos multivariados é calcular o erro de reconstrução dos dados usando PCA. Funciona muito bem e captura até drift sutis na distribuição das features. Aqui está uma visão geral do método:
1. O PCA ajusta no reference e o comprime para uma dimensão menor — reference_lower.
2. reference_lower é então descomprimido para a dimensionalidade original — reference_reconstructed.
reference.3. A diferença entre reference e reference_reconstructed é calculada e chamada de erro de reconstrução — reconstruct_error.
reconstruct_error serve de baseline para comparar o erro de reconstrução dos dados de produção4. Aplica-se o mesmo processo de redução/reconstrução a lotes dos dados de produção.
Esses quatro passos estão implementados na classe DataReconstructionDriftCalculator do NannyML. Veja como usar:
# Initialize
multivariate_calc = nannyml.DataReconstructionDriftCalculator(
   column_names=all_feature_names,
   chunk_size=250,
)

# Fit
multivariate_calc.fit(reference)
# Calculate error
multivariate_results = multivariate_calc.calculate(analysis)
Com o erro para cada chunk de dados (250 linhas por chunk), podemos plotar:
multivariate_results.plot().show()
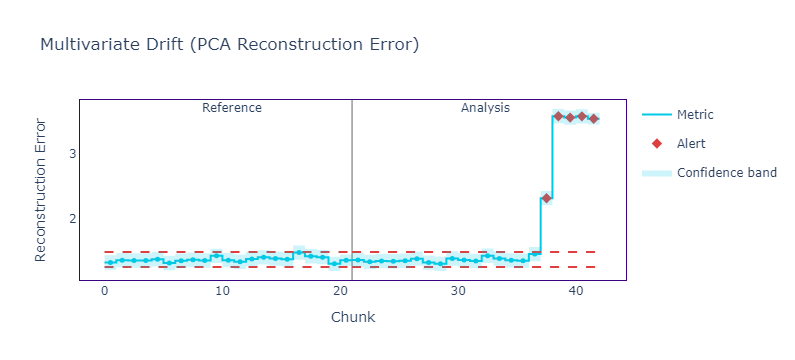
Como vemos, o erro de reconstrução está bem alto, indicando drift nas features. Também podemos comparar o erro com a performance realizada:
multivariate_results.compare(realized_results).plot().show(config={"staticPlot": True})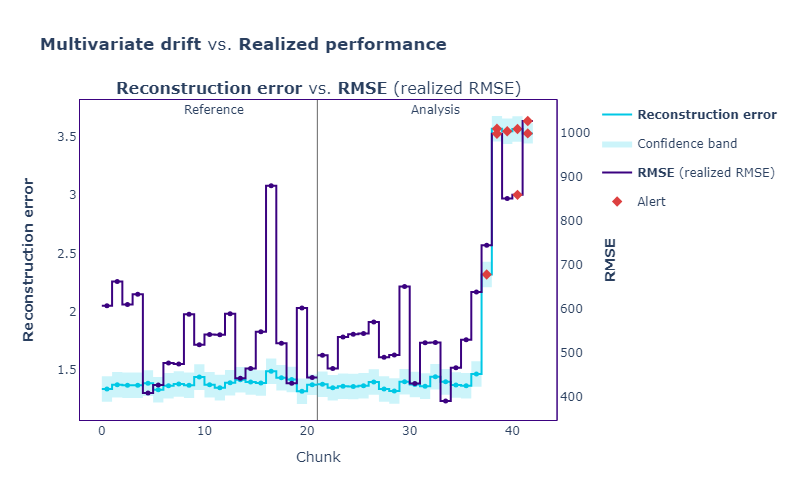
Perceba que todos os picos de perda correspondem a alertas no erro de reconstrução.
O erro de reconstrução é um número único para medir o drift de todas as features. Mas e o drift de cada feature individual? Se nosso dataset tivesse centenas de features, como encontrar as que mais sofreram drift e agir em cima delas?
É aqui que entram os métodos univariados de detecção de drift. O NannyML oferece vários, conforme o tipo de feature:
Todos comparam a distribuição de features individuais no reference com as do conjunto de analysis. Podemos usar alguns (ou todos) via a classe UnivariateDriftCalculator:
univariate_calc = nannyml.UnivariateDriftCalculator(
   column_names=all_feature_names,
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   chunk_size=250,
)

univariate_calc.fit(reference)
univariate_results = univariate_calc.calculate(analysis)
O único parâmetro obrigatório é column_names; o resto pode usar os padrões do NannyML. Para simplificar, estamos usando wasserstein e jensen_shannon para contínuas e categóricas.
No momento, temos 11 features, então chamar plot().show() pode não ser o ideal. Em vez disso, podemos usar um alert count ranker para retornar as features que mais geraram alertas (considerando todos os chunks). Veja o código:
# Initialize the ranker
alert_count_ranker = nannyml.AlertCountRanker()

# Filter the univariate results for only columns containing the metrics
filtered_univariate = univariate_results.filter(
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   only_drifting=False,
)

# Rank the alerts
ranker_results = alert_count_ranker.rank(filtered_univariate)
Com os resultados do rankeador, podemos imprimir o head, já que é um DataFrame do Pandas:
ranker_results.head(10)
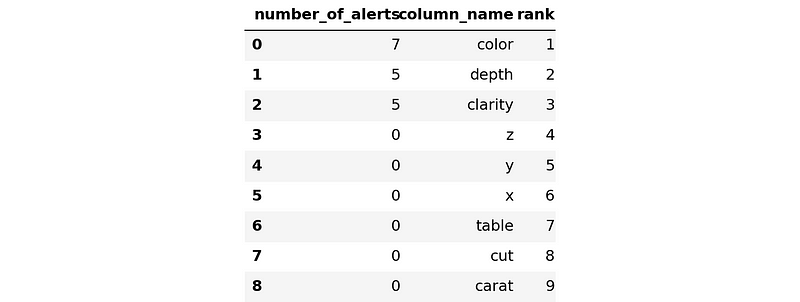
Vemos que as features mais problemáticas são color e depth. Não é surpresa — eu mesmo causei o drift nelas artificialmente antes de escrever o artigo.
Mas, em um cenário real, você dedicaria tempo à resolução de problemas nessas features.
Acho o monitoramento de modelos fascinante porque derruba a ilusão de que o trabalho em machine learning termina quando o modelo fica bom. À medida que o mundo gira e os padrões de uso mudam, nenhum modelo continua relevante por muito tempo. Por isso, monitoramento é uma habilidade essencial para qualquer engenheiro de ML.
Hoje cobrimos um workflow básico de monitoramento. Começamos pelos conceitos fundamentais. Depois, mergulhamos no código: deixamos os dados no formato compatível com o NannyML; criamos nosso primeiro gráfico para a performance estimada; comparamos com a performance realizada; recebemos alguns alertas de queda; verificamos com detecção de drift multivariada; encontramos drift forte de features; conferimos com detecção univariada; identificamos as features com drift.
Infelizmente, paramos na etapa de resolução de problemas. Esse último passo do workflow foge ao escopo deste artigo. Porém, tenho ótimas recomendações que cobrem isso e muito mais sobre monitoramento de modelos:
Ambos os cursos foram criados pela melhor pessoa possível para o tema — o CEO e fundador do NannyML. Eles trazem vários insights que você não pode perder.
Também recomendo ler a documentação do NannyML para tutoriais práticos.
Comece sua jornada em machine learning hoje!
Curso
Curso
Curso
Tutorial
Moez Ali
9 min
Tutorial
Tutorial
Zoumana Keita
8 min
Tutorial
Moez Ali
12 min
Tutorial
Tutorial
Kurtis Pykes
12 min




