
Corso
Capire il Machine Learning
2 ore
311.6K
I progetti di machine learning sono processi iterativi. Non ti fermi a un modello riuscito dentro un Jupyter notebook. Non ti fermi nemmeno dopo che il modello è online e le persone possono accedervi. Anche dopo la messa in produzione, devi continuare a tenerlo d'occhio perché funzioni bene come durante lo sviluppo.
Lo scandalo di Zillow è un esempio perfetto di cosa succede se non lo fai. Nel 2021, Zillow ha perso la cifra sbalorditiva di 304 milioni di dollari a causa del suo modello di machine learning che stimava i prezzi delle case. Zillow ha pagato troppo per oltre 7000 abitazioni ed è stata costretta a rivenderle a un prezzo molto più basso. L'azienda è stata “fregata” dal proprio modello e ha dovuto ridurre la forza lavoro del 25%.
Questi tipi di fallimenti silenziosi dei modelli sono comuni nel mondo reale, quindi è necessario aggiornarli costantemente prima che le prestazioni in produzione calino. Non farlo danneggia la reputazione delle aziende, la fiducia degli stakeholder e, in ultima analisi, i loro conti.
Questo articolo ti insegnerà come implementare un workflow end-to-end per monitorare i modelli di machine learning dopo la messa in produzione con NannyML.
NannyML è una libreria open source in crescita, focalizzata sul machine learning post-deployment. Offre un'ampia gamma di funzionalità per risolvere tutti i tipi di problemi che sorgono negli ambienti ML di produzione. Eccone alcune:
Impareremo gli aspetti tecnici di queste funzionalità una per una.
Impareremo i concetti fondamentali del monitoraggio dei modelli attraverso l'analogia di un robot che impara il tiro con l'arco.
Nella nostra analogia:
Quindi, iniziamo.
Immagina di aver preparato con cura arco, frecce e bersaglio (come nella preparazione dei dati). Il nostro robot, dotato di molti sensori e telecamere, scocca 10000 frecce durante l'addestramento. Nel tempo, inizia a colpire il centro con notevole frequenza. Siamo entusiasti delle prestazioni e iniziamo a vendere il robot e le sue copie agli appassionati di tiro con l'arco (deploy del modello).
Ma presto riceviamo una sfilza di reclami. Alcuni utenti segnalano che il robot manca del tutto il bersaglio. Sorpresi, mettiamo insieme un team per capire cosa è andato storto.
Quello che scopriamo è un classico caso di data drift. L'ambiente in cui operano i robot è cambiato — pattern del vento diversi, livelli di umidità variabili e persino cambiamenti nelle caratteristiche fisiche delle frecce (peso, bilanciamento) e dell'arco.
Questo cambiamento reale nelle feature di input ha compromesso l'accuratezza del nostro robot, in modo simile a come un modello di machine learning può sottoperformare quando i dati in input, in particolare la relazione tra le feature, cambiano nel tempo.
Dopo aver affrontato questi problemi, rilasciamo un nuovo lotto di robot. Eppure, nel giro di qualche settimana, arrivano lamentele simili. Perplessi, indaghiamo più a fondo e scopriamo che gli utenti hanno spesso sostituito i bersagli.
Questi nuovi bersagli variano in dimensioni e sono posizionati a distanze diverse. Questo cambiamento richiede un approccio diverso nella tecnica di tiro del robot — un esempio da manuale di concept drift.
In termini di machine learning, il concept drift si verifica quando cambia la relazione tra le variabili di input e l'esito target. Per i nostri robot, i nuovi tipi di bersagli significano che devono adattarsi a un modo di tirare diverso, proprio come un modello di machine learning deve adeguarsi quando la dinamica dei dati su cui è stato addestrato cambia in modo significativo.
Per fissare bene i concetti, esploriamo alcuni esempi reali di come si verificano data e concept drift.
Ora, consideriamo un workflow di monitoraggio ML end-to-end.
Il monitoraggio dei modelli prevede tre passaggi principali che gli ML engineer dovrebbero seguire in modo iterativo.
Il primo passo è, ovviamente, tenere d'occhio le prestazioni del modello in produzione. Ma è più facile a dirsi che a farsi.
Quando la verità a terra è immediatamente disponibile per un modello in produzione, è facile rilevare cambiamenti nel comportamento del modello. Per esempio, nella nostra analogia robot/tiro con l'arco, gli utenti possono dirci subito cosa non va perché possono guardare il bersaglio e dirci che il robot ha mancato — verità a terra immediata.
Al contrario, prendi l'esempio di un modello che predice i default sui prestiti. Tali modelli prevedono ogni mese se un utente salterà il prossimo pagamento o meno. Per verificare la previsione, il modello deve aspettare la data del pagamento effettivo. Questo è un esempio di verità a terra ritardata, molto comune nei sistemi di machine learning nel mondo reale.
In questi casi, aspettare che la verità a terra sia disponibile per vedere se i modelli stanno performando bene è troppo oneroso. Quindi, gli ML engineer hanno bisogno di metodi per stimare le prestazioni del modello senza di essa. È qui che entrano in gioco algoritmi come CBPE o DLE (ne parleremo tra poco).
Il monitoraggio dei modelli può essere fatto anche misurando l'impatto diretto sul business, cioè monitorando le KPI (key performance indicator). Nel caso di Zillow, un sistema di monitoraggio adeguato avrebbe potuto rilevare la perdita di profitto e avvisare gli ingegneri (ipoteticamente).
Se il sistema di monitoraggio rileva un calo di prestazioni, indipendentemente dal fatto che abbia analizzato prestazioni reali (con verità a terra) o stimate (senza verità a terra), gli ML engineer devono identificare la causa del calo.
Questo di solito comporta il controllo delle feature singolarmente o in combinazione per il data (feature drift) e l'esame dei target per il concept drift.
In base ai risultati, applicano varie tecniche di risoluzione dei problemi.
Ecco un elenco non esaustivo di tecniche per mitigare i danni causati dal degrado delle prestazioni post-deployment:
Ogni metodo ha il suo contesto di applicazione e spesso finisci per implementarne una combinazione.
NannyML si occupa dei primi due passaggi di questo processo iterativo. Quindi, andiamo al sodo.
Oltre ai set di training e validation, NannyML richiede due set aggiuntivi chiamati reference e analysis in formati specifici per iniziare il monitoraggio. Questa sezione ti insegna come crearli a partire da qualsiasi dato.
Per prima cosa, ci serve un modello già addestrato e pronto per la produzione, così da poterlo monitorare. A questo scopo useremo il dataset diamonds e alleneremo un regressore XGBoost.
import warnings

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
import xgboost as xgb
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

warnings.filterwarnings("ignore")
Il primo passo dopo l'import dei moduli è caricare il dataset Diamonds da Seaborn. Tuttavia, useremo una versione speciale del dataset che ho preparato appositamente per questo articolo per illustrare come appare il monitoraggio. Puoi caricare il dataset nel tuo ambiente usando lo snippet qui sotto:
dataset_link = "https://raw.githubusercontent.com/BexTuychiev/medium_stories/master/2024/1_january/4_intro_to_nannyml/diamonds_special.csv"

diamonds_special = pd.read_csv(dataset_link)
diamonds_special.head()
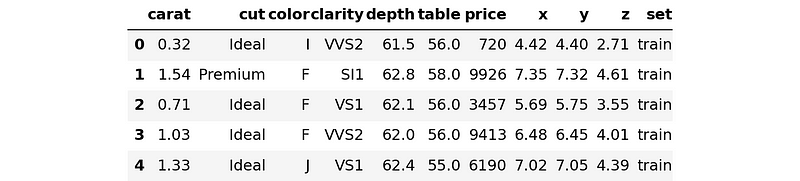
Questa versione speciale del dataset ha una colonna chiamata “set”, di cui parleremo tra un attimo.
Per ora, estraiamo i nomi di tutte le feature, i nomi delle feature categoriche e il nome del target:
# Extract all feature names
all_feature_names = diamonds_special.drop(["price", "set"], axis=1).columns.tolist()

# Extract the columns and cast into category
cats = diamonds_special.select_dtypes(exclude=np.number).columns

# Define the target column
target = "price"
Il task è una regressione — prediremo i prezzi dei diamanti date le loro caratteristiche fisiche.
Il dataset diamonds è abbastanza pulito. Quindi, l'unico preprocessing che eseguiamo è il cast delle feature testuali nel tipo di dato category di Pandas. È un requisito per abilitare l'elaborazione automatica dei dati categorici in XGBoost.
for col in cats:
   diamonds_special[col] = diamonds_special[col].astype("category")
Passiamo ora allo split dei dati.
Sì, hai letto bene. Divideremo i dati in quattro set. Tradizionalmente, potresti averli divisi solo in tre:
I workflow di monitoraggio dei modelli richiedono un altro set per imitare i dati di produzione. Questo serve a garantire che il nostro sistema rilevi correttamente i cali di prestazioni usando gli algoritmi giusti e riporti cosa è andato storto.
A questo scopo, ho etichettato le righe di Diamonds Special con quattro categorie nella colonna set:
diamonds_special.set.unique()
['train', 'val', 'test', 'prod']
Categories (4, object): ['prod', 'test', 'train', 'val']
Il training set rappresenta il 70%, mentre i restanti sono il 10% ciascuno del totale. Facciamo lo split:
tr = diamonds_special[diamonds_special.set == "train"].drop("set", axis=1)
val = diamonds_special[diamonds_special.set == "validation"].drop("set", axis=1)
test = diamonds_special[diamonds_special.set == "test"].drop("set", axis=1)
prod = diamonds_special[diamonds_special.set == "prod"].drop("set", axis=1)

tr.shape
(37758, 10)
Ma i dataset reali non vengono con etichette di set integrate, quindi devi dividere manualmente i dati in quattro set. Ecco una funzione che esegue il compito usando train_test_split da sklearn:
def split_into_four(df, train_size=0.7):
   """
   A function to split a dataset into four sets:
   - Training
   - Validation
   - Testing
   - Production
   train_size is set by the user.
   The remaining data will be equally divided between the three sets.
   """
   # Do the splits
   training, the_rest = train_test_split(df, train_size=train_size)
   validation, the_rest = train_test_split(the_rest, train_size=1 / 3)
   testing, production = train_test_split(the_rest, train_size=0.5)

   # Reset the indices
   sets = (training, validation, testing, production)
   for set in sets:
       set.reset_index(inplace=True, drop=True)

   return sets


tr, val, test, prod = split_into_four(your_dataset)
Nota: usa il pulsante “Spiega il codice” per ottenere una spiegazione riga per riga della funzione.
Ora passiamo al training del modello.
Prima di addestrare un modello XGBoost, dobbiamo convertire i dataset in DMatrix. Ecco il codice:
dtrain = xgb.DMatrix(tr[all_feature_names], label=tr[target], enable_categorical=True)
dval = xgb.DMatrix(val[all_feature_names], label=val[target], enable_categorical=True)

dtest = xgb.DMatrix(
   test[all_feature_names], label=test[target], enable_categorical=True
)
dprod = xgb.DMatrix(
   prod[all_feature_names], label=prod[target], enable_categorical=True
)
Ora, ecco il codice per addestrare un regressore con iperparametri già ottimizzati:
# Define optimized parameters
params = {
   "n_estimators": 10000,
   "learning_rate": 0.1,
   "tree_method": "gpu_hist",
   "max_depth": 6,
   "min_child_weight": 1,
   "gamma": 0,
   "subsample": 0.8,
   "colsample_bytree": 0.8,
   "objective": "reg:squarederror",
   "reg_alpha": 0.01,
   "reg_lambda": 1,
}

# Training with early stopping
regressor = xgb.train(
   params,
   dtrain,
   num_boost_round=10000,
   evals=[(dtrain, "train"), (dval, "eval")],
   early_stopping_rounds=50,
   verbose_eval=500,
)
[0]	train-rmse:3638.77217	eval-rmse:0.00000
[49]	train-rmse:502.61376	eval-rmse:0.00000
Ottimo — abbiamo un modello che ottiene 503$ in termini di RMSE sul validation set. Valutiamo il modello un'ultima volta sul test set:
from sklearn.metrics import mean_squared_error

# Predict on the test set
y_test_pred = regressor.predict(dtest)

# Evaluate
mean_squared_error(test[target], y_test_pred, squared=False)
551.2763827068798
Le prestazioni sul testing sono 551$. Va più che bene.
Fino a questo punto, tutto era piuttosto lineare. Ora arriviamo alla parte principale — creare i set di reference e analysis.
Un set di reference è un altro nome per il test set nel contesto del monitoraggio dei modelli. NannyML usa le prestazioni del modello sul test set come baseline per le prestazioni in produzione. Il set di reference deve avere due colonne oltre alle feature:
y_test_predAl momento, il nostro test set contiene le feature e il target ma manca y_test_pred:
test.columns  # Ignore the `set` column
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z'],
     dtype='object')
Aggiungiamola:
test["y_pred"] = y_test_predOra rinomineremo il test set in reference:
reference = test.copy(deep=True)

reference.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
A questo punto, immaginiamo che il nostro regressore sia stato distribuito sul cloud. Immaginare è più semplice che distribuire davvero il modello, che sarebbe eccessivo per questo articolo.
Dopo aver messo in produzione il nostro modello di pricing dei diamanti, riceviamo la notizia che sta arrivando una grande spedizione di diamanti. Prima che il carico arrivi, le misurazioni fisiche dei diamanti ci sono state inviate come prod (stiamo ancora immaginando) così possiamo generare i prezzi e iniziare a metterli in vetrina sul nostro sito. Quindi, generiamo.
# Generate prices for production data
y_prod_pred = regressor.predict(dprod)
Prima che i diamanti effettivi arrivino e uno specialista umano verifichi i prezzi generati dal nostro modello, dobbiamo controllare se il modello sta performando bene. Non vogliamo mostrare diamanti con prezzi inaccurati sul sito.
Per farlo, dovremmo misurare le prestazioni del modello confrontando y_prod_pred con i prezzi reali dei nuovi diamanti, la verità a terra. Ma non avremo la verità a terra prima che i prezzi vengano verificati. Quindi, dobbiamo stimare le prestazioni del modello senza verità a terra.
Per svolgere questo compito, NannyML richiede un set di analysis — i dati che contengono i dati di produzione con le predizioni prodotte dal modello.
Creare un set di analysis è simile a creare il reference:
# Add the predictions of new diamonds to prod
prod["y_pred"] = y_prod_pred

analysis = prod.copy(deep=True)
analysis.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Ora siamo pronti per stimare le prestazioni del regressor.
NannyML fornisce due algoritmi principali per stimare le prestazioni di modelli di regressione e classificazione:
Useremo l'algoritmo DLE per il nostro compito. DLE può misurare le prestazioni di un modello in produzione senza verità a terra e riportare varie pseudo-metriche di regressione come RMSE, RMSLE, MAE, ecc.
Per usare DLE, dobbiamo prima adattarlo al reference per stabilire una baseline di prestazioni.
import nannyml  # pip install nannyml

estimator = nannyml.DLE(
   feature_column_names=all_feature_names,
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)
L'inizializzazione di DLE richiede tre parametri: i nomi delle feature di input, il nome della colonna contenente la verità a terra per il testing e il nome della colonna contenente le predizioni del testing.
Inoltre, passiamo anche l'RMSE come metrica e una dimensione dei blocchi di 250. Adattiamo l'estimatore al reference e stimiamo le prestazioni su analysis:
# Fit to the reference set
estimator.fit(reference)

# Estimate on the analysis set
estimated_results = estimator.estimate(analysis)
estimated_results
<nannyml.performance_estimation.direct_loss_estimation.result.Result at 0x7f3954af1c90>
Abbiamo un oggetto Result di NannyML che può essere plottato. Vediamo cosa produce:
estimated_results.plot().show()
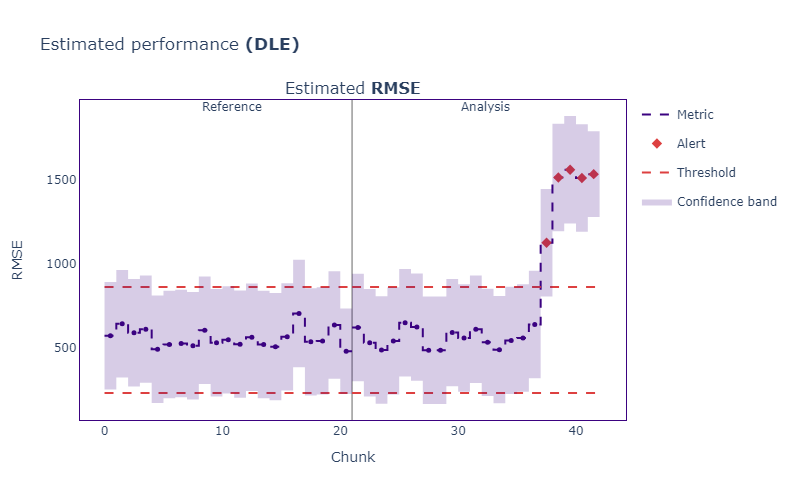
Interpretiamo il grafico — ha due sezioni che mostrano le prestazioni sui set di reference e analysis. Se l'RMSE stimato in produzione supera le soglie, NannyML li segnala come alert.
Come possiamo vedere, abbiamo alcuni alert per i dati di produzione, il che suggerisce che qualcosa di sospetto stia accadendo negli ultimi batch.
Il nostro sistema di monitoraggio ci dice che le prestazioni del modello sono calate di circa la metà in produzione. Ma è solo una stima — non possiamo dirlo con certezza.
Mentre stiamo tracciando le prestazioni stimate, la spedizione è arrivata e il nostro specialista di diamanti ha calcolato il loro prezzo effettivo. Li abbiamo salvati come price in prod.
Ora possiamo confrontare le prestazioni realizzate (effettive) del modello con quelle stimate per vedere se il nostro sistema di monitoraggio funziona bene.
NannyML fornisce una classe PerformanceCalculator per farlo:
calculator = nannyml.PerformanceCalculator(
   problem_type="regression",
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)

calculator.fit(reference)
realized_results = calculator.calculate(analysis)
La classe richiede quattro parametri:
problem_type: qual è il task?y_true: quali sono le etichette?y_pred: dove trovo le predizioni?metrics: quali metriche uso per calcolare le prestazioni?Dopo averli passati e aver adattato il calcolatore al reference, eseguiamo calculate sul set di analysis.
Per confrontare realized_results con estimated_results, usiamo di nuovo una visualizzazione:
estimated_results.compare(realized_results).plot().show()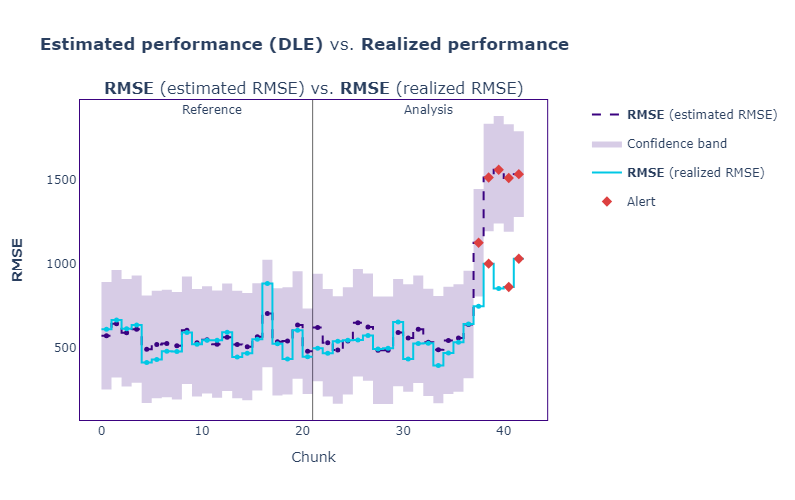
Sembra che l'RMSE stimato (viola) sia stato piuttosto vicino alle prestazioni effettive (RMSE realizzato, blu).
Questo ci dice una cosa — il nostro sistema di monitoraggio funziona bene, ma il nostro modello no, come indicato dall'aumento della loss. Quindi, qual è la/le ragione/i?
Ci addentriamo ora in questo.
Come accennato nell'introduzione, uno dei motivi più comuni per cui i modelli falliscono in produzione è il drift. In questa sezione ci concentreremo sul rilevamento del data (feature) drift.
Il rilevamento del drift fa parte del passaggio di analisi della causa radice del workflow di monitoraggio dei modelli. Tipicamente inizia con il rilevamento del drift multivariato.
Uno dei migliori metodi di rilevamento del drift multivariato è calcolare l'errore di ricostruzione dei dati usando la PCA. Funziona sorprendentemente bene e può catturare anche i minimi drift nelle distribuzioni delle feature. Ecco una panoramica ad alto livello del metodo:
1. Si adatta la PCA a reference e lo si comprime in una dimensione inferiore - reference_lower.
2. reference_lower viene quindi decompresso alla dimensionalità originale - reference_reconstructed.
reference.3. Si trova la differenza tra reference e reference_reconstructed e la si chiama errore di ricostruzione dei dati - reconstruct_error.
reconstruct_error funge da baseline per confrontare l'errore di ricostruzione dei dati di produzione4. Si applica lo stesso metodo di riduzione/ricostruzione ai batch dei dati di produzione.
Questi quattro passaggi sono implementati come classe DataReconstructionDriftCalculator in NannyML. Ecco come usarla:
# Initialize
multivariate_calc = nannyml.DataReconstructionDriftCalculator(
   column_names=all_feature_names,
   chunk_size=250,
)

# Fit
multivariate_calc.fit(reference)
# Calculate error
multivariate_results = multivariate_calc.calculate(analysis)
Una volta che abbiamo l'errore per ogni chunk di dati (250 righe ciascuno), possiamo tracciarlo:
multivariate_results.plot().show()
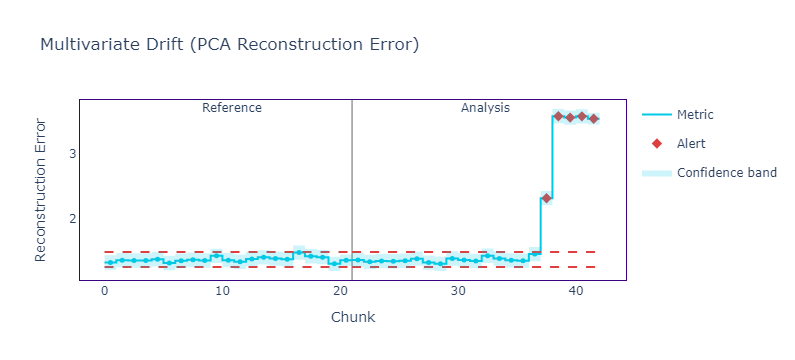
Come possiamo vedere, l'errore di ricostruzione è molto alto, a indicare un drift nelle feature. Possiamo confrontare l'errore anche con le prestazioni realizzate:
multivariate_results.compare(realized_results).plot().show(config={"staticPlot": True})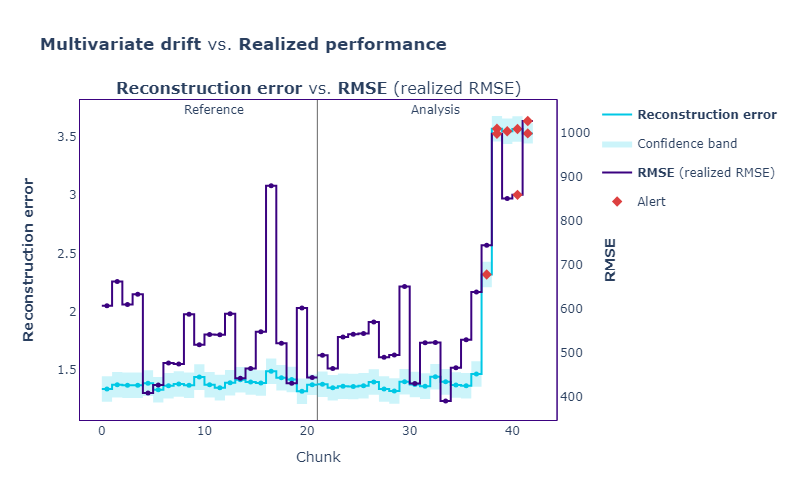
Come possiamo vedere, tutti i picchi della loss corrispondono agli alert nell'errore di ricostruzione.
L'errore di ricostruzione dei dati è un singolo numero per misurare il drift su tutte le feature. Ma che dire del drift delle singole feature? Se il nostro dataset contenesse centinaia di feature, come individueremmo quelle che stanno subendo più drift e prenderemmo le misure appropriate?
È qui che usiamo i metodi di rilevamento del drift univariato. NannyML ne offre diversi a seconda del tipo di feature:
Tutti questi metodi confrontano la distribuzione delle singole feature in reference con quelle del set di analysis. Possiamo usarne alcuni (o anche tutti) all'interno della classe UnivariateDriftCalculator:
univariate_calc = nannyml.UnivariateDriftCalculator(
   column_names=all_feature_names,
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   chunk_size=250,
)

univariate_calc.fit(reference)
univariate_results = univariate_calc.calculate(analysis)
L'unico parametro obbligatorio è column_names, il resto può usare i default impostati da NannyML. Ma, per semplicità, usiamo wasserstein e jensen_shannon per feature continue e categoriche.
Al momento, abbiamo 11 feature, quindi chiamare plot().show() potrebbe non dare i risultati più comodi. Invece, possiamo usare un alert count ranker per restituire le feature che hanno generato il maggior numero di alert (considerando tutti i chunk). Ecco il codice:
# Initialize the ranker
alert_count_ranker = nannyml.AlertCountRanker()

# Filter the univariate results for only columns containing the metrics
filtered_univariate = univariate_results.filter(
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   only_drifting=False,
)

# Rank the alerts
ranker_results = alert_count_ranker.rank(filtered_univariate)
Una volta ottenuti i risultati del ranker, possiamo stamparne la testa dato che è un DataFrame Pandas:
ranker_results.head(10)
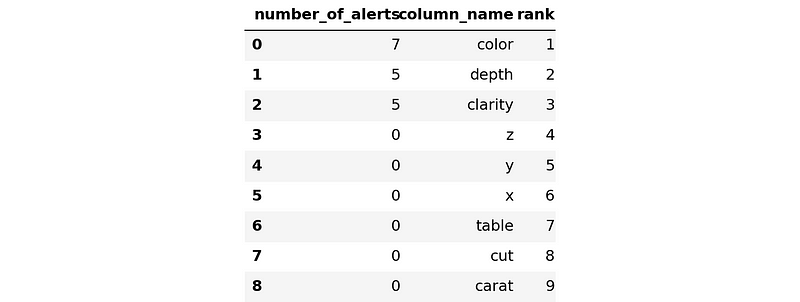
Vediamo che le feature più problematiche sono color e depth. Non dovrebbe sorprendermi, dato che sono stato io ad averle fatte deragliare artificialmente prima di scrivere l'articolo.
Ma se fosse uno scenario reale, vorresti dedicare del tempo alla risoluzione dei problemi per queste feature.
Trovo il monitoraggio dei modelli affascinante perché infrange l'illusione che il machine learning sia finito una volta ottenuto un buon modello. Mentre la Terra gira e i comportamenti degli utenti cambiano, nessun modello rimane rilevante a lungo. Questo rende il monitoraggio una parte cruciale del set di competenze di qualsiasi ML engineer.
Oggi abbiamo trattato un workflow base di monitoraggio dei modelli. Siamo partiti dai concetti fondamentali di monitoraggio. Poi siamo passati subito al codice: abbiamo forgiato i dati in un formato compatibile con NannyML; creato il primo grafico per le prestazioni stimate del modello, e un altro per confrontarle con le prestazioni realizzate; ricevuto alcuni alert di calo prestazionale; verificato con rilevamento del drift multivariato; trovato un forte drift delle feature; ricontrollato con il rilevamento del drift delle singole feature; identificato le feature in drift.
Purtroppo ci siamo fermati proprio alla risoluzione dei problemi. Quest'ultimo passaggio del workflow di monitoraggio è oltre lo scopo di questo articolo. Tuttavia, ho alcune ottime raccomandazioni che lo coprono e approfondiscono molto altro sul monitoraggio dei modelli:
Entrambi questi corsi sono stati creati dalla persona migliore che potresti desiderare — il CEO e fondatore di NannyML. Nei corsi ci sono molte chicche da non perdere.
Consiglio anche di leggere la documentazione di NannyML per alcuni tutorial pratici.
Inizia oggi il tuo percorso nel Machine Learning!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



