
Cours
Comprendre le Machine Learning
2 h
308.6K
Les projets de machine learning sont itératifs. On ne s’arrête pas à un modèle performant dans un notebook Jupyter. On ne s’arrête pas non plus une fois le modèle mis en ligne et accessible aux utilisateurs. Même après le déploiement, il faut le suivre en continu pour s’assurer qu’il fonctionne aussi bien qu’en phase de développement.
Le scandale de Zillow en est l’illustration parfaite. En 2021, Zillow a perdu la somme colossale de 304 millions de dollars à cause de son modèle de machine learning d’estimation des prix immobiliers. Zillow a surpayé plus de 7000 maisons et a dû les revendre à perte. L’entreprise s’est fait « piéger » par son propre modèle et a dû réduire ses effectifs de 25 %.
Ces défaillances silencieuses sont fréquentes avec des modèles en production. Ils doivent donc être surveillés et mis à jour en continu, avant que leurs performances ne se dégradent. À défaut, c’est la réputation, la confiance des parties prenantes, et in fine les résultats financiers qui en pâtissent.
Cet article vous apprend à mettre en place un workflow de surveillance de bout en bout pour des modèles de machine learning après leur déploiement avec NannyML.
NannyML est une bibliothèque open source en pleine croissance, dédiée au machine learning post-déploiement. Elle propose un large éventail de fonctionnalités pour résoudre les problèmes courants rencontrés en production. Parmi lesquelles :
Nous allons découvrir les aspects techniques de ces fonctionnalités pas à pas.
Nous allons aborder les fondamentaux de la surveillance des modèles à travers l’analogie d’un robot qui maîtrise le tir à l’arc.
Dans notre analogie :
Allons-y.
Imaginons que nous ayons soigneusement préparé l’arc, les flèches et la cible (comme une préparation des données). Notre robot, équipé de nombreux capteurs et caméras, tire 10 000 fois pendant l’entraînement. Avec le temps, il touche très souvent le centre. Ravis des performances, nous vendons le robot et ses copies aux passionnés de tir à l’arc (déploiement du modèle).
Mais très vite, les réclamations affluent. Certains utilisateurs indiquent que le robot manque complètement la cible. Étonnés, nous réunissons une équipe pour comprendre.
Nous mettons au jour un cas classique de dérive des données. L’environnement d’utilisation a changé : régimes de vent différents, taux d’humidité variables, et même des modifications des caractéristiques physiques des flèches (poids, équilibre) et de l’arc.
Ce changement réel des variables d’entrée perturbe la précision de notre robot, comme lorsqu’un modèle de machine learning sous-performe parce que la relation entre les caractéristiques évolue avec le temps.
Après avoir corrigé ces problèmes, nous livrons une nouvelle série de robots. Pourtant, quelques semaines plus tard, des plaintes similaires réapparaissent. En creusant, nous découvrons que les cibles ont été fréquemment remplacées par les utilisateurs.
Ces nouvelles cibles varient en taille et sont placées à des distances différentes. Cela exige une autre approche du tir pour le robot : un exemple type de dérive de concept.
En machine learning, la dérive de concept survient lorsque la relation entre les variables d’entrée et la cible change. Pour nos robots, de nouveaux types de cibles impliquent d’adapter la façon de tirer, comme un modèle doit s’ajuster quand la dynamique des données d’entraînement évolue fortement.
Pour bien ancrer ces notions, explorons des exemples réels de dérive.
Passons maintenant à un workflow de surveillance de ML de bout en bout.
La surveillance d’un modèle comporte trois grandes étapes à répéter de façon itérative.
La première étape consiste à suivre de près les performances du modèle en production. Plus facile à dire qu’à faire.
Quand la vérité terrain est disponible immédiatement, détecter un changement de comportement est simple. Dans notre analogie, l’utilisateur voit la cible et constate aussitôt que le robot a manqué : vérité terrain immédiate.
À l’inverse, prenons un modèle qui prédit les défauts de paiement d’un prêt. Il anticipe chaque mois si un client fera défaut. Pour vérifier, il faut attendre la date de paiement effective. C’est un cas de vérité terrain différée, très courant dans les systèmes réels.
Dans ces cas-là, attendre la vérité terrain coûte trop cher. Les ingénieurs ML doivent donc estimer la performance sans elle. C’est là qu’interviennent des algorithmes comme CBPE ou DLE (nous y reviendrons).
On peut aussi surveiller via l’impact business direct, en suivant des KPI (indicateurs clés). Dans le cas Zillow, un bon système de monitoring aurait pu détecter la baisse de marge et alerter les équipes (hypothétiquement).
Si le système détecte une baisse de performance, qu’elle soit mesurée (avec vérité terrain) ou estimée (sans vérité terrain), les ingénieurs ML doivent en identifier l’origine.
Cela consiste généralement à examiner les variables d’entrée individuellement ou en combinaison (dérive des caractéristiques) et à analyser la cible (dérive de concept).
Selon les constats, différentes stratégies de remédiation sont appliquées.
Voici une liste non exhaustive de techniques pour atténuer les dégradations post-déploiement :
Chaque méthode a son contexte d’usage et l’on combine souvent plusieurs approches.
NannyML couvre les deux premières étapes de ce cycle. Passons à la pratique.
Au-delà des jeux d’entraînement et de validation, NannyML a besoin de deux ensembles supplémentaires, appelés reference et analysis, dans des formats spécifiques pour démarrer la surveillance. Cette section explique comment les créer à partir de n’importe quelles données.
Il nous faut d’abord un modèle déjà entraîné et prêt à être déployé, afin de pouvoir le surveiller. Nous allons utiliser le jeu de données diamonds et entraîner un régressseur XGBoost.
import warnings

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
import xgboost as xgb
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

warnings.filterwarnings("ignore")
Après les imports, on charge le jeu de données Diamonds depuis Seaborn. Toutefois, nous allons utiliser une version spéciale du dataset que j’ai préparée pour illustrer la surveillance. Chargez-la dans votre environnement avec l’extrait ci-dessous :
dataset_link = "https://raw.githubusercontent.com/BexTuychiev/medium_stories/master/2024/1_january/4_intro_to_nannyml/diamonds_special.csv"

diamonds_special = pd.read_csv(dataset_link)
diamonds_special.head()
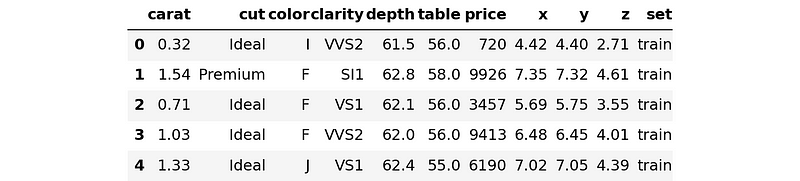
Cette version spéciale comporte une colonne « set », sur laquelle nous reviendrons dans un instant.
Pour l’instant, extrayons les noms de toutes les caractéristiques, les variables catégorielles, et le nom de la cible :
# Extract all feature names
all_feature_names = diamonds_special.drop(["price", "set"], axis=1).columns.tolist()

# Extract the columns and cast into category
cats = diamonds_special.select_dtypes(exclude=np.number).columns

# Define the target column
target = "price"
La tâche est une régression : nous allons prédire le prix des diamants à partir de leurs attributs physiques.
Le dataset diamonds est assez propre. Le seul prétraitement consiste à convertir les variables textuelles en type category de Pandas. C’est requis pour activer le prétraitement automatique des données catégorielles par XGBoost.
for col in cats:
   diamonds_special[col] = diamonds_special[col].astype("category")
Passons à la découpe des données.
Oui, vous avez bien lu : nous allons créer quatre ensembles. Traditionnellement, on se contente de trois :
Les workflows de monitoring exigent un ensemble supplémentaire qui imite les données de production. L’objectif est de s’assurer que le système détecte correctement les baisses de performance avec les bons algorithmes et en identifie les causes.
Pour cela, j’ai étiqueté les lignes de Diamonds Special avec quatre catégories dans la colonne set :
diamonds_special.set.unique()
['train', 'val', 'test', 'prod']
Categories (4, object): ['prod', 'test', 'train', 'val']
Le jeu d’entraînement représente 70 % et les autres 10 % chacun. Découpons :
tr = diamonds_special[diamonds_special.set == "train"].drop("set", axis=1)
val = diamonds_special[diamonds_special.set == "validation"].drop("set", axis=1)
test = diamonds_special[diamonds_special.set == "test"].drop("set", axis=1)
prod = diamonds_special[diamonds_special.set == "prod"].drop("set", axis=1)

tr.shape
(37758, 10)
Dans la réalité, les jeux de données n’arrivent pas avec ces étiquettes, vous devrez donc effectuer vous-même une découpe en quatre. Voici une fonction qui le fait avec train_test_split de sklearn :
def split_into_four(df, train_size=0.7):
   """
   A function to split a dataset into four sets:
   - Training
   - Validation
   - Testing
   - Production
   train_size is set by the user.
   The remaining data will be equally divided between the three sets.
   """
   # Do the splits
   training, the_rest = train_test_split(df, train_size=train_size)
   validation, the_rest = train_test_split(the_rest, train_size=1 / 3)
   testing, production = train_test_split(the_rest, train_size=0.5)

   # Reset the indices
   sets = (training, validation, testing, production)
   for set in sets:
       set.reset_index(inplace=True, drop=True)

   return sets


tr, val, test, prod = split_into_four(your_dataset)
Remarque : utilisez le bouton « Explain code » pour une explication pas à pas de la fonction.
Passons maintenant à l’entraînement du modèle.
Avant d’entraîner un modèle XGBoost, nous devons convertir les jeux de données en DMatrices. Voici le code :
dtrain = xgb.DMatrix(tr[all_feature_names], label=tr[target], enable_categorical=True)
dval = xgb.DMatrix(val[all_feature_names], label=val[target], enable_categorical=True)

dtest = xgb.DMatrix(
   test[all_feature_names], label=test[target], enable_categorical=True
)
dprod = xgb.DMatrix(
   prod[all_feature_names], label=prod[target], enable_categorical=True
)
Voici le code pour entraîner un régressseur avec des hyperparamètres déjà optimisés :
# Define optimized parameters
params = {
   "n_estimators": 10000,
   "learning_rate": 0.1,
   "tree_method": "gpu_hist",
   "max_depth": 6,
   "min_child_weight": 1,
   "gamma": 0,
   "subsample": 0.8,
   "colsample_bytree": 0.8,
   "objective": "reg:squarederror",
   "reg_alpha": 0.01,
   "reg_lambda": 1,
}

# Training with early stopping
regressor = xgb.train(
   params,
   dtrain,
   num_boost_round=10000,
   evals=[(dtrain, "train"), (dval, "eval")],
   early_stopping_rounds=50,
   verbose_eval=500,
)
[0]	train-rmse:3638.77217	eval-rmse:0.00000
[49]	train-rmse:502.61376	eval-rmse:0.00000
Parfait : nous obtenons 503 $ de RMSE sur l’ensemble de validation. Évaluons une dernière fois sur le jeu de test :
from sklearn.metrics import mean_squared_error

# Predict on the test set
y_test_pred = regressor.predict(dtest)

# Evaluate
mean_squared_error(test[target], y_test_pred, squared=False)
551.2763827068798
La performance sur test est de 551 $. Suffisant.
Jusqu’ici, tout est simple. Passons au cœur du sujet : créer les ensembles de référence et d’analyse.
Un ensemble de référence correspond au jeu de test dans le contexte du monitoring. NannyML utilise les performances du modèle sur le test comme base de comparaison pour la production. L’ensemble de référence doit comporter deux colonnes en plus des caractéristiques :
y_test_predActuellement, notre jeu de test contient les caractéristiques et la cible, mais pas y_test_pred :
test.columns  # Ignore the `set` column
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z'],
     dtype='object')
Ajoutons-la :
test["y_pred"] = y_test_predRenommons ensuite le jeu de test en reference :
reference = test.copy(deep=True)

reference.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
À ce stade, imaginons que notre régressseur soit déployé dans le cloud. Imaginer est plus simple que de le déployer réellement, ce qui serait excessif pour cet article.
Après le déploiement du modèle d’estimation des prix, nous apprenons qu’une grosse livraison de diamants arrive. Avant l’arrivée du cargo, les mesures physiques nous sont envoyées sous forme de prod (nous imaginons toujours) afin que nous puissions générer des prix et commencer le marketing sur notre site. Générons-les.
# Generate prices for production data
y_prod_pred = regressor.predict(dprod)
Avant que les diamants n’arrivent et qu’un expert humain ne vérifie les prix générés par notre modèle, nous devons contrôler sa performance. Nous ne voulons pas afficher des prix inexacts sur le site.
Pour cela, il faudrait comparer y_prod_pred aux vrais prix des nouveaux diamants, la vérité terrain. Mais nous ne l’aurons qu’après vérification humaine. Il faut donc estimer la performance sans vérité terrain.
NannyML requiert pour cela un ensemble d’analyse : les données de production avec les prédictions du modèle.
La création est similaire à celle de reference :
# Add the predictions of new diamonds to prod
prod["y_pred"] = y_prod_pred

analysis = prod.copy(deep=True)
analysis.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Nous sommes prêts à estimer la performance du regressor.
NannyML propose deux grands algorithmes pour estimer la performance des modèles de régression et de classification :
Nous allons utiliser l’algorithme DLE pour notre tâche. DLE mesure la performance d’un modèle en production sans vérité terrain et fournit des pseudo-métriques de régression comme RMSE, RMSLE, MAE, etc.
Pour utiliser DLE, il faut d’abord l’ajuster sur reference pour établir une ligne de base.
import nannyml  # pip install nannyml

estimator = nannyml.DLE(
   feature_column_names=all_feature_names,
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)
L’initialisation de DLE nécessite trois paramètres : les noms des colonnes d’entrée, le nom de la colonne contenant la vérité terrain pour le test, et celui de la colonne des prédictions de test.
Nous passons aussi la métrique RMSE et une taille de lot (chunk) de 250. Ajustons l’estimateur sur reference puis estimons sur analysis :
# Fit to the reference set
estimator.fit(reference)

# Estimate on the analysis set
estimated_results = estimator.estimate(analysis)
estimated_results
<nannyml.performance_estimation.direct_loss_estimation.result.Result at 0x7f3954af1c90>
Nous obtenons un objet Result de NannyML que l’on peut tracer. Voyons ce que cela donne :
estimated_results.plot().show()
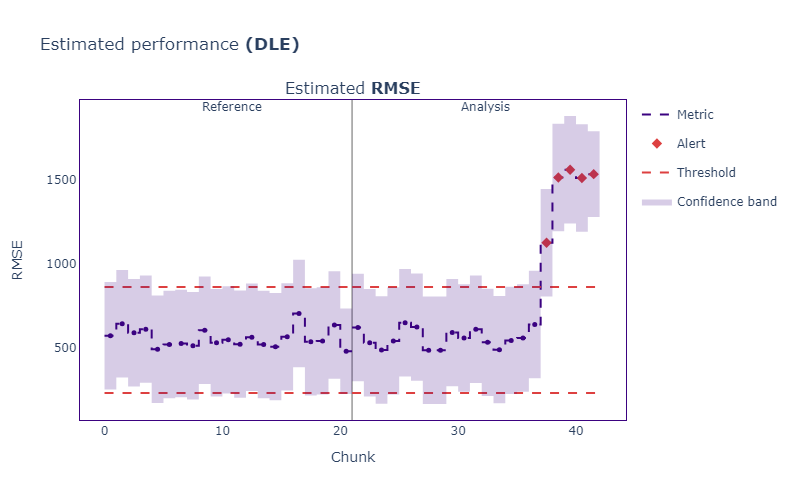
Interprétons le graphique : il comporte deux sections montrant la performance sur les ensembles de référence et d’analyse. Si le RMSE estimé en production dépasse les seuils, NannyML déclenche des alertes.
On observe plusieurs alertes sur les données de production, signe que quelque chose cloche dans les derniers lots.
Notre système de monitoring indique que la performance a chuté de moitié en production. Mais ce n’est qu’une estimation : impossible d’en être certains.
Pendant que nous traçons la performance estimée, la livraison arrive et notre spécialiste évalue les prix réels. Nous les avons enregistrés sous price dans prod.
Nous pouvons maintenant comparer la performance réalisée (effective) à la performance estimée pour juger la qualité de notre monitoring.
NannyML fournit la classe PerformanceCalculator pour cela :
calculator = nannyml.PerformanceCalculator(
   problem_type="regression",
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)

calculator.fit(reference)
realized_results = calculator.calculate(analysis)
La classe requiert quatre paramètres :
problem_type : quel type de tâche ?y_true : où sont les étiquettes ?y_pred : où trouver les prédictions ?metrics : quelles métriques utiliser ?Après l’avoir ajustée sur reference, on calculate sur l’ensemble d’analyse.
Pour comparer realized_results et estimated_results, utilisons une visualisation :
estimated_results.compare(realized_results).plot().show()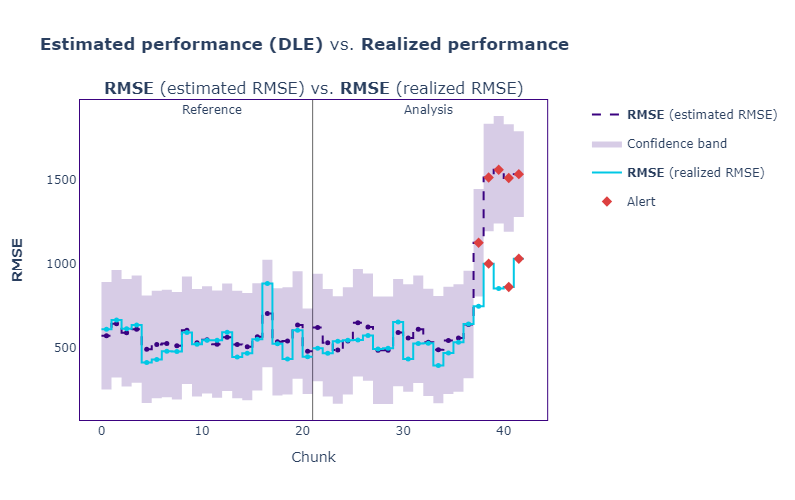
On voit que le RMSE estimé (violet) est très proche de la performance réalisée (bleu).
Conclusion : notre système de monitoring fait bien son travail, mais le modèle se dégrade, comme l’indique la hausse de la perte. Pourquoi ?
Examinons cela.
Comme mentionné en introduction, la dérive est l’une des causes les plus fréquentes d’échec en production. Nous allons nous concentrer ici sur la dérive des données (caractéristiques).
La détection de dérive fait partie de l’analyse des causes racines. Elle commence généralement par une détection multivariée.
L’une des meilleures méthodes multivariées consiste à mesurer l’erreur de reconstruction des données via une ACP (PCA). Elle fonctionne très bien et détecte même de faibles dérives de distribution. Vue d’ensemble :
1. On ajuste la PCA sur reference et on compresse en plus faible dimension : reference_lower.
2. reference_lower est ensuite reconstruite à la dimension initiale : reference_reconstructed.
reference.3. On mesure la différence entre reference et reference_reconstructed, appelée erreur de reconstruction (reconstruct_error).
reconstruct_error sert de référence pour comparer l’erreur de reconstruction en production.4. On applique la même réduction/reconstruction à des lots de données de production.
Ces quatre étapes sont implémentées via la classe DataReconstructionDriftCalculator de NannyML. Utilisation :
# Initialize
multivariate_calc = nannyml.DataReconstructionDriftCalculator(
   column_names=all_feature_names,
   chunk_size=250,
)

# Fit
multivariate_calc.fit(reference)
# Calculate error
multivariate_results = multivariate_calc.calculate(analysis)
Une fois l’erreur calculée pour chaque lot (250 lignes), on peut tracer :
multivariate_results.plot().show()
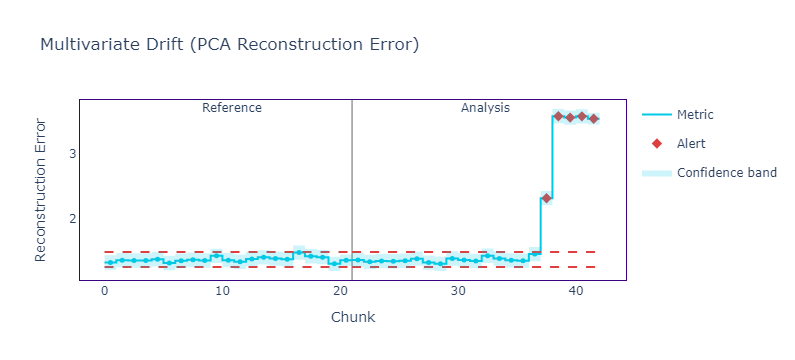
On observe une erreur de reconstruction très élevée, indiquant une dérive des caractéristiques. On peut aussi la comparer à la performance réalisée :
multivariate_results.compare(realized_results).plot().show(config={"staticPlot": True})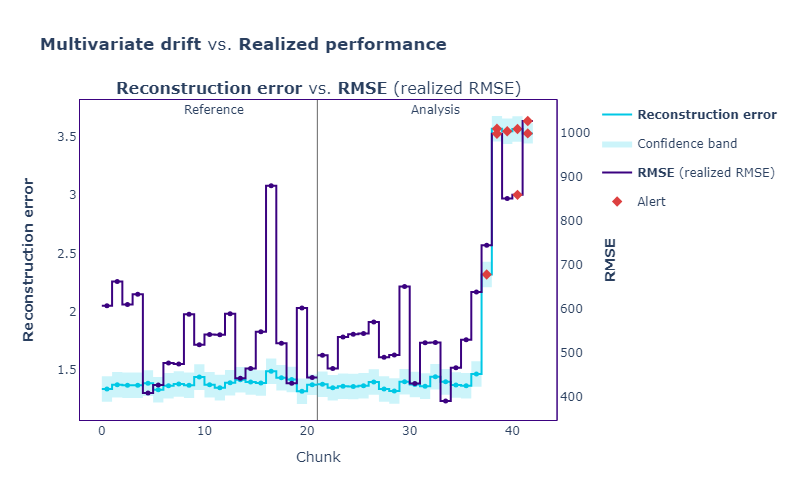
Toutes les pointes de perte correspondent aux alertes d’erreur de reconstruction.
L’erreur de reconstruction donne un indicateur global. Mais qu’en est-il des variables individuelles ? Avec des centaines de caractéristiques, comment identifier celles qui dérivent le plus et agir ?
C’est le rôle des méthodes univariées. NannyML en propose plusieurs selon le type de variable :
Toutes comparent la distribution d’une variable de reference à celle de analysis. On peut en utiliser certaines (ou toutes) via la classe UnivariateDriftCalculator :
univariate_calc = nannyml.UnivariateDriftCalculator(
   column_names=all_feature_names,
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   chunk_size=250,
)

univariate_calc.fit(reference)
univariate_results = univariate_calc.calculate(analysis)
Le seul paramètre requis est column_names, les autres ont des valeurs par défaut. Pour simplifier, nous utilisons wasserstein pour les continues et jensen_shannon pour les catégorielles.
Avec 11 variables, appeler plot().show() n’est pas optimal. À la place, utilisons un classement par nombre d’alertes pour obtenir les variables qui déclenchent le plus d’alertes (tous lots confondus) :
# Initialize the ranker
alert_count_ranker = nannyml.AlertCountRanker()

# Filter the univariate results for only columns containing the metrics
filtered_univariate = univariate_results.filter(
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   only_drifting=False,
)

# Rank the alerts
ranker_results = alert_count_ranker.rank(filtered_univariate)
Une fois les résultats obtenus, affichons l’entête (c’est un DataFrame Pandas) :
ranker_results.head(10)
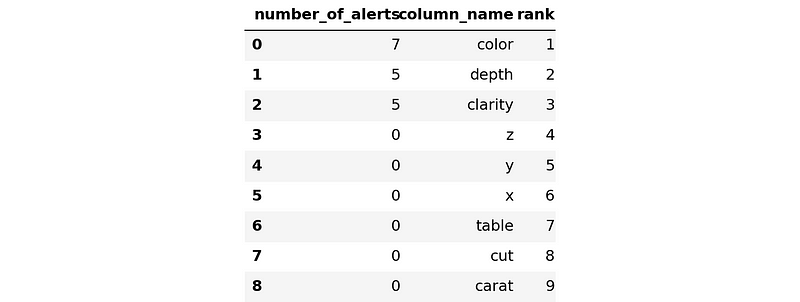
On constate que les variables les plus problématiques sont color et depth. Rien d’étonnant : j’ai moi-même provoqué leur dérive pour les besoins de cet article.
Dans un cas réel, il faudrait consacrer du temps à la remédiation sur ces variables.
La surveillance des modèles est passionnante, car elle balaie l’illusion qu’un bon modèle signe la fin du travail. À mesure que le monde change et que les usages évoluent, aucun modèle ne reste optimal bien longtemps. C’est pourquoi la surveillance fait partie des compétences essentielles de tout ingénieur ML.
Aujourd’hui, nous avons couvert un workflow de base. Nous avons posé les concepts clés, puis plongé dans le code : formatage des données pour NannyML ; premier graphique de performance estimée ; comparaison avec la performance réalisée ; alertes de dégradation ; détection multivariée de dérive ; confirmation de dérive forte ; vérification univariée ; identification des variables en dérive.
Nous nous sommes arrêtés avant la remédiation, dernière étape du workflow, qui dépasse le cadre de cet article. Voici toutefois d’excellentes ressources qui traitent ce sujet et bien d’autres aspects du monitoring :
Ces deux cours sont conçus par la meilleure personne possible : le CEO et fondateur de NannyML. Vous y trouverez de nombreuses pépites à ne pas manquer.
Je vous recommande également la documentation NannyML pour des tutoriels pratiques.
Commencez votre aventure en machine learning dès aujourd’hui !
Cours
Cours
Cours