
Kurs
Machine Learning verstehen
2 Std.
308.6K
Machine-Learning-Projekte sind iterative Vorhaben. Du hörst nicht bei einem erfolgreichen Modell im Jupyter-Notebook auf. Du hörst nicht einmal nach dem Go-live auf, wenn Menschen es nutzen können. Auch nach dem Deployment musst du das Modell im Blick behalten, damit es weiterhin so gut funktioniert wie in der Entwicklungsphase.
Der Zillow-Skandal ist ein perfektes Beispiel dafür, was passiert, wenn man das nicht tut. 2021 verlor Zillow unglaubliche 304 Millionen US-Dollar wegen seines Machine-Learning-Modells zur Schätzung von Immobilienpreisen. Zillow zahlte für mehr als 7000 Häuser zu viel und musste sie später deutlich günstiger wieder verkaufen. Das Unternehmen wurde von seinem eigenen Modell „ausgetrickst“ und musste die Belegschaft um 25% reduzieren.
Solche stillen Modellfehler sind bei realen Systemen häufig. Deshalb müssen Modelle kontinuierlich aktualisiert werden, bevor ihre Performance in Produktion sinkt. Wer das versäumt, schadet seiner Reputation, untergräbt das Vertrauen von Stakeholdern – und am Ende dem eigenen Ergebnis.
Dieser Artikel zeigt dir, wie du mit NannyML einen End-to-End-Workflow implementierst, um ML-Modelle nach dem Deployment zu überwachen.
NannyML ist eine wachsende Open-Source-Bibliothek mit Fokus auf Machine Learning nach dem Deployment. Sie bietet eine Vielzahl an Funktionen, um Probleme in produktiven ML-Umgebungen zu lösen. Zum Beispiel:
Wir schauen uns die technischen Details dieser Funktionen Schritt für Schritt an.
Wir lernen die grundlegenden Konzepte des Modellmonitorings anhand der Analogie eines Roboters, der Bogenschießen meistert.
In unserer Analogie gilt:
Also, los geht’s.
Stell dir vor, wir haben Bogen, Pfeile und Zielscheibe sorgfältig vorbereitet (analog zur Datenaufbereitung). Unser mit Sensoren und Kameras ausgestatteter Roboter schießt im Training 10.000 Mal. Mit der Zeit trifft er erstaunlich häufig ins Schwarze. Wir sind begeistert und beginnen, den Roboter und seine Kopien an Bogenschieß-Fans zu verkaufen (Deployment des Modells).
Kurz darauf prasseln Beschwerden herein. Einige Nutzer melden, dass der Roboter das Ziel völlig verfehlt. Überrascht setzen wir ein Team an, um der Sache auf den Grund zu gehen.
Wir finden einen Klassiker: Data Drift. Die Umgebungen, in denen die Roboter arbeiten, haben sich verändert — andere Windmuster, variierende Luftfeuchtigkeit und sogar veränderte physische Eigenschaften von Pfeilen (Gewicht, Balance) und Bogen.
Diese realen Verschiebungen in den Eingabefeatures haben die Treffsicherheit unseres Roboters beeinträchtigt – ähnlich wie ein ML-Modell schlechter wird, wenn sich Eingabedaten oder vor allem die Beziehungen zwischen Features im Zeitverlauf ändern.
Nachdem wir diese Probleme angegangen sind, bringen wir eine neue Charge Roboter heraus. Doch wenige Wochen später kommen erneut ähnliche Beschwerden. Wir forschen tiefer und entdecken, dass die Zielscheiben von den Nutzern häufig ausgetauscht wurden.
Die neuen Zielscheiben unterscheiden sich in Größe und Entfernung. Diese Änderungen erfordern eine andere Schusstechnik des Roboters — ein typisches Beispiel für Concept Drift.
Im ML-Kontext entsteht Concept Drift, wenn sich die Beziehung zwischen Eingabevariablen und Zielgröße verändert. Für unsere Roboter bedeuten neue Zielscheiben, dass sie ihre Schusstechnik anpassen müssen – genauso wie ein Modell sich anpassen muss, wenn sich die Dynamik der Trainingsdaten wesentlich ändert.
Um die Punkte zu verdeutlichen, schauen wir uns reale Beispiele für Data und Concept Drift an.
Schauen wir uns nun einen End-to-End-Workflow fürs ML-Monitoring an.
Monitoring umfasst drei Hauptschritte, die ML Engineers iterativ durchlaufen sollten.
Der erste Schritt ist, die Modellperformance in Produktion im Auge zu behalten. Das ist leichter gesagt als getan.
Wenn die Ground Truth für ein Produktionsmodell sofort verfügbar ist, lassen sich Verhaltensänderungen leicht erkennen. In unserer Roboter-Analogie sehen Nutzer direkt auf die Zielscheibe und sagen uns, dass der Roboter verfehlt hat — direkte Ground Truth.
Anders beim Beispiel eines Modells, das Kreditausfälle vorhersagt. Solche Modelle prognostizieren monatlich, ob jemand die nächste Rate nicht zahlt. Zur Überprüfung muss man bis zum tatsächlichen Zahlungstermin warten. Das ist ein Beispiel für verzögerte Ground Truth, die in realen ML-Systemen sehr häufig ist.
In solchen Fällen ist es zu teuer, auf die Ground Truth zu warten, nur um zu prüfen, ob das Modell gut läuft. ML Engineers brauchen daher Methoden, um Performance ohne Ground Truth zu schätzen. Hier kommen Algorithmen wie CBPE oder DLE ins Spiel (gleich mehr dazu).
Modelle lassen sich auch über den direkten Business-Impact beobachten, also über KPIs. Im Fall von Zillow hätte ein gutes Monitoring hypothetisch die Gewinnrückgänge erkannt und die Engineers alarmiert.
Wenn das Monitoring einen Performanceeinbruch meldet – egal ob auf Basis realisierter Performance (mit Ground Truth) oder geschätzter Performance (ohne Ground Truth) – müssen ML Engineers die Ursache finden.
Dazu prüfen sie in der Regel einzelne Features oder Feature-Kombinationen auf Data Drift und untersuchen die Targets auf Concept Drift.
Basierend auf den Ergebnissen setzen sie passende Maßnahmen zur Problemlösung ein.
Hier ist eine nicht abschließende Liste von Techniken, um Schäden durch nachlassende Post-Deployment-Performance zu begrenzen:
Welche Methode passt, hängt vom Kontext ab – oft ist eine Kombination sinnvoll.
NannyML deckt die ersten beiden Schritte dieses iterativen Prozesses ab. Los geht’s.
Zusätzlich zu Trainings- und Validierungsset benötigt NannyML zwei weitere Sets in bestimmten Formaten: ein Reference- und ein Analysis-Set. In diesem Abschnitt lernst du, wie du sie aus beliebigen Daten erstellst.
Zuerst brauchen wir ein trainiertes Modell, das für den Einsatz in Produktion bereit ist – damit wir es überwachen können. Dafür nutzen wir den Diamonds-Datensatz und trainieren einen XGBoost-Regressor.
import warnings

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
import xgboost as xgb
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

warnings.filterwarnings("ignore")
Nach dem Import laden wir den Diamonds-Datensatz aus Seaborn. Für diesen Artikel verwenden wir jedoch eine spezielle Version, die ich vorbereitet habe, um Monitoring zu veranschaulichen. Mit dem folgenden Snippet lädst du den Datensatz in deine Umgebung:
dataset_link = "https://raw.githubusercontent.com/BexTuychiev/medium_stories/master/2024/1_january/4_intro_to_nannyml/diamonds_special.csv"

diamonds_special = pd.read_csv(dataset_link)
diamonds_special.head()
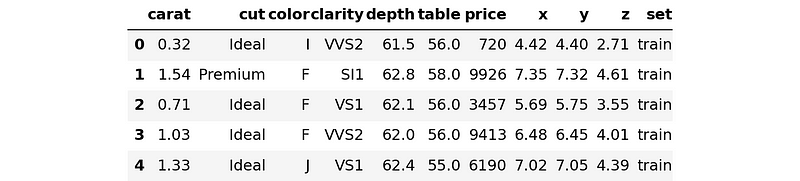
Diese Spezialversion enthält eine Spalte namens „set“, dazu gleich mehr.
Zunächst extrahieren wir alle Featurenamen, die kategorialen Feature-Namen und den Target-Namen:
# Extract all feature names
all_feature_names = diamonds_special.drop(["price", "set"], axis=1).columns.tolist()

# Extract the columns and cast into category
cats = diamonds_special.select_dtypes(exclude=np.number).columns

# Define the target column
target = "price"
Die Aufgabe ist Regression — wir sagen Diamantpreise basierend auf physischen Merkmalen voraus.
Der Diamonds-Datensatz ist recht sauber. Daher wandeln wir lediglich Textfeatures in den Pandas-Datentyp category um. Das ist nötig, um die automatische kategoriale Vorverarbeitung durch XGBoost zu aktivieren.
for col in cats:
   diamonds_special[col] = diamonds_special[col].astype("category")
Weiter geht’s mit dem Split der Daten.
Ja, richtig gelesen: Wir teilen in vier Sets auf. Traditionell nutzt man drei:
Monitoring-Workflows brauchen zusätzlich ein Set, das Produktionsdaten nachbildet. So stellen wir sicher, dass unser System Performanceeinbrüche korrekt erkennt, die passenden Algorithmen nutzt und sauber berichtet.
Dafür habe ich die Zeilen in Diamonds Special über die Spalte set vier Kategorien zugewiesen:
diamonds_special.set.unique()
['train', 'val', 'test', 'prod']
Categories (4, object): ['prod', 'test', 'train', 'val']
Das Trainingsset umfasst 70%, die übrigen drei jeweils 10% der Gesamtdaten. So trennen wir sie:
tr = diamonds_special[diamonds_special.set == "train"].drop("set", axis=1)
val = diamonds_special[diamonds_special.set == "validation"].drop("set", axis=1)
test = diamonds_special[diamonds_special.set == "test"].drop("set", axis=1)
prod = diamonds_special[diamonds_special.set == "prod"].drop("set", axis=1)

tr.shape
(37758, 10)
Reale Datensätze bringen selten eingebaute Set-Labels mit. Du musst daher selbst in vier Sets aufteilen. Diese Funktion erledigt das mit train_test_split aus sklearn:
def split_into_four(df, train_size=0.7):
   """
   A function to split a dataset into four sets:
   - Training
   - Validation
   - Testing
   - Production
   train_size is set by the user.
   The remaining data will be equally divided between the three sets.
   """
   # Do the splits
   training, the_rest = train_test_split(df, train_size=train_size)
   validation, the_rest = train_test_split(the_rest, train_size=1 / 3)
   testing, production = train_test_split(the_rest, train_size=0.5)

   # Reset the indices
   sets = (training, validation, testing, production)
   for set in sets:
       set.reset_index(inplace=True, drop=True)

   return sets


tr, val, test, prod = split_into_four(your_dataset)
Hinweis: Verwende die Schaltfläche „Explain code“, um eine Zeile-für-Zeile-Erklärung der Funktion zu erhalten.
Als Nächstes trainieren wir das Modell.
Bevor wir ein XGBoost-Modell trainieren, müssen wir die Datensätze in DMatrices konvertieren. Hier ist der Code:
dtrain = xgb.DMatrix(tr[all_feature_names], label=tr[target], enable_categorical=True)
dval = xgb.DMatrix(val[all_feature_names], label=val[target], enable_categorical=True)

dtest = xgb.DMatrix(
   test[all_feature_names], label=test[target], enable_categorical=True
)
dprod = xgb.DMatrix(
   prod[all_feature_names], label=prod[target], enable_categorical=True
)
Nun trainieren wir einen Regressor mit bereits abgestimmten Hyperparametern:
# Define optimized parameters
params = {
   "n_estimators": 10000,
   "learning_rate": 0.1,
   "tree_method": "gpu_hist",
   "max_depth": 6,
   "min_child_weight": 1,
   "gamma": 0,
   "subsample": 0.8,
   "colsample_bytree": 0.8,
   "objective": "reg:squarederror",
   "reg_alpha": 0.01,
   "reg_lambda": 1,
}

# Training with early stopping
regressor = xgb.train(
   params,
   dtrain,
   num_boost_round=10000,
   evals=[(dtrain, "train"), (dval, "eval")],
   early_stopping_rounds=50,
   verbose_eval=500,
)
[0]	train-rmse:3638.77217	eval-rmse:0.00000
[49]	train-rmse:502.61376	eval-rmse:0.00000
Super — das Modell erreicht 503$ RMSE auf dem Validierungsset. Prüfen wir zum Abschluss noch das Testset:
from sklearn.metrics import mean_squared_error

# Predict on the test set
y_test_pred = regressor.predict(dtest)

# Evaluate
mean_squared_error(test[target], y_test_pred, squared=False)
551.2763827068798
Die Testleistung liegt bei 551$. Das ist gut genug.
Bis hierhin war alles recht straight. Jetzt kommt der Kern — Reference- und Analysis-Sets erstellen.
Ein Reference-Set ist im Monitoring-Kontext ein anderer Name für das Testset. NannyML nutzt die Test-Performance des Modells als Basislinie für die Produktion. Das Reference-Set braucht zwei zusätzliche Spalten neben den Features:
y_test_pred vorAktuell enthält unser Testset Features und Target, aber keine Spalte y_test_pred:
test.columns  # Ignore the `set` column
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z'],
     dtype='object')
Fügen wir sie hinzu:
test["y_pred"] = y_test_predJetzt benennen wir das Testset in reference um:
reference = test.copy(deep=True)

reference.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Stellen wir uns vor, unser Regressor ist in der Cloud ausgerollt. Vorstellen ist hier einfacher als ein tatsächliches Deployment, das für diesen Artikel übertrieben wäre.
Nach dem Deployment erhalten wir die Nachricht über eine große Diamantenlieferung. Noch bevor die Ware ankommt, bekommen wir die physischen Maße als prod (wir bleiben in der Vorstellung), damit wir Preise generieren und die Steine schon auf der Website bewerben können. Also los:
# Generate prices for production data
y_prod_pred = regressor.predict(dprod)
Bevor die echten Diamanten eintreffen und eine Fachperson die vom Modell generierten Preise prüft, wollen wir sicherstellen, dass das Modell gut performt. Falsche Preise wollen wir nicht auf der Website anzeigen.
Dafür müssten wir die Modellleistung messen, indem wir y_prod_pred mit den tatsächlichen Preisen der neuen Diamanten vergleichen, also der Ground Truth. Die haben wir aber erst nach der Prüfung. Wir müssen die Performance also ohne Ground Truth schätzen.
Dafür braucht NannyML ein Analysis-Set — Produktionsdaten inklusive der vom Modell erzeugten Vorhersagen.
Die Erstellung ähnelt der des reference:
# Add the predictions of new diamonds to prod
prod["y_pred"] = y_prod_pred

analysis = prod.copy(deep=True)
analysis.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Jetzt sind wir bereit, die Performance des regressor zu schätzen.
NannyML bietet zwei zentrale Algorithmen zur Performanceschätzung für Regression und Klassifikation:
Wir nutzen DLE für unsere Aufgabe. DLE kann die Performance eines Produktionsmodells ohne Ground Truth schätzen und Pseudo-Metriken wie RMSE, RMSLE, MAE etc. berichten.
Um DLE zu verwenden, müssen wir es zunächst auf reference fitten, um eine Basislinie zu etablieren.
import nannyml  # pip install nannyml

estimator = nannyml.DLE(
   feature_column_names=all_feature_names,
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)
Beim Initialisieren von DLE gibst du drei zentrale Parameter an: die Eingabefeatures, den Namen der Spalte mit der Ground Truth fürs Testen und den Spaltennamen der Testvorhersagen.
Zusätzlich übergeben wir RMSE als Metrik und eine Chunkgröße von 250. Fitten wir den Estimator auf reference und schätzen auf analysis:
# Fit to the reference set
estimator.fit(reference)

# Estimate on the analysis set
estimated_results = estimator.estimate(analysis)
estimated_results
<nannyml.performance_estimation.direct_loss_estimation.result.Result at 0x7f3954af1c90>
Wir erhalten ein Result-Objekt von NannyML, das sich plotten lässt. Schauen wir uns das an:
estimated_results.plot().show()
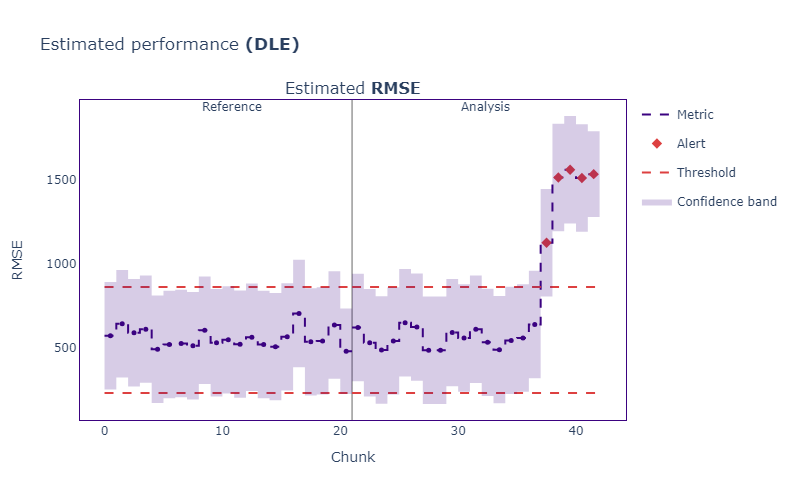
Zur Interpretation: Der Plot hat zwei Bereiche, die die Performance auf Reference- und Analysis-Set zeigen. Steigt die geschätzte Produktions-RMSE über die Schwellwerte, markiert NannyML das als Alert.
Wie zu sehen ist, gibt es mehrere Alerts in den Produktionsdaten – ein Hinweis darauf, dass in den letzten Batches etwas nicht stimmt.
Unser Monitoring sagt, dass die Modellleistung in Produktion etwa um die Hälfte gefallen ist. Aber das ist zunächst nur eine Schätzung — keine Gewissheit.
Während wir die Schätzung plotten, trifft die Lieferung ein und unsere Diamantenspezialistinnen und -spezialisten haben die tatsächlichen Preise ermittelt. Wir haben sie als price in prod gespeichert.
Jetzt können wir die realisierte (tatsächliche) Performance mit der geschätzten vergleichen und prüfen, ob unser Monitoring gut funktioniert.
NannyML stellt dafür die Klasse PerformanceCalculator bereit:
calculator = nannyml.PerformanceCalculator(
   problem_type="regression",
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)

calculator.fit(reference)
realized_results = calculator.calculate(analysis)
Die Klasse benötigt vier Parameter:
problem_type: Welche Aufgabe liegt vor?y_true: Wo stehen die Labels?y_pred: Wo finde ich die Vorhersagen?metrics: Mit welchen Metriken messe ich die Performance?Nach dem Fit auf reference führen wir calculate auf dem Analysis-Set aus.
Zum Vergleich von realized_results und estimated_results nutzen wir wieder eine Visualisierung:
estimated_results.compare(realized_results).plot().show()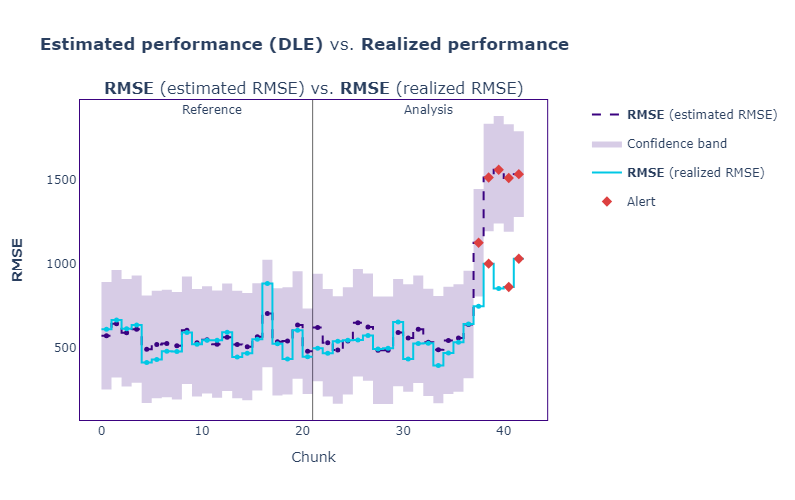
Die geschätzte RMSE (Violett) liegt offenbar nah an der realisierten Performance (Blaue RMSE).
Das sagt uns zweierlei — unser Monitoring funktioniert, aber das Modell nicht, wie der steigende Loss zeigt. Was sind die Gründe?
Genau das sehen wir uns jetzt an.
Wie eingangs erwähnt, ist Drift eine der häufigsten Ursachen für Modellversagen in Produktion. In diesem Abschnitt konzentrieren wir uns auf Data (Feature) Drift.
Drift-Erkennung ist Teil der Ursachenanalyse im Monitoring-Workflow. Üblicherweise beginnt man mit multivariater Drift-Erkennung.
Eine der besten multivariaten Methoden ist die Berechnung des Datenrekonstruktionsfehlers mittels PCA. Das funktioniert bemerkenswert gut und erkennt selbst feine Verschiebungen in Featureverteilungen. High-Level-Ablauf:
1. PCA wird auf reference gefittet und komprimiert die Daten auf eine niedrigere Dimension – reference_lower.
2. reference_lower wird zurück in die ursprüngliche Dimensionalität dekomprimiert – reference_reconstructed.
reference.3. Die Differenz zwischen reference und reference_reconstructed wird als Datenrekonstruktionsfehler – reconstruct_error – bestimmt.
reconstruct_error dient als Basislinie, mit der wir den Rekonstruktionsfehler der Produktionsdaten vergleichen.4. Dasselbe Reduktions-/Rekonstruktionsverfahren wird auf Batches der Produktionsdaten angewendet.
Diese vier Schritte sind in NannyML als DataReconstructionDriftCalculator implementiert. So verwendest du ihn:
# Initialize
multivariate_calc = nannyml.DataReconstructionDriftCalculator(
   column_names=all_feature_names,
   chunk_size=250,
)

# Fit
multivariate_calc.fit(reference)
# Calculate error
multivariate_results = multivariate_calc.calculate(analysis)
Sobald wir den Fehler für jeden Chunk (je 250 Zeilen) haben, können wir ihn plotten:
multivariate_results.plot().show()
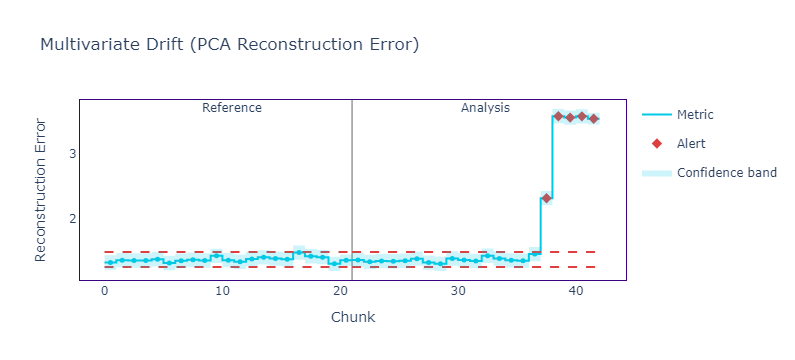
Der Rekonstruktionsfehler ist deutlich erhöht – ein Hinweis auf Feature Drift. Wir können den Fehler auch der realisierten Performance gegenüberstellen:
multivariate_results.compare(realized_results).plot().show(config={"staticPlot": True})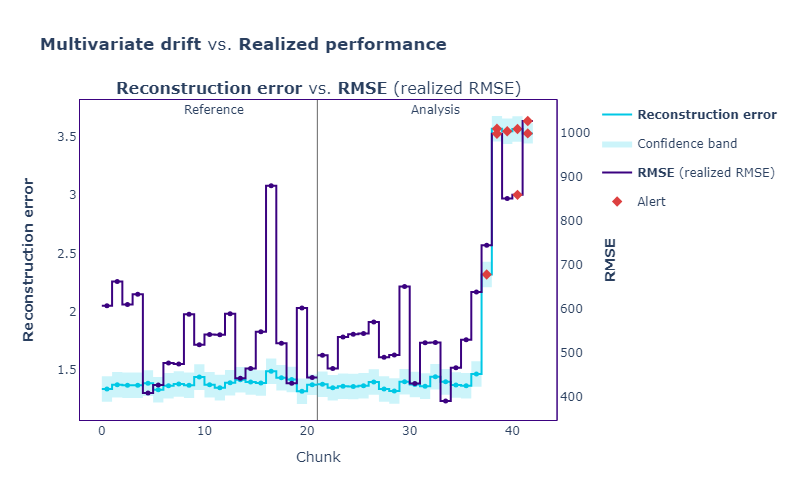
Alle Loss-Spitzen korrespondieren mit Alerts beim Rekonstruktionsfehler.
Der Datenrekonstruktionsfehler ist eine einzige Zahl für den Gesamtdrift über alle Features. Aber wie finden wir driftende Einzel-Features? Bei Hunderten Features müssen wir die auffälligsten finden und gezielt handeln.
Dafür nutzen wir univariate Methoden. NannyML bietet je nach Featuretyp mehrere Ansätze:
Alle vergleichen die Verteilungen einzelner Features im reference- mit denen im analysis-Set. Wir können einige (oder alle) in der Klasse UnivariateDriftCalculator kombinieren:
univariate_calc = nannyml.UnivariateDriftCalculator(
   column_names=all_feature_names,
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   chunk_size=250,
)

univariate_calc.fit(reference)
univariate_results = univariate_calc.calculate(analysis)
Erforderlich ist nur column_names, der Rest kann mit Defaults laufen. Zur Vereinfachung nutzen wir wasserstein und jensen_shannon für kontinuierliche bzw. kategoriale Features.
Mit 11 Features ist plot().show() nicht ideal. Stattdessen nutzen wir einen Alert Count Ranker, der die Features mit den meisten Alerts (über alle Chunks) zurückgibt. So geht’s:
# Initialize the ranker
alert_count_ranker = nannyml.AlertCountRanker()

# Filter the univariate results for only columns containing the metrics
filtered_univariate = univariate_results.filter(
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   only_drifting=False,
)

# Rank the alerts
ranker_results = alert_count_ranker.rank(filtered_univariate)
Die Rankingergebnisse liegen als Pandas DataFrame vor – wir können einfach den Kopf ausgeben:
ranker_results.head(10)
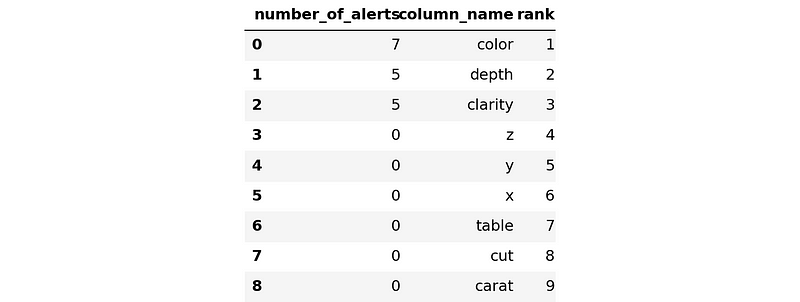
Die größten Problemkinder sind color und depth. Das überrascht mich nicht – ich habe sie vorab künstlich driften lassen.
In einem realen Szenario würdest du jetzt Zeit in die Problemlösung für diese Features investieren.
Monitoring finde ich faszinierend, weil es die Illusion zerstört, Machine Learning sei erledigt, sobald ein Modell gut performt. Die Welt dreht sich weiter und Nutzerverhalten ändert sich – kein Modell bleibt lange relevant. Monitoring gehört deshalb fest in das Skillset jedes ML Engineers.
Heute haben wir einen grundlegenden Monitoring-Workflow behandelt: Wir sind bei den Basis-Konzepten gestartet, sind dann direkt in den Code eingestiegen, haben die Daten NannyML-tauglich aufbereitet; eine erste Visualisierung zur geschätzten Performance erstellt; sie mit der realisierten Performance verglichen; mehrere Alerts für nachlassende Performance erhalten; mit multivariater Drift-Erkennung geprüft; starken Feature Drift gefunden; das mit univariater Drift-Erkennung untermauert; und die driftenden Features identifiziert.
Beim letzten Schritt – der Problemlösung – haben wir aufgehört. Das sprengt den Rahmen dieses Artikels. Hier sind jedoch exzellente Empfehlungen, die diesen Teil und vieles mehr zum Thema Monitoring abdecken:
Beide Kurse stammen vom bestmöglichen Experten – dem CEO und Gründer von NannyML. Darin stecken viele wertvolle Insights, die du nicht verpassen solltest.
Außerdem empfehle ich die NannyML-Dokumentation für praktische Tutorials.
Starte noch heute deine Machine-Learning-Reise!
Kurs
Kurs
Kurs
Tutorial
Aditya Sharma
5 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Satyabrata Pal
15 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Mark Pedigo
10 Min.


