
कोर्स
Understanding Machine Learning
2 घंटा
311.6K
मशीन लर्निंग प्रोजेक्ट्स आवर्तनशील प्रक्रियाएँ होते हैं। आप सिर्फ Jupyter नोटबुक में एक सफल मॉडल पर रुकते नहीं हैं। आप तब भी नहीं रुकते जब मॉडल ऑनलाइन हो जाए और लोग उसे एक्सेस कर सकें। डिप्लॉयमेंट के बाद भी, आपको लगातार उस पर नज़र रखनी होती है ताकि वह विकास चरण जितना ही अच्छा काम करता रहे।
Zillow का कांड इसका एक बेहतरीन उदाहरण है कि अगर आप ऐसा नहीं करते तो क्या होता है। 2021 में, Zillow ने अपने उस मशीन लर्निंग मॉडल के कारण, जो घरों की कीमत का अनुमान लगाता था, चौंकाने वाले 304 मिलियन डॉलर गंवा दिए। Zillow ने 7000 से अधिक घरों के लिए ज़्यादा कीमत चुकाई और उन्हें बहुत कम दाम पर बेचना पड़ा। कंपनी को अपने ही मॉडल ने “नुकसान” पहुंचाया और उसे अपने कार्यबल में 25% की कटौती करनी पड़ी।
ऐसे मौन (साइलेंट) मॉडल फेल्योर वास्तविक दुनिया के मॉडलों में आम हैं, इसलिए उनकी उत्पादन-स्तरीय प्रदर्शन में गिरावट आने से पहले उन्हें लगातार अपडेट करने की ज़रूरत होती है। ऐसा न करने से कंपनियों की साख, हितधारकों का भरोसा और अंततः उनकी कमाई को नुकसान पहुंचता है।
यह लेख आपको दिखाएगा कि NannyML के साथ डिप्लॉयमेंट के बाद मशीन लर्निंग मॉडलों की निगरानी के लिए एक एंड-टू-एंड वर्कफ़्लो कैसे लागू करें।
NannyML एक उभरती हुई ओपन-सोर्स लाइब्रेरी है जो पोस्ट-डिप्लॉयमेंट मशीन लर्निंग पर केंद्रित है। यह प्रोडक्शन ML वातावरण में आने वाली सभी तरह की समस्याओं को हल करने के लिए व्यापक सुविधाएँ प्रदान करती है। कुछ उदाहरण:
हम इन सुविधाओं के तकनीकी पहलुओं को एक-एक करके सीखेंगे।
हम मॉडल मॉनिटरिंग की बुनियादी अवधारणाएँ एक ऐसे रोबोट की मिसाल से समझेंगे जो तीरंदाजी में महारत हासिल कर रहा है।
हमारी मिसाल में:
तो, शुरू करते हैं।
मान लीजिए हमने धनुष, तीर और टार्गेट की बारीकी से तैयारी कर ली है (जैसे डेटा प्रिपरेशन)। हमारा रोबोट, कई सेंसर और कैमरों से लैस, प्रशिक्षण के दौरान 10000 बार तीर चलाता है। समय के साथ, वह प्रभावशाली आवृत्ति से बुल्सआई को भेदने लगता है। हम प्रदर्शन से उत्साहित हैं और अपने रोबोट तथा उसकी प्रतियाँ तीरंदाजी प्रेमियों को बेचना शुरू करते हैं (मॉडल को डिप्लॉय करना)।
लेकिन जल्द ही शिकायतों की बाढ़ आ जाती है। कुछ उपयोगकर्ता बताते हैं कि रोबोट टार्गेट को पूरी तरह मिस कर रहा है। चकित होकर, हम समस्या समझने के लिए टीम इकट्ठा करते हैं।
जो पता चलता है, वह डेटा ड्रिफ्ट का क्लासिक मामला है। जिन वातावरणों में रोबोट काम कर रहे हैं, वे बदल गए हैं—हवा के अलग पैटर्न, आर्द्रता के स्तर में भिन्नता, और तीरों (वज़न, संतुलन) व धनुष की भौतिक विशेषताओं में बदलाव।
इनपुट फीचर्स में यह वास्तविक दुनिया का बदलाव हमारे रोबोट की शुद्धता को डगमगा देता है, ठीक वैसे ही जैसे समय के साथ इनपुट डेटा—खासकर फीचर्स के बीच संबंध—बदलने पर मशीन लर्निंग मॉडल का प्रदर्शन गिर सकता है।
इन मुद्दों को सुलझाने के बाद, हम रोबोट्स का नया बैच जारी करते हैं। फिर भी, कुछ हफ्तों में वैसी ही शिकायतें फिर से आने लगती हैं। उलझन में, हम और गहराई से जाँच करते हैं और पाते हैं कि उपयोगकर्ता बार-बार टार्गेट बदल रहे हैं।
ये नए टार्गेट आकार में अलग हैं और अलग-अलग दूरी पर लगाए जाते हैं। इस बदलाव के कारण रोबोट की शूटिंग तकनीक में अलग दृष्टिकोण की ज़रूरत पड़ती है—कॉन्सेप्ट ड्रिफ्ट का पाठ्यपुस्तकीय उदाहरण।
मशीन लर्निंग की भाषा में, कॉन्सेप्ट ड्रिफ्ट तब होता है जब इनपुट वेरिएबल्स और लक्ष्य परिणाम के बीच संबंध बदल जाता है। हमारे रोबोट्स के लिए, नए तरह के टार्गेट का अर्थ है कि अब उन्हें अलग तरह से निशाना साधने के लिए अनुकूल होना होगा, जैसे किसी मशीन लर्निंग मॉडल को अपने प्रशिक्षण डेटा की गतिशीलता में बड़े बदलाव आने पर समायोजन करना पड़ता है।
बात को पुख्ता करने के लिए, आइए देखें कि वास्तविक दुनिया में डेटा और कॉन्सेप्ट ड्रिफ्ट कैसे होते हैं।
अब, आइए एक एंड-टू-एंड ML मॉनिटरिंग वर्कफ़्लो पर नज़र डालें।
मॉडल मॉनिटरिंग में तीन प्रमुख चरण होते हैं जिन्हें ML इंजीनियरों को आवर्तनशील रूप से अपनाना चाहिए।
पहला कदम है, स्वाभाविक रूप से, डिप्लॉयमेंट में मॉडल के प्रदर्शन पर कड़ी नज़र रखना। पर यह कहना आसान है, करना मुश्किल।
जब प्रोडक्शन में किसी मॉडल के लिए ग्राउंड ट्रुथ तुरंत उपलब्ध हो, तो मॉडल के व्यवहार में बदलाव का पता लगाना आसान होता है। उदाहरण के लिए, हमारे रोबोट/तीरंदाजी की मिसाल में, उपयोगकर्ता तुरंत बता सकते हैं कि क्या गलत है क्योंकि वे टार्गेट को देखकर बता सकते हैं कि रोबोट ने मिस किया—तत्काल ग्राउंड ट्रुथ।
इसके विपरीत, किसी ऐसे मॉडल का उदाहरण लें जो ऋण चूक का पूर्वानुमान लगाता है। ऐसे मॉडल हर महीने यह भविष्यवाणी करते हैं कि उपयोगकर्ता अगली किस्त चूकेंगे या नहीं। भविष्यवाणी सत्यापित करने के लिए, मॉडल को वास्तविक भुगतान तिथि तक इंतज़ार करना पड़ता है। यह विलंबित ग्राउंड ट्रुथ का उदाहरण है, जो वास्तविक दुनिया के अधिकांश ML सिस्टमों में आम है।
ऐसे मामलों में, यह देखने के लिए कि मॉडल अच्छा कर रहे हैं या नहीं, ग्राउंड ट्रुथ का इंतज़ार करना बहुत महंगा पड़ता है। इसलिए, ML इंजीनियरों को बिना ग्राउंड ट्रुथ के प्रदर्शन का अनुमान लगाने के तरीके चाहिए। यहीं CBPE या DLE जैसे एल्गोरिद्म काम आते हैं (आगे और विवरण)।
मॉडलों की निगरानी सीधे व्यावसायिक प्रभाव को मापकर भी की जा सकती है, यानी KPI (मुख्य प्रदर्शन संकेतक) ट्रैक करके। Zillow के मामले में, एक उचित मॉनिटरिंग सिस्टम लाभ में गिरावट का पता लगा सकता था और इंजीनियरों को अलर्ट कर सकता था (काल्पनिक रूप से)।
यदि मॉनिटरिंग सिस्टम प्रदर्शन में गिरावट का पता लगाता है—चाहे उसने साकार (ग्राउंड ट्रुथ सहित) या अनुमानित (बिना ग्राउंड ट्रुथ) प्रदर्शन का विश्लेषण किया हो—तो ML इंजीनियरों को गिरावट के पीछे का कारण पहचानना चाहिए।
यह आमतौर पर फीचर्स को अलग-अलग या संयोजन में डेटा (फीचर ड्रिफ्ट) के लिए जाँचना और लक्ष्यों को कॉन्सेप्ट ड्रिफ्ट के लिए परखना शामिल करता है।
अपने निष्कर्षों के आधार पर, वे विभिन्न समाधान तकनीकों का प्रयोग करते हैं।
डिप्लॉयमेंट के बाद प्रदर्शन में गिरावट से होने वाले नुकसान को कम करने के लिए तकनीकों की एक आंशिक सूची:
हर विधि का अपना संदर्भ होता है, और अक्सर आपको इनमें से कई का संयोजन लागू करना पड़ सकता है।
NannyML इस आवर्तनशील प्रक्रिया के पहले दो चरणों से निपटता है। तो, शुरू करते हैं।
ट्रेनिंग और वैलिडेशन सेट्स के अलावा, NannyML को मॉनिटरिंग शुरू करने के लिए विशेष फ़ॉर्मैट में संदर्भ (reference) और विश्लेषण (analysis) नाम के दो अतिरिक्त सेट चाहिए। इस खंड में आप सीखेंगे कि उन्हें किसी भी डेटा से कैसे बनाया जाए।
पहले, हमें एक ऐसा मॉडल चाहिए जो पहले से प्रशिक्षित हो और प्रोडक्शन में डिप्लॉय होने के लिए तैयार हो ताकि हम उसकी निगरानी कर सकें। इस उद्देश्य से, हम डायमंड्स डेटासेट का उपयोग करेंगे और एक XGBoost रिग्रेसर प्रशिक्षित करेंगे।
import warnings

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
import xgboost as xgb
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

warnings.filterwarnings("ignore")
मॉड्यूल इम्पोर्ट करने के बाद पहला कदम Seaborn से डायमंड्स डेटासेट लोड करना है। हालाँकि, हम डेटासेट का एक विशेष संस्करण इस्तेमाल करेंगे जिसे मैंने खासतौर पर इस लेख के लिए तैयार किया है ताकि मॉनिटरिंग कैसी दिखती है, यह समझाया जा सके। आप नीचे दिए गए स्निपेट से अपना डेटासेट लोड कर सकते हैं:
dataset_link = "https://raw.githubusercontent.com/BexTuychiev/medium_stories/master/2024/1_january/4_intro_to_nannyml/diamonds_special.csv"

diamonds_special = pd.read_csv(dataset_link)
diamonds_special.head()
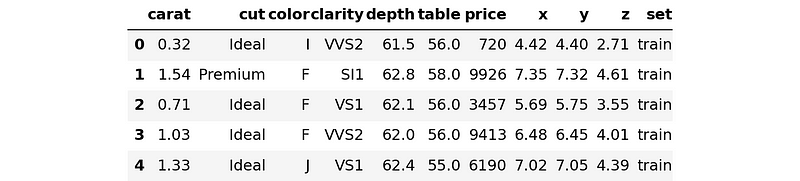
डेटासेट के इस विशेष संस्करण में “set” नाम का एक कॉलम है, जिस पर हम अभी आते हैं।
फिलहाल, हम सभी फीचर नाम, श्रेणीबद्ध फीचर्स के नाम और टार्गेट का नाम निकालेंगे:
# Extract all feature names
all_feature_names = diamonds_special.drop(["price", "set"], axis=1).columns.tolist()

# Extract the columns and cast into category
cats = diamonds_special.select_dtypes(exclude=np.number).columns

# Define the target column
target = "price"
कार्य रिग्रेशन है—हम भौतिक गुणों के आधार पर हीरों की कीमतें भविष्यवाणी करेंगे।
डायमंड्स डेटासेट काफ़ी साफ-सुथरा है। इसलिए, हम केवल इतना प्रीप्रोसेसिंग करेंगे कि टेक्स्ट फीचर्स को Pandas के category डेटा टाइप में कास्ट कर दें। यह XGBoost द्वारा स्वचालित श्रेणीबद्ध डेटा प्रीप्रोसेसिंग सक्षम करने की आवश्यक शर्त है।
for col in cats:
   diamonds_special[col] = diamonds_special[col].astype("category")
अब डेटा को विभाजित करते हैं।
जी हाँ, आपने सही पढ़ा। हम डेटा को चार सेट में बाँटेंगे। परंपरागत रूप से, आप इसे सिर्फ तीन में बाँटते रहे होंगे:
मॉडल मॉनिटरिंग वर्कफ़्लो के लिए प्रोडक्शन डेटा की नकल करने के लिए एक और सेट चाहिए। इससे सुनिश्चित होता है कि हमारा सिस्टम सही एल्गोरिद्म का उपयोग करके प्रदर्शन में गिरावट को ठीक से पकड़े और बताए कि क्या गलत हुआ।
इसके लिए, मैंने डायमंड्स स्पेशल की पंक्तियों को set कॉलम में चार श्रेणियों से लेबल किया है:
diamonds_special.set.unique()
['train', 'val', 'test', 'prod']
Categories (4, object): ['prod', 'test', 'train', 'val']
ट्रेनिंग सेट 70% है, जबकि बाकी तीनों प्रत्येक 10% हैं। चलिए बाँटते हैं:
tr = diamonds_special[diamonds_special.set == "train"].drop("set", axis=1)
val = diamonds_special[diamonds_special.set == "validation"].drop("set", axis=1)
test = diamonds_special[diamonds_special.set == "test"].drop("set", axis=1)
prod = diamonds_special[diamonds_special.set == "prod"].drop("set", axis=1)

tr.shape
(37758, 10)
लेकिन वास्तविक दुनिया के डेटासेट्स में अंतर्निहित सेट लेबल नहीं आते, इसलिए आपको डेटा को खुद ही चार सेट में बाँटना होता है। यहाँ sklearn के train_test_split का उपयोग करके ऐसा करने का एक फ़ंक्शन है:
def split_into_four(df, train_size=0.7):
   """
   A function to split a dataset into four sets:
   - Training
   - Validation
   - Testing
   - Production
   train_size is set by the user.
   The remaining data will be equally divided between the three sets.
   """
   # Do the splits
   training, the_rest = train_test_split(df, train_size=train_size)
   validation, the_rest = train_test_split(the_rest, train_size=1 / 3)
   testing, production = train_test_split(the_rest, train_size=0.5)

   # Reset the indices
   sets = (training, validation, testing, production)
   for set in sets:
       set.reset_index(inplace=True, drop=True)

   return sets


tr, val, test, prod = split_into_four(your_dataset)
ध्यान दें: फ़ंक्शन की लाइन-दर-लाइन व्याख्या के लिए “Explain code” बटन का उपयोग करें।
अब, मॉडल प्रशिक्षण पर बढ़ते हैं।
XGBoost मॉडल को प्रशिक्षित करने से पहले, हमें डेटासेट्स को DMatrix में बदलना होगा। कोड इस प्रकार है:
dtrain = xgb.DMatrix(tr[all_feature_names], label=tr[target], enable_categorical=True)
dval = xgb.DMatrix(val[all_feature_names], label=val[target], enable_categorical=True)

dtest = xgb.DMatrix(
   test[all_feature_names], label=test[target], enable_categorical=True
)
dprod = xgb.DMatrix(
   prod[all_feature_names], label=prod[target], enable_categorical=True
)
अब, पहले से ट्यून किए गए हाइपरपैरामीटर्स के साथ रिग्रेसर ट्रेन करने का कोड:
# Define optimized parameters
params = {
   "n_estimators": 10000,
   "learning_rate": 0.1,
   "tree_method": "gpu_hist",
   "max_depth": 6,
   "min_child_weight": 1,
   "gamma": 0,
   "subsample": 0.8,
   "colsample_bytree": 0.8,
   "objective": "reg:squarederror",
   "reg_alpha": 0.01,
   "reg_lambda": 1,
}

# Training with early stopping
regressor = xgb.train(
   params,
   dtrain,
   num_boost_round=10000,
   evals=[(dtrain, "train"), (dval, "eval")],
   early_stopping_rounds=50,
   verbose_eval=500,
)
[0]	train-rmse:3638.77217	eval-rmse:0.00000
[49]	train-rmse:502.61376	eval-rmse:0.00000
उत्तम—हमारे मॉडल ने वैलिडेशन सेट पर RMSE के रूप में 503$ हासिल किया है। अब मॉडल का एक अंतिम बार टेस्ट सेट पर मूल्यांकन करते हैं:
from sklearn.metrics import mean_squared_error

# Predict on the test set
y_test_pred = regressor.predict(dtest)

# Evaluate
mean_squared_error(test[target], y_test_pred, squared=False)
551.2763827068798
टेस्टिंग प्रदर्शन 551$ है। यह पर्याप्त अच्छा है।
अब तक सब काफ़ी सीधा था। अब आते हैं मुख्य हिस्से पर—रिफ़रेंस और एनालिसिस सेट बनाना।
रिफ़रेंस सेट, मॉडल मॉनिटरिंग संदर्भ में टेस्ट सेट का ही दूसरा नाम है। NannyML टेस्ट सेट पर मॉडल के प्रदर्शन का उपयोग प्रोडक्शन प्रदर्शन के बेंचमार्क के रूप में करता है। रिफ़रेंस सेट में फीचर्स के अलावा दो कॉलम होने चाहिए:
y_test_pred में जनरेट की हैंइस समय, हमारे टेस्ट सेट में फीचर्स और टार्गेट तो हैं, लेकिन y_test_pred नहीं है:
test.columns  # Ignore the `set` column
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z'],
     dtype='object')
इसे जोड़ते हैं:
test["y_pred"] = y_test_predअब हम टेस्ट सेट का नाम reference रख देंगे:
reference = test.copy(deep=True)

reference.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
इस बिंदु पर, मान लेते हैं कि हमारा रिग्रेसर क्लाउड में डिप्लॉय हो चुका है। कल्पना करना वास्तव में डिप्लॉय करने से सरल है, जो इस लेख के लिए ज़रूरत से ज़्यादा होगा।
हमारे डायमंड प्राइसिंग मॉडल के डिप्लॉय होने के बाद, हमें खबर मिलती है कि हीरों की बड़ी खेप आ रही है। माल के पहुँचने से पहले, हीरों के भौतिक माप हमें prod के रूप में भेज दिए गए हैं (हम अभी भी कल्पना कर रहे हैं) ताकि हम उनके लिए कीमतें जनरेट कर सकें और अपनी वेबसाइट पर मार्केटिंग शुरू कर सकें। तो, चलिए जनरेट करते हैं।
# Generate prices for production data
y_prod_pred = regressor.predict(dprod)
वास्तविक हीरे आने से पहले और कोई विशेषज्ञ हमारे मॉडल द्वारा जनरेट की गई कीमतों की पुष्टि करने से पहले, हमें जाँचना होगा कि हमारा मॉडल अच्छा प्रदर्शन कर रहा है या नहीं। हम अपनी वेबसाइट पर गलत कीमतों के साथ हीरे नहीं दिखाना चाहते।
इसके लिए, हमें मॉडल के प्रदर्शन को y_prod_pred की तुलना नए हीरों की वास्तविक कीमतों, यानी ग्राउंड ट्रुथ, से करनी होगी। लेकिन ग्राउंड ट्रुथ तब तक नहीं होगा जब तक कीमतें सत्यापित न हो जाएँ। इसलिए, हमें बिना ग्राउंड ट्रुथ के मॉडल के प्रदर्शन का अनुमान लगाना होगा।
यह कार्य करने के लिए, NannyML को एनालिसिस सेट चाहिए—वह डेटा जिसमें प्रोडक्शन डेटा और मॉडल द्वारा की गई प्रेडिक्शन्स हों।
एनालिसिस सेट बनाना reference बनाने जैसा ही है:
# Add the predictions of new diamonds to prod
prod["y_pred"] = y_prod_pred

analysis = prod.copy(deep=True)
analysis.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
अब, हम regressor के प्रदर्शन का अनुमान लगाने के लिए तैयार हैं।
NannyML रिग्रेशन और क्लासिफ़िकेशन मॉडलों के प्रदर्शन का अनुमान लगाने के लिए दो प्रमुख एल्गोरिद्म प्रदान करता है:
हम अपने कार्य के लिए DLE एल्गोरिद्म का उपयोग करेंगे। DLE बिना ग्राउंड ट्रुथ के प्रोडक्शन मॉडल के प्रदर्शन को माप सकता है और RMSE, RMSLE, MAE आदि जैसे विभिन्न रिग्रेशन स्यूडो-मीट्रिक्स रिपोर्ट कर सकता है।
DLE का उपयोग करने के लिए, हमें पहले reference पर इसे फिट करना होगा ताकि एक बेंचमार्क प्रदर्शन स्थापित हो सके।
import nannyml  # pip install nannyml

estimator = nannyml.DLE(
   feature_column_names=all_feature_names,
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)
DLE को इनिशियलाइज़ करने के लिए तीन पैरामीटर जरूरी हैं—इनपुट फीचर नाम, टेस्टिंग के लिए ग्राउंड ट्रुथ वाले कॉलम का नाम, और टेस्टिंग प्रेडिक्शन्स वाले कॉलम का नाम।
इसके अलावा, हम RMSE को मीट्रिक और 250 की चंक साइज भी दे रहे हैं। अब estimator को reference पर फिट करते हैं और analysis पर प्रदर्शन का अनुमान लगाते हैं:
# Fit to the reference set
estimator.fit(reference)

# Estimate on the analysis set
estimated_results = estimator.estimate(analysis)
estimated_results
<nannyml.performance_estimation.direct_loss_estimation.result.Result at 0x7f3954af1c90>
हमारे पास NannyML का एक Result ऑब्जेक्ट है जिसे प्लॉट किया जा सकता है। देखते हैं यह क्या दिखाता है:
estimated_results.plot().show()
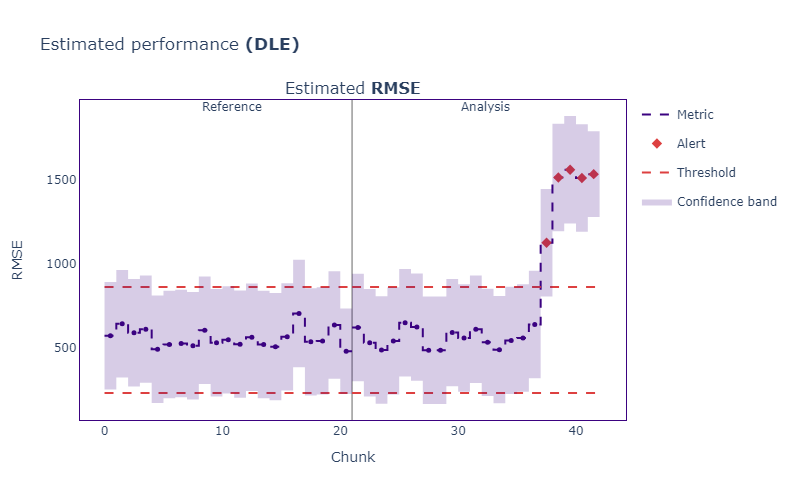
प्लॉट की व्याख्या करते हैं—इसमें दो हिस्से हैं जो रिफ़रेंस और एनालिसिस सेट्स पर प्रदर्शन दिखाते हैं। यदि अनुमानित प्रोडक्शन RMSE सीमा से ऊपर चला जाता है, तो NannyML उन्हें अलर्ट के रूप में चिह्नित करता है।
जैसा कि दिख रहा है, प्रोडक्शन डेटा के लिए कुछ अलर्ट हैं, जो बताते हैं कि आख़िरी बैचों में कुछ गड़बड़ चल रही है।
हमारा मॉनिटरिंग सिस्टम हमें बताता है कि प्रोडक्शन में मॉडल का प्रदर्शन लगभग आधा गिर गया है। पर यह सिर्फ एक अनुमान है—हम इसे पक्के तौर पर नहीं कह सकते।
जब हम अनुमानित प्रदर्शन का प्लॉट बना रहे थे, तब तक भेजाव आ चुका है और हमारे डायमंड विशेषज्ञ ने उनकी वास्तविक कीमतें निकाल दी हैं। हमने उन्हें prod में price के रूप में सहेज दिया है।
अब, हम मॉडल के साकार (वास्तविक) प्रदर्शन की तुलना अनुमानित प्रदर्शन से कर सकते हैं ताकि देखें कि हमारा मॉनिटरिंग सिस्टम ठीक काम कर रहा है या नहीं।
NannyML इसके लिए PerformanceCalculator क्लास देता है:
calculator = nannyml.PerformanceCalculator(
   problem_type="regression",
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)

calculator.fit(reference)
realized_results = calculator.calculate(analysis)
क्लास को चार पैरामीटर चाहिए:
problem_type: कार्य क्या है?y_true: लेबल्स क्या हैं?y_pred: प्रेडिक्शन्स कहाँ मिलेंगे?metrics: प्रदर्शन मापने के लिए कौन-सी मीट्रिक्स उपयोग हों?इन्हें पास करने और reference पर फिट करने के बाद, हम एनालिसिस सेट पर calculate करते हैं।
realized_results की तुलना estimated_results से करने के लिए, फिर से एक विज़ुअल का उपयोग करते हैं:
estimated_results.compare(realized_results).plot().show()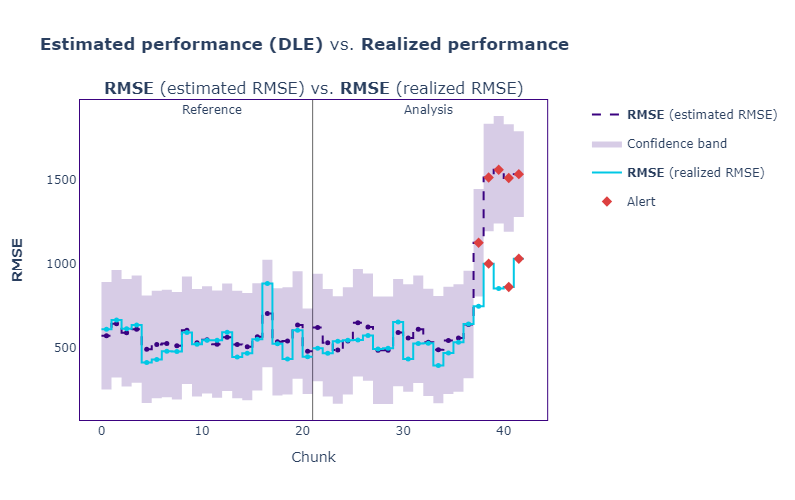
लगता है अनुमानित RMSE (बैंगनी) वास्तविक प्रदर्शन (साकार RMSE, नीला) के काफ़ी करीब था।
यह एक बात बताता है—हमारा मॉनिटरिंग सिस्टम ठीक काम कर रहा है, लेकिन हमारा मॉडल नहीं, जैसा कि बढ़ते लॉस से संकेत मिलता है। तो, इसकी वजह/वजहें क्या हैं?
अब हम इसमें उतरेंगे।
जैसा कि परिचय में बताया गया, प्रोडक्शन में मॉडलों के फेल होने के आम कारणों में से एक ड्रिफ्ट है। इस खंड में, हम डेटा (फ़ीचर) ड्रिफ्ट डिटेक्शन पर ध्यान देंगे।
ड्रिफ्ट डिटेक्शन मॉडल मॉनिटरिंग वर्कफ़्लो के मूल कारण विश्लेषण चरण का हिस्सा है। यह आमतौर पर मल्टीवेरिएट ड्रिफ्ट डिटेक्शन से शुरू होता है।
सर्वश्रेष्ठ मल्टीवेरिएट ड्रिफ्ट डिटेक्शन तरीकों में से एक है PCA का उपयोग करके डेटा रिकंस्ट्रक्शन एरर निकालना। यह उल्लेखनीय रूप से अच्छा काम करता है और फीचर वितरणों में मामूली से मामूली ड्रिफ्ट भी पकड़ सकता है। इस विधि का उच्च-स्तरीय अवलोकन:
1. PCA को reference पर फिट किया जाता है और उसे कम-आयाम में संपीड़ित किया जाता है - reference_lower।
2. फिर reference_lower को उसके मूल आयाम में डिकंप्रेस किया जाता है - reference_reconstructed।
reference जैसा बिल्कुल नहीं होगा।3. reference और reference_reconstructed के बीच अंतर निकाला जाता है और उसे डेटा रिकंस्ट्रक्शन एरर - reconstruct_error कहा जाता है।
reconstruct_error प्रोडक्शन डेटा के रिकंस्ट्रक्शन एरर की तुलना करने के लिए बेंचमार्क का काम करता है।4. यही रिडक्शन/रिकंस्ट्रक्शन विधि प्रोडक्शन डेटा के बैचों पर लागू की जाती है।
इन चार चरणों को NannyML में DataReconstructionDriftCalculator क्लास के रूप में लागू किया गया है। इसका उपयोग इस प्रकार करें:
# Initialize
multivariate_calc = nannyml.DataReconstructionDriftCalculator(
   column_names=all_feature_names,
   chunk_size=250,
)

# Fit
multivariate_calc.fit(reference)
# Calculate error
multivariate_results = multivariate_calc.calculate(analysis)
जब हमारे पास हर चंक (प्रत्येक 250 पंक्तियाँ) के लिए एरर आ जाए, तो उसे प्लॉट कर सकते हैं:
multivariate_results.plot().show()
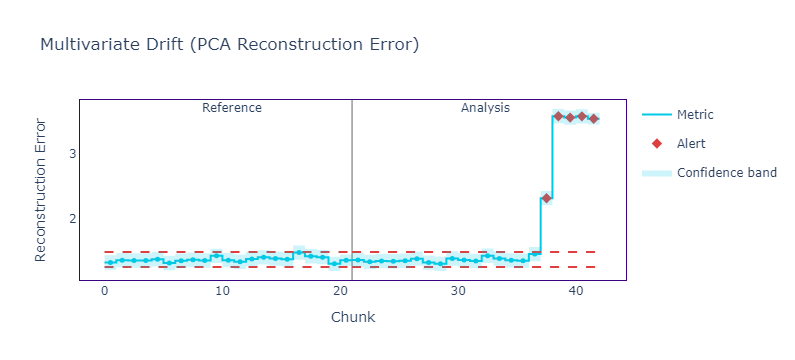
जैसा कि दिख रहा है, रिकंस्ट्रक्शन एरर बहुत अधिक है, जो फीचर्स में ड्रिफ्ट का संकेत देता है। हम एरर की तुलना साकार प्रदर्शन से भी कर सकते हैं:
multivariate_results.compare(realized_results).plot().show(config={"staticPlot": True})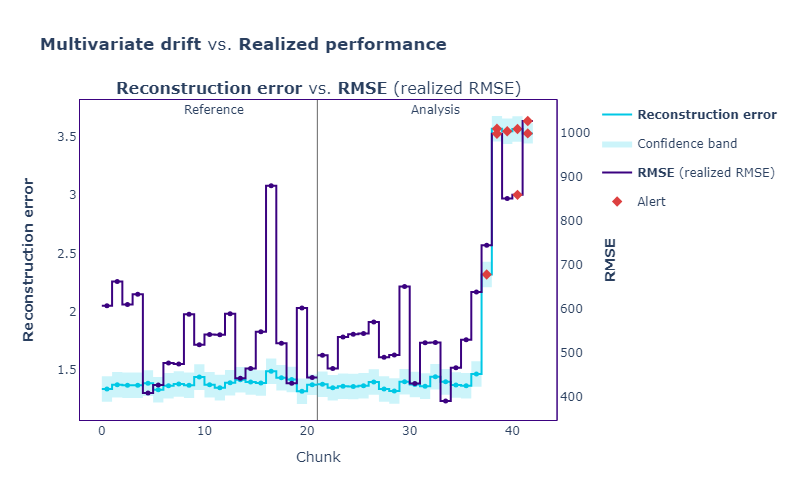
दिख रहा है कि लॉस में सभी उछाल रिकंस्ट्रक्शन एरर में अलर्ट के अनुरूप हैं।
डेटा रिकंस्ट्रक्शन एरर सभी फीचर्स के लिए ड्रिफ्ट मापने की एक एकल संख्या देता है। पर व्यक्तिगत फीचर्स के ड्रिफ्ट का क्या? यदि हमारे डेटासेट में सैकड़ों फीचर्स हों, तो हम सबसे अधिक ड्रिफ्ट करने वाले फीचर्स कैसे ढूँढें और उचित कदम कैसे उठाएँ?
यहीं यूनिवेरिएट ड्रिफ्ट डिटेक्शन विधियाँ काम आती हैं। NannyML फीचर के प्रकार के अनुसार कई विधियाँ देता है:
ये सभी reference में व्यक्तिगत फीचर्स के वितरण की तुलना analysis सेट के वितरण से करते हैं। हम UnivariateDriftCalculator क्लास में इनमें से कुछ (या सभी) का उपयोग कर सकते हैं:
univariate_calc = nannyml.UnivariateDriftCalculator(
   column_names=all_feature_names,
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   chunk_size=250,
)

univariate_calc.fit(reference)
univariate_results = univariate_calc.calculate(analysis)
केवल आवश्यक पैरामीटर column_names है, बाकी NannyML के डिफ़ॉल्ट्स ले सकते हैं। लेकिन सरल रखने के लिए, हम निरंतर के लिए wasserstein और श्रेणीबद्ध के लिए jensen_shannon उपयोग कर रहे हैं।
इस समय हमारे पास 11 फीचर्स हैं, इसलिए सीधे plot().show() कॉल करना बेहतरीन परिणाम नहीं देगा। इसके बजाय, हम अलर्ट काउंट रैंकर का उपयोग कर सकते हैं जो (सभी चंक्स को ध्यान में रखकर) सबसे ज़्यादा अलर्ट देने वाले फीचर्स लौटाएगा। कोड:
# Initialize the ranker
alert_count_ranker = nannyml.AlertCountRanker()

# Filter the univariate results for only columns containing the metrics
filtered_univariate = univariate_results.filter(
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   only_drifting=False,
)

# Rank the alerts
ranker_results = alert_count_ranker.rank(filtered_univariate)
रैंकर के परिणाम मिलने के बाद, हम इसका हेड प्रिंट कर सकते हैं क्योंकि यह एक Pandas DataFrame है:
ranker_results.head(10)
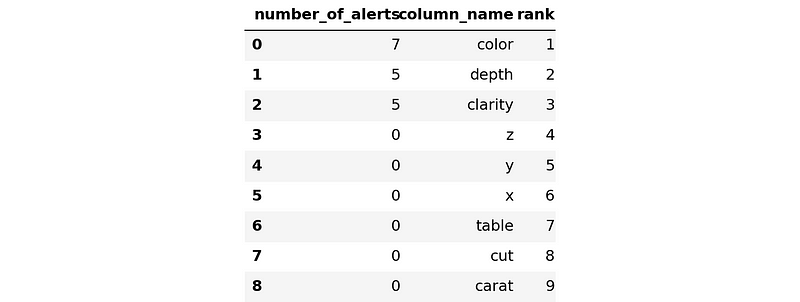
हम देखते हैं कि सबसे समस्या पैदा करने वाले फीचर्स color और depth हैं। यह मुझे चौंकाना नहीं चाहिए क्योंकि लेख लिखने से पहले इन में ड्रिफ्ट मैंने ही कृत्रिम रूप से डाला था।
पर यदि यह वास्तविक दुनिया की स्थिति होती, तो आप इन फीचर्स के लिए समस्या-समाधान पर समय लगाना चाहेंगे।
मुझे मॉडल मॉनिटरिंग रोचक लगती है क्योंकि यह इस भ्रम को तोड़ती है कि एक अच्छा मॉडल बनते ही मशीन लर्निंग का काम समाप्त हो जाता है। जैसे-जैसे पृथ्वी घूमती है और उपयोगकर्ता के पैटर्न बदलते हैं, कोई भी मॉडल लंबे समय तक प्रासंगिक नहीं रहता। यही बात मॉडल मॉनिटरिंग को किसी भी ML इंजीनियर के कौशल-सेट का अहम हिस्सा बनाती है।
आज, हमने एक बुनियादी मॉडल मॉनिटरिंग वर्कफ़्लो कवर किया। हमने मूल मॉनिटरिंग अवधारणाओं से बात शुरू की। फिर सीधे कोड में उतरे: डेटा को NannyML संगत फ़ॉर्मैट में ढाला; अनुमानित मॉडल प्रदर्शन के लिए पहला प्लॉट बनाया; उसे साकार प्रदर्शन से तुलना करने के लिए दूसरा प्लॉट बनाया; प्रदर्शन गिरने के कुछ अलर्ट मिले; मल्टीवेरिएट ड्रिफ्ट डिटेक्शन से जाँचा; भारी फीचर ड्रिफ्ट मिली; व्यक्तिगत फीचर ड्रिफ्ट डिटेक्शन से डबल-चेक किया; ड्रिफ्ट करने वाले फीचर्स पहचाने।
दुर्भाग्य से, हम समस्या-समाधान के ठीक पहले रुक गए। मॉनिटरिंग वर्कफ़्लो का वह अंतिम चरण इस लेख के दायरे से बाहर है। फिर भी, मेरे पास कुछ उत्कृष्ट सिफारिशें हैं जो इसे और मॉडल मॉनिटरिंग से जुड़ी कई और चीज़ों को कवर करती हैं:
ये दोनों कोर्स उस व्यक्ति ने बनाए हैं जो इस विषय के लिए सबसे उपयुक्त हैं—NannyML के CEO और संस्थापक। कोर्स में ऐसी कई जानकारी के मोती हैं जिन्हें आप मिस नहीं कर सकते।
मैं NannyML डॉक्यूमेंटेशन पढ़ने की भी सिफारिश करता हूँ, जहाँ कुछ हैंड्स-ऑन ट्यूटोरियल मिलेंगे।
आज ही अपनी मशीन लर्निंग यात्रा शुरू करें!
कोर्स
कोर्स
कोर्स