
Last chance! 50% off DataCamp Premium
Sale ends in
Machinelearningprojecten zijn iteratieve processen. Je stopt niet bij een succesvol model in een Jupyter-notebook. Je stopt zelfs niet nadat het model online staat en mensen er toegang toe hebben. Ook na de uitrol moet je het constant in de gaten houden zodat het net zo goed blijft werken als tijdens de ontwikkelfase.
Het schandaal van Zillow is een perfect voorbeeld van wat er gebeurt als je dat niet doet. In 2021 verloor Zillow maar liefst 304 miljoen dollar door hun machinelearningmodel dat huizenprijzen schatte. Zillow betaalde te veel voor meer dan 7000 huizen en moest die vervolgens voor een veel lagere prijs verkopen. Het bedrijf werd door zijn eigen model “gepakt” en moest zijn personeelsbestand met 25% inkrimpen.
Dit soort stille modelfouten komt vaak voor bij modellen in de echte wereld, dus moeten ze voortdurend worden bijgewerkt voordat hun performance in productie daalt. Als je dat nalaat, schaadt dat de reputatie van bedrijven, het vertrouwen van stakeholders en uiteindelijk hun portemonnee.
Dit artikel leert je hoe je met NannyML een end-to-end workflow implementeert om machinelearningmodellen na uitrol te monitoren.
NannyML is een groeiende open-sourcelibrary die zich richt op machine learning na de uitrol. Het biedt een breed scala aan features om allerlei problemen in productie-ML-omgevingen op te lossen. Enkele voorbeelden:
We gaan de technische kanten van deze features stuk voor stuk leren.
We leren de basisconcepten van modelmonitoring via de analogie van een robot die boogschieten onder de knie krijgt.
In onze analogie:
Dus, laten we beginnen.
Stel je voor dat we de boog, pijlen en het doel zorgvuldig hebben voorbereid (zoals datapreparatie). Onze robot, uitgerust met veel sensoren en camera’s, schiet 10.000 keer tijdens de training. Na verloop van tijd raakt hij opvallend vaak de roos. We zijn enthousiast over de performance en beginnen onze robot en kopieën ervan te verkopen aan boogschietliefhebbers (het model uitrollen).
Maar al snel krijgen we een stroom klachten. Sommige gebruikers melden dat de robot het doel volledig mist. Verrast stellen we een team samen om te bespreken wat er misging.
Wat we vinden is een klassiek geval van datadrift. De omgeving waarin de robots werken is veranderd — andere windpatronen, wisselende vochtigheid en zelfs veranderingen in de fysieke kenmerken van de pijlen (gewicht, balans) en de boog.
Deze verschuiving in echte inputfeatures heeft de nauwkeurigheid van onze robot onderuitgehaald, vergelijkbaar met hoe een machinelearningmodel kan onderpresteren wanneer inputdata, vooral de relatie tussen features, in de tijd verandert.
Na het aanpakken van deze problemen brengen we een nieuwe batch robots uit. Toch komen er na een paar weken vergelijkbare klachten binnen. Verbaasd graven we dieper en ontdekken dat de doelwitten vaak door gebruikers zijn vervangen.
Deze nieuwe doelwitten variëren in grootte en staan op verschillende afstanden. Deze verandering vraagt om een andere aanpak van de schiettechniek van de robot — een schoolvoorbeeld van conceptdrift.
In machinelearningtermen treedt conceptdrift op wanneer de relatie tussen de inputvariabelen en de targetuitkomst verandert. Voor onze robots betekenden de nieuwe soorten doelwitten dat ze nu hun schietgedrag moeten aanpassen, net zoals een machinelearningmodel zich moet aanpassen wanneer de dynamiek van de data waarop het is getraind significant verandert.
Om de punten extra duidelijk te maken, verkennen we enkele praktijkvoorbeelden van hoe data- en conceptdrift ontstaan.
Laten we nu een end-to-end ML-monitoringworkflow bekijken.
Modelmonitoring omvat drie grote stappen die ML-engineers iteratief moeten volgen.
De eerste stap is natuurlijk het scherp in de gaten houden van de modelperformance in productie. Maar dat is makkelijker gezegd dan gedaan.
Als de ground truth direct beschikbaar is voor een model in productie, is het eenvoudig om veranderingen in modelgedrag te detecteren. In onze robot/boogschiet-analogie kunnen gebruikers bijvoorbeeld meteen aangeven wat er mis is omdat ze naar het doel kunnen kijken en ons kunnen vertellen dat de robot miste — directe ground truth.
Neem daarentegen een model dat betalingsachterstanden op leningen voorspelt. Zulke modellen voorspellen elke maand of een gebruiker de volgende betaling mist of niet. Om de voorspelling te verifiëren, moet het model wachten tot de daadwerkelijke betaaldatum. Dit is een voorbeeld van vertraagde ground truth, wat het meest voorkomt in echte machinelearningsystemen.
In zulke gevallen is het te kostbaar om te wachten tot de ground truth beschikbaar is om te zien of modellen goed presteren. ML-engineers hebben dus methoden nodig om modelperformance te schatten zonder die ground truth. Daar komen algoritmes als CBPE of DLE om de hoek kijken (later meer).
Modellen monitoren kan ook door de directe bedrijfsimpact te meten, oftewel het monitoren van KPI’s (key performance indicators). In het geval van Zillow had een goed monitoringsysteem winstverlies kunnen detecteren en de engineers kunnen alarmeren (theoretisch).
Als het monitoringsysteem een performance-daling detecteert, ongeacht of het systeem gerealiseerde performance (met ground truth) of geschatte performance (zonder ground truth) analyseerde, moeten ML-engineers de oorzaak van de daling achterhalen.
Dit houdt meestal in dat je features individueel of in combinatie controleert op data- (feature)drift en de targets onderzoekt op conceptdrift.
Op basis van hun bevindingen zetten ze verschillende oplossingsstrategieën in.
Hier is een niet-uitputtende lijst met technieken om de schade door performance-degradatie na uitrol te beperken:
Elke methode heeft zijn toepassingscontext, en vaak implementeer je een combinatie.
NannyML pakt de eerste twee stappen van dit iteratieve proces aan. Dus, aan de slag.
Naast trainings- en validatiesets heeft NannyML twee extra sets nodig, een reference en analysis, in specifieke formaten om te starten met monitoring. In deze sectie leer je hoe je ze vanuit elke data creëert.
Eerst hebben we een model nodig dat al getraind is en klaar om in productie te worden uitgerold, zodat we het kunnen monitoren. Hiervoor gebruiken we de diamonds-dataset en trainen we een XGBoost-regressor.
import warnings

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
import xgboost as xgb
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

warnings.filterwarnings("ignore")
De eerste stap na het importeren van modules is het laden van de Diamonds-dataset uit Seaborn. We gebruiken echter een speciale versie van de dataset die ik specifiek voor dit artikel heb voorbereid om te laten zien hoe monitoring eruitziet. Je kunt de dataset in je omgeving laden met het onderstaande fragment:
dataset_link = "https://raw.githubusercontent.com/BexTuychiev/medium_stories/master/2024/1_january/4_intro_to_nannyml/diamonds_special.csv"

diamonds_special = pd.read_csv(dataset_link)
diamonds_special.head()
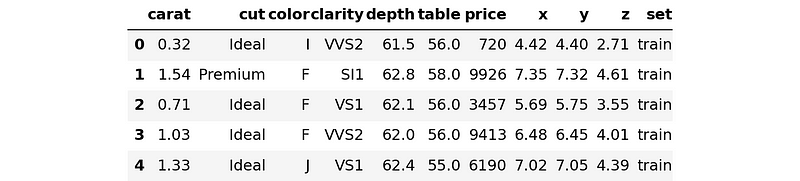
Deze speciale versie van de dataset heeft een kolom genaamd “set”, waar we zo op terugkomen.
Voor nu halen we alle featurenamen op, de namen van categorische features en de targetnaam:
# Extract all feature names
all_feature_names = diamonds_special.drop(["price", "set"], axis=1).columns.tolist()

# Extract the columns and cast into category
cats = diamonds_special.select_dtypes(exclude=np.number).columns

# Define the target column
target = "price"
De taak is een regressie — we gaan diamantprijzen voorspellen op basis van hun fysieke kenmerken.
De diamonds-dataset is vrij schoon. De enige preprocessing die we doen is het casten van tekstfeatures naar het Pandas-datatype category. Dit is vereist om automatische categorische datapreprocessing door XGBoost mogelijk te maken.
for col in cats:
   diamonds_special[col] = diamonds_special[col].astype("category")
Laten we doorgaan met het splitsen van de data.
Ja, dat lees je goed. We splitsen de data in vier sets. Traditioneel splits je die misschien in drie:
Workflows voor modelmonitoring vereisen nog een set om productiedata na te bootsen. Dit zorgt ervoor dat ons systeem correct performance-dalingen detecteert met de juiste algoritmes en rapporteert wat er misging.
Hiervoor heb ik de rijen van Diamonds Special gelabeld met vier categorieën in de kolom set:
diamonds_special.set.unique()
['train', 'val', 'test', 'prod']
Categories (4, object): ['prod', 'test', 'train', 'val']
De trainingsset vertegenwoordigt 70%, terwijl de rest 10% elk van de totale data is. Laten we splitsen:
tr = diamonds_special[diamonds_special.set == "train"].drop("set", axis=1)
val = diamonds_special[diamonds_special.set == "validation"].drop("set", axis=1)
test = diamonds_special[diamonds_special.set == "test"].drop("set", axis=1)
prod = diamonds_special[diamonds_special.set == "prod"].drop("set", axis=1)

tr.shape
(37758, 10)
Maar datasets uit de echte wereld komen niet met ingebouwde setlabels, dus moet je de data zelf handmatig in vier sets splitsen. Hier is een functie die de taak uitvoert met train_test_split uit sklearn:
def split_into_four(df, train_size=0.7):
   """
   A function to split a dataset into four sets:
   - Training
   - Validation
   - Testing
   - Production
   train_size is set by the user.
   The remaining data will be equally divided between the three sets.
   """
   # Do the splits
   training, the_rest = train_test_split(df, train_size=train_size)
   validation, the_rest = train_test_split(the_rest, train_size=1 / 3)
   testing, production = train_test_split(the_rest, train_size=0.5)

   # Reset the indices
   sets = (training, validation, testing, production)
   for set in sets:
       set.reset_index(inplace=True, drop=True)

   return sets


tr, val, test, prod = split_into_four(your_dataset)
Let op: Gebruik de knop “Leg code uit” om een regel-voor-regeluitleg van de functie te krijgen.
Laten we nu doorgaan met het trainen van het model.
Voordat we een XGBoost-model trainen, moeten we de datasets omzetten naar DMatrices. Hier is de code:
dtrain = xgb.DMatrix(tr[all_feature_names], label=tr[target], enable_categorical=True)
dval = xgb.DMatrix(val[all_feature_names], label=val[target], enable_categorical=True)

dtest = xgb.DMatrix(
   test[all_feature_names], label=test[target], enable_categorical=True
)
dprod = xgb.DMatrix(
   prod[all_feature_names], label=prod[target], enable_categorical=True
)
Hier is nu de code om een regressor te trainen met al getunede hyperparameters:
# Define optimized parameters
params = {
   "n_estimators": 10000,
   "learning_rate": 0.1,
   "tree_method": "gpu_hist",
   "max_depth": 6,
   "min_child_weight": 1,
   "gamma": 0,
   "subsample": 0.8,
   "colsample_bytree": 0.8,
   "objective": "reg:squarederror",
   "reg_alpha": 0.01,
   "reg_lambda": 1,
}

# Training with early stopping
regressor = xgb.train(
   params,
   dtrain,
   num_boost_round=10000,
   evals=[(dtrain, "train"), (dval, "eval")],
   early_stopping_rounds=50,
   verbose_eval=500,
)
[0]	train-rmse:3638.77217	eval-rmse:0.00000
[49]	train-rmse:502.61376	eval-rmse:0.00000
Mooi — we hebben een model dat 503$ behaalt qua RMSE op de validatieset. Laten we het model nog één keer evalueren op de testset:
from sklearn.metrics import mean_squared_error

# Predict on the test set
y_test_pred = regressor.predict(dtest)

# Evaluate
mean_squared_error(test[target], y_test_pred, squared=False)
551.2763827068798
De testperformance is 551$. Dat is goed genoeg.
Tot nu toe was alles vrij rechttoe rechtaan. Nu komen we bij het hoofdonderdeel — het maken van reference- en analysis-sets.
Een reference set is een andere naam voor de testset in de context van modelmonitoring. NannyML gebruikt de performance van het model op de testset als baseline voor performance in productie. De reference set moet naast de features twee kolommen hebben:
y_test_predOp dit moment bevat onze testset de features en de target, maar mist y_test_pred:
test.columns  # Ignore the `set` column
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z'],
     dtype='object')
Laten we die toevoegen:
test["y_pred"] = y_test_predNu hernoemen we de testset naar reference:
reference = test.copy(deep=True)

reference.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Stel nu even voor dat onze regressor in de cloud is uitgerold. Je iets voorstellen is eenvoudiger dan het model echt uitrollen, wat voor dit artikel wat overdreven is.
Na de uitrol van ons model voor diamantprijzen krijgen we bericht dat er een grote zending diamanten aankomt. Voordat de lading arriveert, zijn de fysieke metingen van diamanten naar ons gestuurd als prod (we zijn nog steeds aan het voorstellen) zodat we er prijzen voor kunnen genereren en ze op onze website kunnen gaan aanbieden. Dus, laten we genereren.
# Generate prices for production data
y_prod_pred = regressor.predict(dprod)
Voordat de echte diamanten arriveren en een menselijke specialist de prijzen die ons model heeft gegenereerd verifieert, moeten we checken of ons model goed presteert. We willen geen diamanten met onjuiste prijzen op onze website tonen.
Om dit te doen, moeten we de performance van het model meten door y_prod_pred te vergelijken met de werkelijke prijzen van de nieuwe diamanten, de ground truth. Maar we hebben geen ground truth voordat de prijzen zijn geverifieerd. We moeten de performance van het model dus schatten zonder ground truth.
Voor deze taak vereist NannyML een analysis set — de data die de productiedata bevat met de door het model gemaakte voorspellingen.
Een analysis set maken lijkt op het maken van een reference:
# Add the predictions of new diamonds to prod
prod["y_pred"] = y_prod_pred

analysis = prod.copy(deep=True)
analysis.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Nu zijn we klaar om de performance van de regressor te schatten.
NannyML biedt twee hoofdalgoritmes voor het schatten van de performance van regressie- en classificatiemodellen:
We gebruiken het algoritme DLE voor onze taak. DLE kan de performance van een productiemodel meten zonder ground truth en diverse regressie-pseudometrics rapporteren, zoals RMSE, RMSLE, MAE, enz.
Om DLE te gebruiken, moeten we het eerst fitten op reference om een baselineperformance vast te stellen.
import nannyml  # pip install nannyml

estimator = nannyml.DLE(
   feature_column_names=all_feature_names,
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)
Het initialiseren van DLE vereist drie parameters: de inputfeaturenamen, de naam van de kolom met ground truth voor testen en de naam van de kolom met testvoorspellingen.
Daarnaast geven we RMSE als metric door en een chunkgrootte van 250. Laten we de estimator fitten op reference en de performance schatten op analysis:
# Fit to the reference set
estimator.fit(reference)

# Estimate on the analysis set
estimated_results = estimator.estimate(analysis)
estimated_results
<nannyml.performance_estimation.direct_loss_estimation.result.Result at 0x7f3954af1c90>
We hebben een NannyML-Result-object dat geplot kan worden. Laten we zien wat het oplevert:
estimated_results.plot().show()
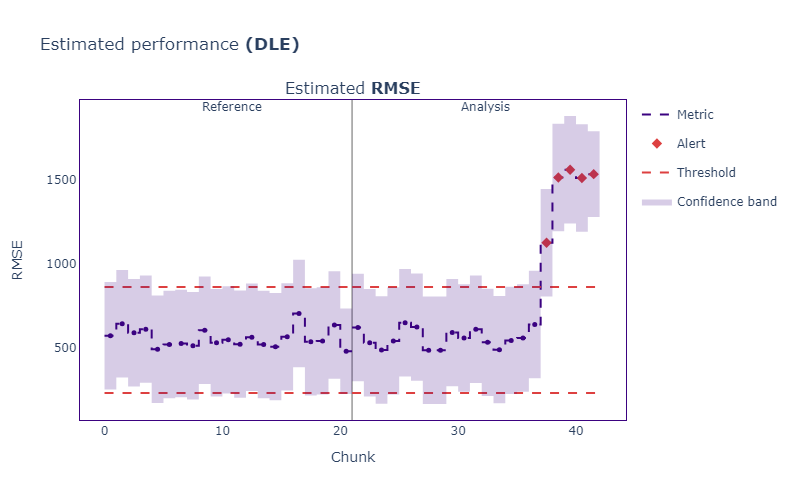
Laten we de plot interpreteren — hij heeft twee secties die de performance op de reference- en analysis-sets tonen. Als de geschatte RMSE in productie boven de drempels uitkomt, markeert NannyML die als alerts.
Zoals we zien hebben we een paar alerts voor productiedata, wat suggereert dat er iets niet pluis is in de laatste batches.
Ons monitoringsysteem vertelt ons dat de modelperformance in productie ongeveer is gehalveerd. Maar het is slechts een schatting — we kunnen het niet met zekerheid zeggen.
Terwijl we de geschatte performance plotten, is de zending gearriveerd en heeft onze diamantspecialist de werkelijke prijzen berekend. We hebben die als price in prod opgeslagen.
Nu kunnen we de gerealiseerde performance (daadwerkelijke performance) van het model vergelijken met de geschatte performance om te zien of ons monitoringsysteem goed werkt.
NannyML biedt een PerformanceCalculator-klasse om dit te doen:
calculator = nannyml.PerformanceCalculator(
   problem_type="regression",
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)

calculator.fit(reference)
realized_results = calculator.calculate(analysis)
De klasse vereist vier parameters:
problem_type: Wat is de taak?y_true: Wat zijn de labels?y_pred: Waar vind ik de voorspellingen?metrics: Welke metrics gebruik ik om de performance te berekenen?Na het doorgeven daarvan en het fitten van de calculator op reference, calculaten we op de analysis set.
Om realized_results te vergelijken met estimated_results, gebruiken we opnieuw een visualisatie:
estimated_results.compare(realized_results).plot().show()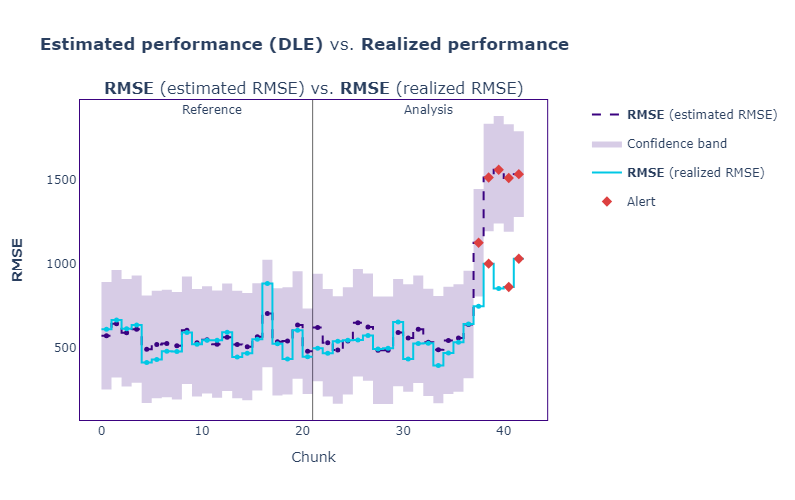
Het lijkt erop dat de geschatte RMSE (paars) behoorlijk dicht bij de daadwerkelijke performance lag (gerealiseerde RMSE, blauw).
Dit vertelt ons één ding — ons monitoringsysteem werkt goed, maar ons model niet, zoals blijkt uit het oplopende verlies. Wat is/zijn de reden(en)?
Daar duiken we nu in.
Zoals in de intro genoemd, is drift een van de meest voorkomende redenen waarom modellen in productie falen. In deze sectie richten we ons op data- (feature)driftdetectie.
Driftdetectie maakt deel uit van de oorzaakanalysestap van de modelmonitoringworkflow. Het begint doorgaans met multivariate driftdetectie.
Een van de beste multivariate driftdetectiemethoden is het berekenen van datareconstructiefout met PCA. Dit werkt opvallend goed en kan zelfs de kleinste drifts in featuredistributies oppikken. Hier is een overzicht op hoofdlijnen van deze methode:
1. PCA wordt gefit op reference en comprimeert die naar een lagere dimensie - reference_lower.
2. reference_lower wordt vervolgens gedecomprimeerd naar de oorspronkelijke dimensionaliteit - reference_reconstructed.
reference.3. Het verschil tussen reference en reference_reconstructed wordt gevonden en aangeduid als datareconstructiefout - reconstruct_error.
reconstruct_error dient als baseline om de reconstructiefout van productiedata mee te vergelijken4. Dezelfde reductie-/reconstructiemethode wordt toegepast op batches productiedata.
Deze vier stappen zijn geïmplementeerd als de klasse DataReconstructionDriftCalculator in NannyML. Zo gebruik je die:
# Initialize
multivariate_calc = nannyml.DataReconstructionDriftCalculator(
   column_names=all_feature_names,
   chunk_size=250,
)

# Fit
multivariate_calc.fit(reference)
# Calculate error
multivariate_results = multivariate_calc.calculate(analysis)
Zodra we de fout voor elke chunk data (elk 250 rijen) hebben, kunnen we die plotten:
multivariate_results.plot().show()
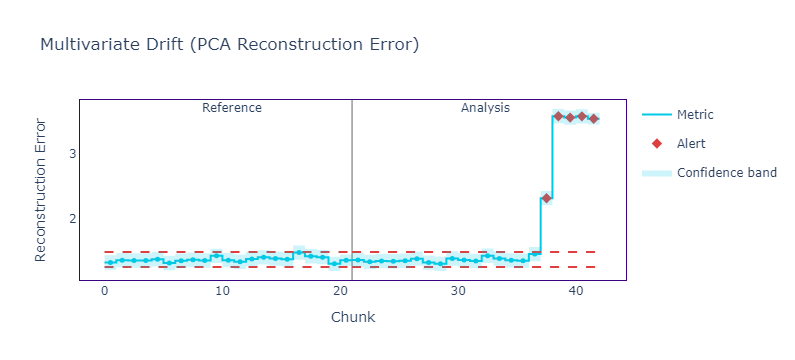
Zoals we zien is de reconstructiefout erg hoog, wat op drift in features wijst. We kunnen de fout ook vergelijken met de gerealiseerde performance:
multivariate_results.compare(realized_results).plot().show(config={"staticPlot": True})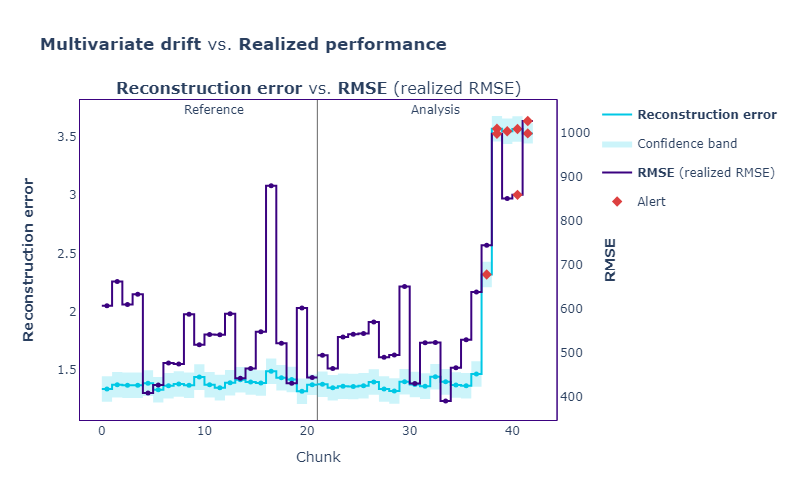
Zoals we zien, komen alle pieken in verlies overeen met alerts in reconstructiefout.
Datareconstructiefout is één getal om drift voor alle features te meten. Maar hoe zit het met de drift van individuele features? Als onze dataset honderden features bevatte, hoe zouden we dan de meest driftende features vinden en passende maatregelen nemen?
Daarvoor gebruiken we univariate driftdetectiemethoden. NannyML biedt er verschillende, afhankelijk van het featuretype:
Al deze methoden vergelijken de distributie van individuele features in reference met die van de analysis-set. We kunnen er enkele (of zelfs alle) gebruiken binnen de klasse UnivariateDriftCalculator:
univariate_calc = nannyml.UnivariateDriftCalculator(
   column_names=all_feature_names,
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   chunk_size=250,
)

univariate_calc.fit(reference)
univariate_results = univariate_calc.calculate(analysis)
De enige vereiste parameter is column_names, de rest kan de door NannyML ingestelde defaults gebruiken. Maar om het simpel te houden, gebruiken we wasserstein en jensen_shannon voor respectievelijk continue en categorische features.
We hebben nu 11 features, dus plot().show() aanroepen levert mogelijk niet de meest optimale resultaten op. In plaats daarvan kunnen we een alert count ranker gebruiken om de features terug te geven die de meeste alerts opleverden (als we alle chunks meenemen). Hier is de code:
# Initialize the ranker
alert_count_ranker = nannyml.AlertCountRanker()

# Filter the univariate results for only columns containing the metrics
filtered_univariate = univariate_results.filter(
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   only_drifting=False,
)

# Rank the alerts
ranker_results = alert_count_ranker.rank(filtered_univariate)
Zodra we de rankerresultaten hebben, kunnen we de kop afdrukken, want het is een Pandas DataFrame:
ranker_results.head(10)
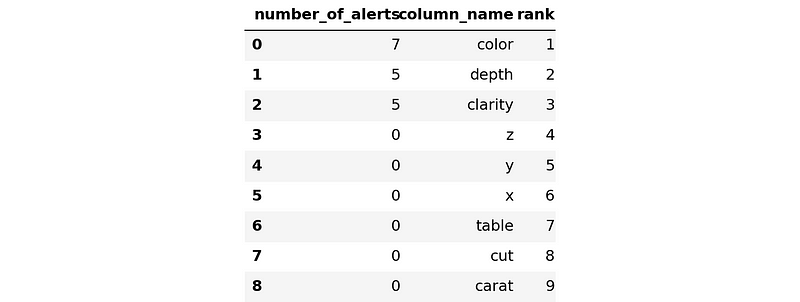
We zien dat de meest problematische features color en depth zijn. Dat verbaast me niet, want ik heb ze vóór het schrijven van het artikel kunstmatig laten driften.
Maar als dit een echte situatie was, zou je wat tijd willen besteden aan het oplossen van problemen voor deze features.
Ik vind modelmonitoring fascinerend omdat het de illusie doorprikt dat machine learning klaar is zodra je een goed model hebt. Terwijl de aarde blijft draaien en gebruikerspatronen veranderen, blijft geen enkel model lang relevant. Dit maakt modelmonitoring een cruciaal onderdeel van de skillset van elke ML-engineer.
Vandaag hebben we een basisworkflow voor modelmonitoring behandeld. We zijn begonnen met fundamentele monitoringconcepten. Daarna doken we direct de code in: we hebben de data in een formaat gegoten dat compatibel is met NannyML; onze eerste plot gemaakt voor geschatte modelperformance; nog een plot gemaakt om die te vergelijken met gerealiseerde performance; enkele alerts ontvangen dat de performance daalt; dat gecheckt met multivariate driftdetectie; forse featuredrift gevonden; het dubbelgecheckt met univariate driftdetectie; de driftende features geïdentificeerd.
Helaas zijn we gestopt net voor het oplossen van problemen. Die laatste stap van de monitoringworkflow valt buiten de scope van dit artikel. Ik heb echter een paar uitstekende aanbevelingen die dat en veel meer over modelmonitoring behandelen:
Beide cursussen zijn gemaakt door de allerbeste persoon die je je kunt wensen — de CEO en oprichter van NannyML. In de cursussen zitten veel inzichten die je niet mag missen.
Ik raad ook aan de NannyML-docs te lezen voor hands-ontutorials.
Begin vandaag nog aan je machinelearningreis!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


