Curso
Comprender el machine learning
2 h
308.6K
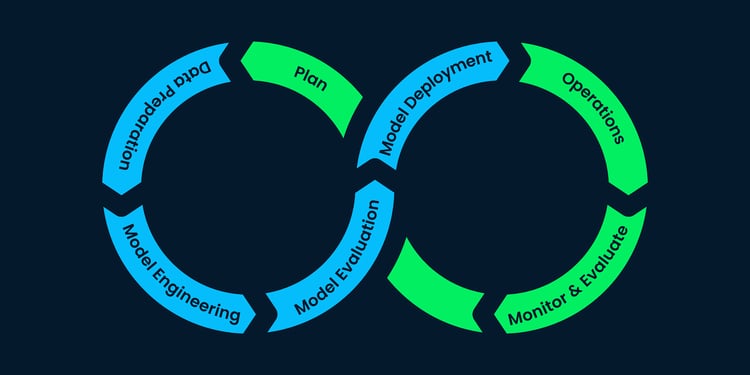
Los proyectos de machine learning son procesos iterativos. No te detienes cuando consigues un buen modelo en un cuaderno de Jupyter. Ni siquiera cuando el modelo está en línea y la gente puede acceder a él. Incluso después del despliegue, hay que vigilarlo constantemente para que funcione tan bien como durante la fase de desarrollo.
El escándalo de Zillow es un ejemplo perfecto de lo que ocurre si no lo haces. En 2021, Zillow perdió la asombrosa cifra de 304 millones de dólares debido a su modelo de machine learning que estimaba precios de viviendas. Zillow pagó de más por más de 7000 casas y tuvo que venderlas después a un precio mucho más bajo. La empresa fue "timada" por su propio modelo y tuvo que reducir su plantilla en un 25%.
Este tipo de fallos silenciosos son habituales en modelos del mundo real, por lo que hay que actualizarlos constantemente antes de que su rendimiento en producción caiga. No hacerlo daña la reputación de las empresas, la confianza de los stakeholders y, en última instancia, su bolsillo.
En este artículo aprenderás a implementar un flujo de trabajo de extremo a extremo para monitorizar modelos de machine learning tras su despliegue con NannyML.
NannyML es una biblioteca open source en crecimiento centrada en el machine learning post‑despliegue. Ofrece un amplio abanico de funciones para resolver todo tipo de problemas que surgen en entornos de ML en producción. Algunas de ellas:
Iremos viendo paso a paso los aspectos técnicos de estas funciones.
Aprenderemos los conceptos fundamentales de la monitorización de modelos con la analogía de un robot que domina el tiro con arco.
En nuestra analogía:
Vamos al lío.
Imagina que hemos preparado cuidadosamente el arco, las flechas y la diana (como la preparación de datos). Nuestro robot, equipado con muchos sensores y cámaras, dispara 10 000 veces durante el entrenamiento. Con el tiempo, empieza a dar en el centro con una frecuencia impresionante. Estamos encantados con el rendimiento y empezamos a vender nuestro robot y sus copias a amantes del tiro con arco (despliegue del modelo).
Pero pronto recibimos un aluvión de quejas. Algunos usuarios informan de que el robot ni siquiera da en la diana. Sorprendidos, reunimos a un equipo para analizar qué ha fallado.
Lo que encontramos es un caso clásico de data drift. El entorno en el que operan los robots ha cambiado: patrones de viento distintos, niveles de humedad variables e incluso cambios en las características físicas de las flechas (peso, equilibrio) y del arco.
Este cambio real en las features de entrada ha desviado la puntería de nuestro robot, similar a cómo un modelo de machine learning puede rendir peor cuando los datos de entrada, especialmente la relación entre features, cambian con el tiempo.
Tras abordar estos problemas, lanzamos una nueva tanda de robots. Sin embargo, a las pocas semanas llegan quejas similares. Extrañados, investigamos más y descubrimos que los usuarios han estado sustituyendo con frecuencia las dianas.
Estas nuevas dianas varían en tamaño y se colocan a distancias diferentes. Este cambio exige otro enfoque en la técnica de disparo del robot: un ejemplo de libro de concept drift.
En términos de machine learning, el concept drift ocurre cuando cambia la relación entre las variables de entrada y el resultado objetivo. Para nuestros robots, los nuevos tipos de dianas implican que ahora deben adaptarse y disparar de manera distinta, igual que un modelo debe ajustarse cuando cambian de forma significativa las dinámicas de los datos con los que se entrenó.
Para afianzar las ideas, veamos ejemplos reales de cómo se producen el data y el concept drift.
Ahora, veamos un flujo de trabajo de monitorización de ML de principio a fin.
La monitorización de modelos consta de tres pasos principales que los ingenieros de ML deben seguir de forma iterativa.
El primer paso, por supuesto, es vigilar de cerca el rendimiento del modelo en producción. Pero esto es más fácil decirlo que hacerlo.
Cuando la verdad terreno está disponible de inmediato para un modelo en producción, es fácil detectar cambios en su comportamiento. Por ejemplo, en nuestra analogía del robot y el tiro con arco, los usuarios pueden decirnos enseguida qué falla porque ven la diana y nos avisan de que el robot ha fallado: verdad terreno inmediata.
En cambio, piensa en un modelo que predice impagos de préstamos. Estos modelos predicen cada mes si una persona dejará de pagar la siguiente cuota o no. Para verificar la predicción, el modelo debe esperar a la fecha real de pago. Este es un ejemplo de verdad terreno retrasada, algo muy común en sistemas de machine learning del mundo real.
En estos casos, esperar a disponer de la verdad terreno para comprobar el rendimiento resulta demasiado costoso. Así que los ingenieros de ML necesitan métodos para estimarlo sin ella. Aquí es donde entran algoritmos como CBPE o DLE (hablaremos de ellos más adelante).
La monitorización también puede hacerse midiendo el impacto directo en el negocio, es decir, siguiendo KPIs (indicadores clave). En el caso de Zillow, un sistema de monitorización adecuado podría haber detectado la pérdida de beneficios y alertado a los ingenieros (hipotéticamente).
Si el sistema detecta una caída de rendimiento, tanto si analizó rendimiento realizado (con verdad terreno) como si fue rendimiento estimado (sin verdad terreno), los ingenieros de ML deben identificar la causa de esa caída.
Esto suele implicar revisar las features individualmente o en combinación para detectar drift de datos (feature drift) y examinar las dianas para detectar concept drift.
En función de lo que encuentren, aplican distintas técnicas de resolución de problemas.
Aquí tienes una lista no exhaustiva de técnicas para mitigar los daños causados por la degradación del rendimiento tras el despliegue:
Cada método tiene su contexto de aplicación y, a menudo, acabarás combinando varios.
NannyML cubre los dos primeros pasos de este proceso iterativo. Vamos a ello.
Además de los conjuntos de entrenamiento y validación, NannyML necesita otros dos llamados referencia y análisis en formatos específicos para empezar a monitorizar. En esta sección verás cómo crearlos a partir de cualquier dato.
Primero necesitamos un modelo ya entrenado y listo para desplegar en producción para poder monitorizarlo. Para ello usaremos el conjunto diamonds y entrenaremos un regresor XGBoost.
import warnings

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
import xgboost as xgb
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

warnings.filterwarnings("ignore")
El primer paso tras importar módulos es cargar el conjunto Diamonds desde Seaborn. Sin embargo, usaremos una versión especial del conjunto que preparé específicamente para este artículo para ilustrar cómo es la monitorización. Puedes cargarlo en tu entorno con este fragmento:
dataset_link = "https://raw.githubusercontent.com/BexTuychiev/medium_stories/master/2024/1_january/4_intro_to_nannyml/diamonds_special.csv"

diamonds_special = pd.read_csv(dataset_link)
diamonds_special.head()
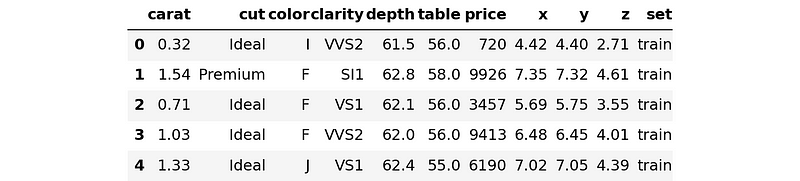
Esta versión especial del conjunto tiene una columna llamada "set", de la que hablaremos en un segundo.
Por ahora, extraeremos todos los nombres de features, los nombres de features categóricas y el nombre del target:
# Extract all feature names
all_feature_names = diamonds_special.drop(["price", "set"], axis=1).columns.tolist()

# Extract the columns and cast into category
cats = diamonds_special.select_dtypes(exclude=np.number).columns

# Define the target column
target = "price"
La tarea es de regresión: vamos a predecir el precio de los diamantes según sus atributos físicos.
El conjunto diamonds está bastante limpio. Así que el único preprocesado que haremos es convertir las features de texto al tipo category de Pandas. Esto es necesario para habilitar el preprocesado automático de categóricas en XGBoost.
for col in cats:
   diamonds_special[col] = diamonds_special[col].astype("category")
Pasemos a dividir los datos.
Sí, lo has leído bien. Vamos a dividir los datos en cuatro conjuntos. Tradicionalmente, quizá los dividas en tres:
Los flujos de monitorización necesitan otro conjunto que imite los datos de producción. Así nos aseguramos de que el sistema detecta correctamente caídas de rendimiento con los algoritmos adecuados e informa de qué ha ido mal.
Con ese fin, he etiquetado las filas de Diamonds Special con cuatro categorías en la columna set:
diamonds_special.set.unique()
['train', 'val', 'test', 'prod']
Categories (4, object): ['prod', 'test', 'train', 'val']
El conjunto de entrenamiento representa el 70%, mientras que el resto son un 10% cada uno del total. Vamos a separarlos:
tr = diamonds_special[diamonds_special.set == "train"].drop("set", axis=1)
val = diamonds_special[diamonds_special.set == "validation"].drop("set", axis=1)
test = diamonds_special[diamonds_special.set == "test"].drop("set", axis=1)
prod = diamonds_special[diamonds_special.set == "prod"].drop("set", axis=1)

tr.shape
(37758, 10)
Pero los conjuntos del mundo real no traen etiquetas de set integradas, así que tendrás que dividir los datos manualmente en cuatro conjuntos. Aquí tienes una función que lo hace usando train_test_split de sklearn:
def split_into_four(df, train_size=0.7):
   """
   A function to split a dataset into four sets:
   - Training
   - Validation
   - Testing
   - Production
   train_size is set by the user.
   The remaining data will be equally divided between the three sets.
   """
   # Do the splits
   training, the_rest = train_test_split(df, train_size=train_size)
   validation, the_rest = train_test_split(the_rest, train_size=1 / 3)
   testing, production = train_test_split(the_rest, train_size=0.5)

   # Reset the indices
   sets = (training, validation, testing, production)
   for set in sets:
       set.reset_index(inplace=True, drop=True)

   return sets


tr, val, test, prod = split_into_four(your_dataset)
Nota: Usa el botón "Explain code" para obtener una explicación línea a línea de la función.
Ahora, pasemos al entrenamiento del modelo.
Antes de entrenar un modelo XGBoost, necesitamos convertir los conjuntos en DMatrices. Este es el código:
dtrain = xgb.DMatrix(tr[all_feature_names], label=tr[target], enable_categorical=True)
dval = xgb.DMatrix(val[all_feature_names], label=val[target], enable_categorical=True)

dtest = xgb.DMatrix(
   test[all_feature_names], label=test[target], enable_categorical=True
)
dprod = xgb.DMatrix(
   prod[all_feature_names], label=prod[target], enable_categorical=True
)
Ahora, aquí tienes el código para entrenar un regresor con hiperparámetros ya ajustados:
# Define optimized parameters params = { "n_estimators": 10000, "learning_rate": 0.1, "tree_method": "gpu_hist", "max_depth": 6, "min_child_weight": 1, "gamma": 0, "subsample": 0.8, "colsample_bytree": 0.8, "objective": "reg:squarederror", "reg_alpha": 0.01, "reg_lambda": 1, } # Training with early stopping regressor = xgb.train( params, dtrain, num_boost_round=10000, evals=[(dtrain, "train"), (dval, "eval")], early_stopping_rounds=50, verbose_eval=500, ) [0] train-rmse:3638.77217 eval-rmse:0.00000 [49] train-rmse:502.61376 eval-rmse:0.00000Genial: tenemos un modelo que logra 503$ de RMSE en el conjunto de validación. Evaluémoslo por última vez en el conjunto de prueba:
from sklearn.metrics import mean_squared_error # Predict on the test set y_test_pred = regressor.predict(dtest) # Evaluate mean_squared_error(test[target], y_test_pred, squared=False) 551.2763827068798El rendimiento en prueba es de 551$. Es suficientemente bueno.
Crear un conjunto de referencia
Hasta ahora, todo bastante directo. Ahora llegamos a la parte principal: crear los conjuntos de referencia y análisis.
Un conjunto de referencia es otro nombre para el conjunto de prueba en el contexto de monitorización de modelos. NannyML usa el rendimiento del modelo en el conjunto de prueba como línea base para la producción. El conjunto de referencia debe tener dos columnas además de las features:
y_test_predAhora mismo, nuestro conjunto de prueba contiene las features y el target, pero le falta y_test_pred:
test.columns  # Ignore the `set` column
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z'],
     dtype='object')
Vamos a añadirla:
test["y_pred"] = y_test_predAhora renombraremos el conjunto de prueba como reference:
reference = test.copy(deep=True)

reference.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
En este punto, imaginemos que nuestro regresor está desplegado en la nube. Imaginarlo es más sencillo que desplegarlo de verdad, lo cual sería excesivo para este artículo.
Tras desplegar nuestro modelo de precios de diamantes, recibimos la noticia de que llega un gran envío de diamantes. Antes de que llegue la carga, nos envían las medidas físicas de los diamantes como prod (seguimos imaginando) para que podamos generar precios y empezar a publicarlos en nuestra web. Vamos a generarlos.
# Generate prices for production data
y_prod_pred = regressor.predict(dprod)
Antes de que lleguen los diamantes reales y una persona especialista verifique los precios que ha generado nuestro modelo, tenemos que comprobar si el modelo está rindiendo bien. No queremos mostrar precios erróneos en la web.
Para ello, necesitaríamos medir el rendimiento comparando y_prod_pred con los precios reales de los nuevos diamantes, la verdad terreno. Pero no tendremos la verdad terreno hasta que se verifiquen los precios. Así que tendremos que estimar el rendimiento sin verdad terreno.
Para esta tarea, NannyML necesita un conjunto de análisis: los datos de producción con las predicciones generadas por el modelo.
Crear un conjunto de análisis es similar a crear el reference:
# Add the predictions of new diamonds to prod
prod["y_pred"] = y_prod_pred

analysis = prod.copy(deep=True)
analysis.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y',
      'z', 'y_pred'],
     dtype='object')
Ya estamos listos para estimar el rendimiento del regressor.
NannyML ofrece dos algoritmos principales para estimar el rendimiento de modelos de regresión y clasificación:
Usaremos el algoritmo DLE para nuestra tarea. DLE puede medir el rendimiento de un modelo en producción sin verdad terreno y reportar varias pseudo‑métricas de regresión como RMSE, RMSLE, MAE, etc.
Para usar DLE, primero debemos ajustarlo a reference para establecer una línea base de rendimiento.
import nannyml  # pip install nannyml

estimator = nannyml.DLE(
   feature_column_names=all_feature_names,
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)
Inicializar DLE requiere tres parámetros: los nombres de las features de entrada, el nombre de la columna con la verdad terreno para las pruebas y el nombre de la columna con las predicciones de prueba.
Además, pasamos RMSE como métrica y un tamaño de lote de 250. Ajustemos el estimador a reference y estimemos el rendimiento en analysis:
# Fit to the reference set
estimator.fit(reference)

# Estimate on the analysis set
estimated_results = estimator.estimate(analysis)
estimated_results
<nannyml.performance_estimation.direct_loss_estimation.result.Result at 0x7f3954af1c90>
Tenemos un objeto Result de NannyML que se puede representar. Veamos qué produce:
estimated_results.plot().show()
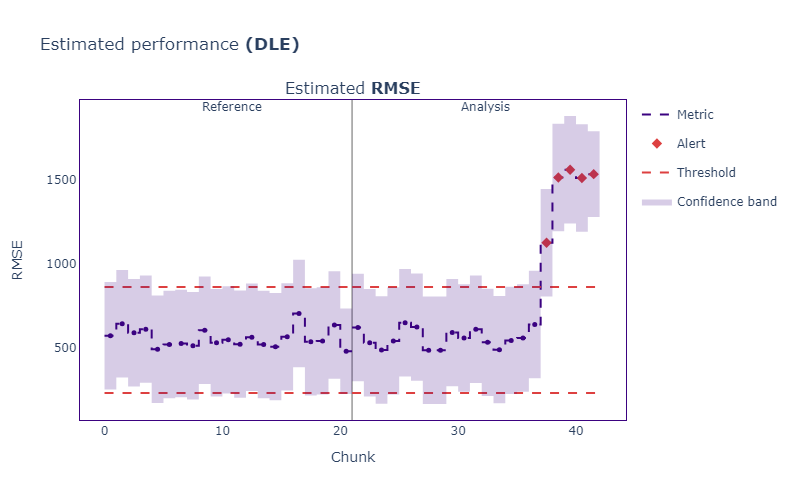
Interpretación del gráfico: tiene dos secciones que muestran el rendimiento en los conjuntos de referencia y análisis. Si el RMSE estimado en producción supera los umbrales, NannyML los marca como alertas.
Como ves, hay varias alertas en datos de producción, lo que sugiere que algo raro está ocurriendo en los últimos lotes.
Nuestro sistema de monitorización nos indica que el rendimiento del modelo cayó a la mitad en producción. Pero es solo una estimación: no podemos afirmarlo con certeza.
Mientras representamos el rendimiento estimado, llega el envío y nuestra persona especialista en diamantes calcula su precio real. Los hemos guardado como price en prod.
Ahora podemos comparar el rendimiento realizado (real) del modelo con el estimado para comprobar si nuestro sistema de monitorización funciona bien.
NannyML ofrece la clase PerformanceCalculator para esto:
calculator = nannyml.PerformanceCalculator(
   problem_type="regression",
   y_true=target,
   y_pred="y_pred",
   metrics=["rmse"],
   chunk_size=250,
)

calculator.fit(reference)
realized_results = calculator.calculate(analysis)
La clase requiere cuatro parámetros:
problem_type: ¿cuál es la tarea?y_true: ¿cuáles son las etiquetas?y_pred: ¿dónde están las predicciones?metrics: ¿qué métricas uso para calcular el rendimiento?Tras pasarlos y ajustar el calculador a reference, ejecutamos calculate sobre el conjunto de análisis.
Para comparar realized_results con estimated_results, usamos de nuevo una visualización:
estimated_results.compare(realized_results).plot().show()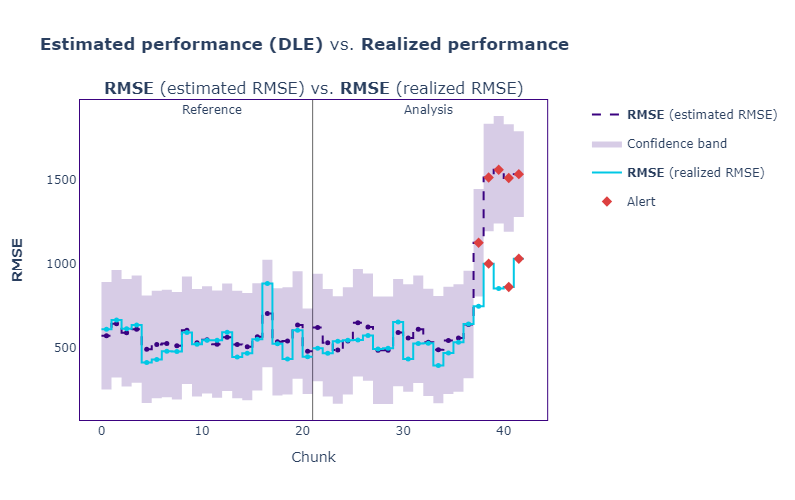
Parece que el RMSE estimado (morado) estuvo bastante cerca del rendimiento real (RMSE realizado, azul).
Esto nos dice una cosa: nuestro sistema de monitorización funciona bien, pero nuestro modelo no, como indica la pérdida al alza. Entonces, ¿cuál es la causa?
Vamos a profundizar.
Como mencionamos en la introducción, una de las razones más comunes por las que los modelos fallan en producción es el drift. En esta sección nos centraremos en la detección de drift de datos (features).
La detección de drift forma parte del análisis de causa raíz en el flujo de monitorización. Normalmente empieza con la detección multivariante.
Uno de los mejores métodos multivariantes es calcular el error de reconstrucción de datos usando PCA. Funciona sorprendentemente bien y puede detectar incluso los drifts más sutiles en las distribuciones de features. Resumen de alto nivel del método:
1. PCA se ajusta a reference y lo comprime a menor dimensión: reference_lower.
2. Luego se descomprime reference_lower a su dimensionalidad original: reference_reconstructed.
reference.3. Se calcula la diferencia entre reference y reference_reconstructed y se denomina error de reconstrucción: reconstruct_error.
reconstruct_error sirve como línea base para comparar el error de reconstrucción de los datos de producción.4. Se aplica la misma reducción/reconstrucción a lotes de datos de producción.
Estos cuatro pasos están implementados como la clase DataReconstructionDriftCalculator en NannyML. Así se usa:
# Initialize
multivariate_calc = nannyml.DataReconstructionDriftCalculator(
   column_names=all_feature_names,
   chunk_size=250,
)

# Fit
multivariate_calc.fit(reference)
# Calculate error
multivariate_results = multivariate_calc.calculate(analysis)
Una vez que tenemos el error para cada lote de datos (250 filas cada uno), podemos representarlo:
multivariate_results.plot().show()
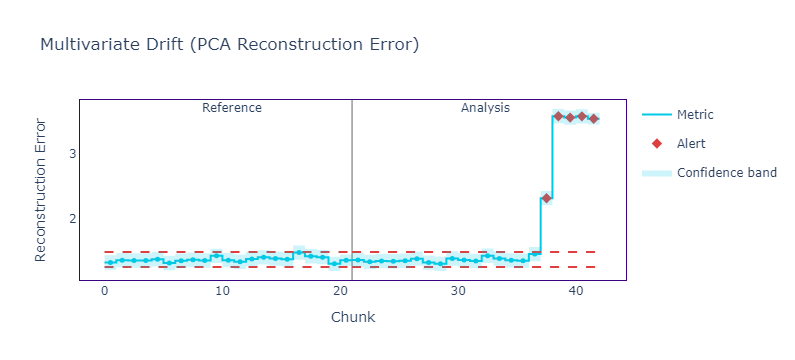
Como ves, el error de reconstrucción es muy alto, lo que indica drift en las features. También podemos compararlo con el rendimiento realizado:
multivariate_results.compare(realized_results).plot().show(config={"staticPlot": True})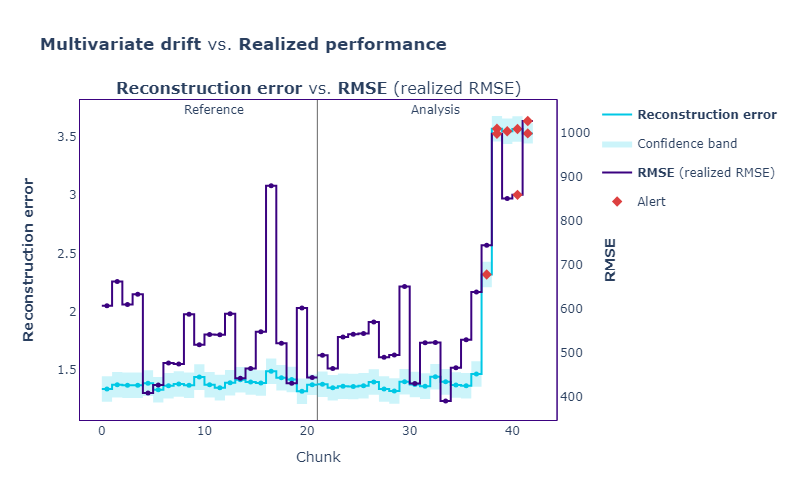
Como puedes ver, todos los picos de pérdida corresponden con alertas en el error de reconstrucción.
El error de reconstrucción es un único número para medir el drift de todas las features. Pero ¿qué pasa con el drift de cada feature individual? Si nuestro conjunto tuviera cientos de features, ¿cómo localizaríamos las que más driftean y tomaríamos medidas?
Ahí es donde usamos métodos univariantes. NannyML ofrece varios según el tipo de feature:
Todos comparan la distribución de cada feature en reference con la del conjunto analysis. Podemos usar algunos (o incluso todos) con la clase UnivariateDriftCalculator:
univariate_calc = nannyml.UnivariateDriftCalculator(
   column_names=all_feature_names,
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   chunk_size=250,
)

univariate_calc.fit(reference)
univariate_results = univariate_calc.calculate(analysis)
El único parámetro obligatorio es column_names; el resto puede usar los valores por defecto de NannyML. Pero, para simplificar, usamos wasserstein y jensen_shannon para continuas y categóricas, respectivamente.
Ahora mismo tenemos 11 features, así que llamar a plot().show() puede que no sea lo más óptimo. En su lugar, podemos usar un ranker por recuento de alertas para obtener las features que generan más alertas (considerando todos los lotes). Código:
# Initialize the ranker
alert_count_ranker = nannyml.AlertCountRanker()

# Filter the univariate results for only columns containing the metrics
filtered_univariate = univariate_results.filter(
   continuous_methods=["wasserstein"],
   categorical_methods=["jensen_shannon"],
   only_drifting=False,
)

# Rank the alerts
ranker_results = alert_count_ranker.rank(filtered_univariate)
Con los resultados del ranker, podemos imprimir su cabecera, ya que es un DataFrame de Pandas:
ranker_results.head(10)
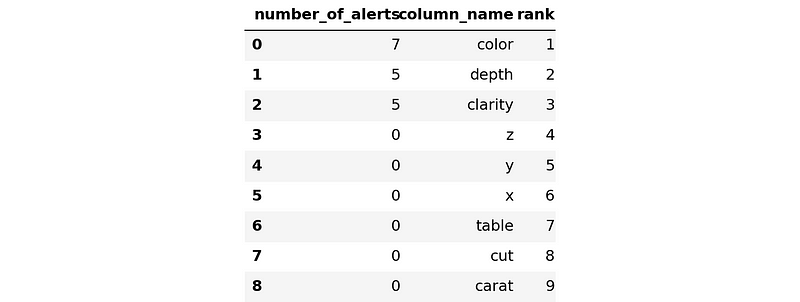
Vemos que las features más problemáticas son color y depth. No debería sorprenderme: fui yo quien provocó artificialmente su drift antes de escribir el artículo.
Pero si fuera un caso real, querrías dedicar tiempo a resolver los problemas en estas features.
La monitorización de modelos me parece fascinante porque rompe la ilusión de que el machine learning termina cuando tienes un buen modelo. A medida que la Tierra gira y cambian los patrones de uso, ningún modelo permanece vigente durante mucho tiempo. Por eso la monitorización es una parte crucial del conjunto de habilidades de cualquier ingeniero de ML.
Hoy hemos visto un flujo básico de monitorización. Empezamos con los conceptos fundamentales. Luego nos metimos de lleno en el código: preparamos los datos en un formato compatible con NannyML; creamos nuestra primera gráfica con el rendimiento estimado; generamos otra para compararlo con el rendimiento realizado; recibimos varias alertas de caída de rendimiento; lo comprobamos con detección de drift multivariante; encontramos drift fuerte en features; lo confirmamos con detección univariante; e identificamos las features en drift.
Por desgracia, nos hemos quedado justo en la resolución de problemas. Ese último paso del flujo queda fuera del alcance de este artículo. Aun así, te dejo recomendaciones excelentes que lo cubren y profundizan mucho más en monitorización de modelos:
Ambos cursos están creados por la mejor persona posible para ello: el CEO y fundador de NannyML. Encontrarás muchas perlas de conocimiento que no te puedes perder.
También te recomiendo leer la documentación de NannyML para tutoriales prácticos.
¡Empieza hoy tu camino en machine learning!
Curso
Curso
Curso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
Tutorial
Moez Ali
9 min
Tutorial
Tutorial
Kurtis Pykes
7 min
Tutorial
Duong Vu
11 min