
Kursus
Pengantar Regresi dengan statsmodels di Python
4 jam
63.6K
Salah satu tantangan utama dalam membangun model regresi yang efektif adalah apa yang kita sebut multikolinearitas. Multikolinearitas muncul ketika dua atau lebih variabel independen dalam sebuah model sangat berkorelasi, sehingga menghasilkan inferensi statistik yang tidak andal. Ini bisa menjadi masalah besar jika Anda perlu menafsirkan koefisien regresi secara akurat atau jika Anda perlu menguji keyakinan terhadapnya.
Di sini, saya akan memandu Anda melalui konsep kunci multikolinearitas, cara mendeteksinya, dan juga cara mengatasinya. Jika Anda baru dalam regresi linear, bacalah tutorial kami, Simple Linear Regression: Everything You Need to Know sebagai titik awal, lalu lanjutkan dengan Multiple Linear Regression in R: Tutorial With Examples, yang membahas regresi dengan lebih dari satu variabel independen—tempat di mana multikolinearitas dapat muncul.
Membangun model machine learning yang akurat adalah tugas yang menantang karena ada begitu banyak faktor yang berperan. Data harus memiliki kualitas, volume, dan lain-lain yang memadai. Lalu Anda perlu membangun jenis algoritme machine learning yang tepat. Namun, di antara keduanya ada tahap persiapan data, yang memang tidak seglamor membangun model prediktif, tetapi sering kali menjadi penentu berhasil tidaknya proses siklus hidup machine learning.
Selama persiapan data, kita mewaspadai multikolinearitas, yang terjadi ketika variabel independen dalam model regresi berkorelasi, artinya mereka tidak saling independen. Ini bukan pertanda baik bagi model, karena multikolinearitas sering kali mendistorsi estimasi koefisien regresi, memperbesar galat baku, dan dengan demikian mengurangi kekuatan statistik model. Hal ini juga menyulitkan untuk menentukan pentingnya masing-masing variabel dalam model.
Multikolinearitas dapat berupa dua bentuk utama, masing-masing memengaruhi cara variabel independen dalam model regresi saling berinteraksi dan seberapa andal estimasi yang dihasilkan.
Multikolinearitas sempurna terjadi ketika salah satu variabel independen dalam model regresi dapat diprediksi secara tepat menggunakan satu atau lebih variabel independen lainnya. Ini berarti ada hubungan yang sempurna di antara mereka.
Bayangkan Anda memiliki dua variabel, X1 dan X2, dan keduanya berhubungan dengan persamaan: X1 = 2*X2 + 3. Ini pada dasarnya berarti model regresi tidak akan bisa memisahkan pengaruh X1 dan X2 karena pada dasarnya mereka menyampaikan hal yang sama. Dengan kata lain, satu variabel merupakan fungsi linear sempurna dari variabel lainnya.
Pada multikolinearitas tidak sempurna, variabel-variabel sangat berkorelasi, tetapi tidak secara sempurna satu banding satu seperti pada kasus multikolinearitas sempurna. Variabel mungkin berbagi korelasi tinggi—ketika satu variabel berubah, variabel lain cenderung ikut berubah—tetapi bukan prediksi yang persis.
Dalam situasi ini, bukan berarti model tidak akan memberikan hasil. Masalahnya adalah hasil tersebut mungkin tidak stabil, yang berarti perubahan kecil pada data dapat menyebabkan perubahan besar pada koefisien yang diestimasi. Ini membuat penafsiran pentingnya masing-masing variabel menjadi lebih sulit secara andal.
Multikolinearitas struktural muncul dari cara model dibangun, bukan dari hubungan alaminya. Ini sering terjadi ketika Anda menyertakan suku interaksi atau suku polinomial dalam model.
Sebagai contoh, jika Anda berpikir bahwa besaran efek suatu variabel meningkat seiring meningkatnya variabel lain, Anda mungkin mempertimbangkan menambahkan suku interaksi. Namun, masalahnya adalah jika variabel-variabel ini sudah agak berkorelasi, menambahkan suku interaksi dapat berlebihan dan menimbulkan masalah multikolinearitas.
Multikolinearitas memengaruhi analisis regresi dengan menimbulkan masalah saat Anda mencoba mengestimasi hubungan antara variabel independen (prediktor) dan variabel dependen (keluaran). Secara khusus, multikolinearitas meningkatkan varians estimasi koefisien, membuatnya sensitif terhadap perubahan kecil pada model atau data.
Ketika koefisien menjadi tidak stabil, galat baku membesar, yang pada gilirannya dapat menghasilkan nilai p yang tidak signifikan meskipun variabel tersebut sebenarnya penting. Penting untuk diketahui bahwa multikolinearitas tidak memengaruhi daya prediktif keseluruhan model. Namun, hal itu memengaruhi penafsiran model karena model kita akan memiliki galat yang membesar dan estimasi yang tidak stabil.
Mendeteksi multikolinearitas memerlukan beberapa alat diagnostik. Kita akan menelusurinya menggunakan subset dataset dari Housing Prices Competition di Kaggle. Subset data yang akan kita gunakan dapat Anda temukan di repositori GitHub ini. Mari memuat dan menelusuri dataset dengan kode di bawah:
import pandas as pd
import numpy as np
import seaborn as sns
from statsmodels.stats.outliers_influence import variance_inflation_factor

df = pd.read_csv('mc_df.csv')
df.head()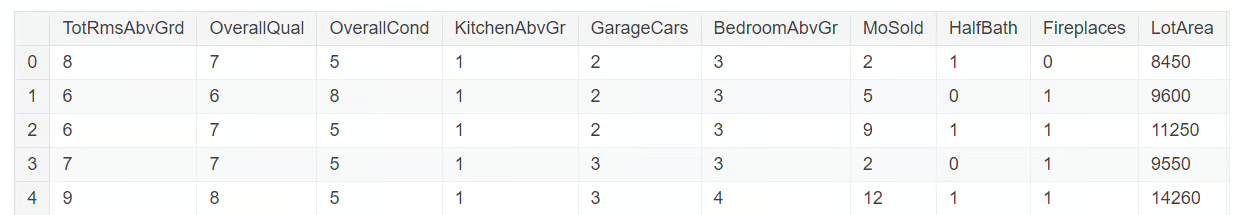
Salah satu teknik yang banyak digunakan untuk mendeteksi multikolinearitas adalah melalui matriks korelasi yang membantu memvisualisasikan kekuatan hubungan antarvariabel. Matriks menampilkan koefisien korelasi berpasangan antarvariabel, yang menunjukkan seberapa kuat hubungan linear mereka (nilai berkisar dari -1 hingga 1). Aturan praktis yang saya gunakan adalah nilai korelasi absolut di atas 0,6 menunjukkan multikolinearitas yang kuat.
Karena multikolinearitas dideteksi pada variabel independen, kita perlu menghapus variabel target, SalePrice, dari dataset. Ini dilakukan dengan kode di bawah.
multi_c_df = multi_c_df.drop('SalePrice', axis=1)Sekarang kita siap untuk analisis korelasi. Kode di bawah menghitung matriks korelasi untuk DataFrame multi_c_df. Setelah menghitung korelasi, kode menggunakan fungsi heatmap() dari Seaborn untuk merepresentasikan matriks korelasi secara visual sebagai heatmap. Argumen annot=True menambahkan nilai korelasi numerik langsung ke heatmap.
# Correlation matrix
correlation_matrix = multi_c_df.corr()

# Set up the matplotlib figure
plt.figure(figsize=(10, 6))

# Create a heatmap for the correlation matrix
sns.heatmap(correlation_matrix, annot=True, cmap="coolwarm", fmt=".2f", linewidths=0.5)

# Title for the heatmap
plt.title("Correlation Heatmap", fontsize=16)

# Show the heatmap
plt.show()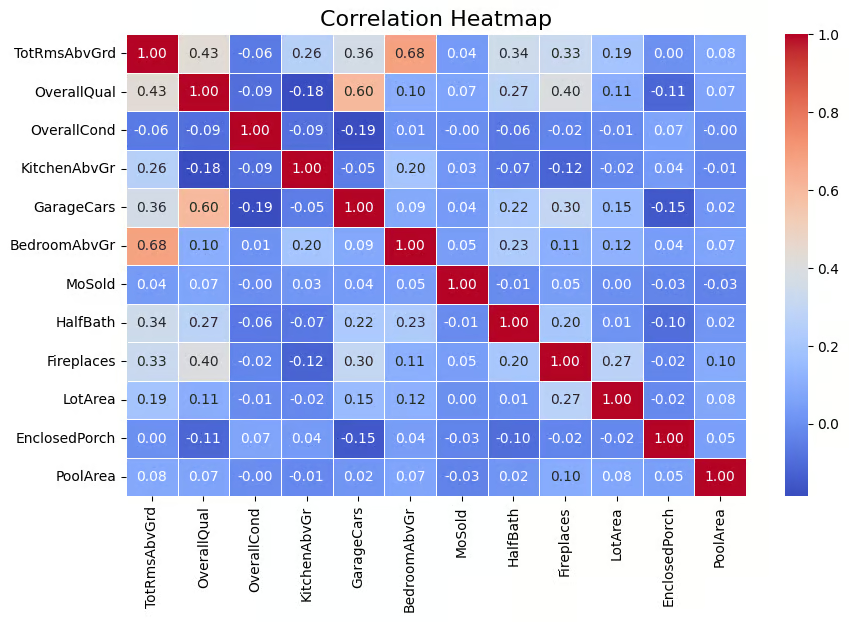
Matriks korelasi direpresentasikan dengan heatmap. Gambar oleh Penulis
Keluaran di atas menunjukkan adanya korelasi di antara beberapa variabel independen. Misalnya, BedroomAbvGr dan TotRmsAbvGrd memiliki korelasi yang relatif tinggi (0,68). Selain itu, GarageCars dan OverallQual memiliki korelasi 0,60, yang menunjukkan bahwa keduanya juga saling terkait. Jadi ada variabel independen yang memiliki korelasi cukup kuat yang menyiratkan adanya multikolinearitas untuk sebagian, jika tidak semua, variabel ini.
Pada tahap ini, sangat penting untuk dicatat bahwa multikolinearitas dapat muncul bahkan ketika tidak ada korelasi berpasangan yang jelas antarvariabel, karena satu variabel dapat berkorelasi dengan kombinasi linear dari lebih dari satu variabel lain. Inilah mengapa penting juga untuk mempertimbangkan variance inflation factor, yang akan kita bahas selanjutnya.
Variance inflation factor (VIF) adalah salah satu teknik paling umum untuk mendeteksi multikolinearitas. Sederhananya, ini memberikan nilai numerik yang menunjukkan seberapa besar varians koefisien regresi meningkat akibat multikolinearitas. Nilai VIF lebih besar dari 5 menunjukkan multikolinearitas sedang, sedangkan nilai di atas 10 menunjukkan multikolinearitas berat.
Mari kita telusuri ini pada dataset kita. Kita akan menghitung nilai VIF untuk masing-masing variabel independen ini. Tugas ini dilakukan pada kode di bawah dengan variance_inflation_factor() function.
# Calculate VIF for each numerical feature
vif_data = pd.DataFrame()
vif_data["feature"] = multi_c_df.columns

# Calculate VIF and round to 4 decimal places
vif_data["VIF"] = [round(variance_inflation_factor(multi_c_df.values, i), 4) for i in range(df.shape[1])]

# Sort VIF values in descending order
vif_data = vif_data.sort_values(by="VIF", ascending=False)

# Display the VIF DataFrame
print(vif_data)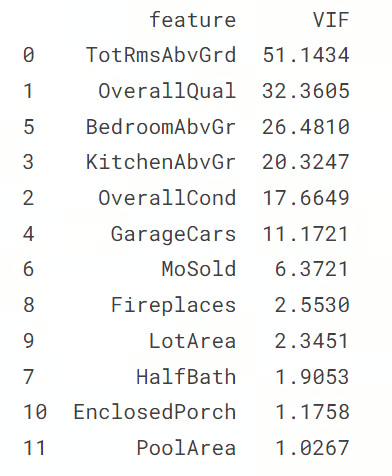
Nilai VIF untuk variabel numerik. Gambar oleh Penulis
Anda dapat melihat bahwa ada beberapa variabel yang memiliki nilai VIF lebih besar dari 10, yang menunjukkan adanya multikolinearitas.
Condition index adalah alat diagnostik lain untuk mendeteksi multikolinearitas, dengan nilai di atas 10 menunjukkan multikolinearitas sedang dan nilai di atas 30 menunjukkan multikolinearitas berat. Condition index bekerja dengan memeriksa seberapa besar variabel independen saling berkaitan dengan menelaah hubungan di antara nilai eigen mereka.
Kode di bawah menghitung condition index untuk memeriksa multikolinearitas dalam model regresi. Pertama, ia menghitung nilai eigen dari matriks korelasi (yang menunjukkan hubungan antarvariabel). Condition index kemudian dihitung dengan membagi nilai eigen terbesar dengan yang terkecil.
from numpy.linalg import eigvals

# Calculate the condition index
eigenvalues = eigvals(correlation_matrix)
condition_index = max(eigenvalues) / min(eigenvalues)

print(f'Condition Index: {condition_index}')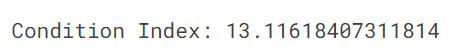
Dalam kasus kita, nilai condition index adalah 13, yang menunjukkan multikolinearitas sedang dalam model. Meskipun tingkat multikolinearitas ini, menurut condition index, tidak parah, hal itu tetap dapat memengaruhi ketepatan estimasi koefisien regresi dan menyulitkan untuk membedakan kontribusi individual dari variabel-variabel yang berkorelasi. Jika Anda tertarik mengetahui lebih lanjut tentang nilai eigen, bacalah artikel kami, Eigenvectors and Eigenvalues: Key Insights for Data Science.
Untuk menangani multikolinearitas secara efektif dalam model regresi, ada beberapa teknik yang dapat diterapkan. Metode-metode ini membantu memastikan bahwa model tetap akurat dan dapat ditafsirkan, bahkan ketika variabel independen saling berkaitan erat.
Salah satu cara paling sederhana untuk menangani multikolinearitas adalah dengan menghapus salah satu variabel yang sangat berkorelasi, sering kali yang memiliki nilai VIF tertinggi. Ini efektif, tetapi kelemahannya adalah dapat menyebabkan hilangnya informasi berguna jika tidak dilakukan dengan hati-hati.
Teknik lain adalah ketika dua atau lebih variabel sangat berkorelasi, kita dapat menggabungkannya menjadi satu prediktor menggunakan teknik seperti Principal Component Analysis (PCA). Ini mengurangi dimensi model sambil mempertahankan informasi paling krusial. Kekurangan utamanya adalah hilangnya keterjelasan penafsiran karena sulit menjelaskan sains dan matematika di balik PCA kepada audiens non-teknis.
Bagi data scientist, menerapkan teknik regularisasi dengan regresi ridge dan lasso adalah teknik populer lainnya untuk menangani masalah multikolinearitas. Teknik regularisasi ini menerapkan penalti pada model regresi, mengecilkan koefisien variabel yang berkorelasi dan dengan demikian mengurangi dampak multikolinearitas.
Saat menangani multikolinearitas, ada beberapa kesalahan umum yang dapat menyebabkan kinerja model buruk. Penting untuk menyadari kesalahan ini dan mengikuti praktik terbaik guna membuat model regresi yang lebih andal.
Ketika Anda melihat variance inflation factor (VIF) yang tinggi untuk suatu variabel, godaan untuk segera menghapus variabel tersebut dari model—dengan asumsi variabel itu penyebab multikolinearitas—cukup besar. Namun, ini bisa menjadi kesalahan karena meskipun suatu variabel memiliki VIF tinggi, variabel tersebut mungkin tetap sangat penting untuk memprediksi keluaran. Jadi jika Anda menghapusnya tanpa memeriksa skor kepentingannya, performa model bisa menurun. Kuncinya adalah mengevaluasi dengan cermat apakah variabel tersebut esensial sebelum memutuskan untuk menghapusnya.
Matriks korelasi berguna untuk mengidentifikasi besaran dan arah hubungan antarvariabel, tetapi masalahnya hanya menunjukkan hubungan linear. Bagaimana dengan hubungan yang kompleks dan non-linear? Sayangnya, itu tidak akan tertangkap dalam matriks. Jadi bergantung hanya pada matriks korelasi tidak akan memberi Anda gambaran lengkap. Itulah mengapa penting menggunakan metrik lain seperti VIF dan condition index untuk mendapatkan gambaran yang lebih utuh.
Selain pendekatan tradisional, ada beberapa metode lanjutan yang juga tersedia untuk menangani masalah multikolinearitas. Beberapa teknik ini dibahas di bawah.
Metode seleksi fitur otomatis seperti Recursive Feature Elimination (RFE) bisa menjadi alternatif yang baik. Metode-metode ini menganalisis pentingnya setiap prediktor dan secara otomatis menghapus yang tidak banyak memberikan nilai tambah. Ini menyederhanakan proses, sehingga lebih mudah mengurangi multikolinearitas tanpa harus memutuskan secara manual variabel mana yang akan dihapus.
Meningkatkan ukuran sampel dapat mengurangi multikolinearitas dengan menambahkan lebih banyak variasi ke dataset, sehingga memudahkan pembedaan kontribusi berbagai prediktor. Jadi solusi lain adalah dengan mengumpulkan lebih banyak data. Ketika ukuran dataset meningkat, hal ini menambah variasi pada variabel, sehingga lebih mudah membedakan efek berbagai prediktor. Ini pada gilirannya membantu mengurangi dampak multikolinearitas.
Memahami dan mengatasi multikolinearitas penting untuk membangun model regresi yang tangguh dan dapat ditafsirkan. Dengan mendeteksi multikolinearitas menggunakan teknik seperti VIF, matriks korelasi, dan condition index, serta mengatasinya dengan metode seperti regresi lasso dan ridge atau menghapus prediktor redundan, Anda dapat memastikan hasil model yang andal dan bermakna. Selalu periksa multikolinearitas dalam model regresi Anda dan terapkan solusi yang sesuai untuk menjaga integritas analisis Anda.
Untuk pembelajaran lebih lanjut dan penyegaran tentang cara melakukan regresi linear di ruang kerja favorit Anda, pertimbangkan menjelajahi sumber berikut:
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



