
Corso
Introduzione alla regressione con statsmodels in Python
4 ore
63.6K
Una delle principali sfide nella costruzione di un modello di regressione efficace è ciò che chiamiamo multicollinearità. La multicollinearità si presenta quando due o più variabili indipendenti in un modello sono altamente correlate, portando a inferenze statistiche inaffidabili. Questo può essere un grosso problema se devi interpretare con precisione i coefficienti di regressione o se devi testare la fiducia che riponi in essi.
Qui ti guiderò attraverso i concetti chiave della multicollinearità, come rilevarla e come affrontarla. Se sei alle prime armi con la regressione lineare, leggi il nostro tutorial Simple Linear Regression: Everything You Need to Know come punto di partenza, ma assicurati poi di proseguire con Multiple Linear Regression in R: Tutorial With Examples, che spiega la regressione con più di una variabile indipendente, ossia proprio il contesto in cui può emergere la multicollinearità.
Costruire modelli di machine learning accurati è un compito impegnativo perché entrano in gioco moltissimi fattori. I dati devono essere di qualità, volume, ecc. adeguati. Poi bisogna scegliere gli algoritmi di machine learning giusti. Tuttavia, tra questi due momenti c’è una fase di preparazione dei dati che non è glamour come la costruzione dei modelli predittivi, ma spesso è quella che decide il successo o il fallimento del ciclo di vita del machine learning.
Durante la preparazione dei dati, prestiamo attenzione alla multicollinearità, che si verifica quando le variabili indipendenti in un modello di regressione sono correlate, cioè non sono indipendenti l’una dall’altra. Questo non è un buon segno per il modello, perché la multicollinearità spesso distorce la stima dei coefficienti di regressione, gonfia gli errori standard e, di conseguenza, riduce la potenza statistica del modello. Inoltre, rende difficile determinare l’importanza delle singole variabili nel modello.
La multicollinearità può presentarsi in due forme principali, ognuna delle quali influisce su come le variabili indipendenti in un modello di regressione interagiscono e su quanto siano affidabili le stime risultanti.
La multicollinearità perfetta si verifica quando una delle variabili indipendenti in un modello di regressione può essere prevista esattamente usando una o più delle altre variabili indipendenti. Significa che esiste una relazione perfetta tra di esse.
Immagina di avere due variabili, X1 e X2, e che siano legate dall’equazione: X1 = 2*X2 + 3. Questo significa, in sostanza, che il modello di regressione non sarà in grado di separare gli effetti di X1 e X2 perché, di fatto, raccontano la stessa storia. In altre parole, una variabile è una funzione lineare perfetta dell’altra.
Nella multicollinearità imperfetta, le variabili sono altamente correlate, ma non in modo perfetto e biunivoco come nel caso della multicollinearità perfetta. Le variabili possono condividere una correlazione elevata, cioè quando una variabile cambia, anche l’altra tende a cambiare, ma non è una previsione esatta.
In questa situazione, non è che il modello non darà risultati. Il problema è che questi risultati potrebbero essere instabili, cioè anche piccoli cambiamenti nei dati possono portare a grandi cambiamenti nei coefficienti stimati. Questo rende più difficile interpretare in modo affidabile l’importanza di ciascuna variabile.
La multicollinearità strutturale nasce dal modo in cui è stato costruito il modello, non tanto dalle relazioni naturali tra variabili. Spesso si verifica quando includi termini di interazione o termini polinomiali nel modello.
Per esempio, se pensi che l’effetto di una variabile aumenti al crescere di un’altra, potresti considerare di aggiungere un termine di interazione. Tuttavia, il problema è che se queste variabili sono già in qualche misura correlate, aggiungere il termine di interazione potrebbe esagerare e portare a problemi di multicollinearità.
La multicollinearità influisce sull’analisi di regressione creando problemi quando cerchi di stimare la relazione tra le variabili indipendenti (i predittori) e la variabile dipendente (l’output). In particolare, la multicollinearità aumenta la varianza delle stime dei coefficienti, rendendole sensibili a piccoli cambiamenti nel modello o nei dati.
Quando i coefficienti diventano instabili, gli errori standard aumentano, il che può portare a p-value non significativi anche quando le variabili sono realmente importanti. È importante sapere che la multicollinearità non influisce sulla capacità predittiva complessiva del modello. Influisce però sull’interpretazione del modello, perché avremo errori gonfiati e stime instabili.
Rilevare la multicollinearità richiede diversi strumenti diagnostici. Li esploreremo usando un sottoinsieme del dataset tratto dalla Housing Prices Competition su Kaggle. Puoi trovare il sottoinsieme di dati che useremo in questo repository GitHub. Carichiamo ed esploriamo il dataset con il codice seguente:
import pandas as pd
import numpy as np
import seaborn as sns
from statsmodels.stats.outliers_influence import variance_inflation_factor

df = pd.read_csv('mc_df.csv')
df.head()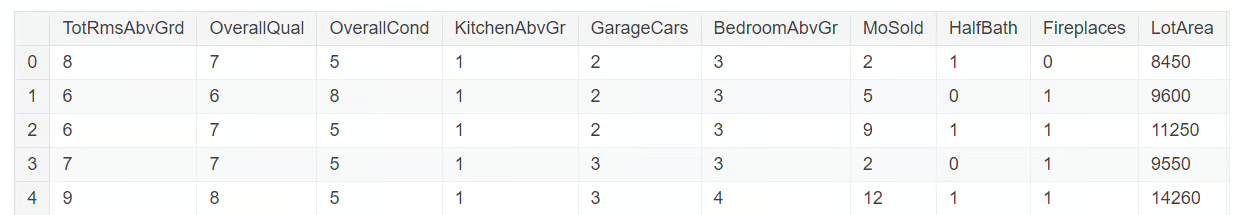
Una tecnica ampiamente utilizzata per rilevare la multicollinearità è la matrice di correlazione, che aiuta a visualizzare l’intensità delle relazioni tra variabili. La matrice mostra i coefficienti di correlazione per coppie di variabili, indicando quanto sono linearmente correlate (valori da -1 a 1). Una regola pratica che uso è che valori assoluti di correlazione superiori a 0,6 indicano una forte multicollinearità.
Poiché la multicollinearità si rileva tra variabili indipendenti, dobbiamo rimuovere la variabile target, SalePrice, dal nostro dataset. Questo si fa con il codice seguente.
multi_c_df = multi_c_df.drop('SalePrice', axis=1)Ora siamo pronti per l’analisi di correlazione. Il codice seguente calcola la matrice di correlazione per il DataFrame multi_c_df. Dopo aver calcolato le correlazioni, il codice usa la funzione heatmap() di Seaborn per rappresentare visivamente la matrice di correlazione come una heatmap. L’argomento annot=True aggiunge i valori numerici di correlazione direttamente sulla heatmap.
# Correlation matrix
correlation_matrix = multi_c_df.corr()

# Set up the matplotlib figure
plt.figure(figsize=(10, 6))

# Create a heatmap for the correlation matrix
sns.heatmap(correlation_matrix, annot=True, cmap="coolwarm", fmt=".2f", linewidths=0.5)

# Title for the heatmap
plt.title("Correlation Heatmap", fontsize=16)

# Show the heatmap
plt.show()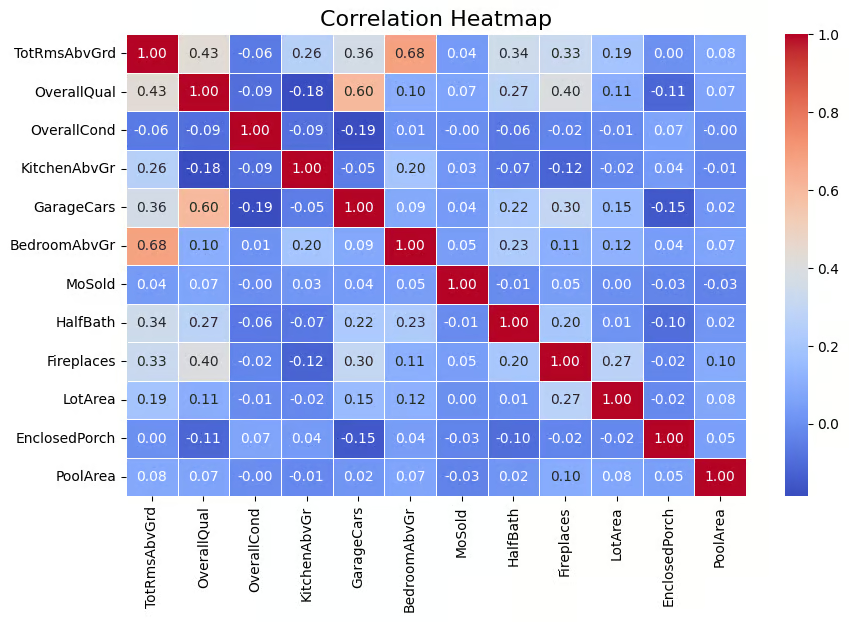
Matrice di correlazione rappresentata con una heatmap. Immagine dell’autore
L’output sopra mostra che esiste correlazione tra alcune variabili indipendenti. Per esempio, BedroomAbvGr e TotRmsAbvGrd hanno una correlazione relativamente alta (0,68). Inoltre, GarageCars e OverallQual hanno una correlazione di 0,60, a indicare che sono anch’esse correlate. Quindi ci sono variabili indipendenti con una correlazione discreta che suggerisce la presenza di multicollinearità per alcune, se non tutte, queste variabili.
A questo punto, è molto importante notare che la multicollinearità può sorgere anche quando non c’è un’evidente correlazione a coppie tra variabili, perché una variabile potrebbe essere correlata con una combinazione lineare di più di un’altra variabile. Ecco perché è importante considerare anche il variance inflation factor, che vedremo a breve.
Il variance inflation factor (VIF) è una delle tecniche più comuni per rilevare la multicollinearità. In parole semplici, fornisce un valore numerico che indica di quanto è gonfiata la varianza di un coefficiente di regressione a causa della multicollinearità. Un valore di VIF superiore a 5 indica multicollinearità moderata, mentre valori oltre 10 suggeriscono multicollinearità grave.
Vediamolo nel nostro dataset. Ora calcoleremo il valore di VIF per ciascuna di queste variabili indipendenti. Questo compito è eseguito nel codice seguente con la variance_inflation_factor() function.
# Calculate VIF for each numerical feature
vif_data = pd.DataFrame()
vif_data["feature"] = multi_c_df.columns

# Calculate VIF and round to 4 decimal places
vif_data["VIF"] = [round(variance_inflation_factor(multi_c_df.values, i), 4) for i in range(df.shape[1])]

# Sort VIF values in descending order
vif_data = vif_data.sort_values(by="VIF", ascending=False)

# Display the VIF DataFrame
print(vif_data)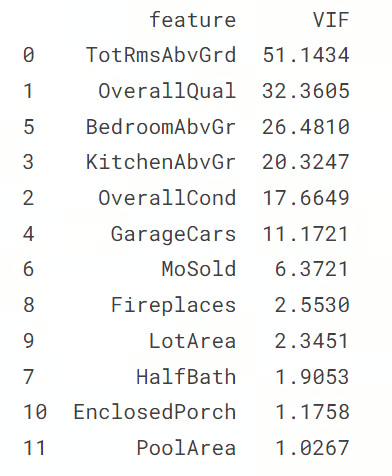
Valori di VIF per le variabili numeriche. Immagine dell’autore
Si vede che ci sono diverse variabili con un valore di VIF superiore a 10, a indicare la presenza di multicollinearità.
Il condition index è un altro strumento diagnostico per rilevare la multicollinearità: valori superiori a 10 indicano multicollinearità moderata e valori oltre 30 indicano multicollinearità grave. Il condition index funziona verificando quanto le variabili indipendenti siano correlate tra loro esaminando le relazioni tra i loro autovalori.
Il codice seguente calcola il condition index per verificare la multicollinearità in un modello di regressione. Per prima cosa calcola gli autovalori della matrice di correlazione (che mostra le relazioni tra variabili). Il condition index viene poi calcolato dividendo l’autovalore più grande per quello più piccolo.
from numpy.linalg import eigvals

# Calculate the condition index
eigenvalues = eigvals(correlation_matrix)
condition_index = max(eigenvalues) / min(eigenvalues)

print(f'Condition Index: {condition_index}')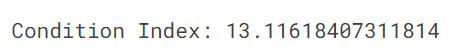
Nel nostro caso, il valore del condition index è 13, il che indica una multicollinearità moderata nel modello. Sebbene questo livello di multicollinearità, secondo il condition index, non sia grave, potrebbe comunque influire sulla precisione delle stime dei coefficienti di regressione e rendere più difficile distinguere i contributi individuali delle variabili correlate. Se vuoi saperne di più sugli autovalori, leggi il nostro articolo Eigenvectors and Eigenvalues: Key Insights for Data Science.
Per gestire efficacemente la multicollinearità nei modelli di regressione, si possono applicare diverse tecniche. Questi metodi aiutano a mantenere il modello accurato e interpretabile anche quando le variabili indipendenti sono strettamente correlate.
Uno dei modi più semplici per gestire la multicollinearità è rimuovere una delle variabili altamente correlate, spesso quella con il VIF più alto. È efficace, ma lo svantaggio è che, se fatto senza attenzione, può comportare la perdita di informazioni utili.
Un’altra tecnica consiste nel combinare in un unico predittore due o più variabili altamente correlate, usando metodi come la Principal Component Analysis (PCA). Questo riduce la dimensionalità del modello mantenendo le informazioni più importanti. Il principale svantaggio è la perdita di interpretabilità, perché è difficile spiegare scienza e matematica alla base della PCA a un pubblico non tecnico.
Per i data scientist, applicare tecniche di regolarizzazione con ridge e lasso regression è un altro approccio comune per affrontare il problema della multicollinearità. Queste tecniche aggiungono penalizzazioni al modello di regressione, riducendo i coefficienti delle variabili correlate e mitigando così gli effetti della multicollinearità.
Quando si affronta la multicollinearità, ci sono alcuni errori comuni che possono portare a prestazioni scarse del modello. È importante essere consapevoli di questi errori e seguire le buone pratiche per creare modelli di regressione più affidabili.
Quando vedi un variance inflation factor (VIF) alto per una variabile, è forte la tentazione di rimuovere subito quella variabile dal modello, supponendo che causi multicollinearità. Tuttavia, può essere un errore, perché anche se una variabile ha un VIF elevato, potrebbe essere comunque molto importante per prevedere l’output. Se la rimuovi senza verificarne l’importanza, il modello potrebbe peggiorare. La chiave è valutare attentamente se la variabile è essenziale prima di decidere se eliminarla.
La matrice di correlazione è utile per identificare l’ampiezza e la direzione della relazione tra variabili, ma il problema è che mostra solo relazioni lineari. E le relazioni complesse e non lineari? Purtroppo non vengono catturate nella matrice. Quindi basarsi solo su una matrice di correlazione non ti darà un quadro completo. Ecco perché è importante usare anche altre metriche come VIF e condition index per ottenere una visione più completa.
Oltre agli approcci tradizionali, esistono anche diversi metodi avanzati per gestire la multicollinearità. Alcune di queste tecniche sono discusse di seguito.
Metodi automatizzati di feature selection come la Recursive Feature Elimination (RFE) possono essere una buona alternativa. Questi metodi analizzano l’importanza di ciascun predittore e rimuovono automaticamente quelli che non aggiungono valore. Questo snellisce il processo, rendendo più semplice ridurre la multicollinearità senza dover decidere manualmente quali variabili rimuovere.
Aumentare la dimensione del campione può ridurre la multicollinearità aggiungendo maggiore variabilità al dataset, rendendo più facile distinguere i contributi dei diversi predittori. Quindi un’altra soluzione è semplicemente raccogliere più dati. Quando aumenta la dimensione del dataset, aumenta anche la variabilità delle variabili, rendendo più semplice distinguere tra gli effetti dei vari predittori. Questo aiuta a ridurre l’impatto della multicollinearità.
Capire e affrontare la multicollinearità è fondamentale per costruire modelli di regressione solidi e interpretabili. Rilevandola con tecniche come VIF, matrici di correlazione e condition index, e risolvendola con metodi come la lasso e ridge regression o rimuovendo predittori ridondanti, puoi garantire risultati del modello affidabili e significativi. Controlla sempre la presenza di multicollinearità nei modelli di regressione e applica soluzioni adeguate per mantenere integra la qualità delle tue analisi.
Per approfondire e ripassare come eseguire la regressione lineare nel tuo ambiente preferito, valuta le seguenti risorse:
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



