
Last chance! 50% off DataCamp Premium
Sale ends in
Bidang Data Science berkembang pesat seperti belum pernah terjadi sebelumnya. Ia mencakup begitu banyak domain berbeda seperti Statistik, Aljabar Linear, Machine Learning, dan Basis Data, lalu memadukannya seefektif mungkin. Namun, di intinya, apa yang membuat bidang ini begitu menarik? - Algoritme statistik yang kuat
Salah satu algoritme statistik yang sangat mendasar adalah Regresi Linear. Meski sudah lama, ia tidak pernah terlalu usang untuk diabaikan oleh calon data scientist seperti Anda. Memahami prinsip di balik cara kerja regresi linear sangat penting untuk menelusuri evolusi satu kelas algoritme statistik yang disebut Generalized Linear Models. Selain itu, ini juga akan membantu Anda memahami aspek lain dari algoritme statistik/machine learning pada umumnya, misalnya fungsi biaya (cost function), koefisien, optimisasi, dan sebagainya.
Sesuai judul tutorial ini, Anda akan membahas Regresi Linear secara rinci. Sebelum menyelami teori di balik Regresi Linear, mari kita pahami terlebih dahulu istilah regression.
Regresi termasuk dalam kelas tugas Supervised Learning di mana dataset yang digunakan untuk pemodelan prediktif/statistik memiliki label kontinu. Namun, mari kita definisikan masalah regresi secara lebih matematis.
Pertimbangkan gambar berikut:  Sumber: catatan kuliah Andrew Ng
Pada gambar di atas, X adalah sekumpulan nilai yang berkaitan dengan luas bangunan berbagai rumah (juga dianggap sebagai ruang nilai input) dan y adalah harga rumah masing-masing, namun perhatikan bahwa nilai-nilai ini diprediksi oleh h. h adalah fungsi yang memetakan nilai X ke y (sering disebut sebagai prediktor). Karena alasan historis, h ini disebut fungsi hipotesis. Perlu diingat, dataset ini hanya memiliki satu fitur, yaitu luas bangunan berbagai rumah, dan anggaplah ini sebagai dataset sederhana demi pemahaman.
Perhatikan bahwa nilai prediksi di sini bersifat kontinu. Jadi, tujuan akhir Anda adalah, diberi sebuah training set, mempelajari fungsi $h : \mathcal{X} \rightarrow \mathcal{Y}$ sehingga h(x) menjadi prediktor yang "baik" untuk nilai y yang bersesuaian. Juga ingat bahwa domain nilai yang diterima X dan Y adalah semua bilangan real dan Anda dapat mendefinisikannya seperti ini: $\mathcal{X} = \mathcal{Y} = \mathbb{IR}$ di mana $\mathbb{IR}$ adalah himpunan semua bilangan real.
Sepasang (x(i), y(i)) disebut contoh pelatihan (training example). Anda dapat mendefinisikan training set sebagai {(x(i), y(i)) ; i = 1,...,m} (jika training set berisi m instance dan hanya ada satu fitur x dalam dataset).
Seulas matematika agar Anda tidak keliru bahkan pada hal yang paling sederhana. Jadi, menurut Han, Kamber, dan Pei-
"Secara umum, metode-metode ini digunakan untuk memprediksi nilai variabel respons (dependen) dari satu atau lebih variabel prediktor (independen), di mana variabel-variabelnya bersifat numerik." - Data Mining: Concepts and Techniques (edisi ke-3)
Sesederhana itu!
Jadi, dalam proses memahami masalah regresi yang khas Anda juga melihat bagaimana mendefinisikan hipotesis untuknya. Keren. Suasana sudah pas! Sekarang, Anda akan langsung menyelami mekanisme Regresi Linear.
Sebelum masuk ke detailnya, bukankah menarik melihat kapan ini ditemukan? Itu terjadi jauh pada abad ke-18. Carl Friedrich Gauss pertama kali mengusulkan bentuk paling sederhana dari regresi statistik, meskipun ada banyak perdebatan tentang hal ini. Kita tidak akan membahasnya. Namun jika Anda tertarik melihat perdebatan antara Gauss dan Adrien-Marie Legendre, berikut tautannya.
Regresi linear mungkin adalah salah satu algoritme yang paling dikenal dan paling dipahami dalam statistik dan machine learning. Regresi linear dikembangkan di bidang statistik dan dipelajari sebagai model untuk memahami hubungan antara variabel numerik input dan output, namun seiring waktu, ia menjadi bagian integral dari perangkat machine learning modern.
Mari gunakan dataset sederhana. Anda akan memakai dataset prediksi harga rumah yang sama untuk menginvestigasinya, tetapi kali ini dengan dua fitur. Tugasnya tetap sama yaitu memprediksi harga rumah.
 Sumber: catatan kuliah Andrew Ng
Seperti disampaikan sebelumnya, kini x bersifat dua dimensi, yang berarti dataset Anda memiliki dua fitur. Misalnya, x1(i) adalah luas bangunan rumah ke-i dalam training set, dan x2(i) adalah jumlah kamar tidurnya.
Untuk melakukan regresi, Anda harus memutuskan bagaimana merepresentasikan h. Sebagai pilihan awal, anggap Anda memutuskan untuk mendekati y sebagai fungsi linear dari x:
Di sini, θi adalah parameter (juga disebut bobot) yang memparametrisasi ruang fungsi linear yang memetakan dari $\mathcal{X}$ ke $\mathcal{Y}$. Secara sederhana, parameter-parameter ini digunakan untuk memetakan $\mathcal{X}$ ke $\mathcal{Y}$ secara akurat. Namun untuk menyederhanakan pemahaman, Anda akan menghilangkan subskrip θ pada hθ(x), dan menuliskannya sebagai h(x) saja. Untuk semakin menyederhanakan notasi, Anda juga akan memperkenalkan konvensi x0 = 1 (ini adalah suku intersep), sehingga

di mana pada ruas kanan di atas Anda menganggap θ dan x keduanya sebagai vektor, dan n adalah jumlah instance input (tidak termasuk x0).
Namun pertanyaan utama pada titik ini adalah bagaimana Anda memilih atau mempelajari parameter θ? Anda tidak bisa mengubah instance input untuk memprediksi harga. Satu-satunya yang dapat Anda atur hanyalah parameter θ ini.
Salah satu metode yang menonjol adalah membuat h(x) mendekati y, setidaknya untuk contoh pelatihan yang Anda miliki. Untuk memahaminya secara lebih formal, mari kita definisikan sebuah fungsi yang menentukan, untuk setiap nilai θ, seberapa dekat h(x(i)) terhadap y(i) yang bersesuaian. Fungsinya tampak seperti berikut:

Untuk memahami alasan menggunakan kuadrat alih-alih nilai absolut, anggap suku kuadrat ini menguntungkan untuk operasi pelatihan model regresi selanjutnya. Namun jika ingin menggali lebih dalam, silakan baca.
Anda baru saja melihat salah satu rumus terpenting di dunia Data Science/Machine Learning/Statistik. Ini disebut fungsi biaya.
Ini adalah turunan yang penting karena bukan hanya melahirkan evolusi berikutnya dari regresi linear (Ordinary Least Squares) tetapi juga meletakkan fondasi seluruh kelas algoritme pemodelan linear (ingat Anda menjumpai istilah Generalized Linear Models).
Penting untuk dicatat bahwa regresi linear sering dibagi menjadi dua bentuk dasar:
Hal-hal ini sangat lugas namun seringkali dapat menimbulkan kebingungan.
Anda telah meletakkan dasar regresi linear. Sekarang Anda akan mempelajari lebih jauh cara memperkirakan parameter yang Anda lihat pada bagian di atas. Estimasi parameter ini pada dasarnya dikenal sebagai pelatihan regresi linear. Ada banyak metode untuk melatih model regresi linear, Ordinary Least Squares (OLS) adalah yang paling populer di antaranya. Jadi, wajar jika menyebut model regresi linear yang dilatih menggunakan OLS sebagai Ordinary Least Squares Linear Regression atau cukup Least Squares Regression.
Catat bahwa parameter di konteks ini juga disebut koefisien model.
Mempelajari/melatih model regresi linear pada dasarnya berarti memperkirakan nilai koefisien/parameter yang digunakan dalam representasi dengan data yang Anda miliki.
Pada bagian ini, Anda akan meninjau secara singkat beberapa teknik untuk menyiapkan model regresi linear.
Anda menutup bagian sebelumnya dengan gagasan memilih θ untuk meminimalkan J(θ). Untuk melakukannya, gunakan algoritme pencarian yang dimulai dengan "tebakan awal" untuk θ, dan secara iteratif mengubah θ untuk memperkecil J(θ), hingga semoga Anda mencapai nilai θ yang meminimalkan J(θ). Secara khusus, pertimbangkan algoritme gradient descent, yang dimulai dengan θ awal, dan berulang kali melakukan pembaruan berikut:
 Sumber: catatan kuliah Andrew Ng
(Pembaruan ini dilakukan secara simultan untuk semua nilai j = 0, . . . , n.) Di sini, α disebut learning rate. Ini adalah algoritme yang sangat alami yang berulang kali mengambil langkah ke arah penurunan J yang paling curam. Besaran α secara efektif mengontrol seberapa cepat algoritme Anda bergerak untuk menurunkan J. Secara visual dapat digambarkan sebagai berikut:
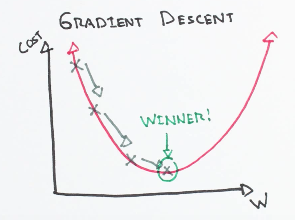 Sumber: ml-cheatsheet
Secara intuitif, rumus di atas menunjukkan perubahan kecil yang terjadi pada J terhadap parameter θj dan bagaimana hal tersebut memengaruhi nilai awal θj. Namun perhatikan, Anda harus berurusan dengan turunan parsial di sini. Proses turunannya di luar cakupan tutorial ini.
Perlu dicatat bahwa untuk satu contoh pelatihan, ini memberikan aturan pembaruan:
 Sumber: ml-cheatsheet
Aturan ini disebut aturan pembaruan LMS (LMS adalah singkatan dari “least mean squares”) dan juga dikenal sebagai aturan pembelajaran Widrow-Hoff.
Mari merangkum beberapa hal dalam konteks OLS.
"Prosedur Ordinary Least Squares berupaya meminimalkan jumlah kuadrat residual. Artinya, diberi sebuah garis regresi melalui data, kita menghitung jarak dari setiap titik data ke garis regresi, mengkuadratkannya, dan menjumlahkan semua error kuadrat tersebut. Inilah kuantitas yang ingin diminimalkan oleh ordinary least squares." - Jason Brownlee
Pada aturan pelatihan sebelumnya, Anda sudah mendapat gambaran bagaimana gradient descent dapat diterapkan di sini. Intinya, gradient descent adalah proses mengoptimalkan nilai koefisien dengan secara iteratif meminimalkan error model pada data pelatihan Anda.
Secara ringkas, ia bekerja dengan memulai dari nilai acak untuk setiap koefisien. Jumlah error kuadrat dihitung untuk setiap pasangan nilai input dan output. Learning rate digunakan sebagai faktor skala, dan koefisien diperbarui ke arah yang meminimalkan error. Proses ini diulang hingga tercapai jumlah error kuadrat minimum atau tidak ada perbaikan lebih lanjut yang mungkin.
Besaran α (learning rate) sangat penting di sini karena menentukan besar langkah perbaikan pada setiap iterasi.
Sekarang ada dua varian umum dari gradient descent:
Itu saja untuk gradient descent dalam tutorial ini. Sekarang, Anda melihat cara lain untuk mengoptimalkan model regresi linear, yaitu Regularisasi.
DataCamp sudah memiliki artikel pengantar yang bagus tentang Regularisasi. Anda mungkin ingin membacanya sebelum melanjutkan yang ini.
Secara umum, metode regularisasi bekerja dengan memberi penalti pada koefisien fitur yang bernilai sangat besar dan dengan demikian berupaya mengurangi error. Ini tidak hanya menghasilkan tingkat error yang lebih baik tetapi juga mengurangi kompleksitas model. Ini sangat berguna ketika Anda menangani dataset dengan jumlah fitur yang besar, dan model dasar Anda tidak mampu membedakan pentingnya fitur (tidak semua fitur dalam dataset sama pentingnya, bukan?).
Ada dua varian prosedur regularisasi untuk regresi linear:
Lasso Regression: menambahkan suku penalti yang setara dengan nilai absolut dari besar koefisien (juga disebut regularisasi L1). Suku penalti terlihat seperti: 
di mana,
Ridge Regression: menambahkan suku penalti yang setara dengan kuadrat dari besar koefisien (juga disebut regularisasi L2). Suku penalti terlihat seperti: 
Tentu saja. Anda telah melihat bagaimana regresi linear dengan elegan memperkenalkan beberapa konsep paling krusial dalam Machine Learning seperti fungsi biaya, optimisasi, hubungan variabel, dan lain-lain. Semua hal ini vital bahkan saat Anda membangun neural network. Penerapannya mungkin berbeda di beberapa tempat, tetapi konsep dasarnya tetap sama persis. Jadi, tanpa memahami hal-hal fundamental ini, Anda tidak akan pernah bisa menalar mengapa neural net Anda tidak berkinerja baik.
Selain itu, konsep sederhana untuk menurunkan hubungan antar variabel melahirkan begitu banyak konsep dan yang terpenting menciptakan satu keluarga algoritme baru - Generalized Linear Models. Jadi bagi praktisi Data Science/Machine Learning/Artificial Intelligence yang bercita-cita, algoritme ini tidak bisa diabaikan. Anda pasti sudah memahaminya sekarang!
Sekarang, Anda akan mengimplementasikan regresi linear sederhana di Python sendiri. Ini akan menyenangkan!
Untuk studi kasus ini, pertama-tama Anda akan menggunakan pustaka Statsmodel untuk Python. Ini adalah pustaka yang sangat populer yang menyediakan kelas dan fungsi untuk estimasi berbagai model statistik, serta untuk melakukan uji statistik, dan eksplorasi data statistik. Untuk datanya, Anda akan menggunakan dataset Boston House yang terkenal. scikit-learn sudah menyertakan dataset ini, jadi Anda tidak perlu mengunduhnya terpisah.
Mari mulai studi kasus dengan mengimpor pustaka statsmodels dan dataset Anda:
import statsmodels.api as sm
from sklearn import datasets

data = datasets.load_boston()
Scikit-learn menyediakan deskripsi dataset yang praktis, dan ini dapat dengan mudah dilihat dengan:
print (data.DESCR)
Boston House Prices dataset
===========================

Notes
------
Data Set Characteristics:

    :Number of Instances: 506

    :Number of Attributes: 13 numeric/categorical predictive

    :Median Value (attribute 14) is usually the target

    :Attribute Information (in order):
        - CRIM     per capita crime rate by town
        - ZN       proportion of residential land zoned for lots over 25,000 sq.ft.
        - INDUS    proportion of non-retail business acres per town
        - CHAS     Charles River dummy variable (= 1 if tract bounds river; 0 otherwise)
        - NOX      nitric oxides concentration (parts per 10 million)
        - RM       average number of rooms per dwelling
        - AGE      proportion of owner-occupied units built prior to 1940
        - DIS      weighted distances to five Boston employment centres
        - RAD      index of accessibility to radial highways
        - TAX      full-value property-tax rate per $10,000
        - PTRATIO  pupil-teacher ratio by town
        - B        1000(Bk - 0.63)^2 where Bk is the proportion of blacks by town
        - LSTAT    % lower status of the population
        - MEDV     Median value of owner-occupied homes in $1000's

    :Missing Attribute Values: None

    :Creator: Harrison, D. and Rubinfeld, D.L.

This is a copy of UCI ML housing dataset.
http://archive.ics.uci.edu/ml/datasets/Housing


This dataset was taken from the StatLib library which is maintained at Carnegie Mellon University.

The Boston house-price data of Harrison, D. and Rubinfeld, D.L. 'Hedonic
prices and the demand for clean air', J. Environ. Economics & Management,
vol.5, 81-102, 1978.   Used in Belsley, Kuh & Welsch, 'Regression diagnostics
...', Wiley, 1980.   N.B. Various transformations are used in the table on
pages 244-261 of the latter.

The Boston house-price data has been used in many machine learning papers that address regression
problems.

**References**

   - Belsley, Kuh & Welsch, 'Regression diagnostics: Identifying Influential Data and Sources of Collinearity', Wiley, 1980. 244-261.
   - Quinlan, R. (1993). Combining Instance-Based and Model-Based Learning. In Proceedings on the Tenth International Conference of Machine Learning, 236-243, University of Massachusetts, Amherst. Morgan Kaufmann.
   - many more! (see http://archive.ics.uci.edu/ml/datasets/Housing)
Sekarang, sebelum menerapkan regresi linear, Anda harus menyiapkan data dan memisahkan fitur dan label pada dataset. MEDV (median home value) adalah label dalam kasus ini. Anda dapat mengakses fitur dataset menggunakan atribut feature_names.
Pengetahuan sedikit tentang pandas akan sangat berguna di sini. Cheat sheet ini wajib dilihat jika Anda ingin menyegarkan konsep dasar pandas.
# Pandas and NumPy import
import numpy as np
import pandas as pd

# Set the features
df = pd.DataFrame(data.data, columns=data.feature_names)

# Set the target
target = pd.DataFrame(data.target, columns=["MEDV"])
Pada titik ini, Anda perlu mempertimbangkan beberapa hal penting tentang regresi linear sebelum menerapkannya pada data. Anda bisa saja mempelajarinya lebih awal di tutorial ini, tetapi mempelajari faktor-faktor ini sekarang akan membantu Anda merasakannya secara nyata.
Sekarang mari praktik langsung. Untuk menyederhanakan, Anda hanya akan mengambil fitur RM — the average number of rooms untuk saat ini. Perhatikan bahwa Statsmodels tidak menambahkan suku konstanta (ingat faktor θ0) secara default. Mari lihat dulu tanpa suku konstanta dalam model regresi Anda:
X = df["RM"]
y = target["MEDV"]

# Fit and make the predictions by the model
model = sm.OLS(y, X).fit()
predictions = model.predict(X)

# Print out the statistics
model.summary()

Apa ini keluaran modelnya! Terlalu besar untuk dipahami saat pertama kali melihatnya. Mari bahas poin-poin paling krusial selangkah demi selangkah:
OLS untuk melatih model regresi linear. RM meningkat 1, nilai prediksi MEDV meningkat 3,634. Ini adalah poin terpenting yang perlu Anda perhatikan untuk saat ini (dan Anda juga bisa mengabaikan peringatannya).
Suku konstanta dapat dengan mudah ditambahkan ke model regresi linear. Anda dapat melakukannya dengan X = sm.add_constant(X) (X adalah nama dataframe yang memuat variabel input/independen).
X = sm.add_constant(X)

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Terlihat jelas bahwa penambahan suku konstanta berdampak langsung pada suku koefisien. Tanpa suku konstanta, model Anda melalui titik asal, tetapi kini Anda memiliki intersep y di -34,67. Sekarang kemiringan prediktor RM juga berubah dari 3,634 menjadi 9,1021 (coef dari RM).
Sekarang Anda akan memasang model regresi dengan lebih dari satu variabel — Anda akan menambahkan LSTAT (persentase status lebih rendah dalam populasi) bersama variabel RM. Prosedur pelatihan (fitting) modelnya persis sama seperti sebelumnya:
X = df[["RM", "LSTAT"]]
y = target["MEDV"]

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Sekarang mari interpretasikan:
Model ini memiliki nilai R-squared yang jauh lebih tinggi — 0,948, yang pada dasarnya berarti model ini menangkap 94,8% varians pada variabel dependen. Sekarang, mari cari hubungan antara dua variabel RM dan LSTAT dengan nilai median rumah. Ketika RM meningkat 1, MEDV akan meningkat 4,9069, dan ketika LSTAT meningkat 1, MEDV akan menurun sebesar 0,6557. Ini menunjukkan bahwa RM dan LSTAT signifikan secara statistik dalam memprediksi (atau mengestimasi) nilai median rumah.
Anda juga dapat menginterpretasikan hubungan ini dengan bahasa sehari-hari:
Lebih masuk akal sekarang, bukan?
Itu tadi contoh regresi linear tunggal dan berganda di Statsmodels. Pekerjaan rumah Anda adalah menyelidiki dan menginterpretasikan hasilnya dengan fitur-fitur lainnya.
Selanjutnya, mari lihat bagaimana regresi linear dapat diimplementasikan menggunakan scikit-learn. Dataset sudah Anda impor, tetapi Anda harus mengimpor kelas linear_model.
from sklearn import linear_model
X = df
y = target["MEDV"]

lm = linear_model.LinearRegression()
model = lm.fit(X,y)
Pelatihan model selesai. Implementasi sklearn ini juga menggunakan OLS. Mari buat beberapa prediksi nilai MEDV untuk lima sampel pertama.
predictions = lm.predict(X)
print(predictions[0:5])
[30.00821269 25.0298606 30.5702317 28.60814055 27.94288232]
Jika Anda ingin mengetahui detail lebih lanjut (seperti R-squared, koefisien, dan lain-lain) dari model Anda, Anda dapat melakukannya dengan mudah.
lm.score(X,y)
0.7406077428649427
lm.coef_
array([-1.07170557e-01,  4.63952195e-02,  2.08602395e-02,  2.68856140e+00,
       -1.77957587e+01,  3.80475246e+00,  7.51061703e-04, -1.47575880e+00,
        3.05655038e-01, -1.23293463e-02, -9.53463555e-01,  9.39251272e-03,
       -5.25466633e-01])
Bagus! Anda berhasil sampai akhir. Membahas salah satu algoritme paling sederhana dan paling fundamental memang tidak mudah, tetapi Anda melakukannya dengan baik. Anda tidak hanya mengenal regresi linear sederhana tetapi juga mempelajari banyak aspek, istilah, dan faktor fundamental machine learning. Anda juga melakukan studi kasus mendalam di Python.
Tutorial ini juga dapat menjadi motivasi bagi Anda untuk mengimplementasikan Regresi Linear dari nol. Berikut langkah-langkah singkat jika ingin benar-benar melakukannya:
Berikut beberapa referensi yang digunakan untuk menyiapkan tutorial ini:
Jika Anda ingin mempelajari lebih jauh tentang linear classifier, ikuti kursus DataCamp Linear Classifiers in Python.
Lihat juga Tutorial Persamaan Normal untuk Regresi Linear.
Kursus Python
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



