
Kurs
Python ile statsmodels kullanarak Regresyona Giriş
4 sa
63.6K
Etkili bir regresyon modeli kurmanın başlıca zorluklarından biri, çoklu doğrusal bağlantı dediğimiz durumdur. Multi-collinearity, bir modeldeki iki veya daha fazla bağımsız değişkenin yüksek düzeyde ilişkili olmasıyla ortaya çıkar ve istatistiksel çıkarımların güvenilirliğini zedeler. Regresyon katsayılarını doğru yorumlamanız ya da onlara olan güveninizi sınamanız gerektiğinde bu büyük bir sorun olabilir.
Burada, çoklu doğrusal bağlantının temel kavramlarını, nasıl tespit edileceğini ve nasıl ele alınacağını anlatacağım. Doğrusal regresyona yeniyseniz başlangıç noktası olarak Basit Doğrusal Regresyon: Bilmeniz Gereken Her Şey eğitimimize göz atın; ancak birden fazla bağımsız değişkenle regresyonu öğreten ve çoklu doğrusal bağlantının ortaya çıkabileceği yer olan R ile Çoklu Doğrusal Regresyon: Örneklerle Eğitim ile devam ettiğinizden emin olun.
Doğru makine öğrenmesi modelleri kurmak zordur çünkü devrede çok fazla etken vardır. Verinin makul bir kaliteye, hacme vb. sahip olması gerekir. Ardından doğru türde makine öğrenmesi algoritmalarını kurmanız gerekir. Ancak bu ikisinin arasında, öngörü modelleri kurmak kadar göz alıcı olmayan, fakat makine öğrenmesinin yaşam döngüsünde çoğu zaman belirleyici olan bir veri hazırlama aşaması vardır.
Veri hazırlama sırasında, regresyon modelindeki bağımsız değişkenlerin ilişkili, yani birbirinden bağımsız olmadığı durum olan çoklu doğrusal bağlantıya dikkat ederiz. Bu, model için iyi bir işaret değildir; çünkü çoklu doğrusal bağlantı, regresyon katsayılarının tahminini bozma, standart hataları şişirme ve dolayısıyla modelin istatistiksel gücünü azaltma eğilimindedir. Bu durum ayrıca modeldeki tek tek değişkenlerin önemini belirlemeyi de zorlaştırır.
Çoklu doğrusal bağlantı iki ana biçimde görülebilir; her biri, regresyon modelindeki bağımsız değişkenlerin etkileşimini ve ortaya çıkan tahminlerin güvenilirliğini farklı şekilde etkiler.
Mükemmel çoklu doğrusal bağlantı, bir regresyon modelindeki bağımsız değişkenlerden birinin, diğer bir veya daha fazla bağımsız değişken kullanılarak tam olarak tahmin edilebildiği durumda ortaya çıkar. Bu, aralarında kusursuz bir ilişki olduğu anlamına gelir.
İki değişkeniniz olduğunu hayal edin: X1 ve X2, ve aralarındaki ilişki şu denklemle veriliyor: X1 = 2*X2 + 3. Bu, modelin X1 ve X2 etkilerini birbirinden ayıramayacağı anlamına gelir; çünkü esasen aynı hikâyeyi anlatmaktadırlar. Başka bir deyişle, bir değişken diğerinin mükemmel bir doğrusal fonksiyonudur.
Mükemmel olmayan çoklu doğrusal bağlantıda değişkenler yüksek düzeyde ilişkilidir, ancak mükemmel çoklu doğrusal bağlantıdaki gibi bire bir değildir. Değişkenler yüksek korelasyon paylaşabilir; yani bir değişken değiştiğinde diğeri de değişme eğilimindedir, ancak bu tam bir tahmin değildir.
Bu durumda model sonuç üretmez değildir. Sorun şu ki bu sonuçlar kararsız olabilir; yani verideki küçük değişiklikler bile tahmin edilen katsayılarda büyük değişimlere yol açabilir. Bu da her bir değişkenin önemini güvenilir şekilde yorumlamayı zorlaştırır.
Yapısal çoklu doğrusal bağlantı, değişkenlerin doğal ilişkilerinden ziyade modelin nasıl kurulduğundan kaynaklanır. Bu çoğunlukla modele etkileşim terimleri veya polinom terimleri dahil edildiğinde görülür.
Örneğin, bir değişkenin etki büyüklüğünün başka bir değişken arttıkça arttığını düşünüyorsanız, bir etkileşim terimi eklemeyi düşünebilirsiniz. Ancak sorun şu ki bu değişkenler zaten bir miktar ilişkiliyse, etkileşim terimi eklemek bunu aşırıya kaçırabilir ve çoklu doğrusal bağlantı sorunlarına yol açabilir.
Çoklu doğrusal bağlantı, bağımsız değişkenler (yordayıcılar) ile bağımlı değişken (sonuç) arasındaki ilişkiyi tahmin etmeye çalışırken sorunlar yaratarak regresyon analizini etkiler. Özellikle, çoklu doğrusal bağlantı katsayı tahminlerinin varyansını artırır ve bunları modeldeki ya da verideki küçük değişikliklere duyarlı hale getirir.
Katsayılar kararsız hale geldiğinde, standart hatalar büyür ve bu da, değişkenler gerçekte önemli olsa bile anlamsız p-değerlerine yol açabilir. Çoklu doğrusal bağlantının modelin genel öngörü gücünü etkilemediğini bilmek önemlidir. Ancak, hataları şişirip tahminleri kararsızlaştırdığı için modelin yorumlanmasını etkiler.
Çoklu doğrusal bağlantıyı tespit etmek için birkaç tanısal araca ihtiyaç vardır. Bunları, Kaggle’daki Konut Fiyatları Yarışması’ndan alınmış veri kümesinin bir alt kümesini kullanarak inceleyeceğiz. Kullanacağımız veri alt kümesini bu GitHub deposunda bulabilirsiniz. Aşağıdaki kodla veri kümesini yükleyip keşfedelim:
import pandas as pd
import numpy as np
import seaborn as sns
from statsmodels.stats.outliers_influence import variance_inflation_factor

df = pd.read_csv('mc_df.csv')
df.head()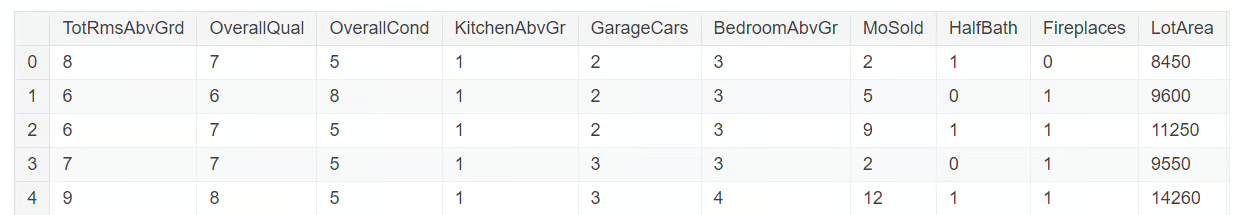
Çoklu doğrusal bağlantıyı tespit etmek için yaygın kullanılan tekniklerden biri, değişkenler arasındaki ilişkilerin gücünü görselleştirmeye yardımcı olan bir korelasyon matrisidir. Matris, değişkenler arasındaki ikili korelasyon katsayılarını gösterir; bu, doğrusal olarak ne kadar güçlü ilişkilendiklerini gösterir (değerler -1 ile 1 arasında değişir). Kullandığım bir kural, mutlak korelasyon değerlerinin 0,6’nın üzerinde olmasının güçlü çoklu doğrusal bağlantıya işaret ettiğidir.
Çoklu doğrusal bağlantı bağımsız değişkenler için tespit edildiğinden, veri kümemizden hedef değişkeni, SalePrice’ı çıkarmamız gerekir. Bu, aşağıdaki kodla yapılır.
multi_c_df = multi_c_df.drop('SalePrice', axis=1)Artık korelasyon analizi için hazırız. Aşağıdaki kod, multi_c_df DataFrame’i için korelasyon matrisini hesaplar. Korelasyonlar hesaplandıktan sonra kod, matrisi ısı haritası olarak görsel olarak temsil etmek için Seaborn’un heatmap() fonksiyonunu kullanır. annot=True argümanı, sayısal korelasyon değerlerini doğrudan ısı haritasına ekler.
# Correlation matrix
correlation_matrix = multi_c_df.corr()

# Set up the matplotlib figure
plt.figure(figsize=(10, 6))

# Create a heatmap for the correlation matrix
sns.heatmap(correlation_matrix, annot=True, cmap="coolwarm", fmt=".2f", linewidths=0.5)

# Title for the heatmap
plt.title("Correlation Heatmap", fontsize=16)

# Show the heatmap
plt.show()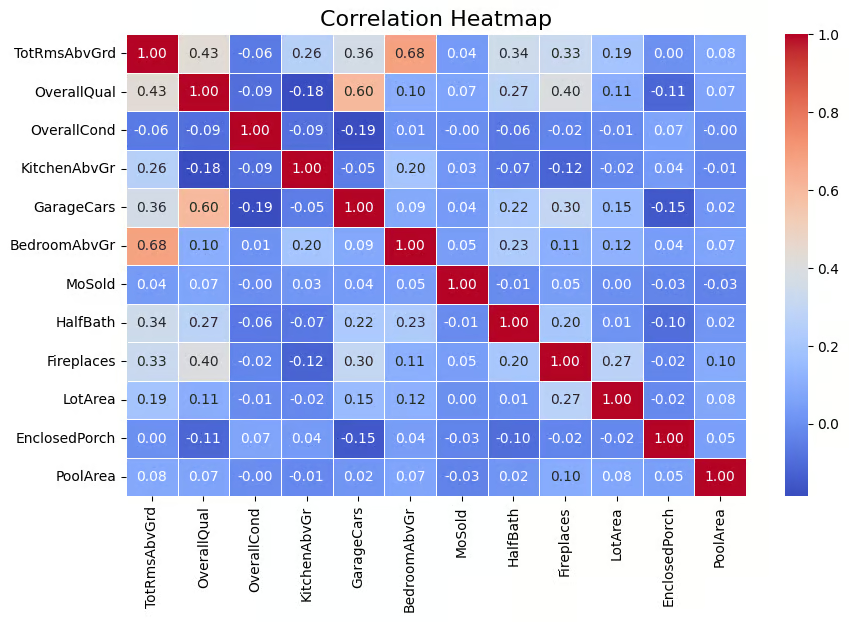
Isı haritasıyla temsil edilen korelasyon matrisi. Görsel: Yazar
Yukarıdaki çıktı, bazı bağımsız değişkenler arasında korelasyon olduğunu gösteriyor. Örneğin, BedroomAbvGr ve TotRmsAbvGrd görece yüksek bir korelasyona (0,68) sahip. Ayrıca GarageCars ve OverallQual arasında 0,60 korelasyon var; bu da ilişkili olduklarını gösteriyor. Dolayısıyla, en azından bu değişkenlerin bir kısmında çoklu doğrusal bağlantı olabileceğini düşündüren kayda değer korelasyona sahip bağımsız değişkenler mevcut.
Bu noktada, değişkenler arasında bariz bir ikili korelasyon olmasa bile çoklu doğrusal bağlantının ortaya çıkabileceğini not etmek çok önemlidir; çünkü bir değişken, birden fazla diğer değişkenin doğrusal bir kombinasyonu ile ilişkili olabilir. Bu yüzden bir sonraki bölümde ele alacağımız varyans şişirme faktörünü de (VIF) dikkate almak önemlidir.
Varyans şişirme faktörü (VIF), çoklu doğrusal bağlantıyı tespit etmek için en yaygın tekniklerden biridir. Basitçe söylemek gerekirse, çoklu doğrusal bağlantı nedeniyle bir regresyon katsayısının varyansının ne kadar şiştiğini gösteren sayısal bir değer sağlar. 5’ten büyük VIF değeri orta düzeyde, 10’un üzerindeki değerler ise ciddi çoklu doğrusal bağlantıya işaret eder.
Bunu veri kümemizde inceleyelim. Şimdi bu bağımsız değişkenlerin her biri için VIF değerini hesaplayacağız. Bu görev, aşağıdaki kodda variance_inflation_factor() fonksiyonu ile gerçekleştirilir.
# Calculate VIF for each numerical feature
vif_data = pd.DataFrame()
vif_data["feature"] = multi_c_df.columns

# Calculate VIF and round to 4 decimal places
vif_data["VIF"] = [round(variance_inflation_factor(multi_c_df.values, i), 4) for i in range(df.shape[1])]

# Sort VIF values in descending order
vif_data = vif_data.sort_values(by="VIF", ascending=False)

# Display the VIF DataFrame
print(vif_data)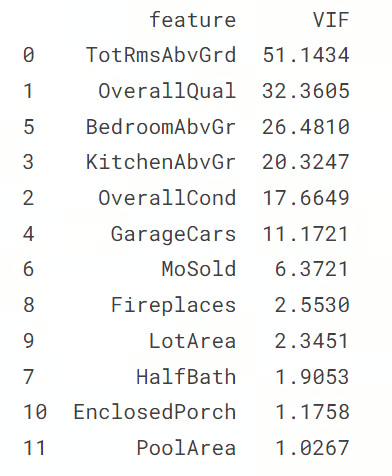
Sayısal değişkenler için VIF değeri. Görsel: Yazar
10’dan büyük VIF değerine sahip birkaç değişken olduğunu görebilirsiniz; bu da çoklu doğrusal bağlantının varlığına işaret eder.
Koşul indeksi, çoklu doğrusal bağlantıyı tespit etmek için kullanılan bir diğer tanı aracıdır; 10’un üzerindeki değerler orta düzeyde, 30’un üzerindeki değerler ise ciddi çoklu doğrusal bağlantıya işaret eder. Koşul indeksi, özdeğerler arasındaki ilişkileri inceleyerek bağımsız değişkenlerin birbirleriyle ne kadar ilişkili olduğunu kontrol eder.
Aşağıdaki kod, bir regresyon modelinde çoklu doğrusal bağlantıyı kontrol etmek için koşul indeksini hesaplar. Önce korelasyon matrisinin (değişkenler arasındaki ilişkileri gösteren) özdeğerlerini hesaplar. Ardından, en büyük özdeğerin en küçük özdeğere bölünmesiyle koşul indeksi elde edilir.
from numpy.linalg import eigvals

# Calculate the condition index
eigenvalues = eigvals(correlation_matrix)
condition_index = max(eigenvalues) / min(eigenvalues)

print(f'Condition Index: {condition_index}')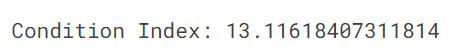
Bizim durumumuzda koşul indeksi değeri 13’tür; bu da modelde orta düzeyde çoklu doğrusal bağlantıya işaret eder. Koşul indeksine göre bu düzey ciddi olmasa da, regresyon katsayısı tahminlerinin hassasiyetini etkileyebilir ve ilişkili değişkenlerin bireysel katkılarını ayırt etmeyi zorlaştırabilir. Özdeğerler hakkında daha fazla bilgi almak isterseniz Özvektörler ve Özdeğerler: Veri Bilimi İçin Temel İçgörüler yazımızı okuyun.
Regresyon modellerinde çoklu doğrusal bağlantıyı etkili bir şekilde yönetmek için uygulanabilecek çeşitli teknikler vardır. Bu yöntemler, bağımsız değişkenler birbirine yakın ilişkili olsa bile modelin doğru ve yorumlanabilir kalmasına yardımcı olur.
Çoklu doğrusal bağlantıyla başa çıkmanın en basit yollarından biri, genellikle en yüksek VIF değerine sahip olan yüksek korelasyonlu değişkenlerden birini kaldırmaktır. Bu etkili olmakla birlikte, dikkatli yapılmazsa faydalı bilgilerin kaybına yol açabilir.
Bir diğer teknik de, iki veya daha fazla değişken yüksek korelasyon gösterdiğinde, Bunları Temel Bileşenler Analizi (PCA) gibi tekniklerle tek bir yordayıcıda birleştirmektir. Bu, en kritik bilgiyi korurken modelin boyutunu azaltır. Başlıca dezavantajı, PCA’nin arkasındaki bilim ve matematiği teknik olmayan bir kitleye açıklamanın zor olması nedeniyle yorumlanabilirliğin azalmasıdır.
Veri bilimciler için, ridge ve lasso regresyonu ile düzenlileştirme (regularization) uygulamak, çoklu doğrusal bağlantı sorunuyla başa çıkmada bir başka popüler tekniktir. Bu düzenlileştirme yöntemleri, regresyon modeline cezalar uygular; ilişkili değişkenlerin katsayılarını küçülterek çoklu doğrusal bağlantının etkilerini hafifletir.
Çoklu doğrusal bağlantıyla uğraşırken, zayıf model performansına yol açabilecek birkaç yaygın hata vardır. Bu hataların farkında olmak ve en iyi uygulamaları izlemek, daha güvenilir regresyon modelleri oluşturmak için önemlidir.
Bir değişken için yüksek bir varyans şişirme faktörü (VIF) gördüğünüzde, bunun çoklu doğrusal bağlantıya neden olduğunu varsayarak o değişkeni modelden hemen çıkarmak cazip gelebilir. Ancak bu bir hata olabilir; çünkü VIF’i yüksek olan bir değişken yine de sonucu tahmin etmek için çok önemli olabilir. Önem puanını kontrol etmeden onu kaldırırsanız, modeliniz daha kötü performans gösterebilir. Esas olan, kaldırmaya karar vermeden önce değişkenin vazgeçilmez olup olmadığını dikkatle değerlendirmektir.
Korelasyon matrisi, değişkenler arasındaki ilişkinin büyüklüğünü ve yönünü belirlemede yararlı bir tekniktir; ancak yalnızca doğrusal ilişkileri gösterir. Peki ya karmaşık, doğrusal olmayan ilişkiler? Ne yazık ki, matris bunu yakalamaz. Dolayısıyla yalnızca bir korelasyon matrisine dayanmak size tam bir resim vermez. Bu yüzden daha kapsamlı bir görünüm için VIF ve koşul indeksi gibi diğer metrikleri kullanmak önemlidir.
Geleneksel yaklaşımlara ek olarak, çoklu doğrusal bağlantı sorununu ele almak için kullanılabilecek çeşitli gelişmiş yöntemler de vardır. Bu tekniklerden bazıları aşağıda tartışılmaktadır.
RFE (Özyinelemeli Özellik Eleme) gibi otomatik özellik seçimi yöntemleri iyi bir alternatif olabilir. Bu yöntemler, her yordayıcının önemini analiz eder ve çok değer katmayanları otomatik olarak kaldırır. Bu, süreci sadeleştirir; hangi değişkenlerin kaldırılacağına elle karar vermeden çoklu doğrusal bağlantıyı azaltmayı kolaylaştırır.
Örneklem büyüklüğünü artırmak, veri kümesine daha fazla çeşitlilik katarak çoklu doğrusal bağlantıyı azaltabilir ve farklı yordayıcıların katkılarını ayırt etmeyi kolaylaştırır. Bu nedenle bir diğer çözüm, basitçe daha fazla veri toplamaktır. Veri kümesinin boyutu arttığında, değişkenlere daha fazla çeşitlilik eklenir ve farklı yordayıcıların etkilerini ayırt etmek kolaylaşır. Bu da çoklu doğrusal bağlantının etkisini azaltmaya yardımcı olur.
Dayanıklı ve yorumlanabilir regresyon modelleri kurmak için çoklu doğrusal bağlantıyı anlamak ve ele almak kritik önemdedir. VIF, korelasyon matrisleri ve koşul indeksi gibi tekniklerle çoklu doğrusal bağlantıyı tespit ederek ve lasso ve ridge regresyonu ya da gereksiz yordayıcıları kaldırma gibi yöntemlerle gidererek, güvenilir ve anlamlı model sonuçları elde edebilirsiniz. Regresyon modellerinizde daima çoklu doğrusal bağlantıyı kontrol edin ve analizlerinizin bütünlüğünü korumak için uygun çözümleri uygulayın.
Daha fazla öğrenmek ve favori çalışma ortamınızda doğrusal regresyonu nasıl yapacağınıza dair tazeleme için aşağıdaki kaynakları incelemeyi düşünün:
DataCamp ile öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




