
Khóa học
Giới thiệu về Hồi quy với statsmodels trong Python
4 giờ
62.7K
Một trong những thách thức lớn khi xây dựng mô hình hồi quy hiệu quả là hiện tượng gọi là đa cộng tuyến. Đa cộng tuyến xuất hiện khi hai hoặc nhiều biến độc lập trong mô hình có tương quan cao, dẫn đến suy luận thống kê thiếu tin cậy. Đây có thể là vấn đề lớn nếu bạn cần diễn giải chính xác các hệ số hồi quy hoặc kiểm định độ tin cậy của chúng.
Tại đây, tôi sẽ hướng dẫn bạn những khái niệm cốt lõi về đa cộng tuyến, cách phát hiện và cách xử lý. Nếu bạn mới bắt đầu với hồi quy tuyến tính, hãy đọc bài hướng dẫn Hồi quy tuyến tính đơn: Mọi điều bạn cần biết làm điểm khởi đầu, và nhớ theo dõi tiếp Hồi quy tuyến tính bội trong R: Hướng dẫn kèm ví dụ, bài này dạy về hồi quy với nhiều biến độc lập — nơi đa cộng tuyến có thể xuất hiện.
Xây dựng mô hình máy học chính xác là nhiệm vụ đầy thách thức vì có rất nhiều yếu tố tác động. Dữ liệu cần đảm bảo chất lượng, dung lượng, v.v. Sau đó bạn cần xây dựng đúng loại thuật toán. Tuy nhiên, ở giữa hai khâu đó là giai đoạn chuẩn bị dữ liệu — không “hào nhoáng” như xây dựng mô hình dự báo, nhưng lại thường là yếu tố quyết định thành bại trong vòng đời dự án máy học.
Trong giai đoạn chuẩn bị dữ liệu, chúng ta cần chú ý đến đa cộng tuyến, xảy ra khi các biến độc lập trong mô hình hồi quy có tương quan, tức là chúng không thực sự độc lập với nhau. Đây là dấu hiệu không tốt cho mô hình, vì đa cộng tuyến thường làm sai lệch ước lượng hệ số hồi quy, làm phồng sai số chuẩn, từ đó giảm sức mạnh thống kê của mô hình. Nó cũng khiến việc xác định tầm quan trọng của từng biến trở nên khó khăn.
Đa cộng tuyến có hai dạng chính, mỗi dạng ảnh hưởng đến cách các biến độc lập tương tác trong mô hình hồi quy và độ tin cậy của các ước lượng thu được.
Đa cộng tuyến hoàn hảo xảy ra khi một biến độc lập trong mô hình có thể được dự đoán chính xác từ một hoặc nhiều biến độc lập khác. Nghĩa là có mối quan hệ hoàn hảo giữa chúng.
Hãy hình dung bạn có hai biến X1 và X2, và chúng liên hệ theo phương trình: X1 = 2*X2 + 3. Điều này đồng nghĩa mô hình hồi quy sẽ không thể tách biệt ảnh hưởng của X1 và X2 vì về bản chất chúng đang kể cùng một câu chuyện. Nói cách khác, một biến là hàm tuyến tính hoàn hảo của biến kia.
Trong đa cộng tuyến không hoàn hảo, các biến có tương quan cao nhưng không theo dạng một-một hoàn hảo như trường hợp trên. Các biến có thể cùng thay đổi theo nhau ở mức độ cao, nhưng không thể dự đoán chính xác tuyệt đối.
Trong tình huống này, mô hình vẫn cho ra kết quả. Vấn đề là kết quả có thể không ổn định, nghĩa là chỉ cần thay đổi nhỏ trong dữ liệu cũng có thể dẫn đến biến động lớn ở các hệ số ước lượng. Điều này khiến việc diễn giải tầm quan trọng của từng biến trở nên kém tin cậy.
Đa cộng tuyến cấu trúc phát sinh từ cách mô hình được xây dựng, hơn là từ mối quan hệ tự nhiên giữa các biến. Điều này thường xảy ra khi bạn đưa vào mô hình các biến tương tác hoặc các hạng đa thức.
Ví dụ, nếu bạn cho rằng độ lớn tác động của một biến tăng lên khi một biến khác tăng, bạn có thể cân nhắc thêm biến tương tác. Tuy nhiên, nếu các biến này vốn đã có tương quan nhất định, việc thêm biến tương tác có thể “quá tay” và dẫn đến vấn đề đa cộng tuyến.
Đa cộng tuyến ảnh hưởng đến phân tích hồi quy bằng cách gây khó khăn khi ước lượng mối quan hệ giữa các biến độc lập (biến dự báo) và biến phụ thuộc (kết quả). Cụ thể, đa cộng tuyến làm tăng phương sai của các ước lượng hệ số, khiến chúng nhạy cảm với thay đổi nhỏ trong mô hình hoặc dữ liệu.
Khi hệ số trở nên không ổn định, sai số chuẩn tăng lên, điều này có thể dẫn đến p-value không có ý nghĩa ngay cả khi biến thực sự quan trọng. Lưu ý rằng đa cộng tuyến không ảnh hưởng đến năng lực dự báo tổng thể của mô hình, nhưng nó ảnh hưởng đến khả năng diễn giải vì mô hình sẽ có sai số phồng lên và ước lượng kém ổn định.
Phát hiện đa cộng tuyến cần dùng một số công cụ chẩn đoán. Chúng ta sẽ khám phá các công cụ này bằng một tập con dữ liệu lấy từ cuộc thi Housing Prices trên Kaggle. Bạn có thể tìm tập dữ liệu con mà chúng ta dùng tại kho GitHub này. Hãy tải và khám phá dữ liệu với đoạn mã dưới đây:
import pandas as pd
import numpy as np
import seaborn as sns
from statsmodels.stats.outliers_influence import variance_inflation_factor

df = pd.read_csv('mc_df.csv')
df.head()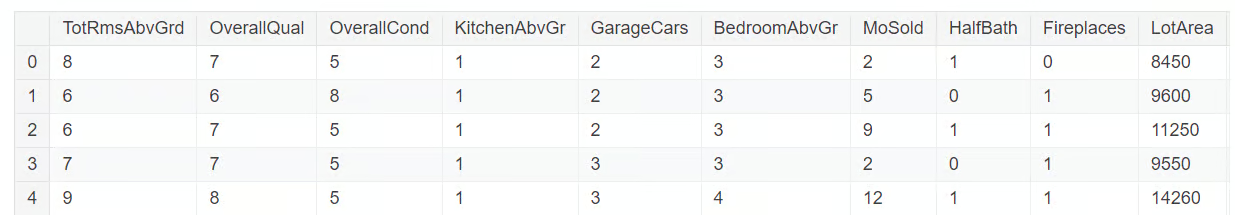
Một kỹ thuật phổ biến để phát hiện đa cộng tuyến là dùng ma trận tương quan nhằm trực quan hóa độ mạnh của mối quan hệ giữa các biến. Ma trận hiển thị hệ số tương quan theo cặp giữa các biến, cho thấy mức độ quan hệ tuyến tính (giá trị từ -1 đến 1). Quy tắc kinh nghiệm tôi dùng là giá trị tương quan tuyệt đối trên 0.6 cho thấy đa cộng tuyến mạnh.
Vì đa cộng tuyến được xem xét ở các biến độc lập, chúng ta cần loại bỏ biến đích SalePrice khỏi dữ liệu. Thao tác này thực hiện bằng đoạn mã sau.
multi_c_df = multi_c_df.drop('SalePrice', axis=1)Giờ chúng ta sẵn sàng cho phân tích tương quan. Đoạn mã dưới tính ma trận tương quan cho DataFrame multi_c_df. Sau khi tính tương quan, mã sử dụng hàm heatmap() của Seaborn để biểu diễn ma trận tương quan dưới dạng bản đồ nhiệt. Tham số annot=True sẽ hiển thị trực tiếp các giá trị tương quan trên biểu đồ.
# Correlation matrix
correlation_matrix = multi_c_df.corr()

# Set up the matplotlib figure
plt.figure(figsize=(10, 6))

# Create a heatmap for the correlation matrix
sns.heatmap(correlation_matrix, annot=True, cmap="coolwarm", fmt=".2f", linewidths=0.5)

# Title for the heatmap
plt.title("Correlation Heatmap", fontsize=16)

# Show the heatmap
plt.show()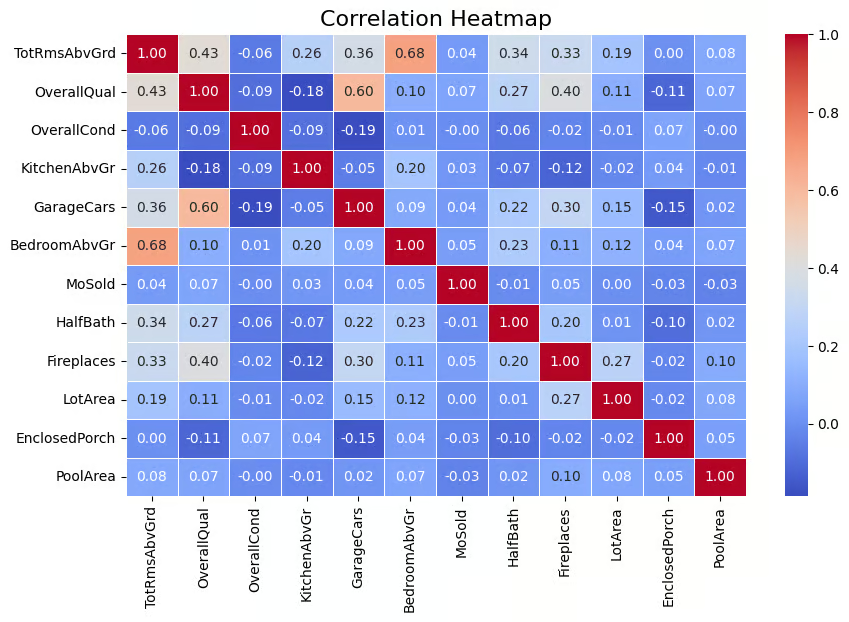
Ma trận tương quan dưới dạng bản đồ nhiệt. Ảnh: Tác giả
Kết quả trên cho thấy có tương quan giữa một số biến độc lập. Chẳng hạn, BedroomAbvGr và TotRmsAbvGrd có tương quan tương đối cao (0.68). Ngoài ra, GarageCars và OverallQual có tương quan 0.60, cho thấy chúng cũng liên quan. Như vậy có các biến độc lập tương quan đáng kể, gợi ý sự hiện diện của đa cộng tuyến ở một phần, nếu không phải tất cả, các biến này.
Tại thời điểm này, cần lưu ý rằng đa cộng tuyến có thể phát sinh ngay cả khi không có tương quan theo cặp rõ ràng giữa các biến, vì một biến có thể tương quan với tổ hợp tuyến tính của nhiều biến khác. Đó là lý do cần xem xét thêm hệ số phóng đại phương sai (VIF), nội dung chúng ta sẽ đề cập tiếp theo.
VIF là một trong những kỹ thuật phổ biến để phát hiện đa cộng tuyến. Hiểu đơn giản, nó cho một giá trị số chỉ ra mức độ phương sai của hệ số hồi quy bị phóng đại do đa cộng tuyến. VIF lớn hơn 5 cho thấy đa cộng tuyến ở mức vừa, còn trên 10 cho thấy đa cộng tuyến nghiêm trọng.
Hãy áp dụng trên dữ liệu của chúng ta. Chúng ta sẽ tính VIF cho từng biến độc lập. Nhiệm vụ này được thực hiện bằng variance_inflation_factor() trong đoạn mã dưới đây.
# Calculate VIF for each numerical feature
vif_data = pd.DataFrame()
vif_data["feature"] = multi_c_df.columns

# Calculate VIF and round to 4 decimal places
vif_data["VIF"] = [round(variance_inflation_factor(multi_c_df.values, i), 4) for i in range(df.shape[1])]

# Sort VIF values in descending order
vif_data = vif_data.sort_values(by="VIF", ascending=False)

# Display the VIF DataFrame
print(vif_data)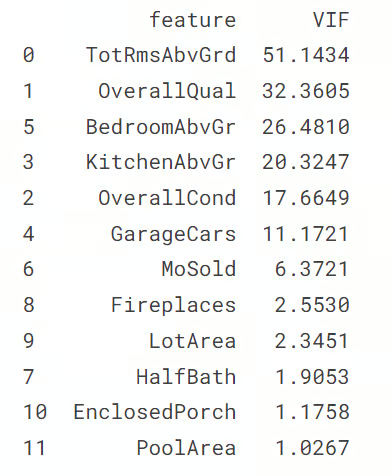
Giá trị VIF cho các biến số. Ảnh: Tác giả
Bạn có thể thấy một số biến có VIF lớn hơn 10, cho thấy sự hiện diện của đa cộng tuyến.
Chỉ số điều kiện là một công cụ chẩn đoán khác để phát hiện đa cộng tuyến; giá trị trên 10 cho thấy đa cộng tuyến vừa, còn trên 30 cho thấy đa cộng tuyến nghiêm trọng. Chỉ số điều kiện hoạt động bằng cách kiểm tra mức độ liên quan giữa các biến độc lập thông qua mối quan hệ giữa các trị riêng (eigenvalue) của chúng.
Đoạn mã dưới đây tính chỉ số điều kiện để kiểm tra đa cộng tuyến trong mô hình hồi quy. Trước hết, nó tính các trị riêng của ma trận tương quan (thể hiện mối quan hệ giữa các biến). Sau đó chỉ số điều kiện được tính bằng cách lấy trị riêng lớn nhất chia cho trị riêng nhỏ nhất.
from numpy.linalg import eigvals

# Calculate the condition index
eigenvalues = eigvals(correlation_matrix)
condition_index = max(eigenvalues) / min(eigenvalues)

print(f'Condition Index: {condition_index}')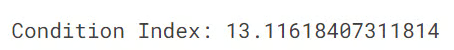
Trong trường hợp của chúng ta, chỉ số điều kiện là 13, cho thấy đa cộng tuyến mức vừa trong mô hình. Mặc dù mức đa cộng tuyến này, theo chỉ số điều kiện, không nghiêm trọng, nó vẫn có thể ảnh hưởng đến độ chính xác của ước lượng hệ số hồi quy và khiến việc phân biệt đóng góp riêng lẻ của các biến tương quan trở nên khó khăn hơn. Nếu bạn muốn tìm hiểu thêm về trị riêng, hãy đọc bài viết Eigenvectors and Eigenvalues: Key Insights for Data Science.
Để quản lý hiệu quả đa cộng tuyến trong các mô hình hồi quy, có một số kỹ thuật có thể áp dụng. Những phương pháp này giúp mô hình vẫn chính xác và có thể diễn giải, ngay cả khi các biến độc lập có liên hệ chặt chẽ.
Một cách đơn giản là loại bỏ một trong các biến có tương quan cao, thường là biến có VIF lớn nhất. Cách này hiệu quả, nhưng nhược điểm là có thể làm mất thông tin hữu ích nếu không cân nhắc cẩn thận.
Một kỹ thuật khác: khi hai hoặc nhiều biến tương quan cao, ta có thể kết hợp chúng thành một biến dự báo duy nhất bằng các kỹ thuật như Phân tích thành phần chính (PCA). Điều này giảm số chiều của mô hình nhưng vẫn giữ lại thông tin quan trọng nhất. Nhược điểm lớn là mất tính diễn giải vì khó giải thích cơ sở khoa học và toán học của PCA cho đối tượng không chuyên.
Đối với các nhà khoa học dữ liệu, áp dụng kỹ thuật regularization như ridge và lasso là phương pháp phổ biến để xử lý đa cộng tuyến. Các kỹ thuật này áp dụng hệ số phạt vào mô hình hồi quy, làm co nhỏ các hệ số của biến tương quan, nhờ đó giảm thiểu tác động của đa cộng tuyến.
Khi xử lý đa cộng tuyến, có một số lỗi thường gặp có thể dẫn đến hiệu năng mô hình kém. Điều quan trọng là nhận diện các lỗi này và tuân theo thực hành tốt để xây dựng các mô hình hồi quy đáng tin cậy hơn.
Khi thấy một biến có VIF cao, bạn dễ bị cám dỗ loại ngay biến đó khỏi mô hình, cho rằng nó gây ra đa cộng tuyến. Tuy nhiên, đây có thể là sai lầm vì dù VIF cao, biến đó vẫn có thể rất quan trọng cho dự báo. Nếu loại bỏ mà không kiểm tra điểm quan trọng của biến, mô hình có thể kém hiệu quả hơn. Mấu chốt là đánh giá cẩn thận xem biến đó có thiết yếu hay không trước khi quyết định loại bỏ.
Ma trận tương quan hữu ích để xác định độ lớn và chiều của mối quan hệ giữa các biến, nhưng chỉ phản ánh các quan hệ tuyến tính. Còn các quan hệ phi tuyến phức tạp thì sao? Đáng tiếc, ma trận sẽ không nắm bắt được. Vì vậy chỉ dựa vào ma trận tương quan sẽ không cho bức tranh đầy đủ. Do đó, cần sử dụng thêm các thước đo như VIF và chỉ số điều kiện để có góc nhìn toàn diện hơn.
Bên cạnh các cách tiếp cận truyền thống, còn có một số phương pháp nâng cao để xử lý vấn đề đa cộng tuyến. Một vài kỹ thuật được thảo luận dưới đây.
Các phương pháp chọn lọc đặc trưng tự động như Recursive Feature Elimination (RFE) có thể là lựa chọn tốt. Chúng phân tích tầm quan trọng của từng biến dự báo và tự động loại bỏ những biến không mang lại nhiều giá trị. Điều này giúp tinh gọn quy trình, giảm đa cộng tuyến mà không cần quyết định thủ công nên bỏ biến nào.
Tăng kích thước mẫu có thể giảm đa cộng tuyến bằng cách bổ sung thêm biến thiên cho tập dữ liệu, giúp dễ phân biệt đóng góp của các biến dự báo khác nhau. Vì vậy một giải pháp khác là đơn giản là thu thập thêm dữ liệu. Khi kích thước dữ liệu tăng lên, biến thiên của các biến cũng tăng, giúp phân biệt tác động của các biến dự báo khác nhau dễ hơn, từ đó giảm ảnh hưởng của đa cộng tuyến.
Hiểu và xử lý đa cộng tuyến là tối quan trọng để xây dựng các mô hình hồi quy vững và có thể diễn giải. Bằng cách phát hiện đa cộng tuyến với các kỹ thuật như VIF, ma trận tương quan và chỉ số điều kiện, rồi xử lý bằng các phương pháp như hồi quy lasso và ridge hoặc loại bỏ biến dư thừa, bạn có thể đảm bảo kết quả mô hình đáng tin cậy và có ý nghĩa. Hãy luôn kiểm tra đa cộng tuyến trong các mô hình hồi quy và áp dụng giải pháp phù hợp để giữ vững tính toàn vẹn của phân tích.
Để học thêm và ôn lại cách thực hiện hồi quy tuyến tính trong không gian làm việc ưa thích của bạn, hãy tham khảo các nguồn sau:
Học cùng DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
