
Kursus
Prompt Engineering dengan OpenAI API
4 jam
55.8K
OpenAI baru saja merilis model yang telah lama dinantikan dengan kemampuan “penalaran setara PhD,” dan itu bukan GPT-5 seperti yang banyak dari kita duga—melainkan model OpenAI o1.
Cara kerja OpenAI o1 menandai pergeseran paradigma penting dalam alokasi sumber daya komputasi, dengan penekanan lebih besar pada fase pelatihan dan inferensi. Pendekatan ini membuatnya sangat unggul dalam tugas penalaran kompleks tetapi juga jauh lebih lambat dibandingkan saudaranya, GPT-4o dan GPT-4o mini.
Meski begitu, GPT-4o dan GPT-4o mini tetap menjadi pilihan utama untuk aplikasi yang memerlukan respons cepat, penanganan gambar, atau function calling. Namun, jika proyek Anda membutuhkan kemampuan penalaran tingkat lanjut dan dapat mentolerir waktu respons yang sedikit lebih lama, model o1 adalah pilihan yang tepat.
Saya berkesempatan mengeksplorasi o1 melalui API OpenAI, dan di blog ini, saya akan memberikan panduan langkah demi langkah tentang cara melakukannya. Saya akan menunjukkan cara terhubung ke API, mengelola biaya, dan di akhir, saya akan berbagi beberapa tips prompting untuk membantu Anda meminimalkan pengeluaran dan mendapatkan respons yang lebih baik.
Jika Anda mencari artikel yang lebih pengantar, lihat Panduan OpenAI o1 ini.
Catatan: Pada saat penulisan tutorial ini, model o1 masih dalam versi beta. Namun, proses untuk terhubung ke API tetap sama.
Salah satu hal pertama yang perlu Anda ketahui adalah, untuk saat ini, mengakses model o1 melalui API memerlukan tingkat penggunaan Tier 5.
|
Tier |
Kualifikasi |
Batas penggunaan |
|
Gratis |
Pengguna harus berada di wilayah yang diizinkan |
$100 / bulan |
|
Tier 1 |
Pembayaran $5 |
$100 / bulan |
|
Tier 2 |
Pembayaran $50 dan 7+ hari sejak pembayaran pertama berhasil |
$500 / bulan |
|
Tier 3 |
Pembayaran $100 dan 7+ hari sejak pembayaran pertama berhasil |
$1.000 / bulan |
|
Tier 4 |
Pembayaran $250 dan 14+ hari sejak pembayaran pertama berhasil |
$5.000 / bulan |
|
Tier 5 |
Pembayaran $1.000 dan 30+ hari sejak pembayaran pertama berhasil |
$50.000 / bulan |
Untuk memeriksa tier penggunaan Anda, buka halaman akun Anda di platform pengembang OpenAI dan lihat bagian Limits di bawah Organization.
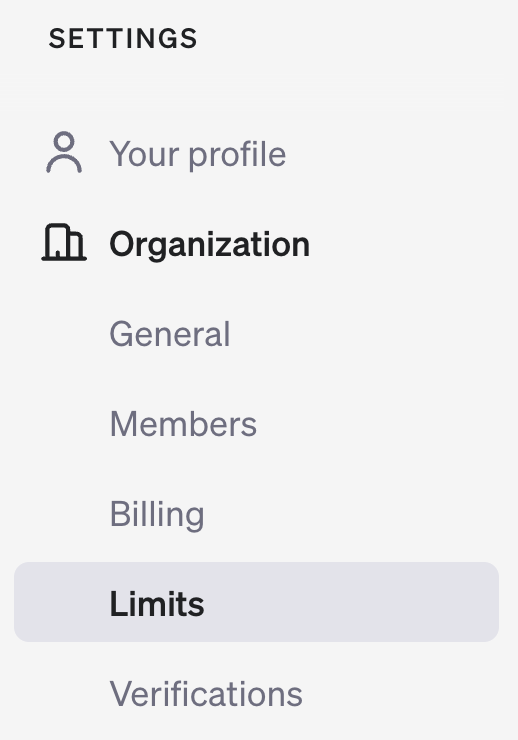
Setiap tier penggunaan memiliki batas laju tersendiri. Pada saat artikel ini ditulis, berikut batas laju untuk Tier 5:
|
Model |
RPM (Permintaan per Menit) |
TPM (Token per Menit) |
Batas Antrean Batch |
|
gpt-4o |
10.000 |
30.000.000 |
5.000.000.000 |
|
gpt-4o-mini |
30.000 |
150.000.000 |
15.000.000.000 |
|
o1-preview |
500 |
30.000.000 |
saat ini tidak didukung |
|
o1-mini |
1000 |
150.000.000 |
saat ini tidak didukung |
Model O1 memerlukan waktu proses yang cukup lama pada fase inferensi, yang menjelaskan batas RPM lebih rendah dibanding model GPT-4o. Perlu dicatat bahwa batching saat ini tidak didukung untuk model o1, artinya Anda tidak dapat mengelompokkan (batch) beberapa permintaan ke model pada waktu yang sama.
Model O1 masih baru, sehingga persyaratan dan batas laju ini dapat berubah dalam beberapa minggu mendatang. Misalnya, OpenAI awalnya mengumumkan bahwa batas mingguan adalah 30 pesan untuk o1-preview dan 50 untuk o1-mini. Namun, beberapa hari kemudian, mereka memperbarui menjadi 50 kueri per minggu untuk o1-preview dan 50 kueri per hari untuk o1-mini.
Kita akan masuk ke bagian praktik sebentar lagi, tetapi sebelum itu, mari kita perjelas konsep baru yang mendasar saat menggunakan o1 melalui API: reasoning tokens. Memahami konsep ini penting untuk memahami tagihan bulanan OpenAI Anda.
Jika Anda telah menggunakan o1-preview melalui antarmuka ChatGPT, Anda akan melihat bahwa model ini “berpikir keras” sebelum menghasilkan jawaban.
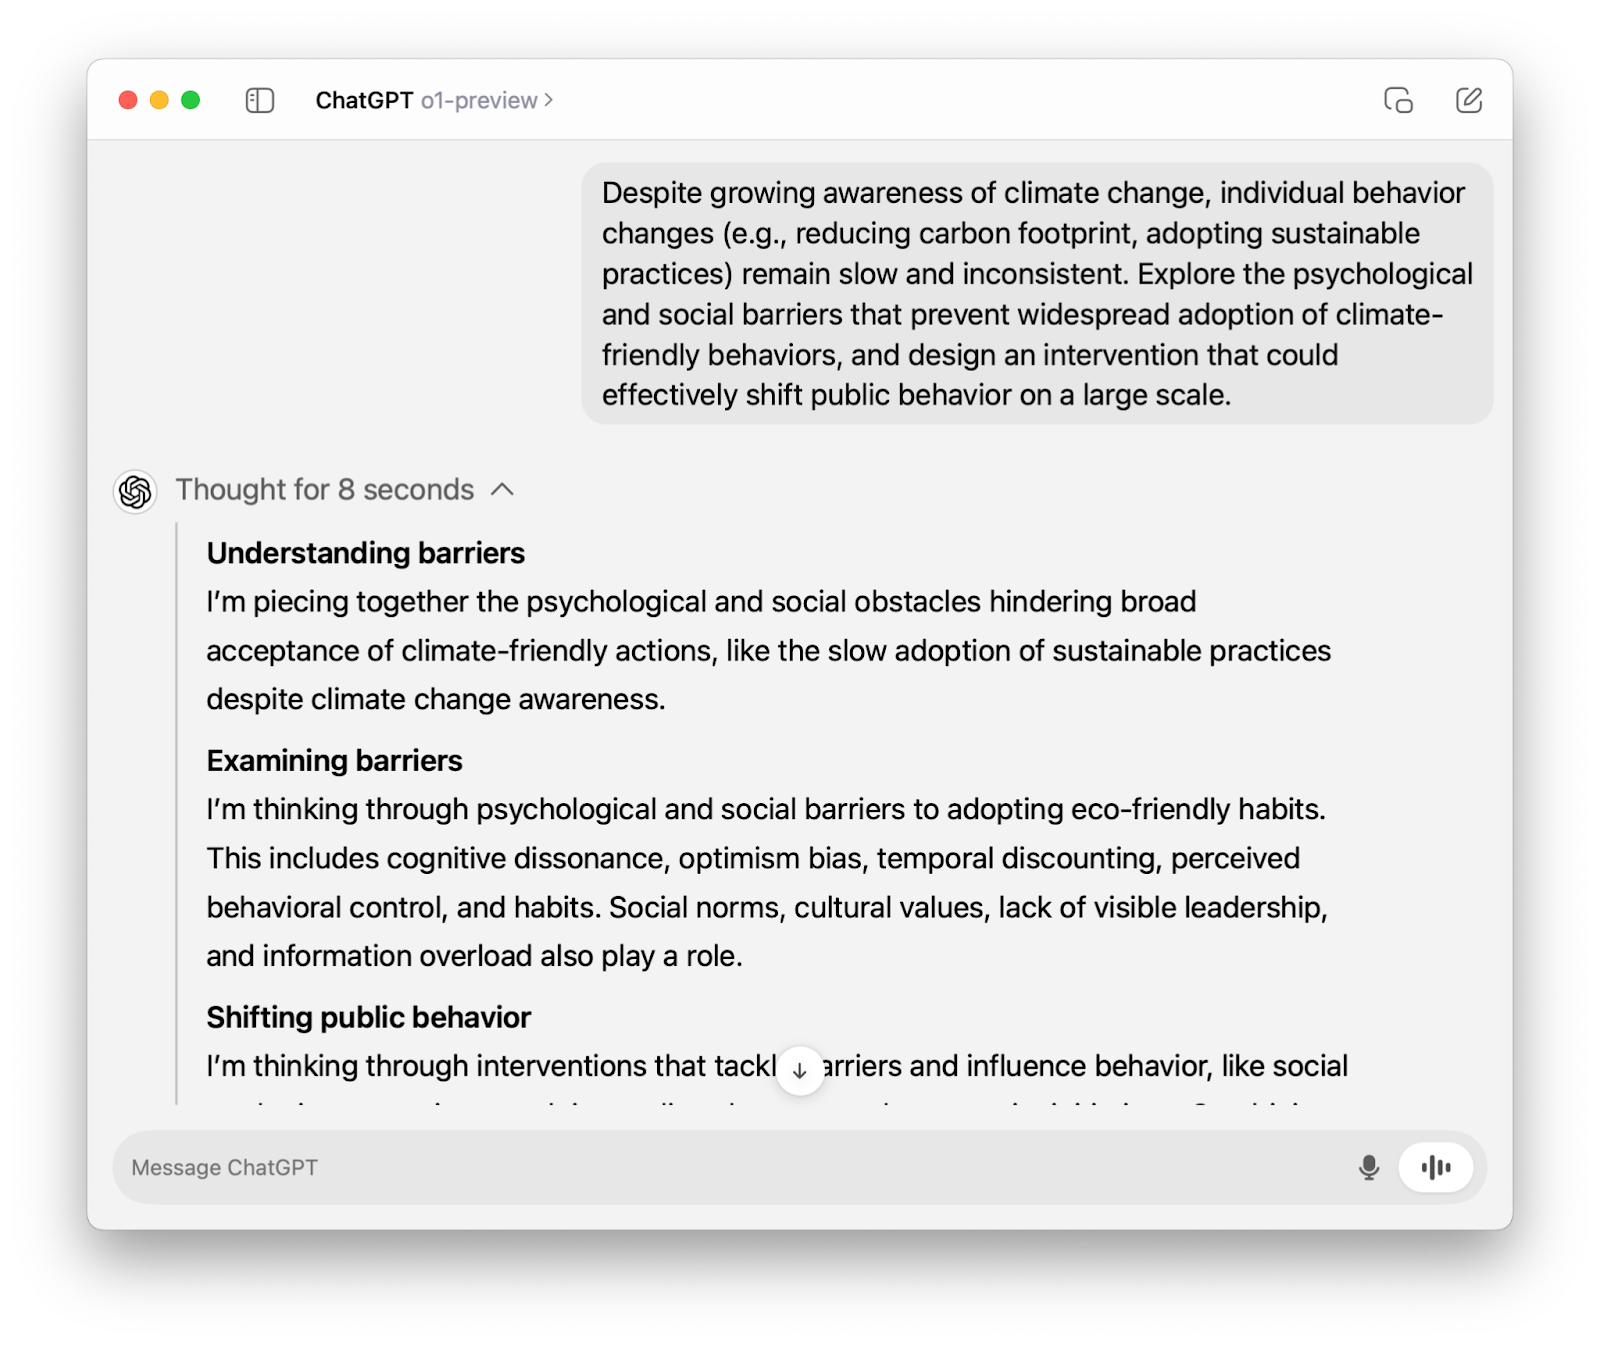
Saat kita menggunakan model o1 melalui API, ia melalui proses berpikir yang sama. Satu-satunya perbedaan adalah, tidak seperti di antarmuka ChatGPT, penalarannya tidak terlihat, dan yang kita lihat hanyalah jawaban akhir.
Namun, penalaran tersebut tetap ditokenisasi (karena itu disebut “reasoning tokens”), dan seperti yang bisa Anda tebak, hal itu ditagihkan. Reasoning tokens ditagihkan sebagai token keluaran, yang empat kali lebih mahal daripada token masukan.
Sebentar lagi kita akan mempelajari cara mengontrol jumlah token dan mengelola biaya, tetapi untuk saat ini, mari fokus pada koneksi ke API OpenAI untuk menggunakan model o1.
Di bagian ini, kita akan menguraikan serangkaian langkah untuk membantu Anda terhubung ke model o1-preview melalui API. Nantinya, kita juga akan membahas cara terhubung ke model o1-mini.
Asal Anda memiliki akun aktif, Anda dapat memperoleh secret API key dari halaman API key OpenAI.
Jika Anda bagian dari sebuah organisasi, Anda mungkin juga memerlukan ID organisasi dan ID proyek, yang dapat membantu tim Anda mengelola biaya lebih efektif. Pastikan untuk mengonfirmasi hal ini dengan tim Anda.
Baik Anda baru dalam API atau pengembang berpengalaman, selalu merupakan ide bagus untuk mengikuti praktik terbaik API.
openaiOpenAI memudahkan interaksi dengan API-nya melalui pustaka Python openai. Anda dapat memasangnya dengan perintah berikut:
pip install openaiSetelah terpasang, kita mengimpor kelas OpenAI dari pustaka openai:
from openai import OpenAIUntuk berinteraksi dengan API OpenAI, kita menginisialisasi klien menggunakan secret API key kita:
client = OpenAI(api_key=’your-api-key’)Jika Anda bagian dari organisasi, Anda mungkin juga memerlukan ID organisasi dan ID proyek, jadi langkah ini mungkin terlihat seperti ini untuk Anda:
client = OpenAI(
    organization=’your-organization-id’,
    project=’your-project-id’,
    api_key=’your-api-key’
)Satu-satunya model o1 yang tersedia saat artikel ini ditulis adalah o-1 preview dan o1-mini. Keduanya tersedia melalui endpoint chat.completions. Pada kode di bawah, perhatikan bahwa:
client.chat.completions.create().”o1-preview” untuk parameter model.”content”.response.choices[0].message.content.response = client.chat.completions.create(
model="o1-preview",
messages=[
{
"role": "user",
"content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
}
]
)
print(response.choices[0].message.content)```python
import ast
# Read the input string
s = input()
# Add outer brackets to make it a valid list representation
input_str = '[' + s + ']'
# Safely evaluate the string to a list of lists
matrix = ast.literal_eval(input_str)
# Transpose the matrix
transposed = list(map(list, zip(*matrix)))
# Convert the transposed matrix back to the required string format
transposed_str = ','.join('[' + ','.join(map(str, row)) + ']' for row in transposed)
# Print the result
print(transposed_str)
```Seperti disebutkan sebelumnya, penalaran di balik layar tetap dihitung sebagai token yang ditagihkan. Untuk kode yang kita jalankan di atas, berikut rincian semua token yang digunakan:
print(response.usage)CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})Dengan memeriksa output, kita melihat bahwa jumlah reasoning tokens adalah 1024: completion_tokens_details={'reasoning_tokens': 1024}.
Model menghasilkan completion menggunakan 1279 token (completion_tokens=1279), di mana 1024 di antaranya adalah reasoning tokens yang tidak terlihat—sekitar 80%!
Mengelola biaya menjadi sedikit lebih rumit dengan model o1 yang baru, jadi mari kita bahas ini lebih detail.
Pada model sebelumnya, kita menggunakan parameter max_tokens untuk mengontrol jumlah completion token. Halnya cukup sederhana: jumlah token yang dihasilkan dan jumlah token yang terlihat selalu sama.
Namun, dengan model o1, kita membutuhkan parameter yang menetapkan batas atas untuk semua completion token, termasuk token keluaran yang terlihat dan reasoning tokens yang tidak terlihat. Untuk alasan ini, OpenAI menambahkan parameter max_completion_tokens, sekaligus menghentikan max_tokens dan menjadikannya tidak kompatibel dengan model o1.
Mari coba max_completion_tokens dengan contoh sebelumnya. Kita akan menetapkannya ke 300 dan melihat hasilnya. Untuk menggunakan parameter baru ini, perhatikan bahwa Anda mungkin memerlukan pembaruan pustaka openai jika menjalankan versi lama.
response_with_limit = client.chat.completions.create(
    model="o1-preview",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ],
    max_completion_tokens=300
)
print(response_with_limit.choices[0].message.content) Perhatikan bahwa kita tidak mendapatkan output apa pun. Namun apakah kita tetap membayar? Jawabannya adalah ya.
print(response_with_limit.usage)CompletionUsage(completion_tokens=300, prompt_tokens=43, total_tokens=343, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=300))Jika model o1 mencapai batas token sebelum mencapai jawaban akhir, ia menghentikan proses penalarannya dan tidak mengembalikan output apa pun. Karena itu, penting untuk menetapkan max_completion_tokens pada nilai yang menjamin output—jika tidak, kita akan ditagih untuk reasoning tokens dan token masukan tanpa mendapatkan apa pun sebagai imbalan.
Anda perlu bereksperimen dengan nilai tepat max_completion_tokens berdasarkan kasus penggunaan Anda, tetapi OpenAI menyarankan untuk menyisihkan setidaknya 25.000 token untuk total jumlah completion token.
Untuk menghindari output terpotong (atau tidak ada output sama sekali), Anda juga perlu memperhatikan context window jika kasus penggunaan Anda melibatkan jumlah token yang besar. Model o1-preview dan o-1 mini memiliki context window 128.000 token. Perlu dicatat, meskipun demikian, bahwa token keluaran (terlihat dan tidak terlihat) dibatasi pada 32.768 token untuk o1-preview dan 65.536 token untuk o1-mini.
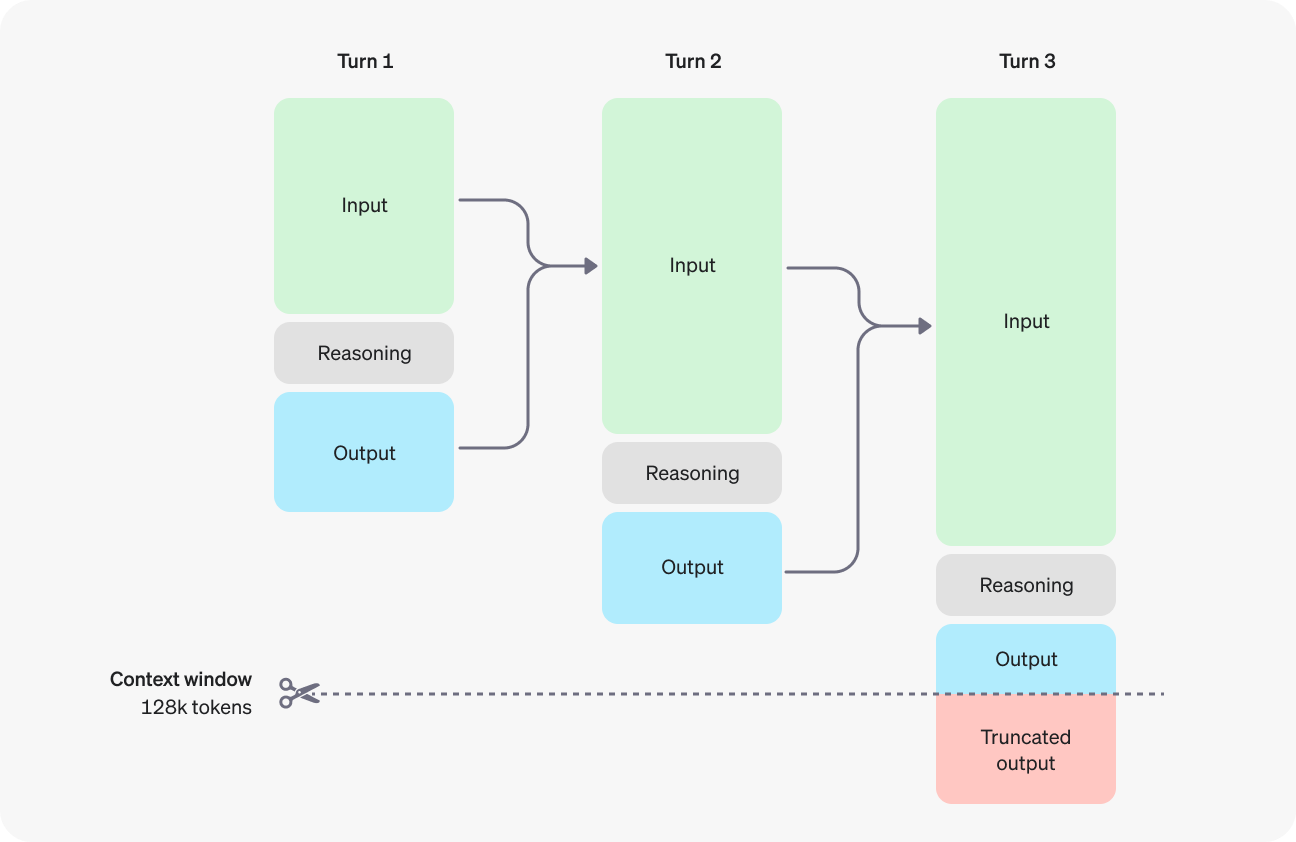
Sumber: OpenAI
Model o1 yang besar kuat dalam penalaran tingkat lanjut, tetapi juga sangat lambat. Jika Anda memerlukan waktu respons yang lebih cepat untuk aplikasi Anda dan bersedia sedikit berkompromi pada performa penalaran, maka model o1-mini bisa menjadi pilihan yang lebih baik.
Untuk terhubung ke model o1-mini melalui API, ikuti semua langkah yang telah kita bahas untuk model o1-preview—kecuali untuk parameter model, di mana Anda harus menggunakan string ”o1-mini”.
Kita akan menggunakan prompt yang sama seperti pada contoh terakhir, sehingga kita bisa membandingkan penggunaan token:
response_mini = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format."
        }
    ]
)
print(response_mini.choices[0].message.content)
Certainly! Below is a Python script that takes a matrix represented as a string in the format `'[1,2],[3,4],[5,6]'`, computes its transpose, and prints the transposed matrix in the same string format.
```python
def parse_matrix(matrix_str):
"""
Parses a matrix string like '[1,2],[3,4],[5,6]' into a list of lists.
"""
# Split the string by '],[' to separate the rows
rows = matrix_str.strip().split('],[')
# Clean the first and last elements by removing any leading '[' or trailing ']'
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
# Convert each row into a list of integers
matrix = []
for row in rows:
# Split each row by ',' and convert each element to integer
matrix.append([int(num) for num in row.split(',')])
return matrix
def transpose_matrix(matrix):
"""
Transposes a given matrix (list of lists).
"""
# Use zip with unpacking to transpose the matrix
transposed = list(zip(*matrix))
# Convert each tuple in the transposed matrix back to a list
transposed = [list(row) for row in transposed]
return transposed
def matrix_to_string(matrix):
"""
Converts a list of lists into a string format like '[1,3,5],[2,4,6]'.
"""
# Convert each row to a string
row_strings = []
for row in matrix:
# Convert each number to string and join with commas
row_str = ','.join(str(num) for num in row)
# Enclose the row in brackets
row_strings.append(f'[{row_str}]')
# Join all rows with commas
return ','.join(row_strings)
def main():
# Example input
input_str = '[1,2],[3,4],[5,6]'
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
if __name__ == "__main__":
main()
```
### How It Works:
1. **Parsing the Input String:**
- The `parse_matrix` function takes the input string and splits it into individual rows by looking for the pattern `"],["`.
- It cleans the first and last rows by removing any leading `[` or trailing `]`.
- Each row string is then split by `,` to extract individual numbers, which are converted to integers and stored in a nested list.
2. **Transposing the Matrix:**
- The `transpose_matrix` function uses the `zip` function along with unpacking (`*`) to transpose the matrix. This effectively switches rows with columns.
- Since `zip` returns tuples, each transposed row is converted back into a list.
3. **Converting Back to String:**
- The `matrix_to_string` function takes the transposed matrix and converts each row back into a string in the desired format.
- It joins the elements of each row with commas and encloses them in brackets.
- Finally, all row strings are joined together with commas to form the final output string.
4. **Main Execution:**
- The `main` function demonstrates the usage with an example input. You can modify `input_str` to test with different matrices.
- It prints the transposed matrix in the specified string format.
### Example:
Given the input string:
```
'[1,2],[3,4],[5,6]'
```
The script will output:
```
[1,3,5],[2,4,6]
```
### Handling User Input:
If you'd like the script to accept user input instead of having a hardcoded string, you can modify the `main` function as follows:
```python
def main():
# Take user input
input_str = input("Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): ").strip()
# Parse the input string into a matrix
matrix = parse_matrix(input_str)
# Compute the transpose of the matrix
transposed = transpose_matrix(matrix)
# Convert the transposed matrix back to string format
output_str = matrix_to_string(transposed)
# Print the result
print(output_str)
```
With this modification, when you run the script, it will prompt you to enter the matrix string:
```
Enter the matrix string (e.g., '[1,2],[3,4],[5,6]'): [1,2],[3,4],[5,6]
[1,3,5],[2,4,6]
```
### Notes:
- **Error Handling:** The current script assumes that the input string is well-formatted. For production code, you might want to add error handling to manage malformed inputs.
- **Non-integer Elements:** If your matrix contains non-integer elements (e.g., floats or strings), you'll need to adjust the parsing logic accordingly.
### Running the Script:
1. **Save the Script:** Save the above code to a file, say `transpose_matrix.py`.
2. **Run the Script:** Open a terminal or command prompt, navigate to the directory containing the script, and execute:
```bash
python transpose_matrix.py
```
3. **Provide Input:** If you've modified it to accept user input, enter the matrix string when prompted.
This script provides a straightforward way to transpose a matrix represented as a string and can be easily adapted or extended based on specific requirements.Output yang terlihat jauh lebih panjang dibandingkan output o1-preview—mari bandingkan penggunaannya:
print(response_mini.usage) # o1-mini
print(response.usage) # o1-preview
CompletionUsage(completion_tokens=1511, prompt_tokens=43, total_tokens=1554, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=256))
CompletionUsage(completion_tokens=1279, prompt_tokens=43, total_tokens=1322, completion_tokens_details={'reasoning_tokens': 1024})Model o1-mini melakukan penalaran empat kali lebih sedikit dibanding model o1 (256 vs. 1024 reasoning tokens). Namun, karena jawabannya panjang, jumlah total completion token justru lebih besar. Meskipun o1-mini secara signifikan lebih murah daripada o1-preview, ini tetap kurang ideal.
Salah satu cara untuk mengatasinya adalah melalui rekayasa prompt—kita akan menginstruksikan model untuk menghindari penjelasan dan pengantar serta membatasi outputnya hanya pada jawaban.
response_mini_2 = client.chat.completions.create(
    model="o1-mini",
    messages=[
        {
            "role": "user",
            "content": "Write a Python script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. Limit yourself to the answer and don't add explanations or introductions."
        }
    ]
)
print(response_mini_2.choices[0].message.content)
```python
import ast
def parse_matrix(matrix_str):
rows = matrix_str.split('],[')
rows[0] = rows[0].lstrip('[')
rows[-1] = rows[-1].rstrip(']')
matrix = [ast.literal_eval(f'[{row}]') for row in rows]
return matrix
def transpose(matrix):
return list(zip(*matrix))
def format_matrix(transposed):
return ','.join([f'[{",".join(map(str, row))}]' for row in transposed])
input_str = '[1,2],[3,4],[5,6]'
matrix = parse_matrix(input_str)
transposed = transpose(matrix)
output_str = format_matrix(transposed)
print(output_str)
```Jauh lebih baik! Jumlah total completion token kira-kira tiga kali lebih sedikit:
print(response_mini_2.usage)CompletionUsage(completion_tokens=487, prompt_tokens=55, total_tokens=542, completion_tokens_details=CompletionTokensDetails(reasoning_tokens=320))Pada saat penulisan tutorial ini, model o1 masih dalam versi beta. Sementara OpenAI telah mengumumkan rencana fitur tambahan dan batas laju yang lebih bersahabat dalam beberapa minggu ke depan, berikut keterbatasan yang akan Anda temui saat menggunakan model o1 versi beta:
temperature, top_p, dan n ditetapkan pada 1, sementara presence_penalty dan frequency_penalty ditetapkan pada 0.Untuk saat ini, OpenAI tampaknya tidak memiliki banyak pesaing di ranah penalaran tingkat lanjut. Karenanya, harganya mungkin sedikit tinggi, dan seperti yang Anda lihat, secara signifikan lebih mahal dibandingkan model GPT-4o:
|
Model |
Harga |
|
o1-preview |
$15,00 / 1M token masukan |
|
$60,00 / 1M token keluaran |
|
|
o1-mini |
$3,00 / 1M token masukan |
|
$12,00 / 1M token keluaran |
|
|
gpt-4o |
$5,00 / 1M token masukan |
|
$15,00 / 1M token keluaran |
|
|
gpt-4o-mini |
$0,150 / 1M token masukan |
|
$0,600 / 1M token keluaran |
Model o1 sangat berbeda dari model yang biasa kita gunakan, seperti GPT-4o atau Claude 3.5 Sonnet. Karena model o1 sudah melakukan penalaran chain-of-thought secara internal, model ini bekerja paling baik dengan prompt yang lugas. Menggunakan few-shot prompting atau meminta model untuk berpikir “selangkah demi selangkah” justru dapat menurunkan kinerjanya.
Berikut beberapa praktik prompting terbaik yang direkomendasikan oleh pengembang di OpenAI:
Sepanjang blog ini, saya telah berbagi panduan langkah demi langkah untuk terhubung ke model o1 melalui API OpenAI.
Jika proyek Anda memerlukan kemampuan penalaran tingkat lanjut dan dapat menerima waktu respons yang sedikit lebih lama, model o1 merupakan pilihan yang sangat baik.
Untuk aplikasi yang memerlukan respons cepat, pemrosesan gambar, atau function calling, GPT-4o dan GPT-4o mini tetap menjadi pilihan utama.
Untuk terus belajar, saya merekomendasikan sumber berikut:
Pelajari AI dengan kursus-kursus ini!
Kursus
Program
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt



